
大家好,最近可谓是热闹的不得了,刷到好多文章,目前木有看到有写怎么节省 GPT-6 Astra Token 的,这不巧了,官方已经给答案了,为了节省时间,我做一下搬运工,可以随时翻出来看,下面我让 GPT 总结。
GPT-6 Astra 官方介绍
GPT-6 Astra 是迄今为止最智能的模型,在计算机使用、浏览、软件工程、科学研究和专业工作方面均展现出卓越的性能。它尤其擅长 跨代码、浏览器和专业软件执行多步骤 工作流程、谨慎行事、尊重任务边界以及透明沟通。
当指令留有解读空间时,它会利用上下文信息填补常规的空白,并在答案可能影响结果时提出有针对性的问题。它能够整合新的需求,在被要求时调整方向,并在回答旁支问题的同时,始终不偏离整体任务。
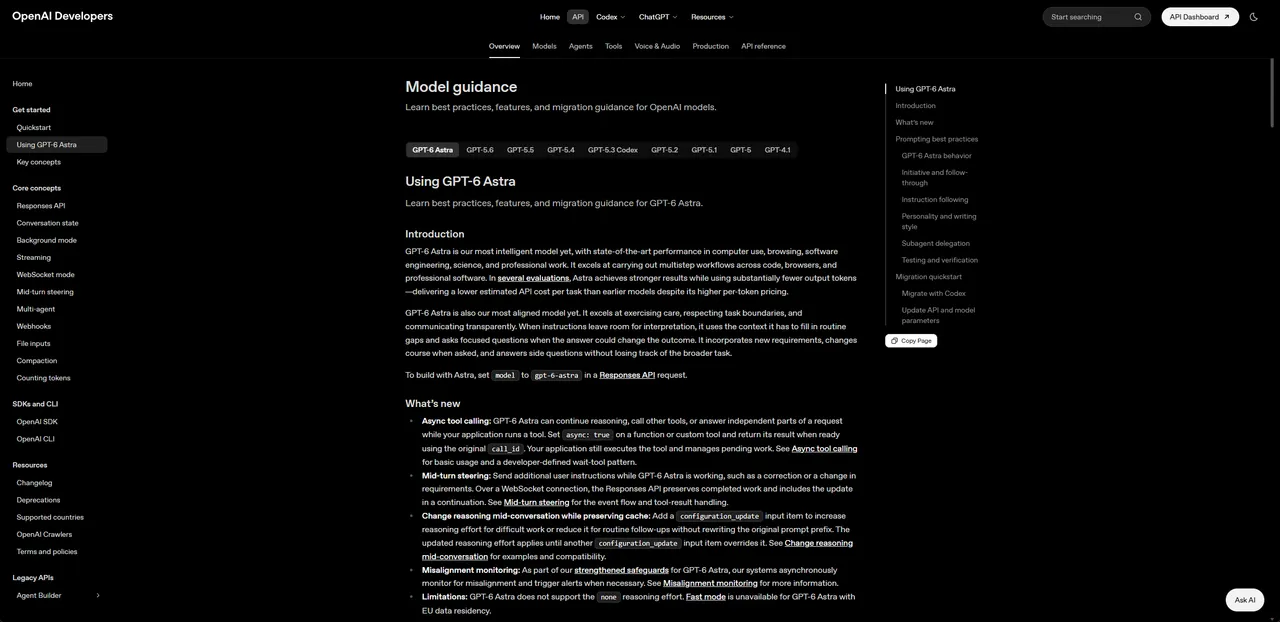
地址:https://developers.openai.com/api/docs/guides/latest-model
1.使用较低的推理力度
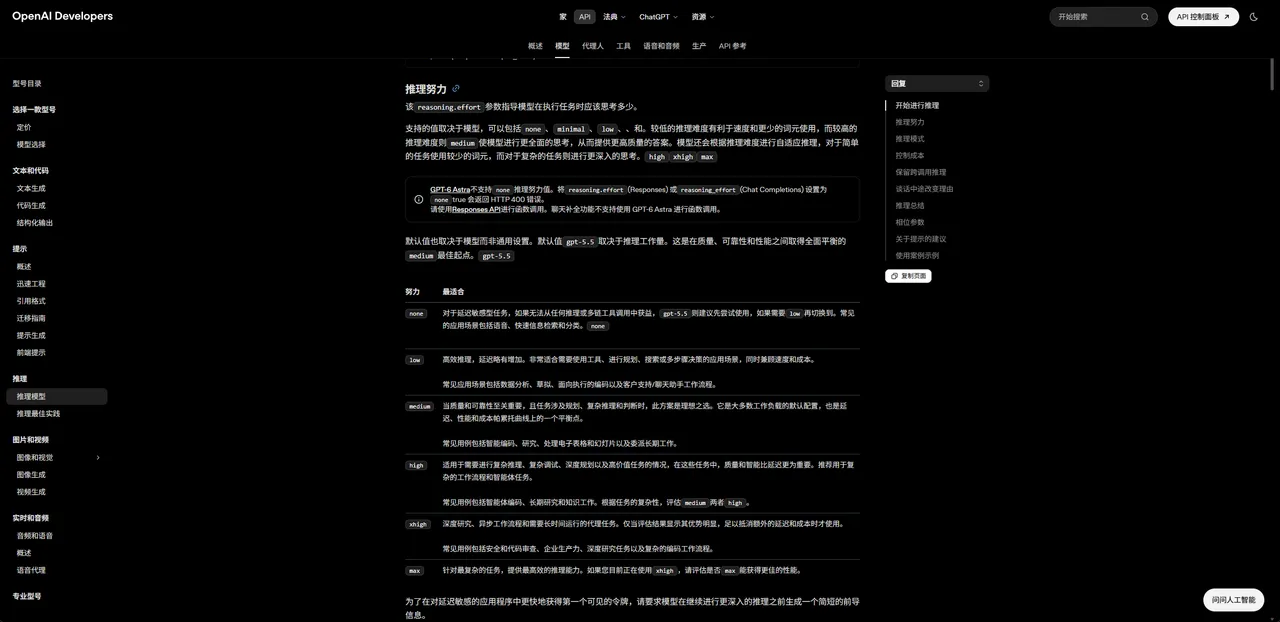
普通任务默认用 reasoning.effort: "low" [推理强度:低]
不要所有任务都开高强度推理。简单问答、改文案、翻译、总结、格式整理、普通代码修改,都可以先用 low。只有复杂分析、难题、架构设计、疑难 Debug [程序排错] 时,再临时切到 medium [中等推理] 或 high [高强度推理] 。
{
  "model": "gpt-6-astra",
  "reasoning": {
    "effort": "low"
  }
}这样可以减少模型不必要的“深度思考”,从而节省推理 token。而且 Astra 支持中途动态调整推理,把推理强度从 low 改成 high,这样就不需要每次都重新修改整段 Prompt [提示词],同时还能继续保留 Prompt Cache [提示词缓存] 的效果。
关键词: reasoning.effort: "low"
2.长对话一定要用上下文压缩
不要每次都把前面完整聊天记录重新发给模型。聊天越长,输入 token 就越多,成本也会越来越高。Compaction [上下文压缩] 的作用,就是把前面很长的聊天内容压缩成一个更短的状态,再继续往下聊。关键的信息会保留,但不会每轮都重复传几十万 token。
可以理解成:
错误方式:


第 1 轮  5k
第 2 轮  10k
第 3 轮  20k
第 4 轮  40k
...
每次全部重新发送改成:
前面完整历史
↓
Compaction
↓
压缩后的短上下文
+
新问题对于你这种可能会连续修改网页、Prompt、设计方案的长任务,这个非常重要。
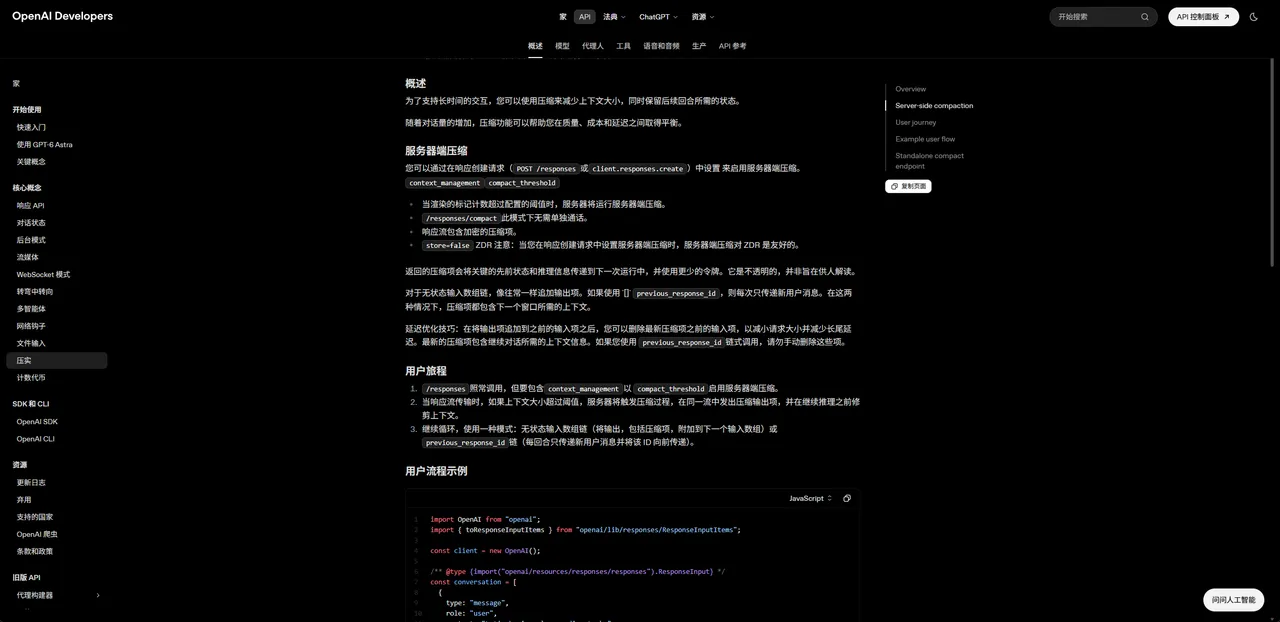
关键词: Compaction
3.开启提示词缓存
固定内容放前面,动态内容放后面,像 System Prompt [系统提示词]、Skill [技能规则]、品牌规范、输出规范、工具说明、长期参考资料,这些固定内容尽量不要反复改。
把它们放在 Prompt [提示词] 的前面,把用户本轮的新需求、时间、变量、临时条件放在后面。这样系统更容易命中 Prompt Cache [提示词缓存],相同的前半段就不用每次重新完整计算。
比如你每次都有一段很长的系统提示词:
你的身份
设计规范
Skill
品牌规范
输出规范
工具定义
参考资料不要每轮都改这些东西,推荐结构:
固定 System Prompt
固定 Skill
固定设计规范
固定工具定义
固定参考资料
----------------
用户本轮动态需求
时间
变量
临时要求注意:它不一定减少统计出来的 token 数量,但通常可以明显降低重复输入部分的费用和延迟。
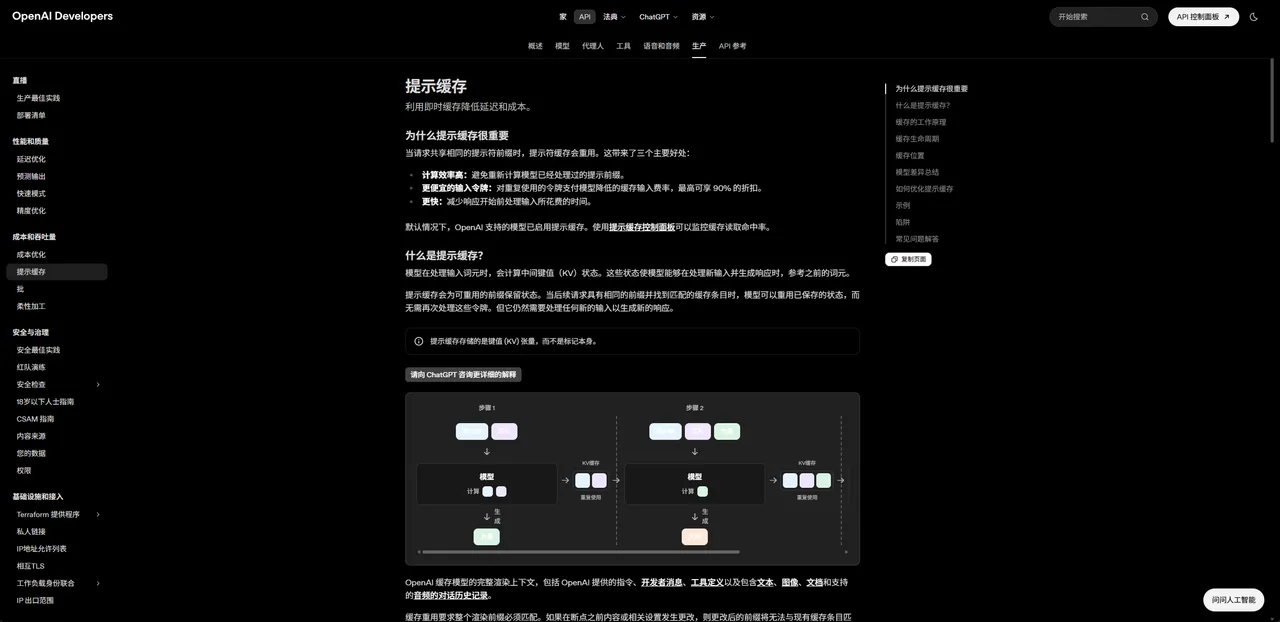
关键词:Prompt Cache
4.工具不要一次全部塞给模型,用延迟加载
如果你的 Agent 同时有 Browser [浏览器]、Search [搜索]、Figma、Photoshop、Gmail、Calendar [日历]、Database [数据库]、GitHub、Shell [命令行]、Image [图像]、PDF 等几十个工具,不要每次都把所有工具说明一起发送给模型。工具本身的 Schema [结构说明] 也会占很多 token。
defer_loading [延迟加载] 的意思就是:当前需要哪个工具,才加载哪个工具。
比如现在只需要查网页,就只加载 Browser [浏览器] 和 Search [搜索];等真正需要 Figma 时,再加载 Figma。这样可以直接减少输入 token。
假设你的 Agent 有:
Browser
Search
Figma
Photoshop
Gmail
Calendar
Database
GitHub
Shell
Image
PDF
20 个 MCP Tool如果每次请求都把所有工具 schema [格式规范] 发给模型,工具定义本身可能就是几千甚至几万 token。
官方建议使用 Tool Search [工具查找] +:
defer_loading: true需要哪个工具再加载哪个工具,从而直接减少前几轮请求中的输入 token,所以更好的思路是:
❌ 30 个 Tool → 全部放进 Context


✅ 当前只需要网页
Browser + Search


真正需要 Figma 时
↓
再加载 Figma如果你在做 Agent / Skill / MCP,这个属于非常值得优化的一项。
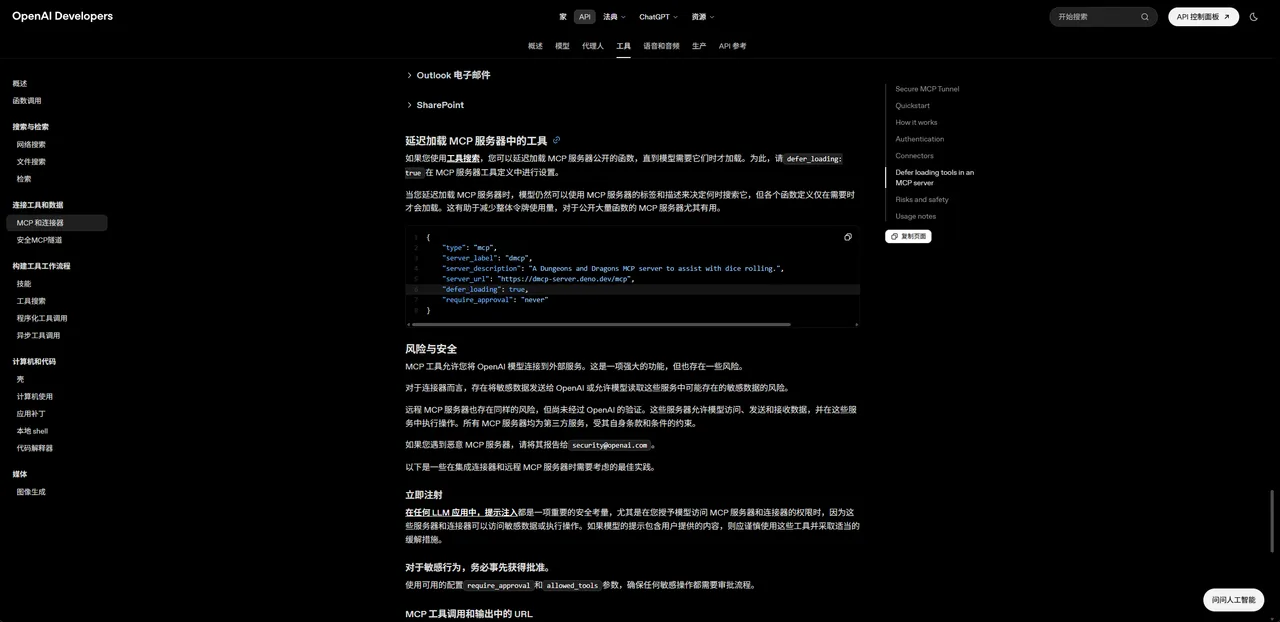
关键词:defer_loading
5.明确限制模型的回答长度,减少输出 token
GPT 模型默认可能会解释得比较详细,如果你只需要结果,就要明确写清楚。比如可以要求:“只回答重点。”、“每项最多 2 句话。”、“不要复述我的问题。”、“不要重复总结。”、“不要解释思考过程。”
例如不要只写:
帮我分析这个网页。可以写:
分析这个网页。
只输出:
1. 设计风格
2. 布局
3. 字体
4. 配色
5. 动效


每项最多 3 句话。
不要复述需求。
不要总结。
不要解释分析过程。甚至在系统 Prompt 里长期加入:
默认使用简洁回答。
优先直接给结果。
除非用户明确要求,否则避免:
- 重复问题
- 背景介绍
- 总结段
- 不必要的 Markdown
- 重复结论
- 长篇解释这样可以直接减少 output tokens [模型输出产生的 token]。很多时候,省 token 最简单有效的方法不是改模型,而是明确让它 “少说一点”。
关键词:output tokens
6.不要让模型反复测试和验证,尤其是在编程智能体里
Astra 这类模型比较谨慎,写完代码后可能会自动继续检查、重新跑测试、再扩大测试范围。如果代码已经通过了必要测试,就不要让它重复验证。可以直接告诉它:“只执行和这次修改直接相关的测试。”、“必要测试通过后立即停止。”、“不要重复运行已经通过的测试。”。
这个主要针对 Coding Agentp [编程智能体],Astra 默认比较谨慎,代码改完后可能:
跑测试
↓
再检查
↓
再跑完整测试
↓
再验证
↓
再检查边缘案例官方专门建议限制这种行为:小型、可逆、低风险改动,不要写重复测试;已有必要测试通过后,没有新变化、失败或疑点,就不要继续扩大验证范围。你可以直接加:
仅执行与本次修改直接相关的测试。


必要测试通过后立即停止验证,
除非出现错误、新修改或未解决的问题。


不要为了完整性重复运行已经通过的测试。这样可以同时减少推理 token、工具调用次数、执行时间和计算成本。
关键词:Coding Agent
7.多轮任务不要每次从头开始
复杂 Agent 任务经常是这种流程:用户提出任务 → 模型思考 → 调用浏览器 → 浏览器返回结果 → 模型继续 → 再调用代码工具。这种情况下,不要每一步都重新把完整背景、目标和历史再说一遍。
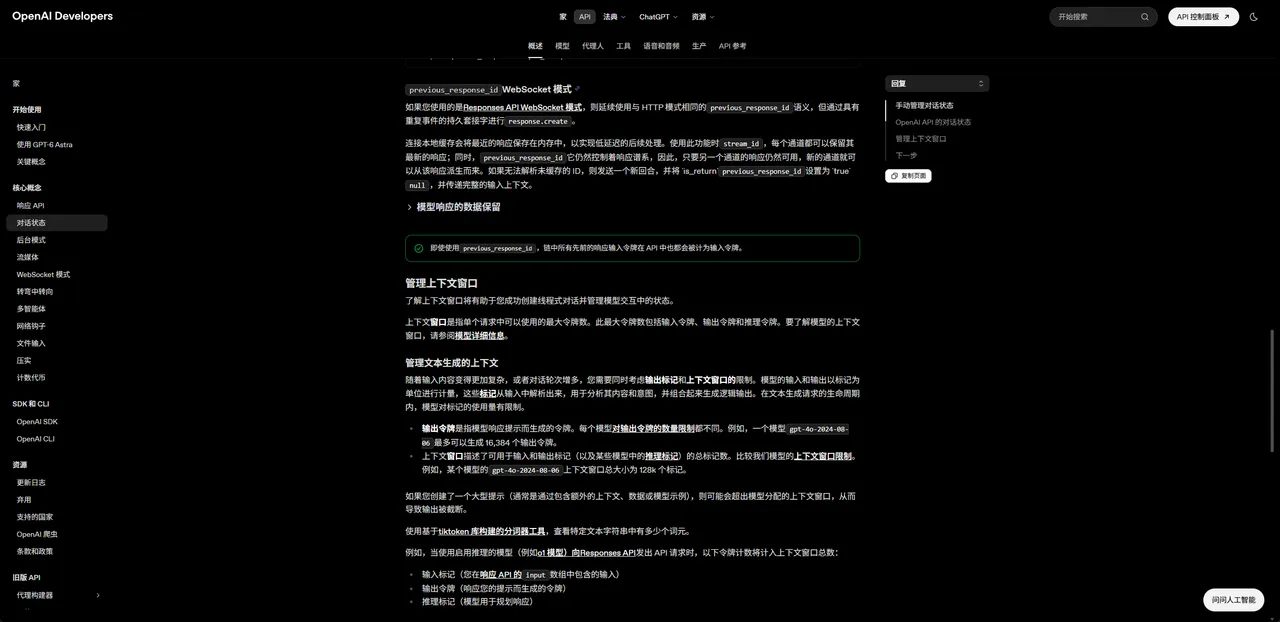
可以通过 previous_response_id [上一轮响应 ID] 接着上一轮继续,让模型沿用之前的状态。
尤其是复杂 Agent:
用户
↓
模型思考
↓
调用 Browser
↓
浏览器返回
↓
模型继续思考
↓
调用 Code
↓
继续不要每一步都像全新请求一样重新解释整个问题。Responses API [模型调用接口] 可以通过:
previous_response_id继续之前状态。官方也建议在 function calling [函数调用] 场景中把相关 reasoning items [推理内容单元] 和工具结果保留下来,这样模型能以更 token-efficient [更节省token] 的方式继续之前的推理,而不是重新建立整个推理过程。
\-
如果排一个省 token 优先级,会是:
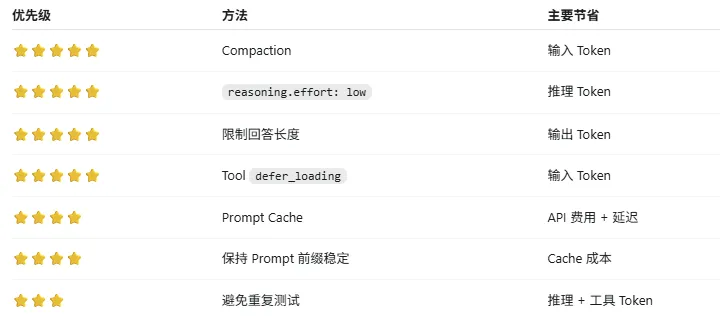
其中最容易犯的一个错误是:
为了省 token,把 System Prompt 拼命删短这并不一定最划算,如果一段 5000 token 的规则每次都完全一样,并且能稳定缓存,有时候反而比:
每轮重新生成
重新总结
重新排序
重新组织 Prompt更省钱。OpenAI 甚至专门提醒:为了缩短 Prompt 而破坏缓存前缀,有时会导致总成本反而上升。
\-
如果是你现在在做 Agent / Skill,建议直接采用这一套:
固定区:
System Prompt
角色
Skill
工作原则
输出规范
稳定 Tool 定义
稳定参考资料


↓


动态区:
当前任务
用户新增要求
临时变量


↓


执行策略:
reasoning = low
复杂任务 → medium / high
完成后恢复 low


↓


Tool:
默认 defer_loading
需要时才加载


↓


长会话:
达到一定 Context → Compaction


↓


输出:
直接回答
不复述问题
不解释思考过程
不重复总结
默认简洁
必要时再展开这样模型不需要反复重新理解整个任务,也能减少重复上下文和重复推理。
关键词: previous_response_id
结尾
一句话总结:
GPT-6 Astra 最有效的省 token 方法是:低推理起步 + 稳定 Prompt 缓存 + 按需加载工具 + 长对话 Compaction + 严格限制输出长度 + 避免重复验证。
补充:
如果你自己都不知道要做什么,首先应该去学相关的知识或者问其他大模型,给你方向,这样会更节省 Token 。
请不要 “许愿式使用大模型”,服务商最喜欢你们这种 “宝宝” 了...
