
文章作者:@udaykiran
引言
AI 工具现已嵌入Uber软件开发的每一个阶段。超过 70% 的拉取请求归因于本地或云端智能体。工程师已在软件开发生命周期中构建了 3,600 多项智能体技能,并且每天执行超过 3 万次智能体技能调用。
在 AI Engineer 2026 大会上,我们分享了 我们的愿景,即软件工厂以及我们正在生命周期各阶段构建的基础组件和托管智能体。随着这一愿景的推进,越来越多的会话并非由人类发起,而是由自动化托管智能体处理代码审查、自愈 CI 故障、完成带视觉验证的端到端拉取请求、分类值班告警、调试新出现的 bug,以及处理各类代码维护任务,同时辅以人工审查 / 升级。
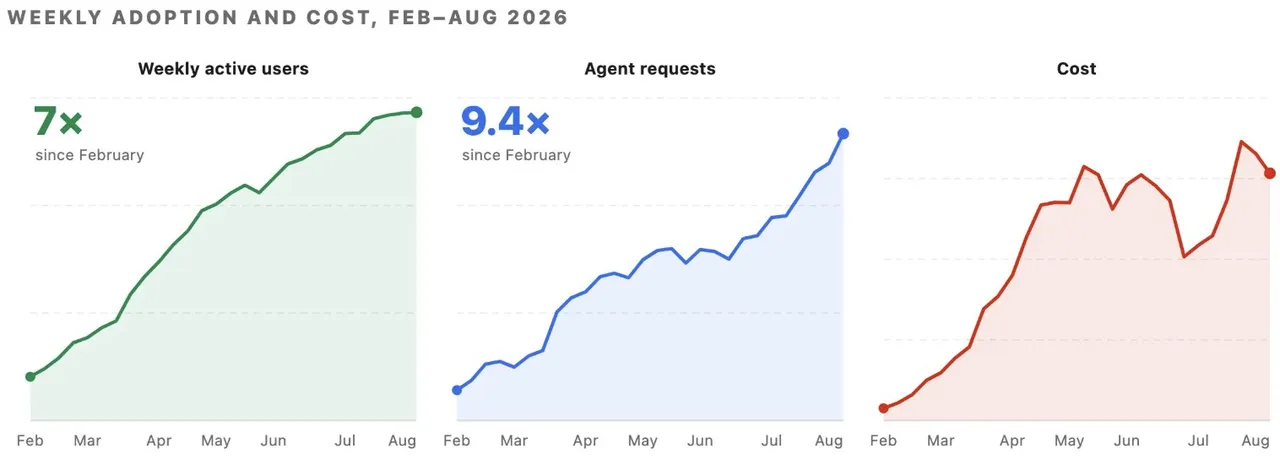
如图 1 所示,从 2026 年 2 月到 8 月,所有员工(工程师与非工程师)中各类智能体产品的周活跃用户增长了 7 倍,周智能体请求量增长了 9.4 倍。与此同时,由于全方位的优化,自 4 月以来我们的 AI 总支出相对趋于稳定。
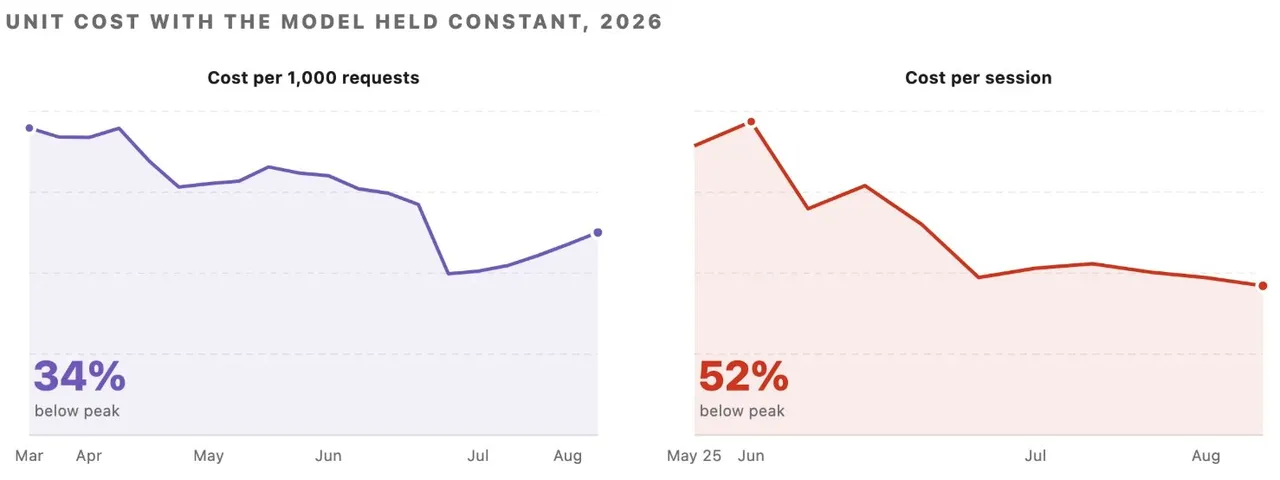
由于采用率、工作负载组合和模型升级都在持续变化,要单独衡量我们的优化收益,就需要固定一个模型,因为每次升级和模型系列切换都会带来行为变化。我们从 2 月到 7 月就是这么做的:每 1,000 次模型请求的成本比峰值下降了近 34%,每次会话成本比 6 月峰值下降了 52%。
这篇博客将介绍我们如何思考软件工厂:智能体会话运行的四个层次、我们用于分解支出的成本公式、我们如何衡量每一项,以及如何在每一层优化这些项。
本对比中的所有定价和供应商指标均基于公开可用信息,成本效率提升是通过在标准分层定价内更智能地路由我们的内部Uber工作负载实现的。虽然我们衡量的具体成本降幅是我们环境所特有的,你的具体情况可能因代码库、团队规模和智能体工作流而异,但基于真实工作构建基准并针对准确性和成本进行优化的方法论是普遍适用的。
软件工厂及其成本公式
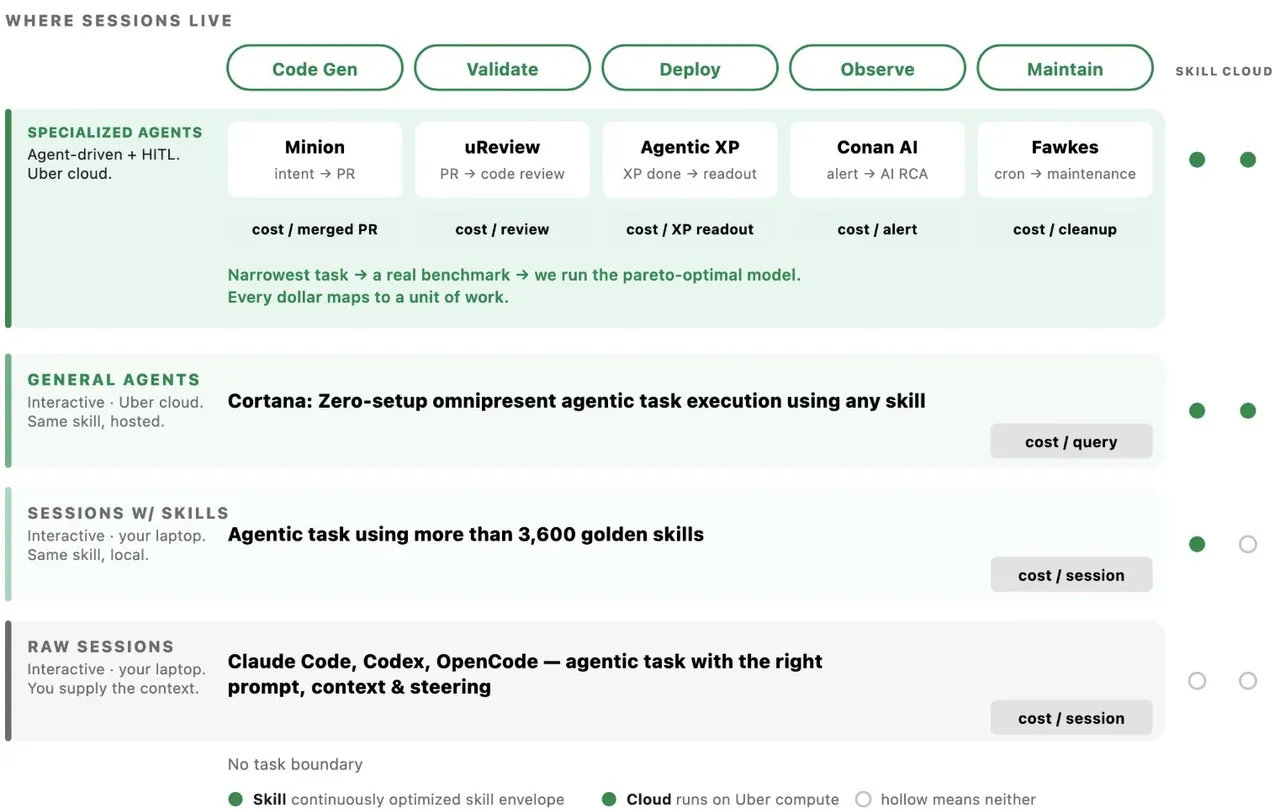
智能体使用的四个层次
我们将 AI 使用分为四个层次,从最专业化到最通用。如图 3 所示,层次越高,我们对成本、质量和模型选择的控制力就越强。
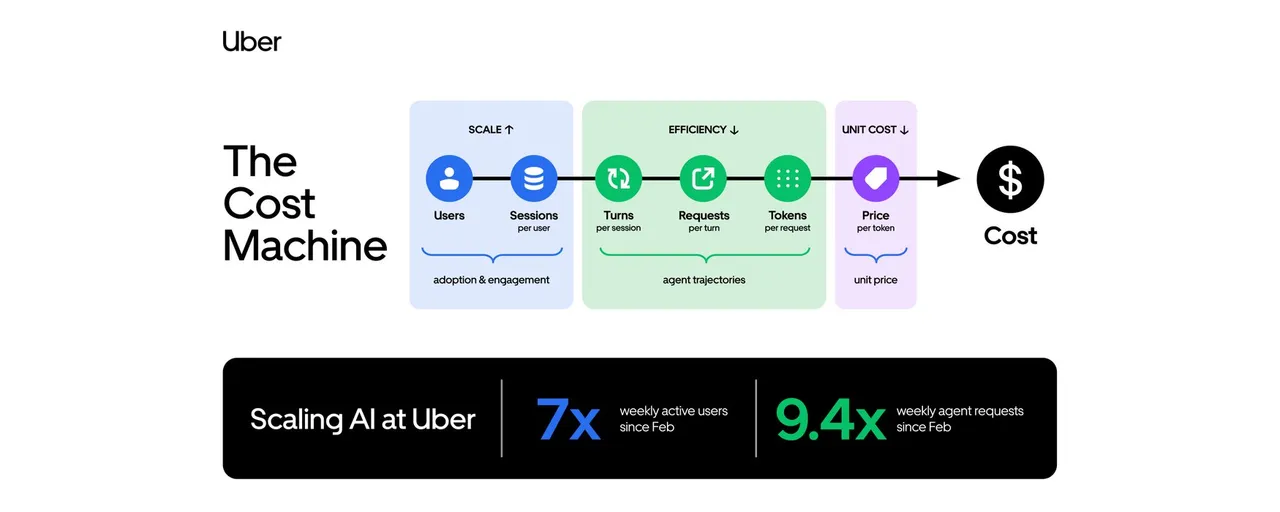
成本公式
在上述任何层次中,我们都可以将智能体会话的成本分解为以下各项,这些项可以独立衡量和优化。
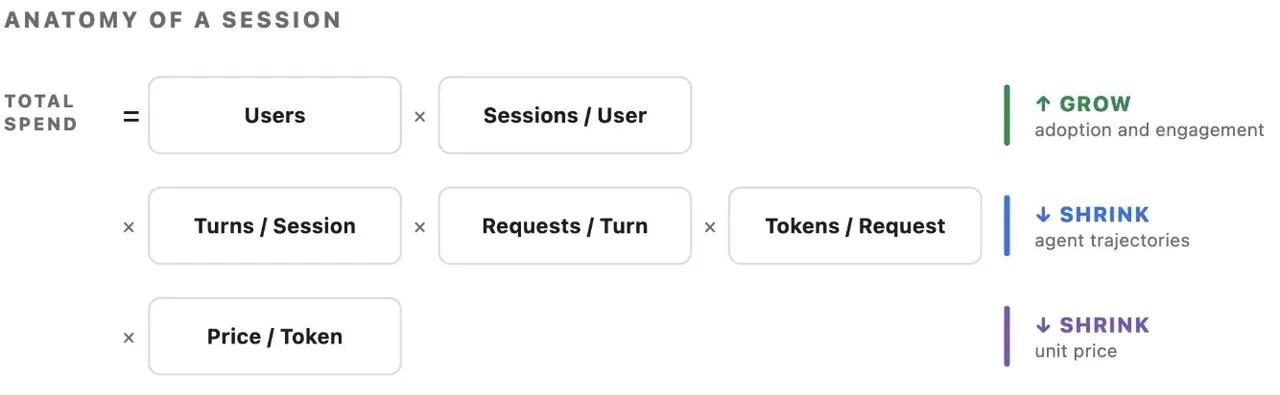
前两项代表采用率与参与度,我们希望它们在整个用户群体中持续增长,无论用户是交互式使用,还是由智能体代表他们处理任务。中间三项提供了优化机会:智能体在工程师实际发出的请求之外,自行完成的工作。这正是我们投入大部分精力的地方,包括帮助智能体更快规划、减少不必要的轮次或错误、优化输入 token 等机制。
我们如何衡量
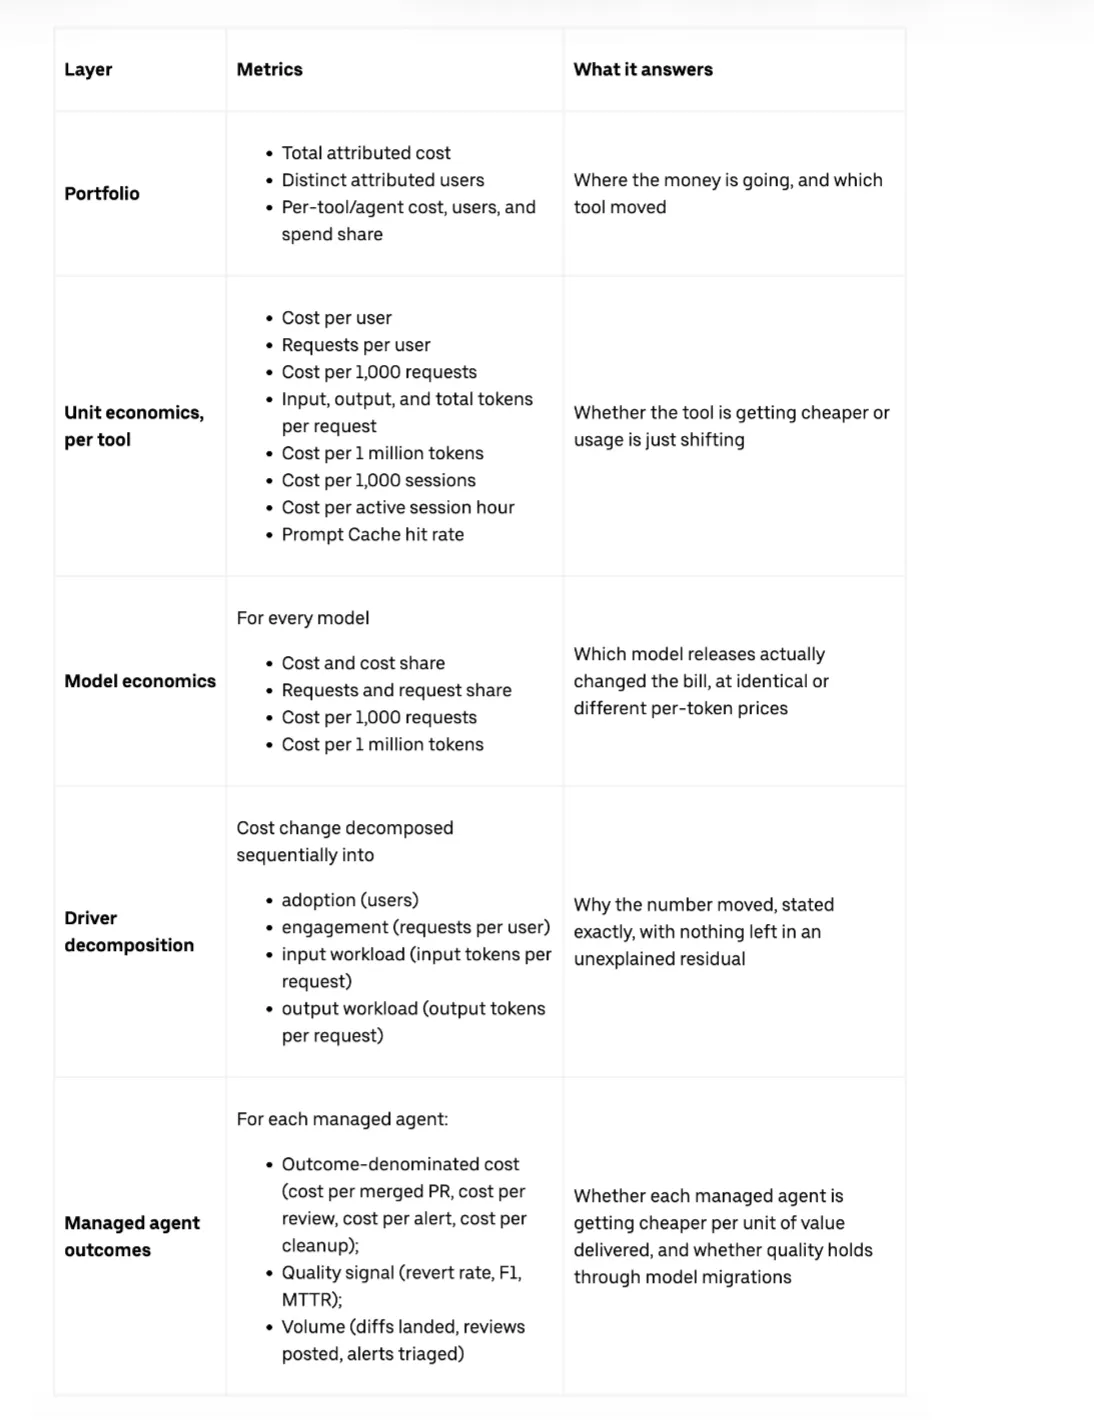
以下是我们在每周和每月追踪的完整指标集,它们使我们能够对短期和长期工作进行预测与规划。
优化杠杆
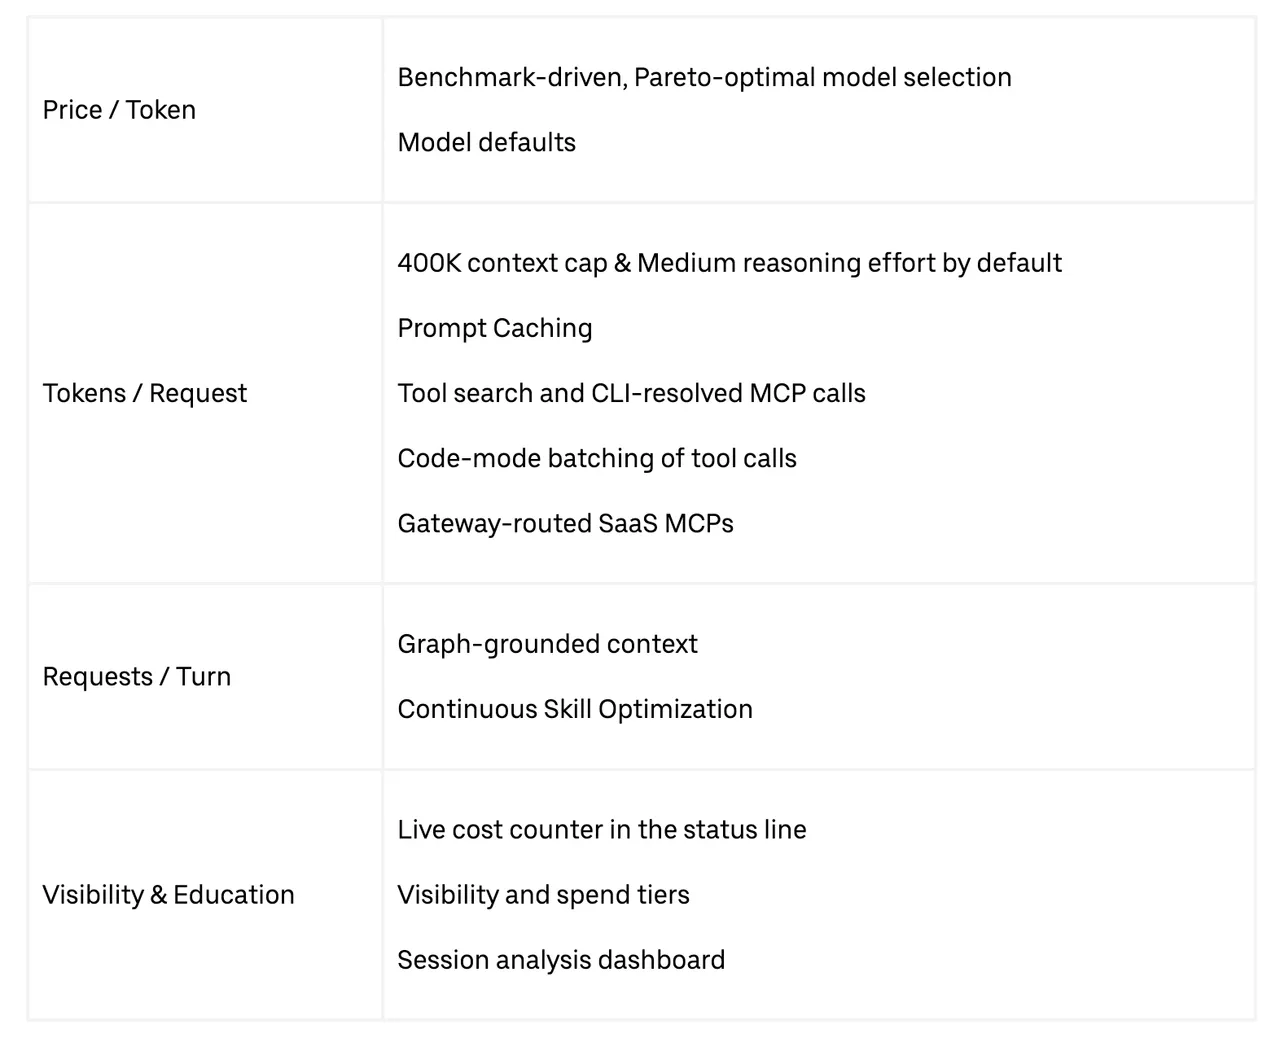
在以下各节中,我们将详细介绍用于优化成本公式各部分的关健杠杆。其中一些杠杆会影响到成本公式中的一行或多行。
优化价格 / token
供应商设定 token 价格,我们则选择哪个模型运行哪种工作负载。在我们所有托管智能体的层次中,我们选择对该工作负载最符合帕累托效率的模型。对我们而言,帕累托效率意味着每个完成任务成本、输出质量和模型可靠性。
基准驱动的模型选择
模型选择分四步进行,我们运行的每个托管智能体都采用相同的流程。
- 基于智能体的真实工作构建基准。
- 在一个可服务于任何模型(前沿或开放权重)的统一接口测试框架上运行智能体。
- 切换到任何帕累托最优的模型,并持续切换。前沿每几周就会移动一次。
展望未来,我们利用托管智能体的聚合洞察来测试和部署各种模型路由策略,从而不断优化工作负载性能。
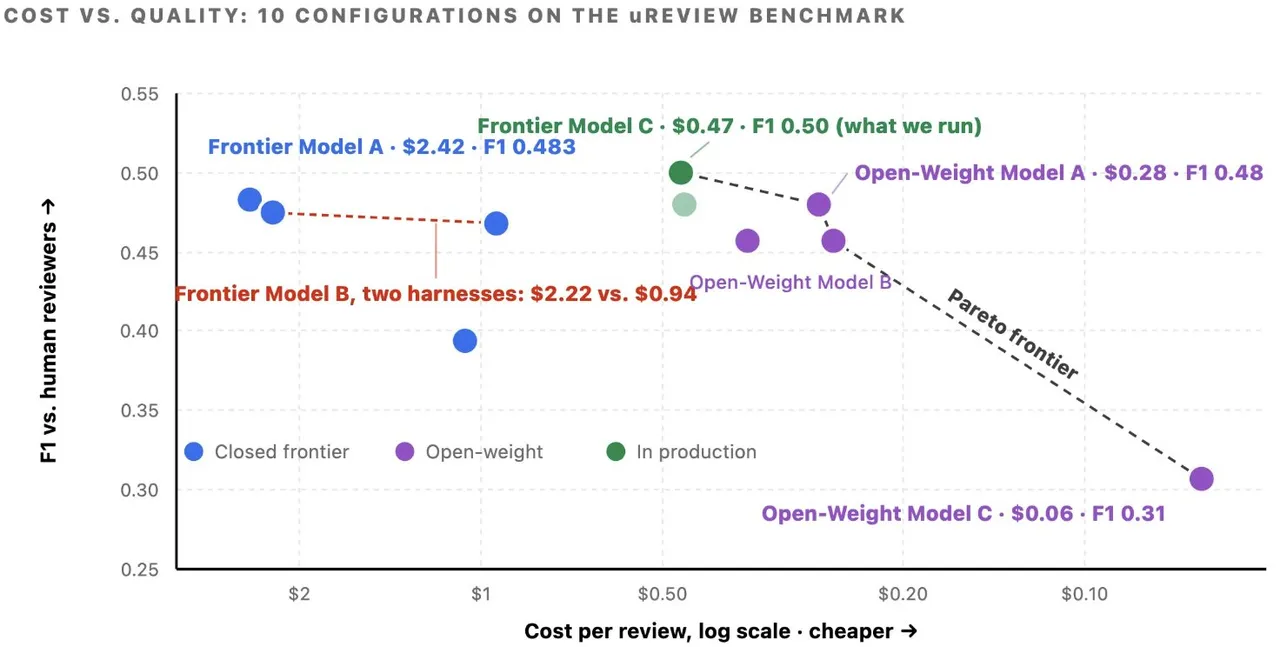
例如,我们使用 uReview,它负责对所有拉取请求进行 AI 代码审查。我们基于包含已知 bug 的真实拉取请求构建了它的基准,并将其分级为简单、中等和困难。我们针对这些 bug 评估精确率、召回率和 F1 分数,同时衡量每次审查成本、延迟、超时和噪音。如图 5 所示,切换模型提高了我们的 F1 分数,同时大幅降低了每次 PR 的成本。图中虚线是帕累托前沿。其下方和左侧的一切都被更便宜或更好的方案所超越。
利用我们大型单体仓库中的数千个真实 PR,我们内部还构建了一个 Uber SWE 基准,在不同任务类型上运行前沿和开放权重模型。我们用它来为所有 SDLC 托管智能体的模型选择提供依据。
默认模型选择
在交互式界面中,token 单位成本保持不变;但是,你可以策略性地管理各模型之间的 token 分配。两个默认设置主要控制这种分配:初始会话模型和子智能体模型。
子智能体默认设置已被证明是最具影响力的杠杆,而且其重要性还在持续增长。随着最新模型能力使更有效的多智能体编排成为可能,启动子智能体的会话比例稳步上升。由于子智能体执行定义明确的任务,输入内容明确,通常不需要前沿级别的推理,因此我们将它们默认设置为较弱但更具成本效益的模型,同时仍允许手动覆盖。主模型负责任务分解和评估,而子智能体则执行具体工作。
优化 token / 请求
每一轮都会重新发送完整的对话历史、项目上下文和工具结果。任何减少每请求负载的措施都会在整个会话中产生累积效应。
默认设置
所有交互式测试框架都使用统一包装器进行安装管理、配置、身份验证和成本可见性。两个标准化的默认配置直接减少了每次请求的 token 消耗:
- 即使对于 1M 上下文窗口的模型,自动压缩也会在 400k token 时触发: 该阈值在模型性能与缓存突发和重复输入 token 成本之间取得平衡。我们的测量显示,整个机群的每次请求输入 token 显著减少。
- 推理强度默认设为中等:输出 token(包括内部推理 token)按主模型输入 token 费率的倍数计费;这一策略调整直接减少了最高成本 token 类别中的支出。对于很大一类任务而言,中等推理强度在成本与质量之间取得了良好平衡。
提示词缓存策略
我们的提示词缓存策略由提供商提示词缓存读写成本的经济性驱动。由于每一轮都会重新传输完整的对话历史,缓存前面的上下文可以避免重复支付全部成本,将后续读取成本降低到标准输入 token 费率的 0.1 倍。然而,写入溢价各不相同:5 分钟缓存条目成本为 1.25 倍,而 1 小时条目成本为 2 倍。因此,选择最优 TTL(生存时间)取决于轮次之间的间隔时长。可用的 TTL 选项包括 Anthropic® 提供的 5 分钟和 1 小时,以及 OpenAI® 提供的 30 分钟。
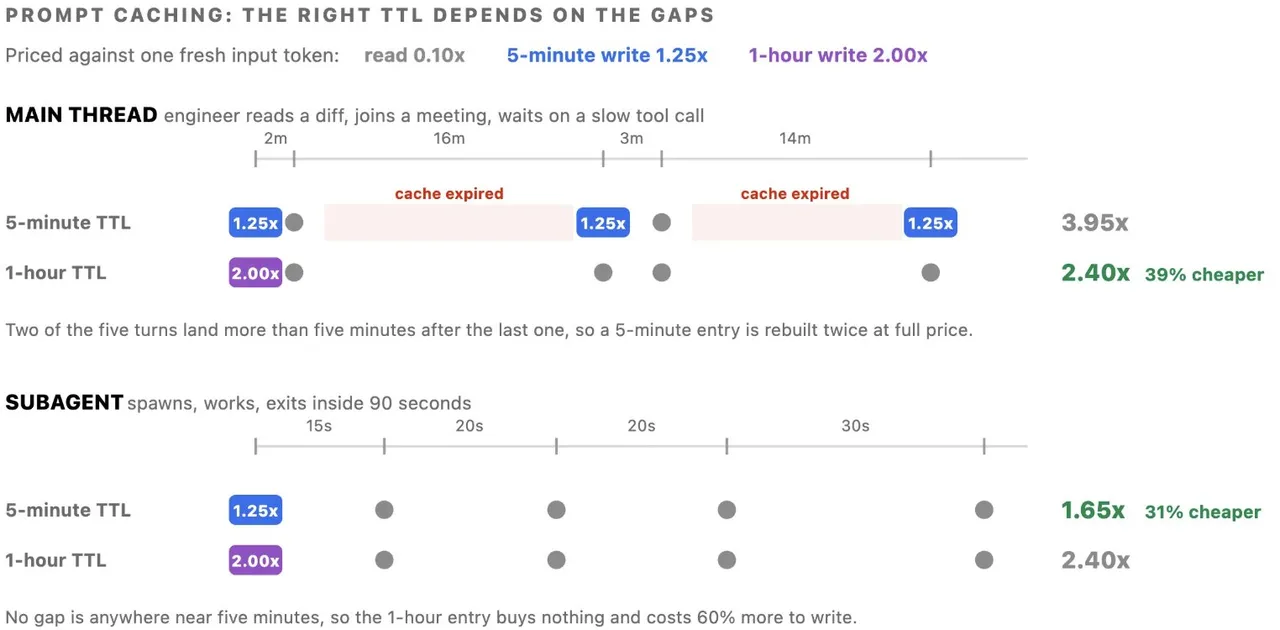
因为工程师经常让交互式会话空闲超过 5 分钟,我们将默认的 5 分钟 TTL(生存时间)调整为 1 小时窗口。这些频繁的空闲间隙之前会导致前缀缓存失效,迫使进行成本高昂的全价上下文重建。相比之下,子智能体保留 5 分钟的缓存 TTL,因为它们的执行重点仅限于单个短时任务。
通过 Shell 执行 MCP 工具
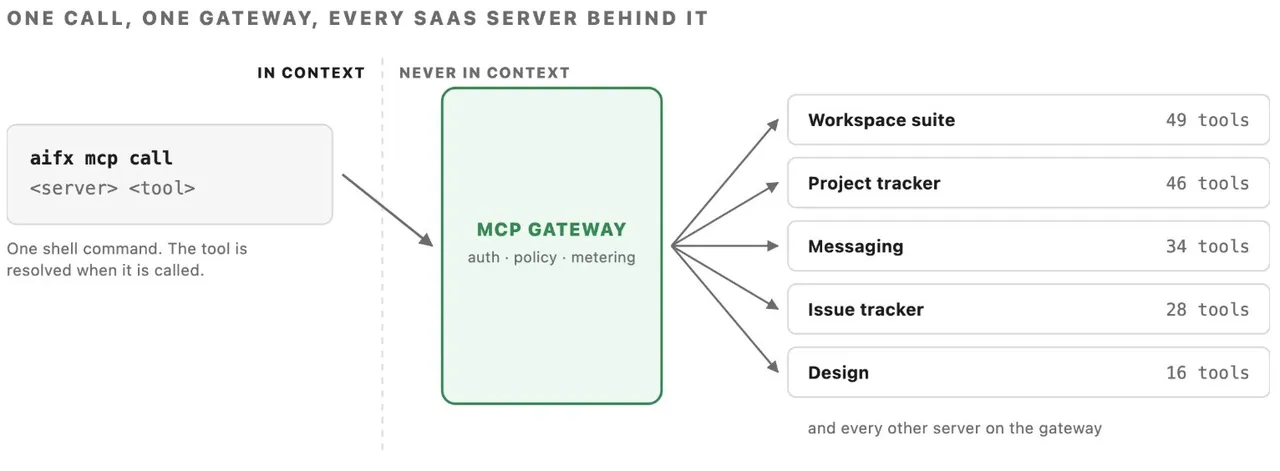
在 Uber,所有 MCP(模型上下文协议)交互都通过统一网关进行路由。这个单一入口点涵盖了超过 1000 个内部及第三方 SaaS MCP 服务器,实现了集中式身份验证和策略执行。
然而,标准的 MCP 会将所有工具模式直接加载到每个会话中,无论工程师在该会话中是否会调用它们。例如,安装了超过 100 个工具时,这种预加载会为初始提示词增加大约 50K-70K token 的模式开销,并且这些信息会在每次上下文轮次中重新发送。
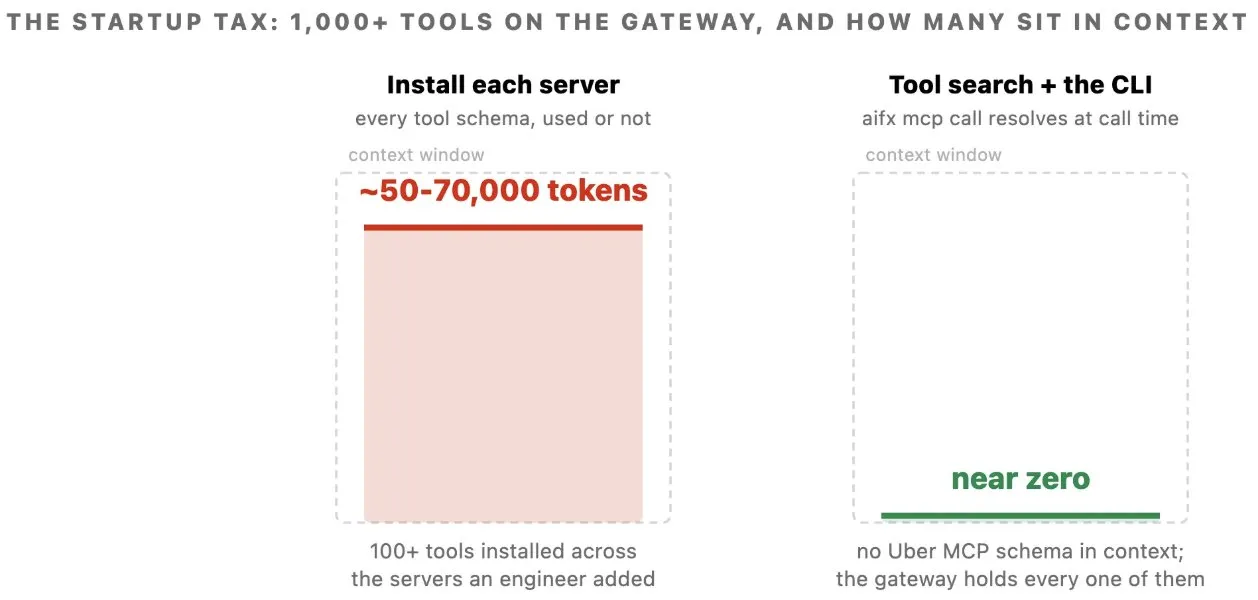
为了解决这种上下文膨胀,我们引入了两种互补的优化机制:
- CLI 工具解析:通过允许模型执行 shell 命令来取代直接的 MCP 集成。CLI 在调用时动态地针对网关解析并调用所需工具,从而消除会话上下文中的 Uber MCP 模式。我们内部 MCP 网关中的所有 1000 多个 MCP 工具都被映射为 CLI 命令。
- 工具搜索:通过允许模型搜索工具目录并按需仅加载所需工具,可扩展至数千种工具。这种方法减轻了上下文膨胀,通常能减少工具定义中的 token 使用,并能在可用工具库扩展时保持高选择准确性,防止与大型工具集相关的性能下降。
代码模式
当工具作为 shell 命令直接调用函数时,模型可以在单个脚本中批量处理多个操作。这种批处理对于协议交互频繁的工具尤其有利。在标准的 MCP 工作流程下,每个操作都需要模型单独一轮来发出请求、将原始响应加载到上下文窗口中,并顺序处理结果。例如,执行单个 SQL 查询需要提交请求、轮询状态 2 到 5 次,以及检索输出。代码模式将整个流程简化为一个自动化的 Python 循环,使中间轮询不进入模型的活跃上下文。如图 8 左侧所示,模型参与轮询循环,每个响应都会进入其上下文。在右侧,循环在子进程中运行,只有摘要返回。
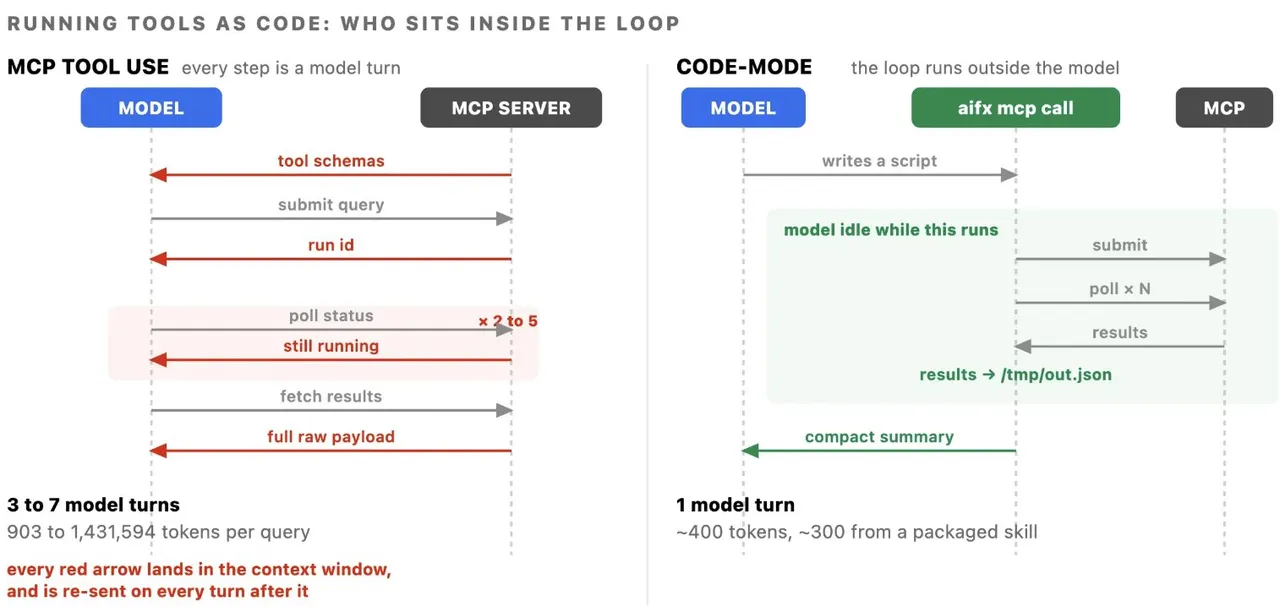
我们通过在同一个会话中通过两种路径运行 5 个相同的 SQL 查询来衡量这一效果:
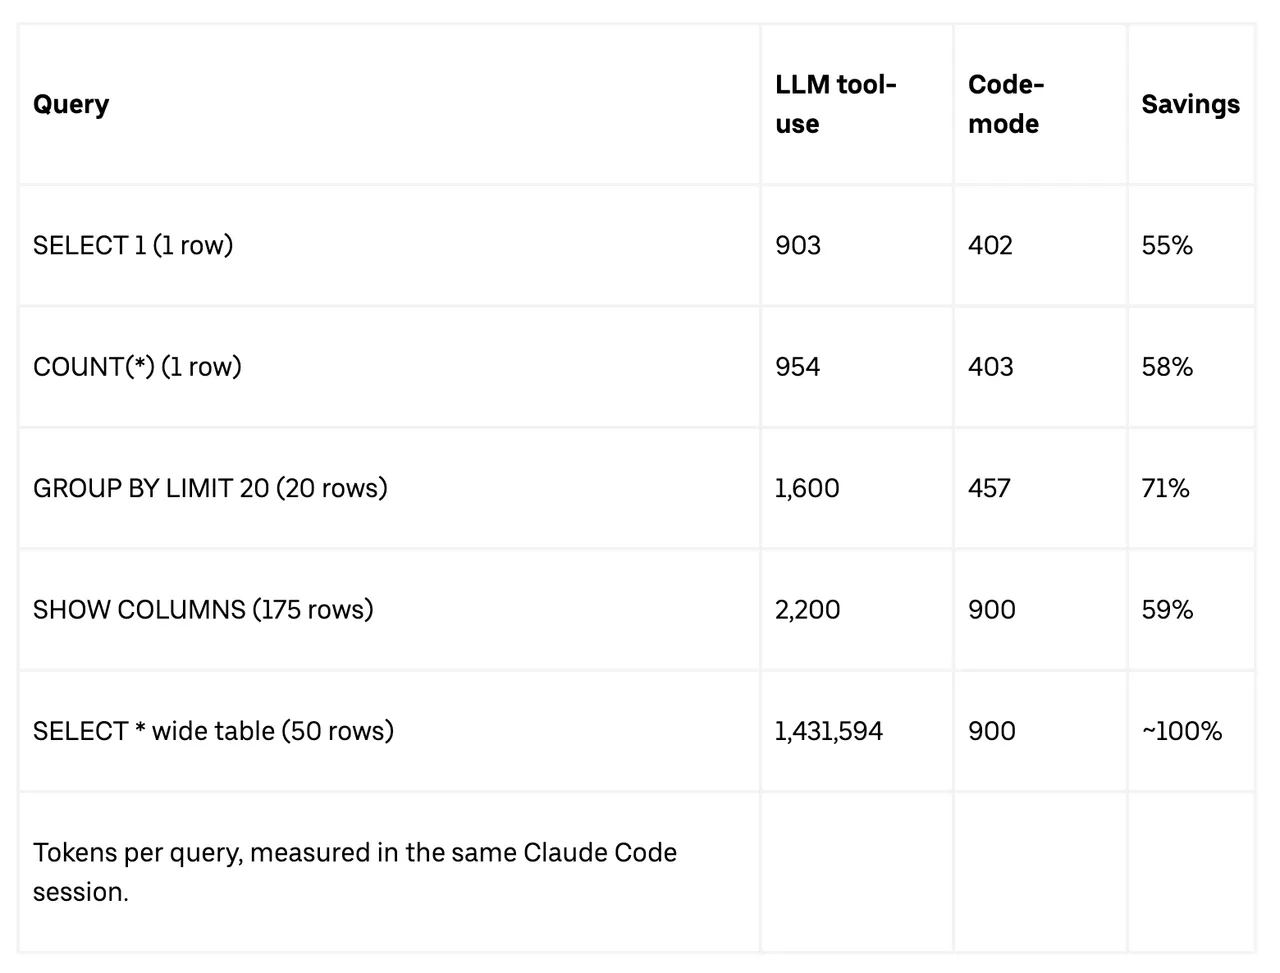
前三行突显了主要发现:即使对于远低于响应大小限制的最小结果集,代码模式也能将 token 使用量减少超过 50%。这些效率并非通过绕过大数据负载实现,而是源于消除不必要的开销,包括模式初始化、多轮轮询和冗余的逐步推理。
批量工作流程会放大这种效果,因为原本需要 N 轮模型交互的循环变成单个脚本,节省的成本会累积到超过 90%。通过为访问最频繁的 MCP 服务器部署超过 25 个预构建的代码模式技能,我们确保标准工作流程默认采用最经济高效的路径。
SaaS MCPs
管理第三方软件比管理内部服务器更具挑战性。供应商设计 MCP 服务器以展示完整产品功能,因为他们无法预测特定客户的使用情况。例如,一个工作区套件将 49 个工具捆绑到一个服务器中,需要约 22K token 的模式;而消息和项目跟踪供应商分别提供 34 和 46 个工具。加载两三个供应商服务器会使智能体在用户输入提示词之前就携带比正在编辑的文件更多的模式开销。
为解决此问题,我们通过与内部 MCP 相同的机制,将 SaaS MCP 服务器路由到我们的 MCP 网关。我们还将所有这些 MCP 作为 CLI 暴露出来,任何智能体界面都可以调用它们。此外,我们在代码模式插件中为每个服务器编写了专用技能,以封装常见工作流程。这解锁了跨多个 SaaS 供应商的高效智能体工作流程。
优化每轮请求数
一个缺乏依据的智能体会缓慢而非廉价地失败,它会反复发送不断扩展的上下文窗口,以再搜索一个位置。在前端提供更丰富的信息仍是减少这种搜索开销的最强大杠杆。
上下文工程
在 Uber 庞大的代码库和数据生态系统中,包含数亿行代码和数千张表,智能体大部分轮次都花在定位信息上,而非生成代码。为解决此问题,我们构建了 AI 上下文图:一个统一的网络,包含 2400 万个节点和 8000 万条边,涵盖 86 种节点和 117 种边类型。它整合了来自 30 多个内部系统的数据,包括服务、工程团队、事件日志、拉取请求、架构设计文档、部署、数据集和历史表使用查询,并允许任何智能体用自然语言查询它。
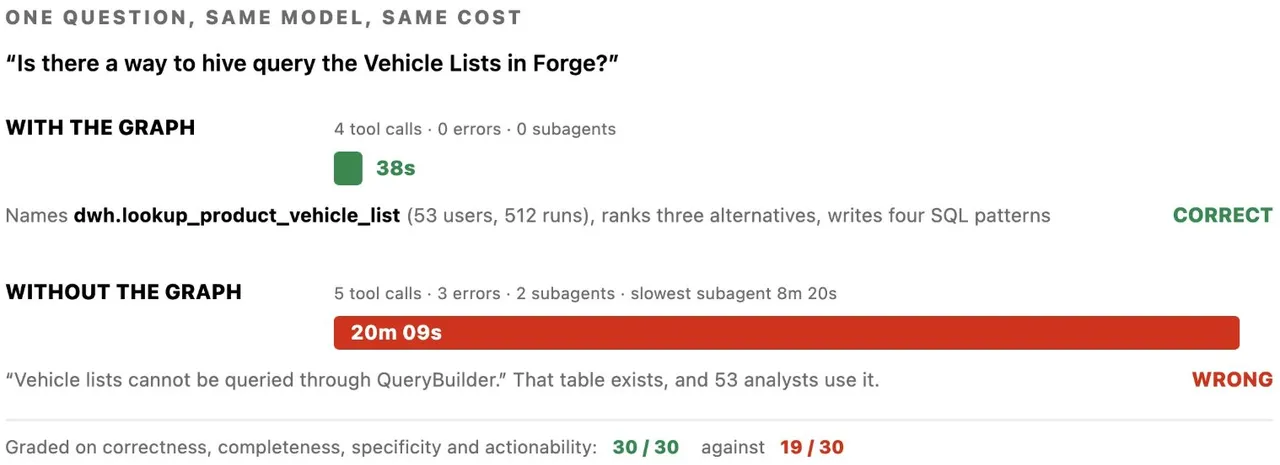
有依据的智能体查询了历史使用情况,确定了超过 50 名分析师使用的特定表,并在 38 秒内给出了答案。相反,无依据的智能体无法看到该表;它花了 20 分钟检查服务代码,产生了 2 个子智能体,遇到 3 个错误,最后错误地得出结论,认为该数据集无法查询。
Visibility & Education(可见性与教育)
这里的杠杆是可见性和反馈循环,它们有助于工程师和智能体更快地收敛。
状态行
我们在工具状态行中放置了实时成本计数器,用于跟踪每个工具以及每个用户的跨所有工具的实时支出。

可见性与支出层级
为避免实施严格上限,我们实施了实时支出跟踪和自动提醒:
- 状态行实时计数器。 终端中始终显示正在运行的会话成本。
- 工具池。 所有交互式工具共享一个层级,而非每个工具单独预算。托管智能体有单独的层级。
- Slack 提醒。 在预期支出的 50/80/100% 时发出提醒,以便工程师有时间规划。
- 简便的审批流程。 经理审批层级升级,并可快速传播。
- 成本检查技能与提示。 一个仪表板技能,用于按需成本分解和实时状态行指导。
这些使工程师能够独立评估任务的投资回报率,同时抑制失控的支出。
会话分析仪表板
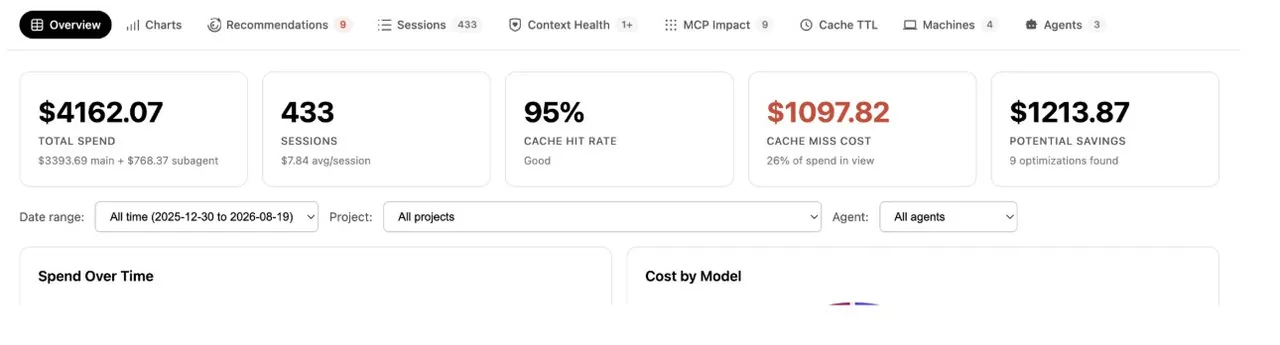
虽然状态行能突出显示会话的总支出,但它缺乏对成本驱动因素或可操作效率步骤的可见性。一般性指导提供了高层原则,但无法评估个体开发者的工作流程。会话分析仪表板通过直接检查会话工件来弥补这一差距。
它直接内置于运行时中,无需任何设置或选择加入。执行 成本仪表板 技能会分析用户在所有使用的工具中跨本地和远程云沙箱的所有会话轨迹。它不会生成一个汇总指标,而是会跨会话标记 16 种不同的反模式,将每种模式与其财务影响和针对性的补救措施配对。其中一些类别包括:
- 次优模型路由:在 Opus 上执行简单的多轮会话,而 Sonnet 完全可以满足需求。
- 上下文窗口膨胀:大型 MCP 负载(例如 40KB 的响应)持续存在于上下文中,并在后续轮次中导致重复计费。
- 缓存过期低效:在长时间中断后恢复会话,此时过期的提示词缓存会强制进行全价前缀重建。
- 提示词初始化开销:在用户提供任何输入之前预加载 100,000 token 的系统指令和工具定义。
下一步是什么?
目前正在推进的计划包括:
- 扩大受管智能体队伍:对于每一个新智能体,我们遵循一致的路线图:确定目标结果指标、建立评估基准、确定帕累托最优模型。这种系统化方法旨在将 SDLC 的每个阶段提升到工厂成熟度模型的更高层次。
- 动态模型路由:我们正在跨多种编程语言、代码仓库和智能体模式扩展基准覆盖。鉴于模型能力差异巨大,有效的模型路由高度依赖全面的评估。
- 深化上下文图集成:我们正在为更广泛的自主智能体解锁图查询能力。
- 将会话分析演进为实时开发者指导:通过从周期性批量检测反模式转向持续追踪监控,我们旨在向工程师直接提供个性化、实时的效率建议。
- 持续技能改进:我们正在开发一种自动化方式,记录智能体技能执行中的小问题,并从收集的追踪中自动生成技能更新。
Conclusion(结论)
管理和控制不断上升的 AI 编码成本也是一项可处理的工程挑战。通过消除浪费的、零价值的 token 消耗,而不是仅仅依赖降低单价或降级工具,我们将使用量扩展了 7 倍,同时降低了所有指标的单位成本,并提升或保持了输出质量。
核心战略转变是从交互式开发者工作流转向完全受管的智能体。将 SDLC 工作负载迁移到受管环境,可以完全控制模型路由、执行框架和运营支出。优化一支专门的受管智能体队伍,每个智能体配备专门的评估基准和帕累托高效模型,本质上比优化数千名工程师的个人终端会话更具成本效益和可扩展性。
Acknowledgments(致谢)
这是众多工程师的集体成果,他们正在构建最高效的模块,在 Uber 规模上实施软件工厂,同时确保我们花费的每一个 token 都能获得投资回报。我们要感谢参与软件工厂各项工作的核心团队,名单如下:Abhishek Bhatia, Adam Huda, Aditya Patel, Alok Srivastava, Ameya Ketkar, Anil Purohit, Atakan Kandemir, Ben Chou, Brandon Barker, Danielle Yim, Deepanshu Mehndiratta, Gaurav Gill, Israel Marban, Jason Varbedian, Karen Xu, Lei Shi, Mager Mager, Meghana Somasundara, Peng Liu, Preet Inder, Qiushen Wang, Rush Tehrani, Shesh Patel, Shiven Tripathi, Shubham Gupta, Stas Khalup, Ting Chen, Tse-Shi Wang, Ty Smith, Vikram Hullukunte, Weiqiang Wang, Will Bond.
同时感谢 Johannes Gehrke、Mattie Toia、Sumanth Sukumar 和 Praveen Neppalli Naga 的领导。
*Anthropic® 是 Anthropic PBC 的注册商标。
Claude Code™和 Claude® 是 Anthropic, PBC 的商标。
OpenAI® 及其标识是 OpenAI® 的注册商标。*
