技能介绍
Interview Coach 是一个基于 Claude Code 的面试教练,覆盖求职全流程——从 JD 分析和简历优化,一路到模拟面试和拿到 offer 之后的谈薪。它包含 23 条命令,分布在申请材料、面试准备、练习模拟、复盘分析与薪酬教练几类。
它给自己的定位很明确:不是通用题库,而是一个自适应系统,越用越准。 它会按 Substance、Structure、Relevance、Credibility、Differentiation 五个维度给你每次回答打分,并且把分数映射到根因(身份焦虑、叙事囤积、回避冲突等)和对应的针对性练习;它建立一套可以在高压下检索的故事库,并根据你的具体行为模式调整教练策略。说一句 kickoff、把简历贴进去,两分钟内你就在被教练了。
作者是 Noam Segal,仓库采用 MIT 许可。
适用场景
- 拿到一份 JD 想先判断值不值得投,需要拆解它真正在要什么人;
- 简历要被 ATS 和人同时读到,需要按目标职位做针对性优化;
- 面试前想要一份针对该公司、该轮次的准备简报,包括面试官视角;
- 面完之后手里有 transcript,需要复盘每轮回答并知道下一步练什么;
- 连续面试多家但没有进展,需要从拒绝模式里找出定位问题;
- 拿到 offer 要谈薪,需要具体话术和备选方案。
核心能力
- 打分与诊断:每个回答按 Substance、Structure、Relevance、Credibility、Differentiation 五维打分,并按你的资历校准;分数会映射到根因和针对性修法,而不只是"再努力一点"。
- 自适应教练:打分后用决策树判定你的瓶颈并分支到对应训练——Relevance 弱就练问题解码,Substance 弱就补原材料;不会给每个候选人跑同一套流程。
- 多格式 transcript 分析:可粘贴 Otter、Zoom、Grain、Google Meet、Teams、Tactiq、Granola 等工具的原始 transcript,系统自动识别并归一化格式。分析随面试类型变化:行为面做 Q&A 解析,系统设计做阶段分析(定范围、方案、深入、取舍、适应),面板面追踪跨面试官动态,混合格式处理技术与行为段之间的模式切换;每种格式有自己的反模式检测和附加评分维度。
- 故事库与作品集优化:结构化故事管理,含完整 STAR 文本、earned secrets、强度评级与快速检索训练。故事到问题的映射用 4 级匹配(Strong Fit、Workable、Stretch、Gap),并做作品集优化——当多个问题争抢同一个故事时解决冲突,跟踪新鲜度与过度使用,优先选择 earned secrets 强的故事。叙事身份提取会找出跨故事的 2-3 个核心主题,让每个回答都在强化同一个关于"你是谁"的论点。
- 练习与模拟:8 阶段训练进阶(约束阶梯、抗压反驳、转向训练、面板模拟、压力测试),加上 4-6 题的行为面、系统设计、案例、面板、技术+行为混合模拟。每一轮都给出面试官视角——你说话时他实际在想什么。角色训练分数会映射到核心维度,专项练习因此纳入整体趋势分析。
- 结果校准:跟踪练习分数是否真的预测了真实面试结果;累计 3 场以上真实面试后运行打分漂移检测,发现外部反馈与教练评分矛盾时重新校准,并把跨维度根因(如"回避冲突"同时影响 Substance 和 Differentiation)合并处理。
- 岗位匹配评估:从需求覆盖、资历匹配、领域相关性、能力重叠、轨迹一致性五个维度评估人岗匹配,区分强匹配、可投资的高攀和长线机会。
- 公司情报:Quick Scan、Standard、Deep Dive 三档研究深度,配合结构化检索协议与断言核验——每条公司相关信息都标注来源层级(已核实/常识/未知)。
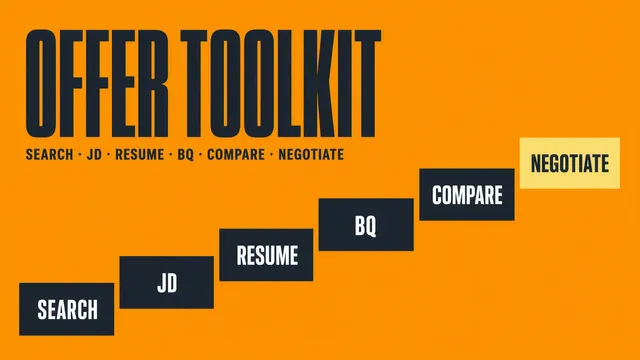
- 求职生命周期管理:公司研究、带面试官情报的岗位准备简报、当天面后复盘的 debrief、把练习分数与真实结果关联的结果追踪,以及带完整话术的 offer 谈薪教练。
- 面试情报:每次 transcript、复盘和招聘方反馈都会进入个人知识库——跨公司的问题模式、对你个人有效和无效的做法、反馈与结果的关联;数据带时间衰减,过期数据会被标记而不是默认采信。
- 会话连续性:一个持久的
coaching_state.md记录故事库、分数、模式、训练进度、面试轮次、面试情报和校准状态,几周后回来可以接着上次继续,且自动保存。 - 质疑协议(直率度 5 级):在最高直率档位,教练会通过五个视角主动挑战你——假设审计、盲区扫描、事前验尸、魔鬼代言人、强化路径。故事在新增或改进后被红队审查,transcript 被质疑,第 3 轮起的练习附随机质疑注记,进步报告含"难听的真话"板块;它还会检测回避模式,如果你一直绕开某个弱点,它会直接点出来。1-4 级完全不受影响。
其他单项能力还包括:引导式流程(每条命令后基于教练状态推荐具体的下一步,而不是给菜单;识别"帮我准备 Google 的面试"这类多步意图并串起完整序列)、LinkedIn 资料优化(按平台机制逐节审计:招聘方布尔搜索、算法分发、各节影响)、简历优化(ATS 解析与排序、招聘方扫读行为、要点质量、资历校准、关键词覆盖、结构、疑虑管理、跨渠道一致性)、核心定位(10 秒电梯、30 秒社交、60 秒招聘方通话、90 秒面试 TMAY 等多个版本)、networking 外联教练(冷启动 LinkedIn 消息、引荐请求、informational interview、招聘方回复、跟进序列、内推)、JD 解码与批量分诊(6 个解码视角 + 置信度标签)、演示轮教练(四种叙事弧、按约 130-150 词/分钟校准内容密度)、早期流程薪酬教练(招聘方初筛的"期望薪资"问题、薪资历史处理、申请表策略)、差异化(earned secrets 与 spiky POV 是一等维度)以及自我认知(追踪你自评与教练评分的差距,判断你是高估型还是低估型)。
效果预览
工作方式
23 条命令
招聘准备类:research [company] 公司研究 + 结构化匹配评估(3 档深度);decode JD 分析 + 批量分诊(3 档深度、6 个视角);prep [company] 岗位准备简报(感知面试形式与文化、评估人岗匹配);concerns 预判面试官疑虑;questions 生成 5 个非通用提问;present 演示轮教练(3 档深度)。
申请材料类:linkedin LinkedIn 资料优化(3 档深度);resume 简历优化(3 档深度,有 JD 时做定向版);pitch 核心定位陈述与场景变体;outreach networking 外联教练(3 档深度、9 类消息);apply [company] 起草网申筛选题答案。
对话前类:salary 早期/中期薪酬教练(3 档深度);hype 面试前信心与心理热身(5 级时含事前验尸)。
练习与模拟类:practice 训练轮次(有进阶闸门,5 级时含质疑注记);mock [format] 完整模拟面试 4-6 题;stories 建立/管理故事库 + 快速检索训练(5 级时用 5 个质疑视角做红队审查)。
分析与面后类:analyze 按格式解析 transcript,基于分诊给教练建议,附面试官内心独白(5 级时含结构化质疑);debrief 当天快速复盘;progress 趋势、自我校准、结果追踪、打分校准(5 级时含"难听的真话");feedback 记录招聘方反馈、结果、纠正、上下文或对教练本身的反馈(5 级时从拒绝中提取筹码);thankyou 面后跟进草稿;negotiate offer 谈薪教练;reflect 求职复盘与归档;help 显示命令菜单(带上下文感知)。
加 kickoff 共 25 条可执行条目——官方 README 导语写的是"23 条命令",命令表与 references/commands/ 目录实际列出 25 个(含 help)。
两条路线
- Quick Prep:面试时间紧时用——公司研究、准备简报、聚焦的 transcript 分析、立刻可做的下一步。
- Full System:多周求职时用——带检索训练与作品集优化映射的故事库、多格式 transcript 分析(行为面/系统设计/面板/混合)与决策树分诊、模式与趋势追踪、贯穿所有工作流的内置差异化教练、完整模拟面试、带闸门的 8 阶段训练进阶、面后复盘、结果追踪与打分校准、面试情报、跨公司轮次的面试 loop 感知、offer 谈薪教练、求职复盘与归档。
两条路线在 kickoff 时选择,之后可以切换。
你需要提供
- 一份真实简历(不是高层摘要);
- 目标职位与时间线;
prep需要完整 JD,知道面试形式的话一并给出;analyze最好用真实 transcript,给得越多分诊越准;apply需要粘贴网申筛选题,可选提供 JD 与每题字数/字符限制;negotiate需要 offer 细节、竞争 offer 和理想结果;- 可选:面试官的 LinkedIn 链接(用于逐个面试官的情报)。
你会获得
- 一份带优先级、按时间线调整的行动计划,以及后续每步的具体推荐;
- 五维打分卡、根因诊断和自评与教练评分的差距;
- 结构化故事库(含 earned secrets)与 4 级匹配的问题映射;
- 针对具体公司/轮次的准备简报:面试形式指引、文化解读、人岗匹配评估、面试官情报、预测问题(7-10 个)、故事映射、要问对方的问题、当天速查表;
- 带来源层级的公司研究结论与置信度标签的 JD 解码;
- 优化后的简历与 LinkedIn 各节改写、定位陈述及其多时长版本;
- 带话术的谈薪策略与备选语言;
- 一个持续更新的
coaching_state.md(自动保存),跨会话记录全部状态。
使用示例
Claude Code 安装与激活(需要任一付费 Claude 计划;也可用在 Cursor 或任何有文件系统访问的环境):
git clone https://github.com/noamseg/interview-coach-skill.git
cd interview-coach-skill
mv SKILL.md CLAUDE.md在 Claude Code 中打开该目录,说 kickoff 即可。OpenAI Codex 用户把 mv SKILL.md CLAUDE.md 换成 mv SKILL.md AGENTS.md(需要付费 ChatGPT 计划)。也可以直接下载 ZIP:https://github.com/noamseg/interview-coach-skill/archive/refs/heads/main.zip
典型指令序列:
kickoff                     # 建立档案、选路线、给行动计划
research Notion             # 先看公司再决定要不要准备
prep Stripe                 # 面试前生成准备简报
debrief                     # 面试当天快速复盘
analyze                     # 粘贴 transcript 做逐题分析
practice ladder             # 30s / 60s / 90s / 3min 约束训练
mock behavioral Stripe      # 完整行为面模拟
decode                      # 粘贴 JD 做解码与匹配评估
pitch                       # 建立核心定位陈述
outreach                    # 教练一条冷启动外联消息
apply HireRight             # 起草网申筛选题答案
negotiate # offer 谈薪训练进阶顺序为 practice ladder(约束训练)、practice pushback(应对质疑与打断)、practice pivot(问题与准备不符时转向)、practice gap("我没有例子"的时刻)、practice role(角色专项深挖)、practice panel(多面试官角色)、practice stress(高压模拟)、practice technical(边想边说、主动澄清、讲清取舍,仅系统设计/案例/混合格式);practice retrieval 为不计入闸门的独立训练(限时快速匹配故事)。
作者给出的最佳实践:分享真实简历、prep 带上完整 JD 与面试形式、analyze 用真实 transcript、用 stories 维护活的故事库并给每个故事提取 earned secret、每周跑 progress、真实面试后记录结果与反馈、重要面试前跑 mock、当天用 debrief 抓信号、投递前先 decode、第一通招聘方电话前先跑 salary、演示轮前先 present、网申有筛选题时用 apply。