
2.2 上基础能力:应用、模型、角色指令、变量与长期记忆
本节主要了解一个智能体在 ADP 中是如何被“定义出来”的:它叫什么、面向谁、使用哪些模型、遵循什么角色指令、如何使用变量传递信息,以及是否通过长期记忆形成个性化体验。
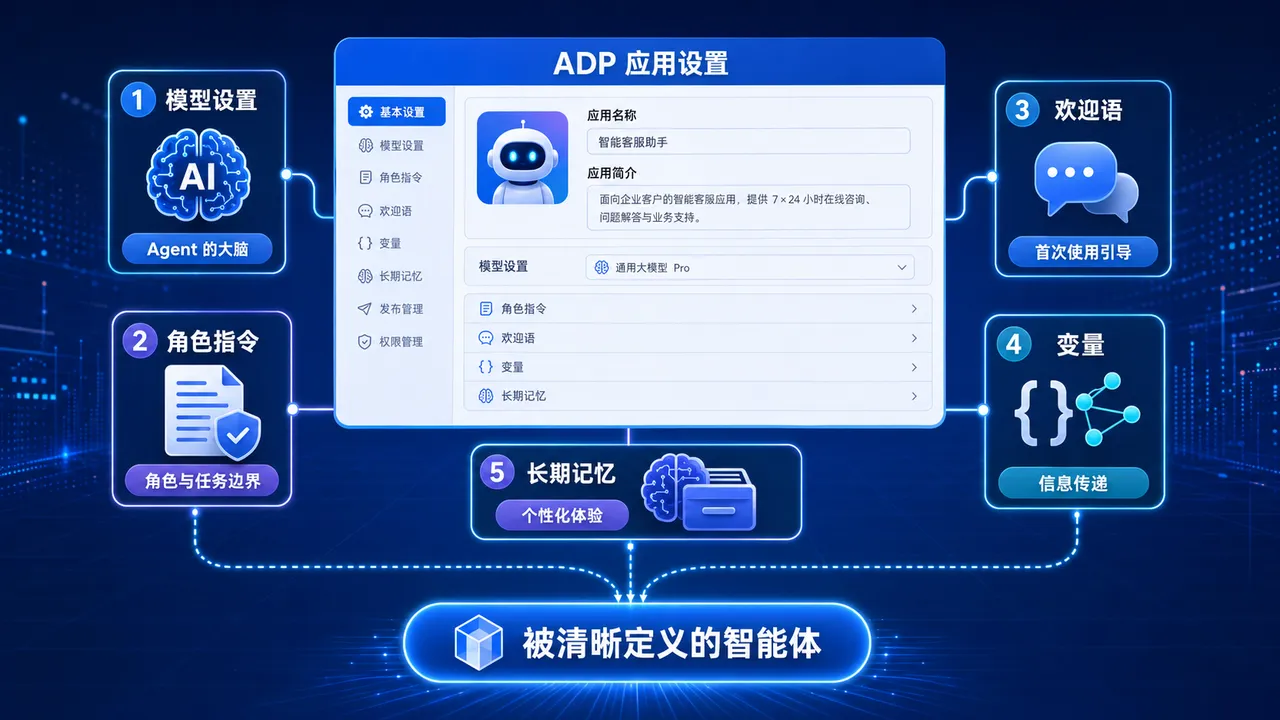
本节学习目标
学完这一部分,能够知道如何给 Agent 一个“大脑”和任务边界;了解应用基础信息可以编辑什么;理解 ADP 模型设置中各类模型的作用;知道角色指令如何限定模型回复的角色、语种、语气和版本;理解应用级变量、工作流级变量的类型与隔离范围;理解长期记忆如何为应用提供个性化对话体验。
一个智能体如何被搭建出来?首先,需要给 Agent 一个“大脑”和任务边界。这个智能体是谁?要完成什么任务?怎么说话?用哪个模型?记住什么?接下来我们将回答这些问题。
2.2.1 创建应用
通过智能体开发平台新建智能体应用,可利用大模型技术,实现可自主编排与决策,或按固定工作流高效执行流程完成任务。创建应用时,可以配置应用的基础信息、应用模式等。
| 基础信息
应用名称、图标、描述等,用于定义用户看到的智能体身份。
| 应用模式
可根据场景选择标准模式、单工作流模式、Multi-Agent 模式、Claw 模式或智能工作台。
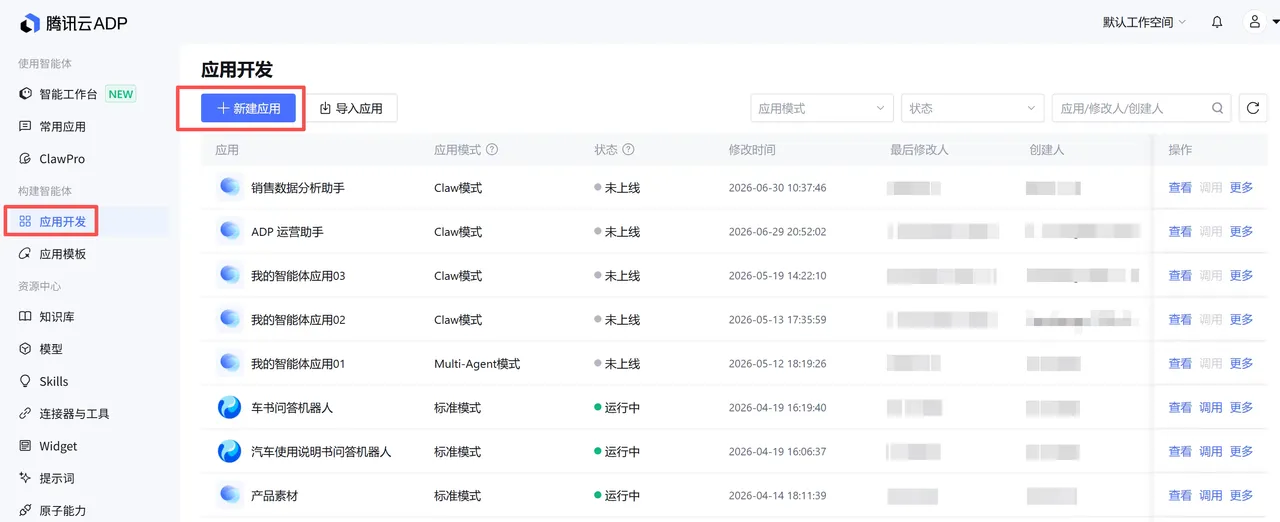
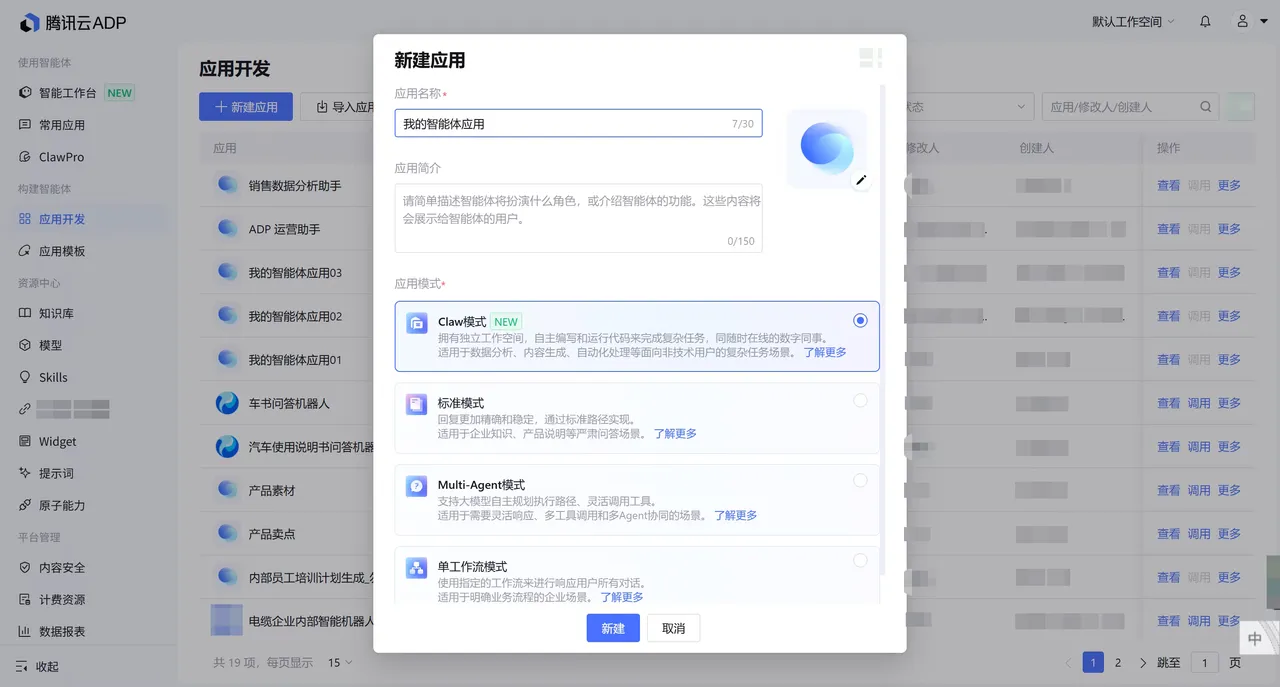
Tips:应用设置解决的是“智能体以什么身份存在”。它不会自动保证回答准确,也不会自动完成业务动作;回答准确依赖模型、Prompt 和知识库,业务动作依赖工具、Workflow 和权限配置。
创建应用后,进入应用设置页面,可对应用模型、知识库、输出配置等进行设置。以标准模式应用为例,应用设置页承载了大量应用配置能力。创建应用后,单击左上角应用图标,支持在“编辑应用”弹窗中修改应用图标、应用名称、应用简介等信息。
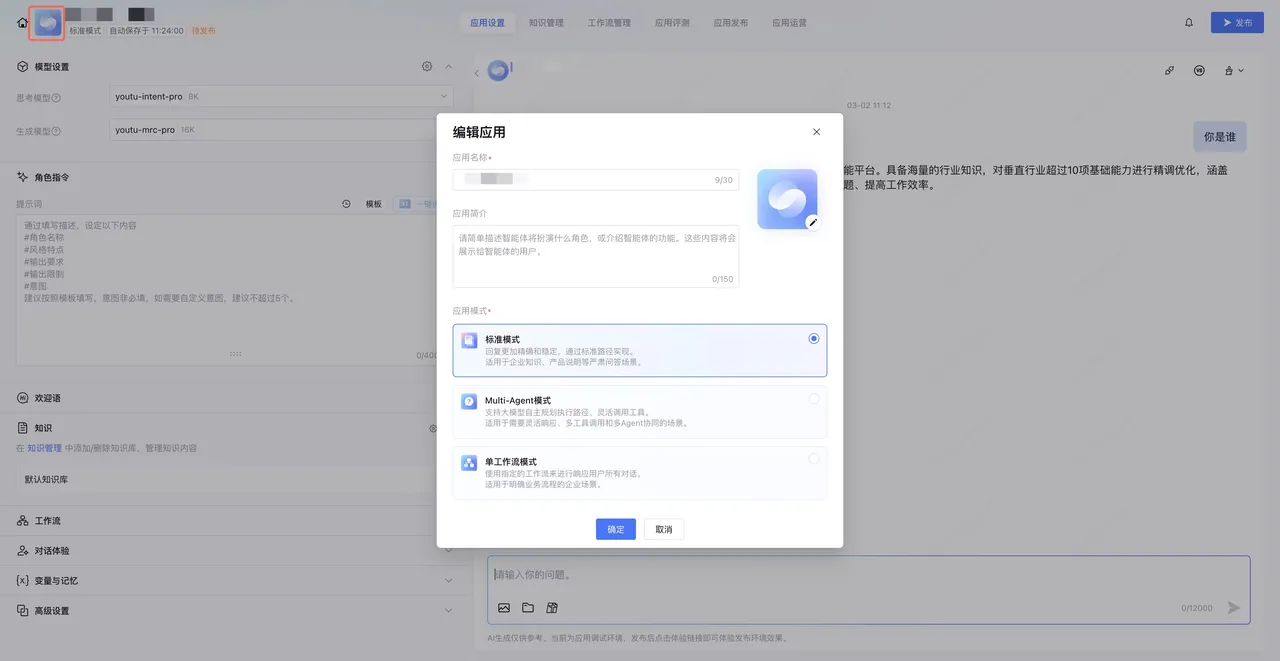
应用本身是一个可管理的智能体单位。应用图标、名称和简介决定用户如何识别这个智能体,也影响后续运营、交付和复用。对于标准模式、单工作流模式、Multi-Agent 模式三种应用,编辑应用弹窗中的“模式”区域会展示模式卡片,并支持切换至其他非 Claw 模式;Claw 模式应用不支持模式切换,编辑应用弹窗中的“模式”区域仅展示当前 Claw 模式卡片。
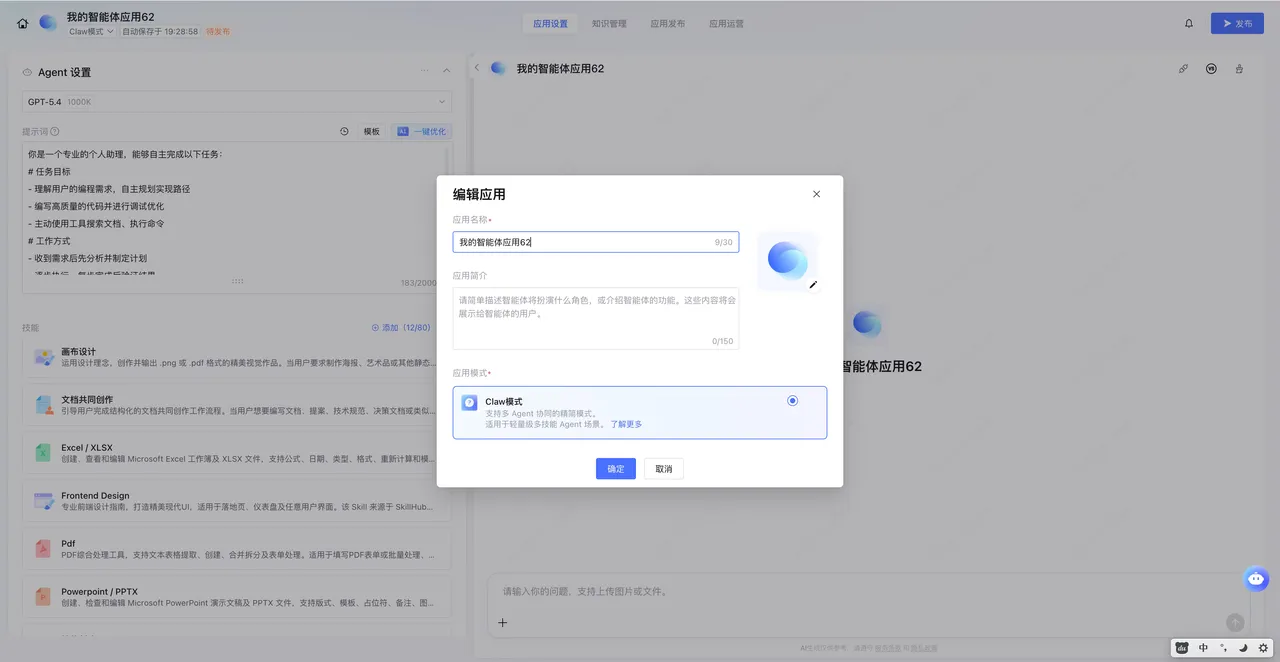
Tips:编辑应用可以修改应用身份信息,也能在部分模式间切换;但具体业务能力仍然取决于后续模型、角色指令、知识库、工具、变量、记忆、工作流和发布配置。
2.2.2 模型设置
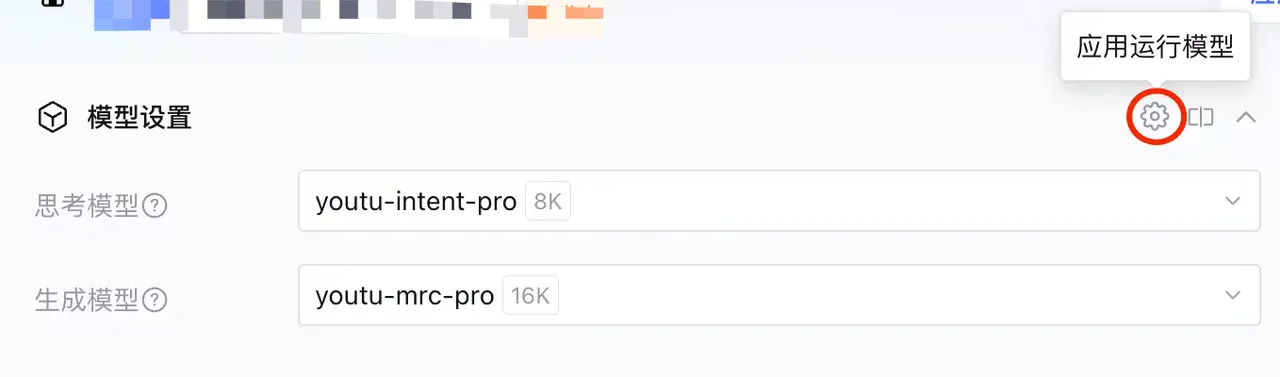
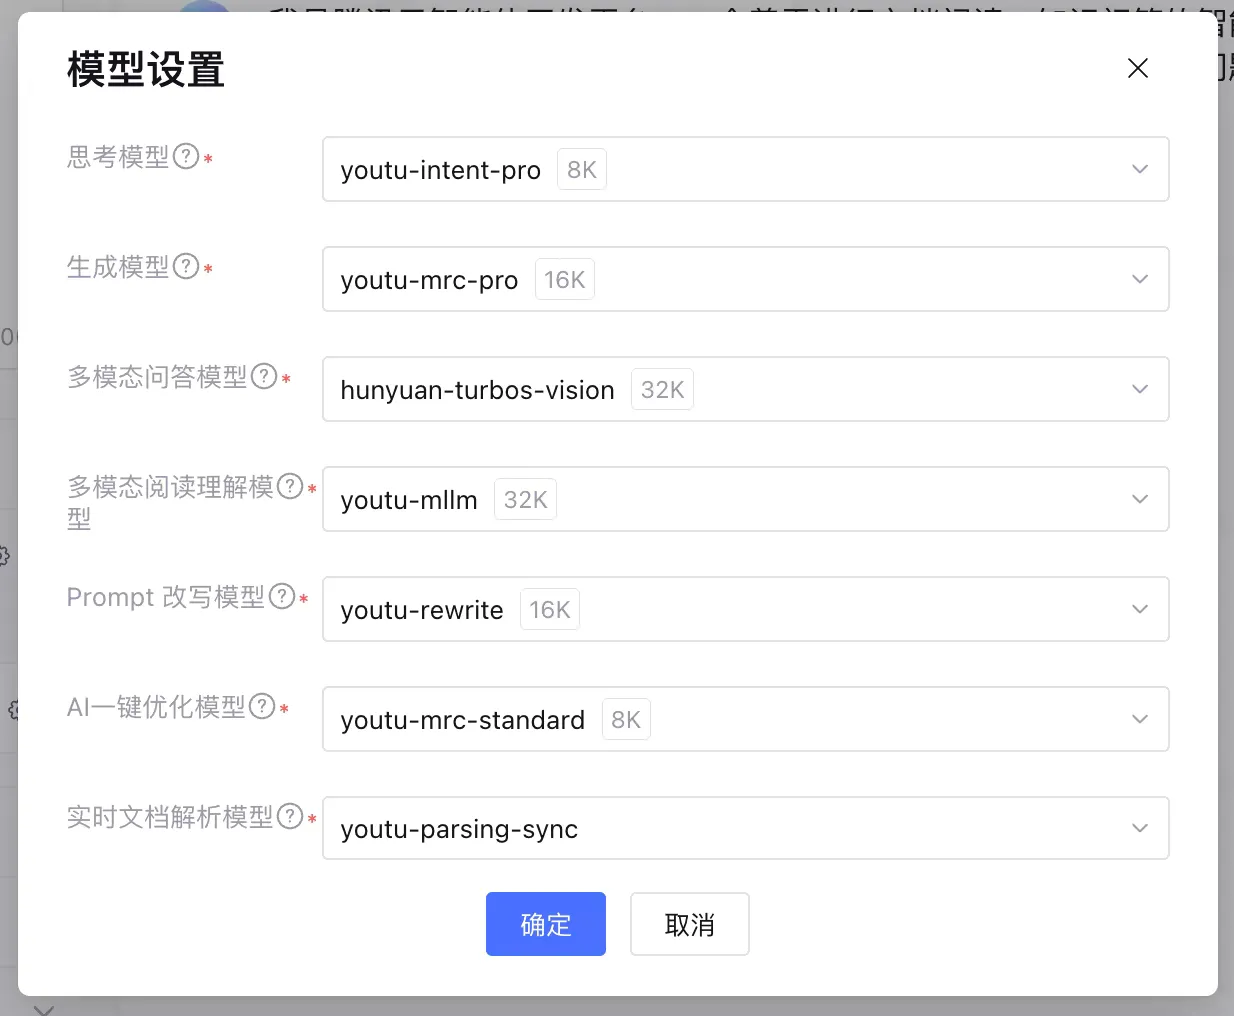
在模型设置中,ADP 支持对应用运行中的模型进行模型配置。不同模型在应用运行链路中的作用不同,不是所有模型都只负责“回答问题”。有的用于意图识别,有的用于生成回复,有的用于图片理解,有的用于知识库片段解析,有的用于 Prompt 改写和 AI 一键优化。
| 模型类型 | 作用说明 |
|---|---|
| 思考模型 | 用于意图识别(标准模式)、任务规划和选择连接器与工具(Multi-Agent 模式)。 |
| 生成模型 | 用于阅读理解、总结并生成回复结果。 |
| 多模态问答模型 | 用于对应用对话中用户上传的图片进行理解。 |
| 多模态阅读理解模型 | 用于对知识库检索召回的多文多图片段进行解析。 |
| Prompt 改写模型 | 用于解决多轮对话中的“上下文割裂”问题,将模糊、省略或依赖前文的用户输入,转化为大模型可精准理解的完整语义指令。 |
| AI 一键优化模型 | 用于对提示词、角色指令、工作流描述、工作流各节点提示词进行一键优化,也会用于工作流代码节点 AI 代码生成。 |
| 实时文档解析模型 | 用于对用户在问答中上传的文档进行文档解析。 |
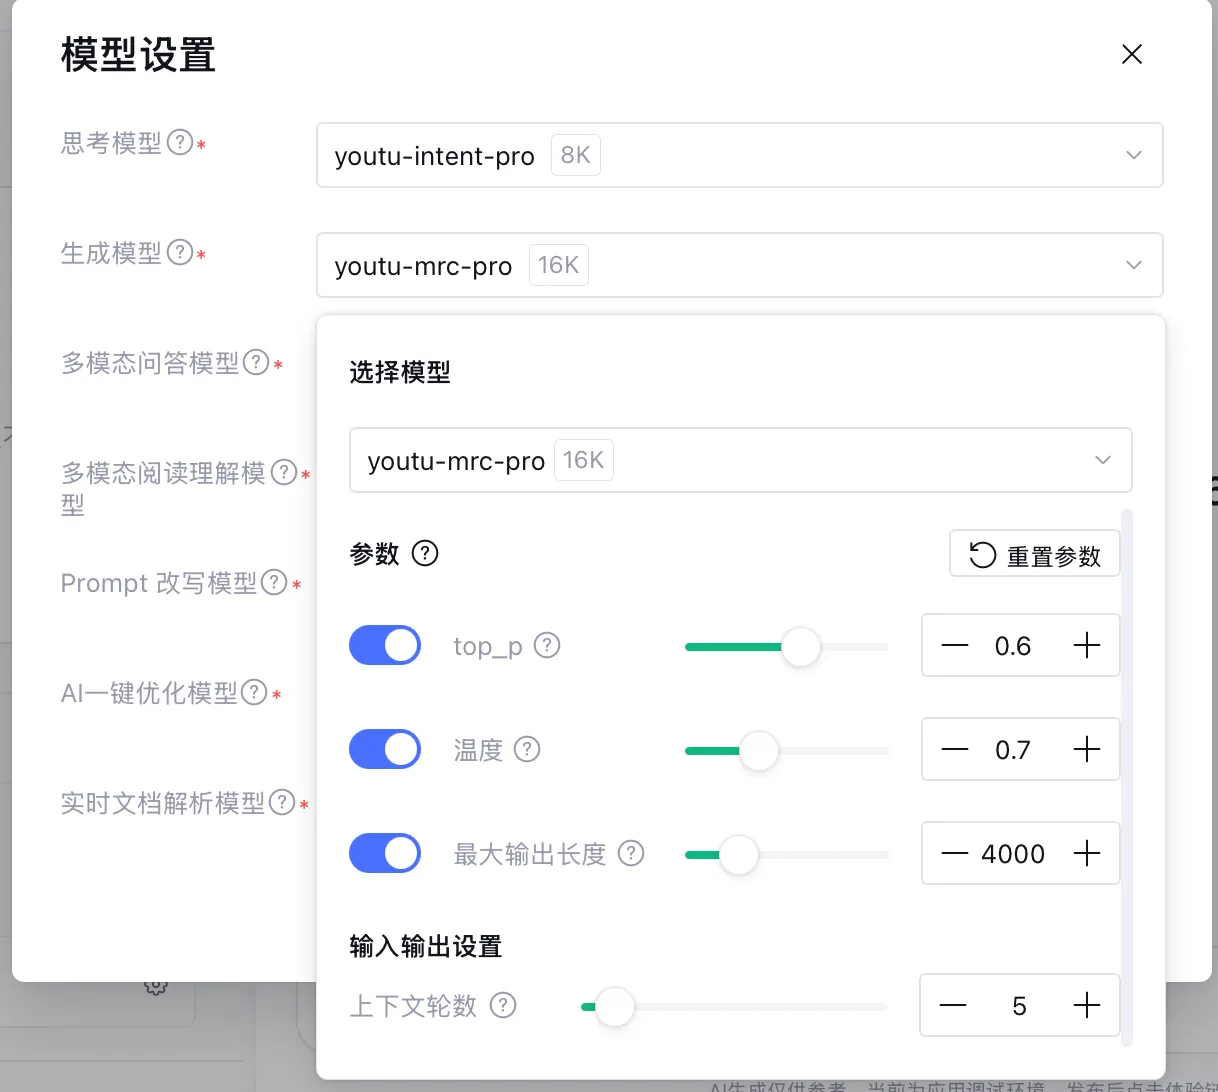
标准模式、单工作流模式可通过模型设置进行统一设置。模型设置相关功能包括模型服务、上下文轮数和参数设置。模型服务方面,平台新用户可获得一定量免费额度,可通过选择不同种类的模型进行免费应用调试;根据测试结果,再进一步购买和使用。
| 设置项 | 功能说明 |
|---|---|
| 模型选择 | 用于选择不同种类模型进行应用调试和使用,模型调用会影响效果、成本和响应体验。 |
| 上下文轮数 | 设置输入给大模型作为 Prompt 的上下文对话历史轮数。轮数越多,多轮对话相关性越高,但消耗 tokens 也越多。 |
| 温度 | 控制生成文本的随机性和多样性。较高的值会使输出更随机、更有创造性;较低的值会使输出更集中、更确定。 |
| top_p | 控制模型生成文本的多样性。top_p 是一种核采样方法,模型会考虑累计概率达到 top_p 阈值的最可能词汇。 |
| 最大输出长度 | 限制生成模型生成文本的最大长度,有助于控制 API 调用成本和响应时间,并防止生成过长的无意义文本。 |
补充理解|生成参数与长任务上下文
温度为什么会影响稳定性:模型每一步都在多个候选 Token 中采样。较低温度会压低低概率候选被选中的机会,因此同一问题多次生成通常更集中、更稳定;较高温度会保留更多候选,适合创意任务,但不适合要求口径一致的制度问答或结构化输出。
上下文不只是聊天记录:回答“我的报销为何被驳回”时,只有制度条文仍然不够,还要把该员工的具体单据状态、审批记录和必要身份信息作为实时业务上下文,通过有权限的工具或 API 获取。模型参数不能替代真实业务数据。
长任务要维护任务状态:对“查资料—生成报告—发送通知”这类多步任务,应持续记录任务目标、输出格式、可用工具及调用约束、已完成步骤、关键中间结果和异常原因。步骤较多时要定期生成状态摘要,避免上下文越来越长后重复早期错误计划;失败时应能从最近的可靠状态继续,而不是从头盲目重跑。
Tips:多模态问答模型、多模态阅读理解模型、Prompt 改写模型、AI 一键优化模型在新建应用时,ADP 展示的默认模型是平台官方推荐的最佳实践模型,是经过大量场景验证的优选模型,不建议用户随意修改。自行修改后,可能造成端到端问答效果下降,应谨慎更换。
2.2.3 角色指令
用户提问后,应用会以“角色指令”中定义的任务角色给出回答。角色指令可以参照模板填写,用于限定模型回复的语种、语气等。目前平台已支持中英文问答输出。对客户来说,角色指令是让智能体从“通用模型”变成“某个业务角色”的关键配置。
| 能力项 | 功能说明 |
|---|---|
| 版本 | 支持将当前提示词草稿保存为一个版本,并填写版本说明。已保存的版本可以在查看版本记录中查看和复制,版本记录仅展示当前所在提示词框下创建的版本。支持在内容对比中选择两个版本,查看提示词内容差异。 |
| 模板 | 提供设定好的角色指令格式模板,建议按照模板填写,指令遵循效果更佳。编写指令后,也可以单击“模板 > 保存为模板”,将当前指令存为模板。 |
| AI 一键优化 | 初步完成角色设定后,可单击“一键优化”对角色设定内容进行优化。模型会基于已输入内容优化设定,使模型更好完成对应要求。AI 一键优化会消耗 tokens 资源。 |
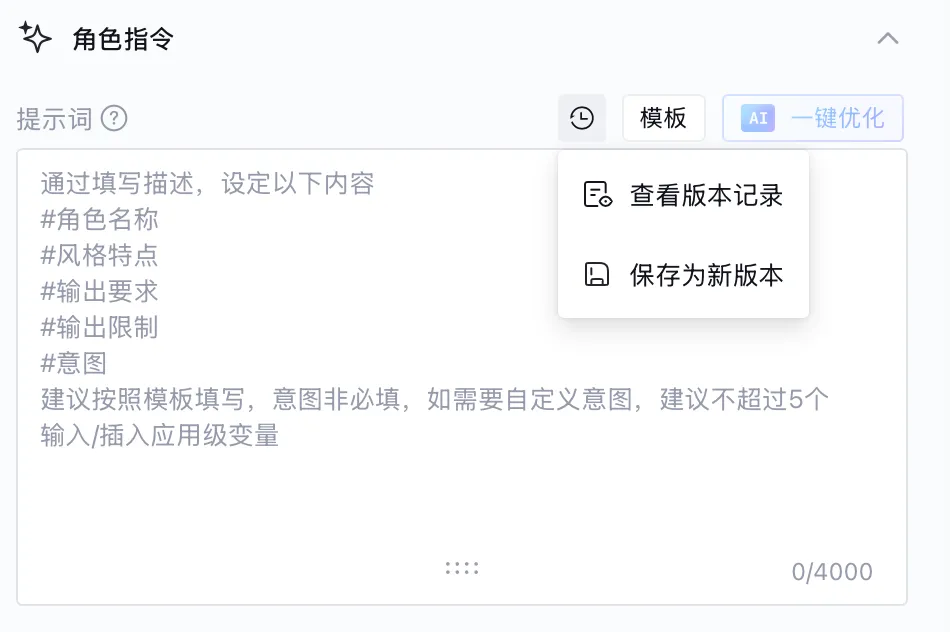
Tips:角色指令可以强化角色、语气、回答格式和规则,但不能替代知识库和工具。需要基于企业资料回答的问题,应配合知识库;需要查询或执行的问题,应配合工具、工作流或连接器。
2.2.4 欢迎语
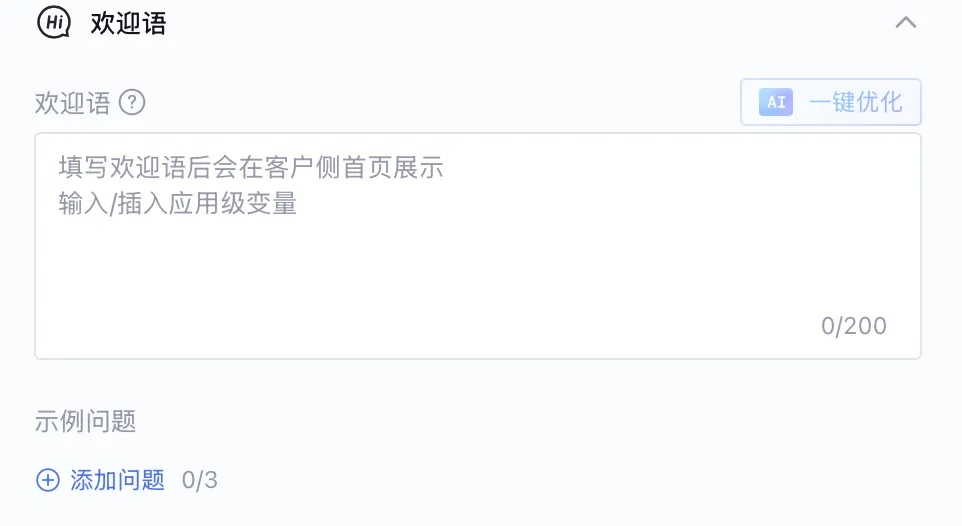
填写欢迎语后,将在客户端侧首页显示,支持插入应用级变量显示。欢迎语不是可有可无的装饰,它影响用户第一次打开应用时是否知道应该怎么问、能获得什么帮助。平台支持使用 AI 一键优化生成欢迎语。
2.2.5 变量
智能体开发平台提供了丰富的变量类型,以满足不同业务场景需求。从变量的使用范围角度,变量分为“应用级变量”和“工作流级变量”两类。变量让应用可以读取系统信息、接收 API 参数、保存环境密钥、在应用内传递内容,也可以在工作流内部传递节点输入输出。
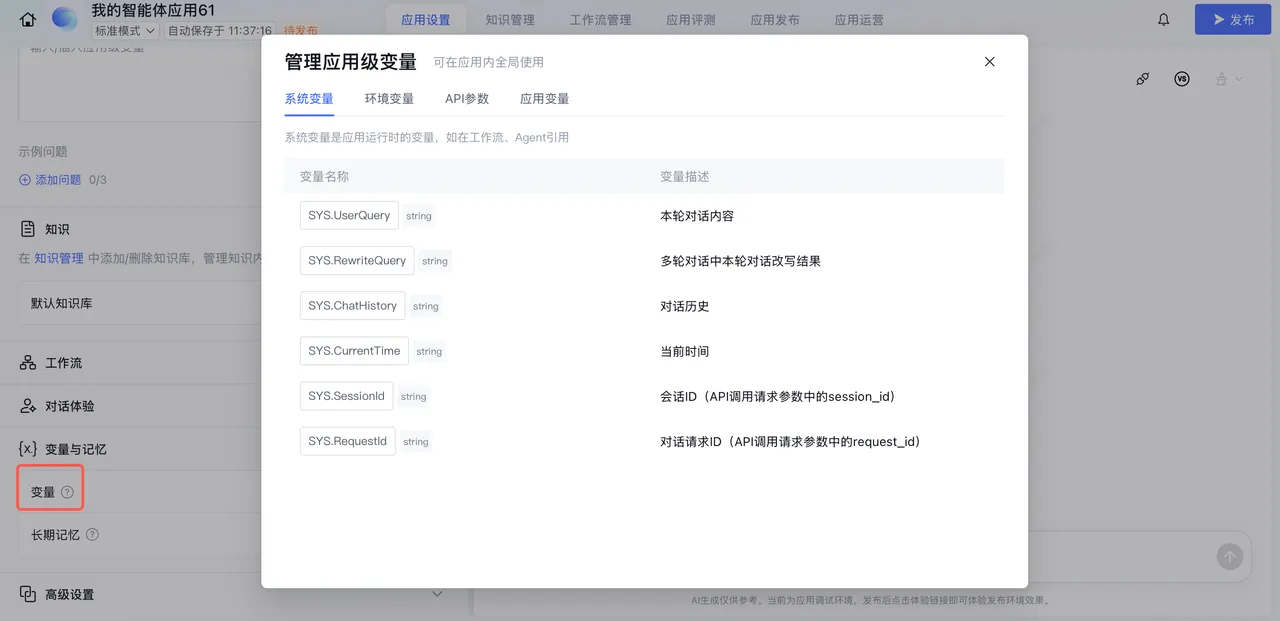
应用级变量表示应用全局范围内可见、可使用的变量,具体包括系统变量、环境变量、API 参数和应用变量。
| 应用级变量类型 | 变量描述 | 变量名称及示例 |
|---|---|---|
| 系统变量 | 平台系统默认提供的变量,在应用范围内各模块均可读取,但不支持用户编辑。以 SYS.XXX 方式命名。 | SYS.UserQuery:本轮对话内容;SYS.RewriteQuery:多轮对话中本轮对话改写结果;SYS.ChatHistory:对话历史;SYS.CurrentTime:当前时间;SYS.RequestId:对话请求ID;SYS.Memory:长期记忆内容。 |
| 环境变量 | 用于保存 API 密钥、数据库密码等敏感数据,提供 secret 数据类型,支持加密存储、传输,并在页面显示为 *****。以 ENV.XXX 方式命名。 | 示例:ENV.LLMSecretKey,存储大语言模型调用时的 secretKey,可在工作流或 Agent 工具中使用。 |
| API 参数 | 表示用户调用平台 API 时,通过 custom_variables 字段传入系统的变量。以 API.XXX 方式命名。 | 示例:API.UserName,通过 API 参数传入用户姓名,在对话时更亲切地称呼用户。 |
| 应用变量 | 表示在应用内各模块中互相传递的变量。例如工作流 A 对应用变量赋值,工作流 B 读取。以 APP.XXX 方式命名。 | 示例:APP.Notes,工作流 A 收集用户笔记内容并赋值给 APP.Notes,工作流 B 获取笔记内容并总结摘要。 |
工作流级变量表示工作流内部可见、可使用的变量,具体包括工作流变量、节点输入变量和节点输出变量。
| 工作流级变量类型 | 变量描述 | 变量名称及示例 |
|---|---|---|
| 工作流变量 | 表示在工作流范围内传递的变量。例如在工作流分支 A 对变量赋值,在分支 B 读取变量值。工作流变量在开始节点定义,在工作流内各节点均可读取,并仅支持在变量赋值节点中赋值。以 WF.XXX 方式命名。 | 示例:WF.OrderList,分支 A 中整理用户订单内容并赋值给 WF.OrderList,分支 B 中获取订单内容并下单。 |
| 节点输入变量 | 表示当前工作流节点的输入变量,仅在节点内部编辑和使用。 | 用于承接当前节点需要处理的输入内容。 |
| 节点输出变量 | 表示当前工作流节点的输出变量,节点内实现该变量写入,并在后续节点读取和使用。 | 用于把当前节点处理结果传递给后续节点。 |
由于使用场景不同,每种变量的适用范围也存在差异。
- 系统变量(除 SYS.Memory 外)通常用户隔离、Session 隔离;
- SYS.Memory 用户隔离但不 Session 隔离;
- 环境变量用户和 Session 都不隔离;
- API 参数和应用变量用户隔离但不 Session 隔离;
- 工作流变量、工作流节点输入变量和工作流节点输出变量均用户隔离、Session 隔离。
具体参考如下表格:
| 变量名称 | 变量名称 | 是否用户隔离 | 是否 Session 隔离 |
|---|---|---|---|
| 应用级变量 | 系统变量(除 SYS.Memory 外) | 是 | 是 |
| 应用级变量 | SYS.Memory | 是 | 否 |
| 应用级变量 | 环境变量 | 否 | 否 |
| 应用级变量 | API 参数 | 是 | 否 |
| 应用级变量 | 应用变量 | 是 | 否 |
| 工作流级变量 | 工作流变量 | 是 | 是 |
| 工作流级变量 | 工作流节点输入变量 | 是 | 是 |
| 工作流级变量 | 工作流节点输出变量 | 是 | 是 |
变量隔离理解
- “用户隔离”指同一个变量对于不同终端用户的变量值不同;“Session 隔离”指同一个变量在不同 session 下变量值不同。
- 从隔离范围上看,用户隔离 > Session 隔离。灵活使用变量可以满足复杂业务场景需求。
2.2.6 长期记忆
长期记忆功能是实现个性化对话体验的核心,它如同为应用赋予了 “大脑记忆” 的能力。通过持续识别并精准留存与终端用户相关的各类关键信息,包括用户的基础画像(年龄、性别等)以及重要的记忆点(如特定时间在特定地点做过的事情等),让应用在后续与用户的每一次互动中,都能快速调用这些信息,从而提供更贴合用户个性化需求的回应,极大地提升用户的使用体验。
长期记忆的唯一性由两大核心要素共同决定,即终端用户和应用。意味着每一个终端用户在不同的应用中,都会形成独立且唯一的长期记忆。这种独立性能够确保用户在不同应用场景下的信息不会相互混淆,保证了记忆的针对性和准确性。
- 说明:
终端用户 A 在应用 1 中的长期记忆为 A1;终端用户 A 在应用 2 中的长期记忆为 A2;终端用户 B 在应用 1 中的长期记忆为 B1,其中 A1、A2、B1 彼此独立,互不相同,这些记忆不会相互干扰。
长期记忆的模块构成
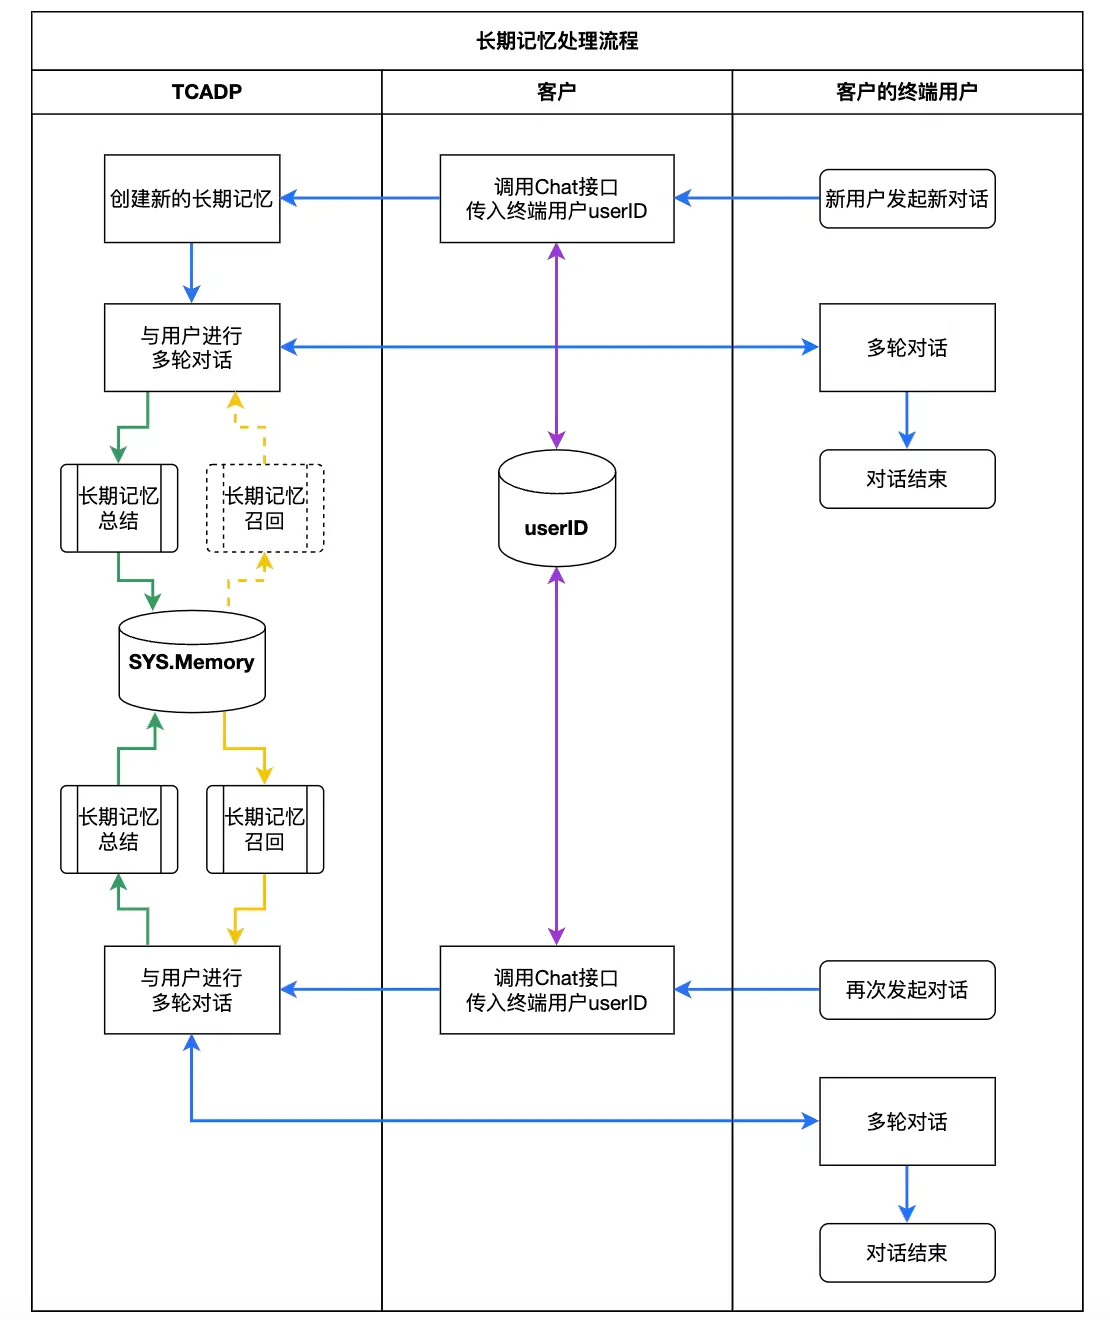
长期记忆主要分为“长期记忆总结”和“长期记忆召回”两个步骤,运行流程如下:
- 新用户首次发起对话,系统会根据终端用户 ID 和应用 ID 创建一份唯一的长期记忆,存储在 SYS.Memory 中。
- 在用户与系统多轮对话时,系统调用 “长期记忆总结” 模块,根据对话历史自动总结长期记忆内容。
- 长期记忆总结的时效性:每一轮对话都会运行总结模块并尝试提取长期记忆,并更新 SYS.Memory 内容。
- 在用户新的对话中,系统调用 “长期记忆召回” 模块,拿到用户的长期记忆内容,帮助大模型了解用户画像及重要记忆点,与用户个性化对话。
- 例如:长期记忆内容为“用户是一名素食主义者”,那么后续为用户推荐附近的餐厅时,则主要推荐素食餐厅。
- 循环上述 “长期记忆总结” 和 “长期记忆召回” 过程。
长期记忆运行流程图如下:
2.2 上小结
本部分内容聚焦应用设置中的核心配置能力:应用编辑定义应用身份,模型设置决定运行链路中的模型能力,角色指令限定回复角色和规则,欢迎语影响用户入口体验,变量支撑应用和工作流的数据传递,长期记忆支撑个性化对话体验。
下一节,我们将继续了解 ADP 如何让智能体获得企业知识、连接外部系统,并从“会回答”进一步走向“能办事”。
