
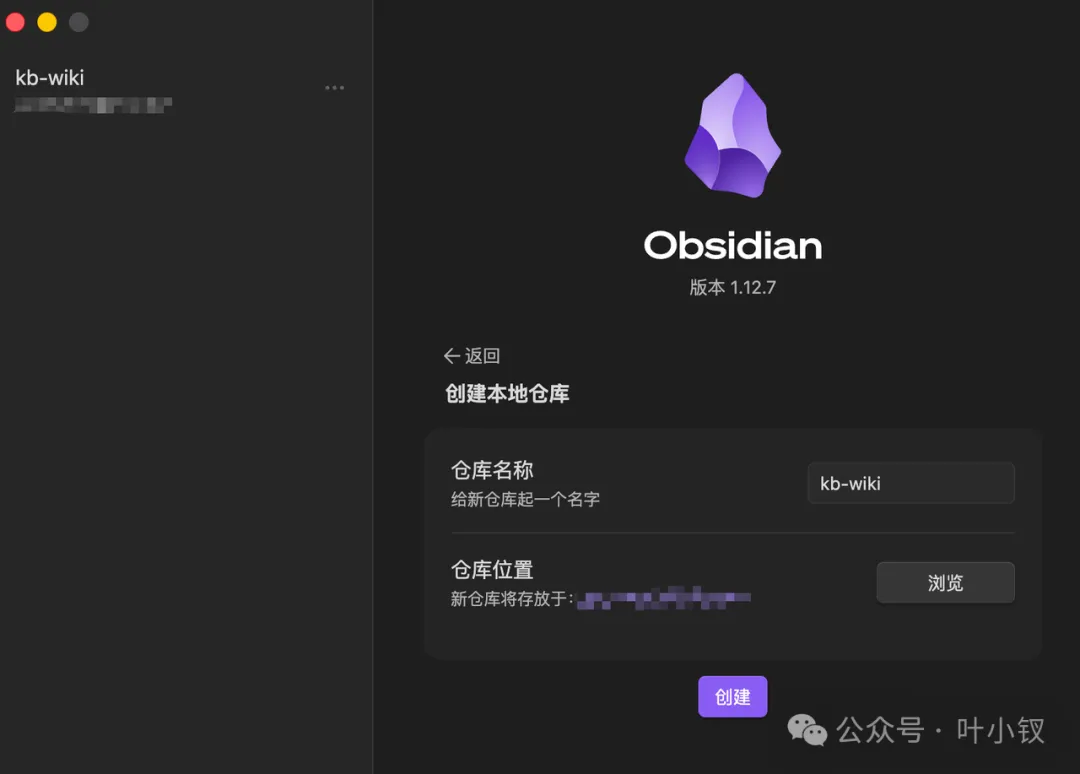
首先我们打开 Obsidian,点击【创建】
在指定文件夹下创建一个新的仓库,这里命名为kb-wiki,并使用Git版本管理工具初始化仓库,便于后续管理版本记录。
prompt指令大致如下:
然后打开WorkBuddy,新建一个会话
工作空间选择刚刚在Obsidian中创建的项目文件夹。
这样Obsidian、WorkBuddy这两个软件的工作空间都指向了同一个本地目录,只不过现在文件夹还是空的,我们继续往下。
数据采集
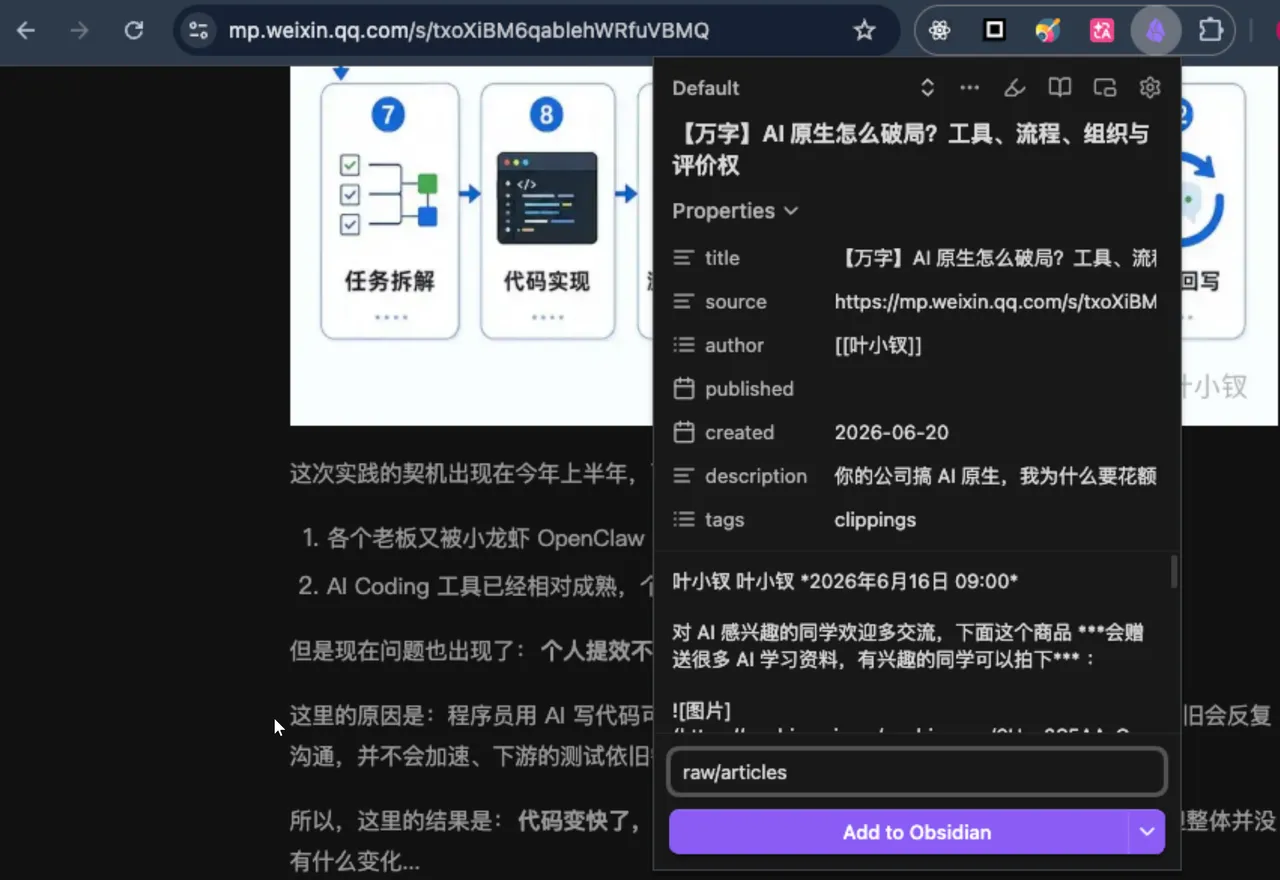
比如,在电脑端浏览器中,我看到一篇优质的文章,我想把它加入我的知识库项目原始资料中,就可以使用Obsidian Web Clipper插件把网页内容以markdown的格式直接添加到项目的raw目录中。
编写Wiki Schema
整体架构
根据前面的LLM Wiki的原则,我们在Obsidian中把目录文件层级设置为如下结构:
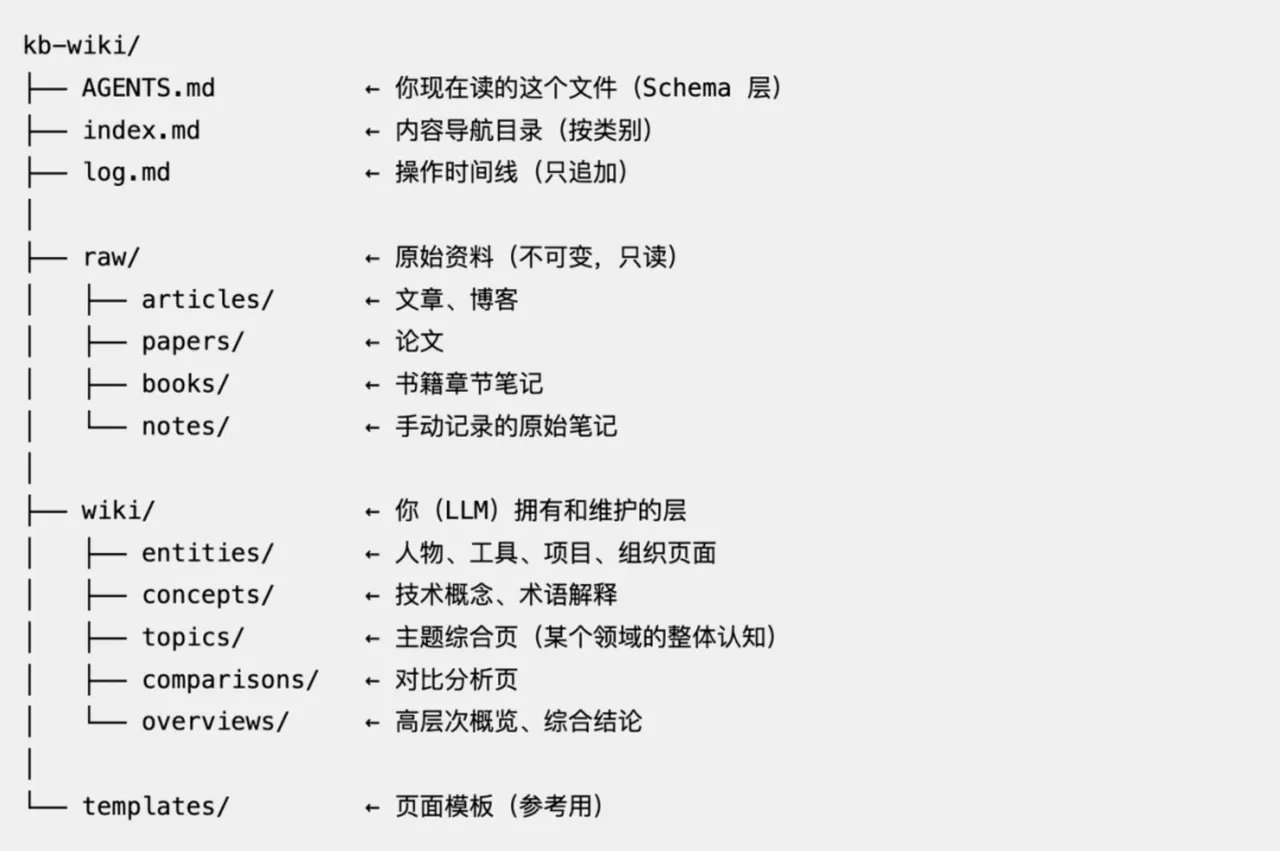
可以看出,整体流程中最为关键是:
数据怎么采集、知识怎么加工、用什么模型加工、如何被查询、怎么保持加工的质量能够稳定持续。
下面我们围绕这些方面进一步展开。
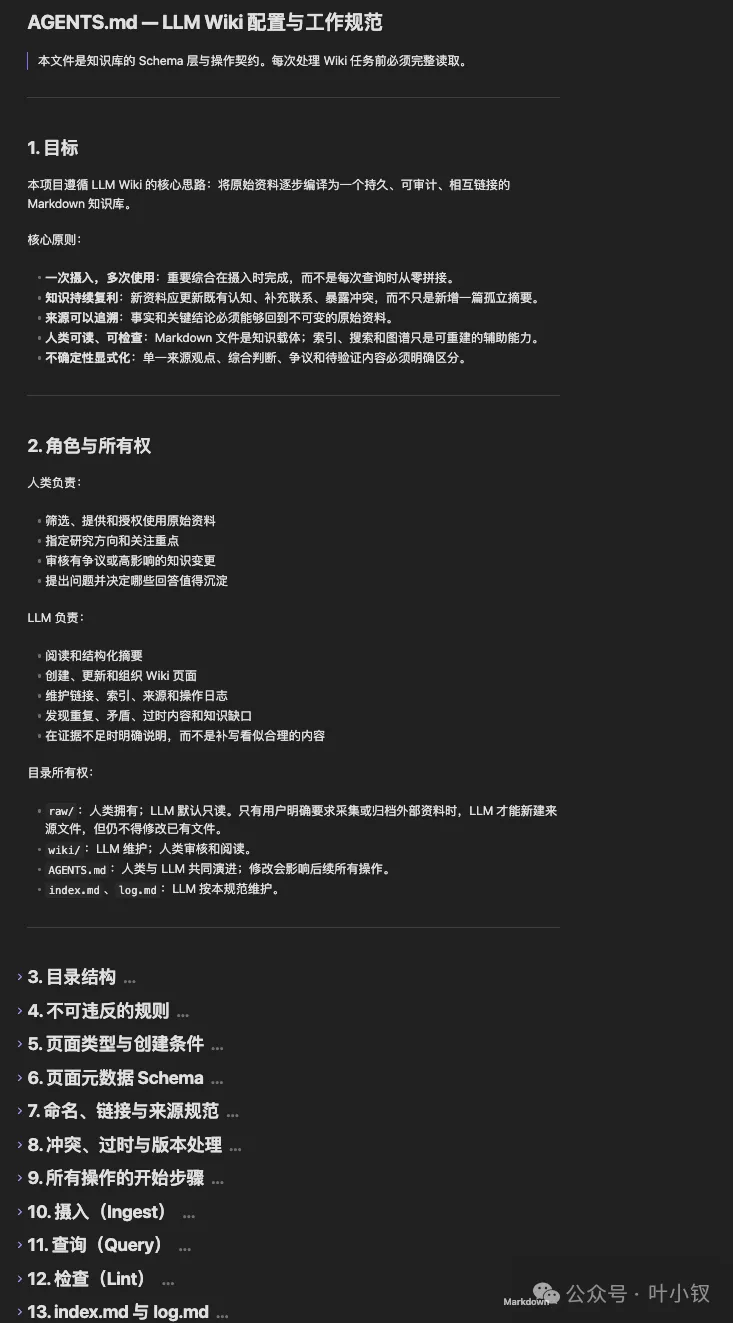
把上面的内容编写到项目的根目录AGENTS.md中
🫡 这个文件的内容并不是一劳永逸或者一蹴而就的,需要我们持续的维护更新,直到表现稳定。
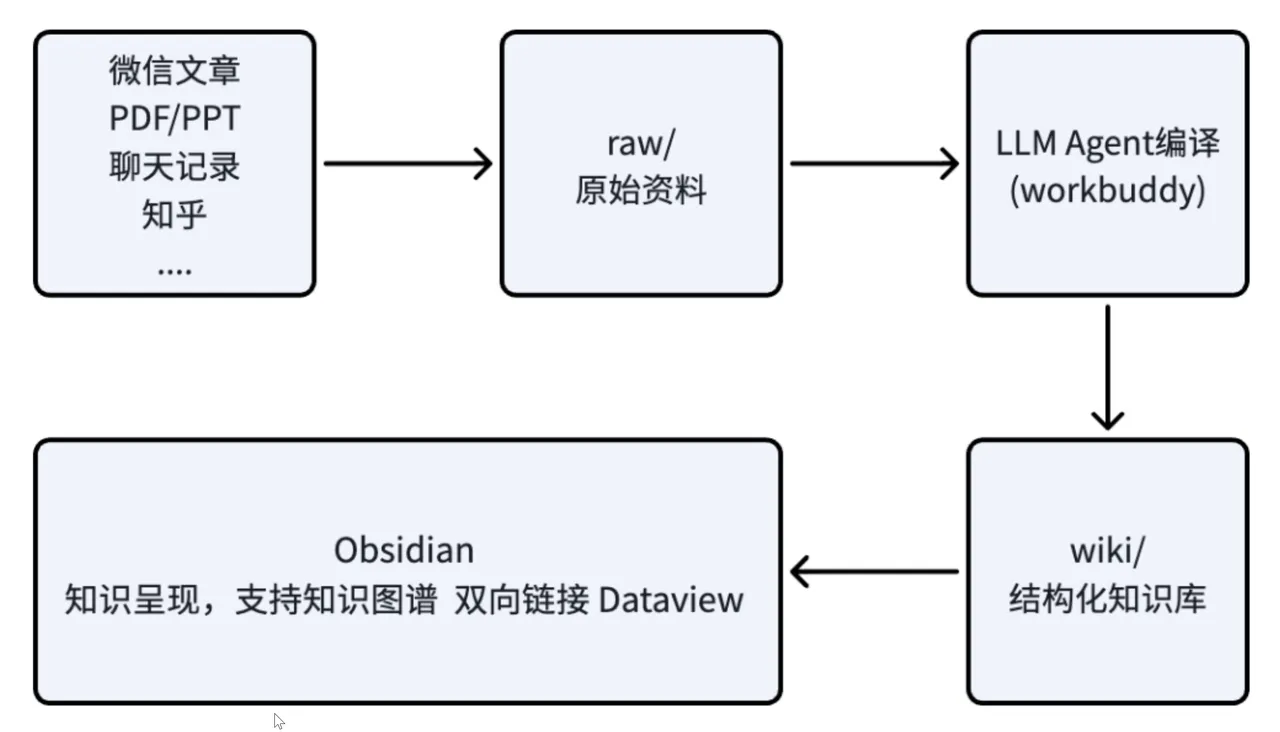
这里我们可以使用IMA知识库作为中转站,用来收集移动端的内容,把在微信中看到的各类信息一键收藏到IMA知识库中,这个方法对于微信生态的内容尤其友好。
然后我们还要借助Workbuddy的定时任务,定期的从IMA知识库中把新增的内容同步到项目raw目录中来,自动化任务设置大致如下:
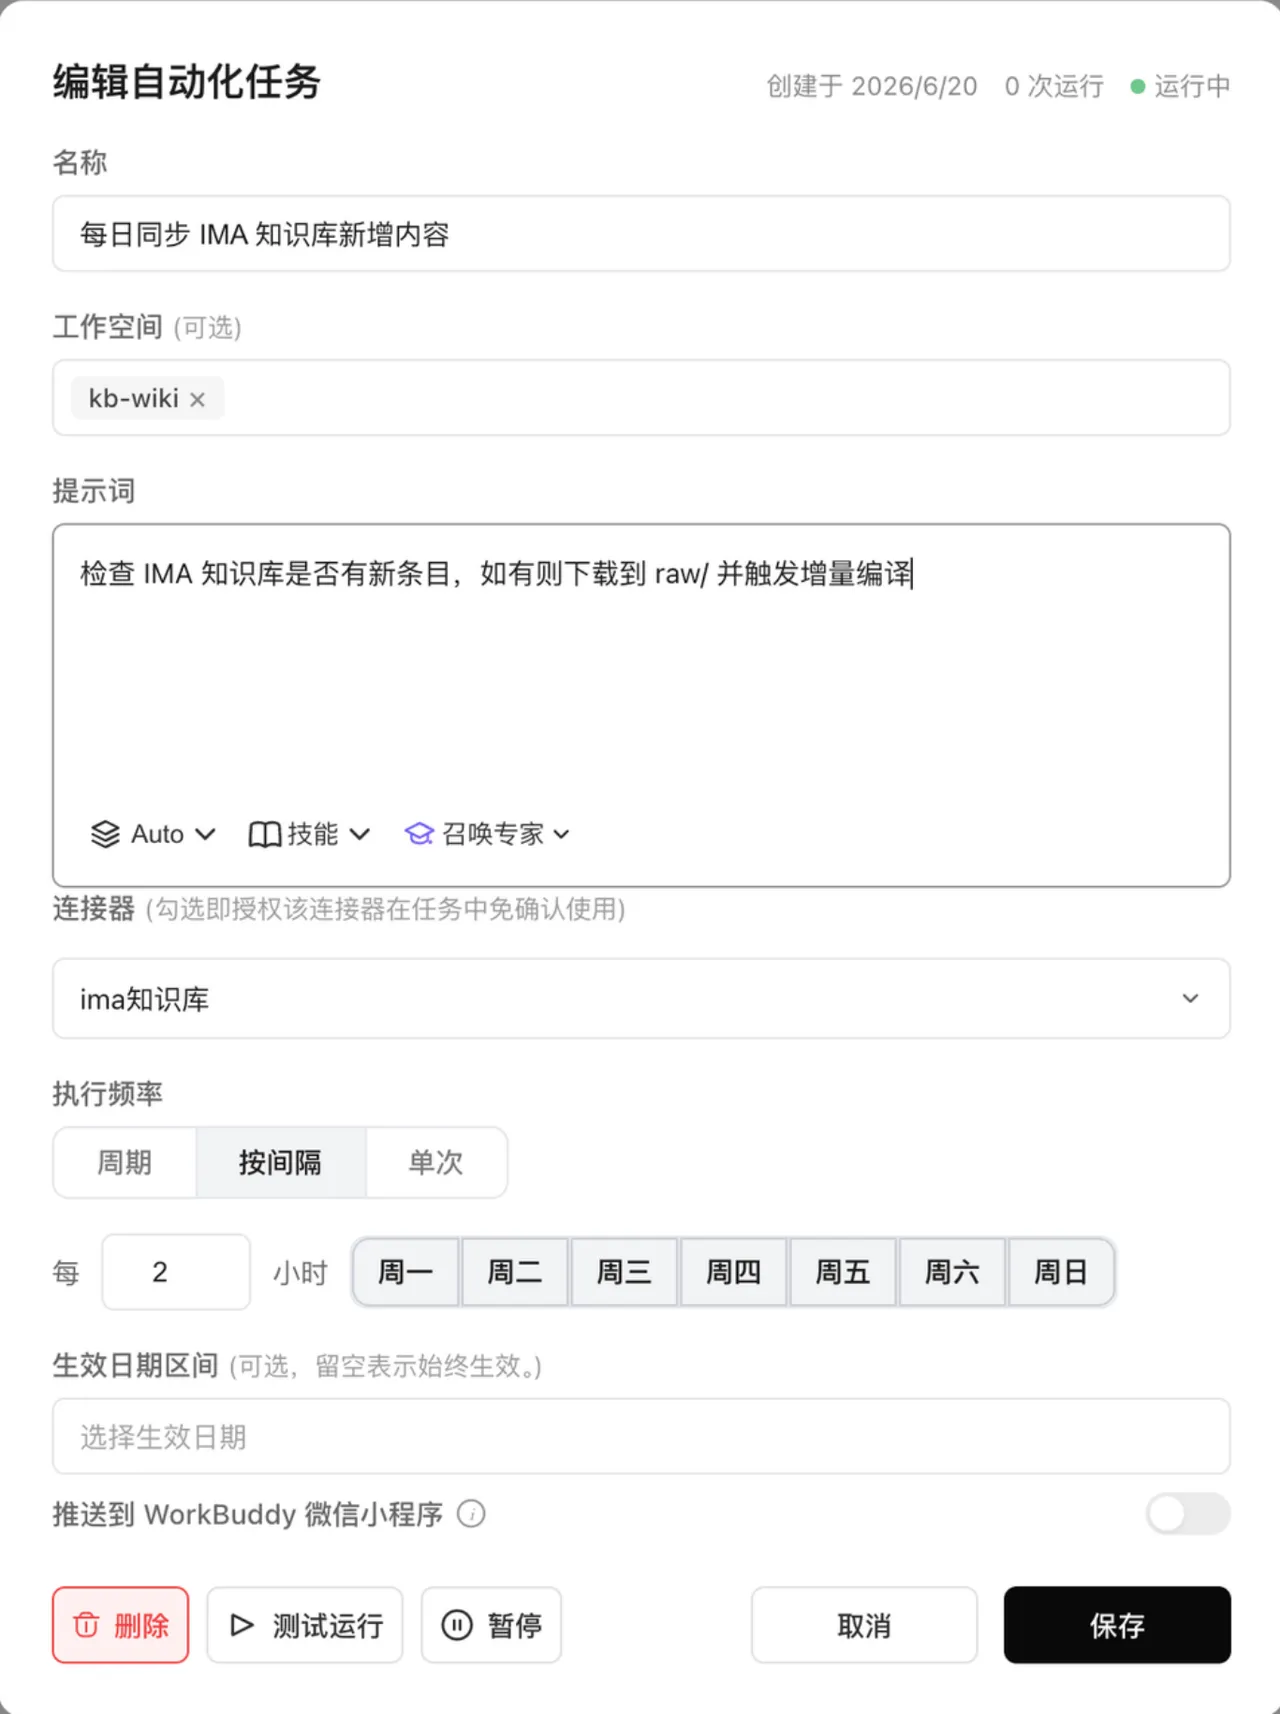
这样我们就能同时收集到电脑端和移动端看到的多数优质内容了。
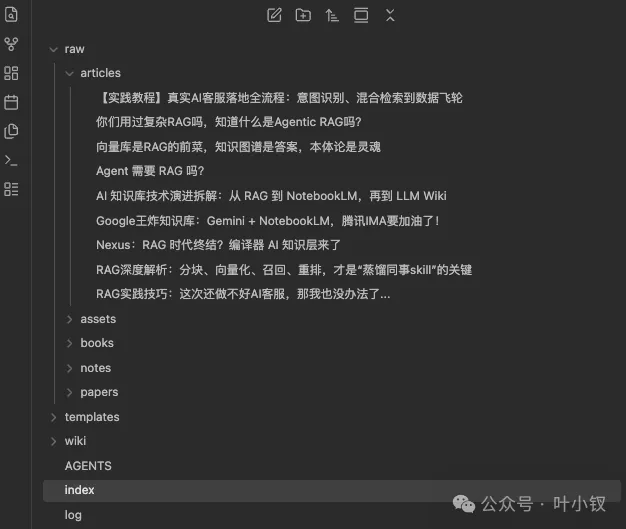
这里通过Obsidian Web Clipper插件,把之前写过的所有关于知识库和RAG的文章都放入到项目的原始资料中来。
编译知识
原始资料采集完成后,我们就可以开始让WorkBuddy编译知识了。
🫡 打开WorkBuddy,把工作空间指向kb-wiki这个目录,在会话中告诉它:
> 阅读当前项目raw/中新增的文件,按照项目根目录中的AGENTS.md的规范,将它们编译到wiki/目录中,并同时更新index.md和log.md文件
此外,还会更新知识wiki的索引文件index.md,以及把本次知识写入日志更新到log.md中。
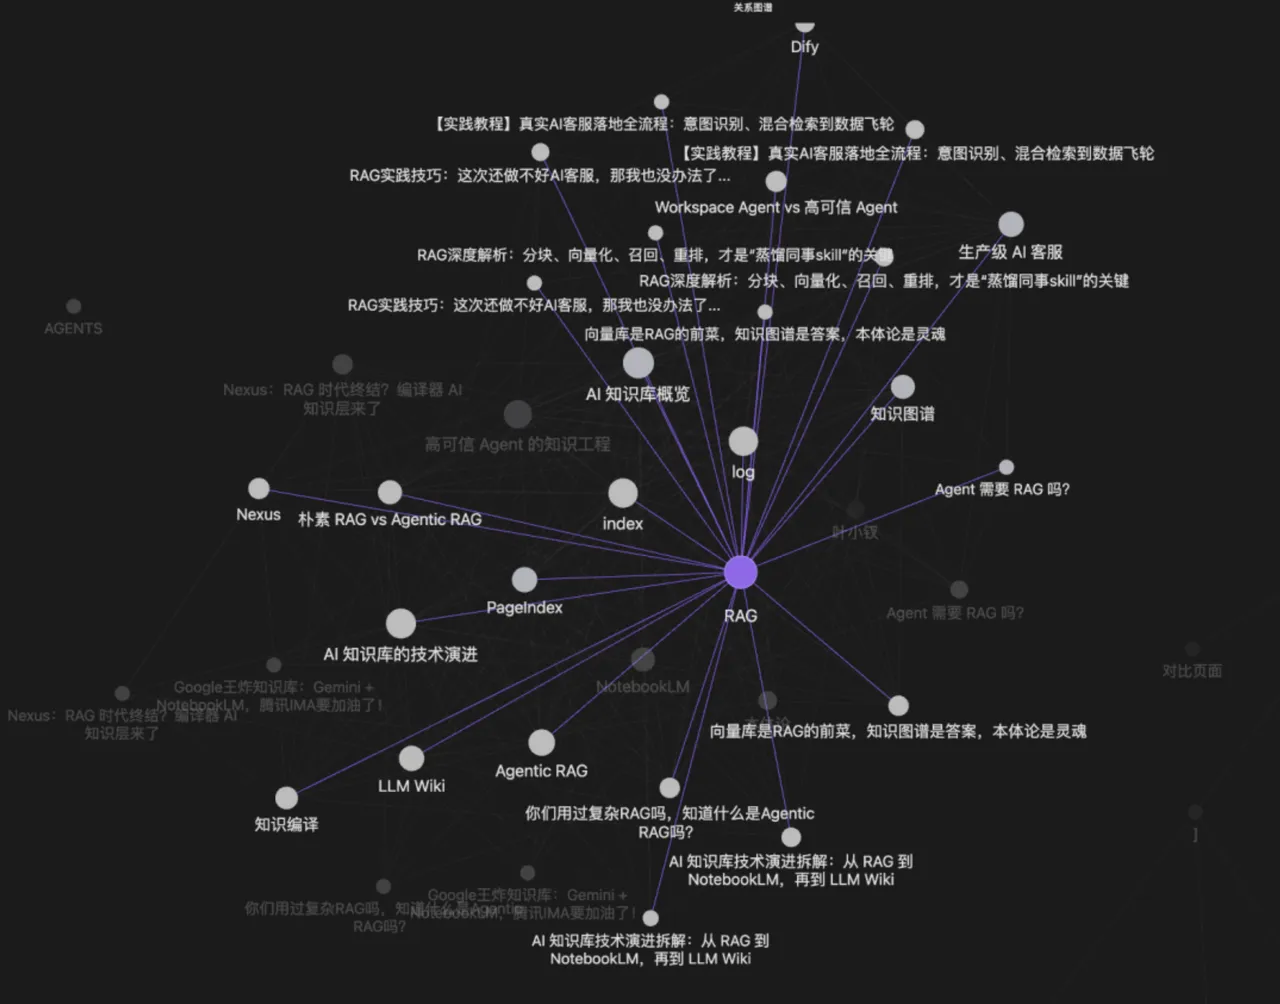
到这一步就完成了知识的摄取,接下来我们看如何查询知识。
查询知识
查询这里就非常简单了,直接向WorkBuddy提问即可,它会根据wiki中沉淀下来的知识,进行综合回答。
🫡 比如我问:
> 根据 Wiki,解释一下LLM wiki的工作原理是什么,它与传统的RAG有啥区别?
下面是回答截图:
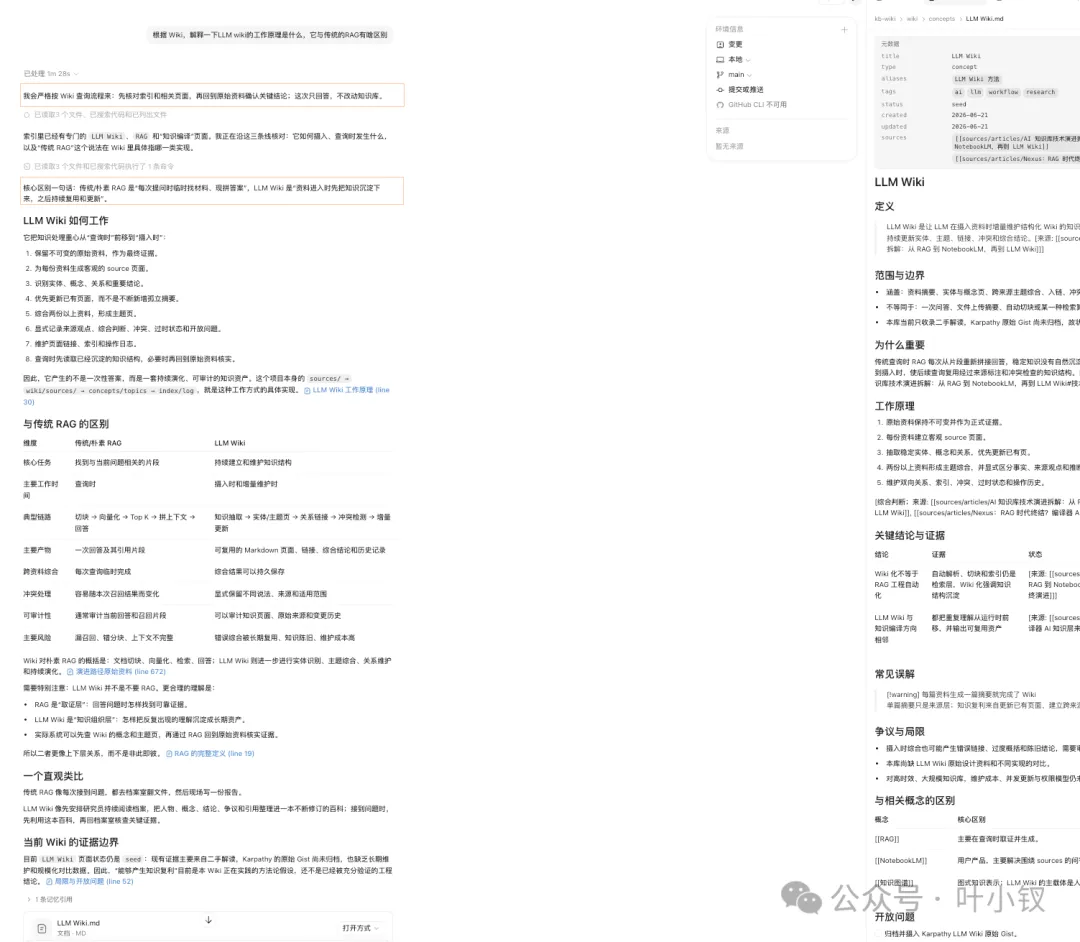
这里Wiki 页面的渐进式展开和 Skills 的渐进式披露的机制也非常一致。
当然,这里生效的前提是,我们要在AGENTS.md中定义查询的工作流程,让Agent先查index.md,然后在加载wiki中的相关知识。
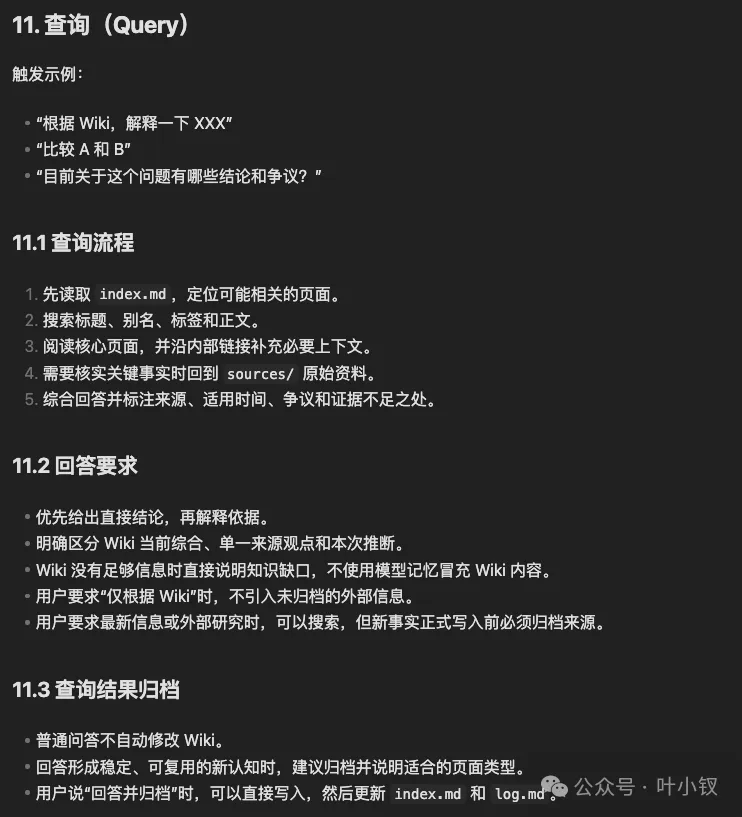
另外,对于有价值的回答,还可以把结论写回wiki,让知识越攒越厚。
治理知识
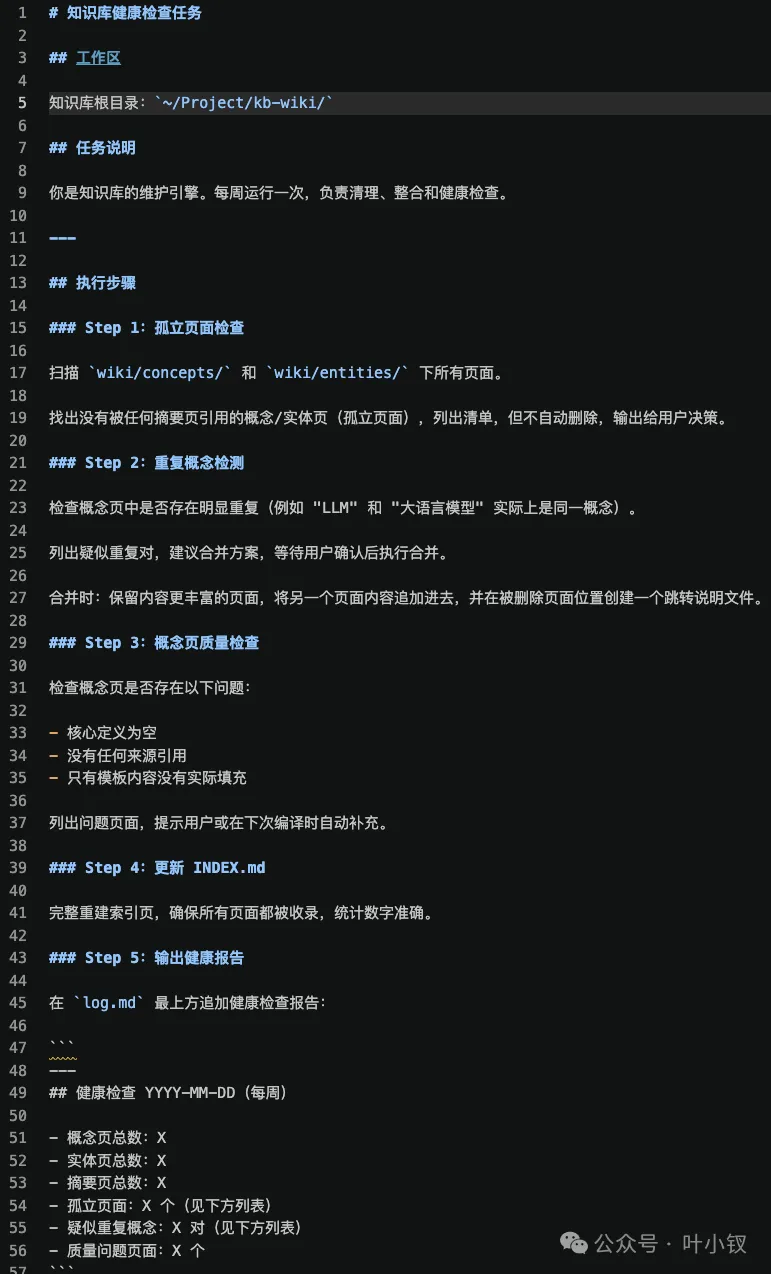
这里可以通过Workbuddy的定时任务来实现自动化健康检查,比如每周检查一次,定时任务设置如下:
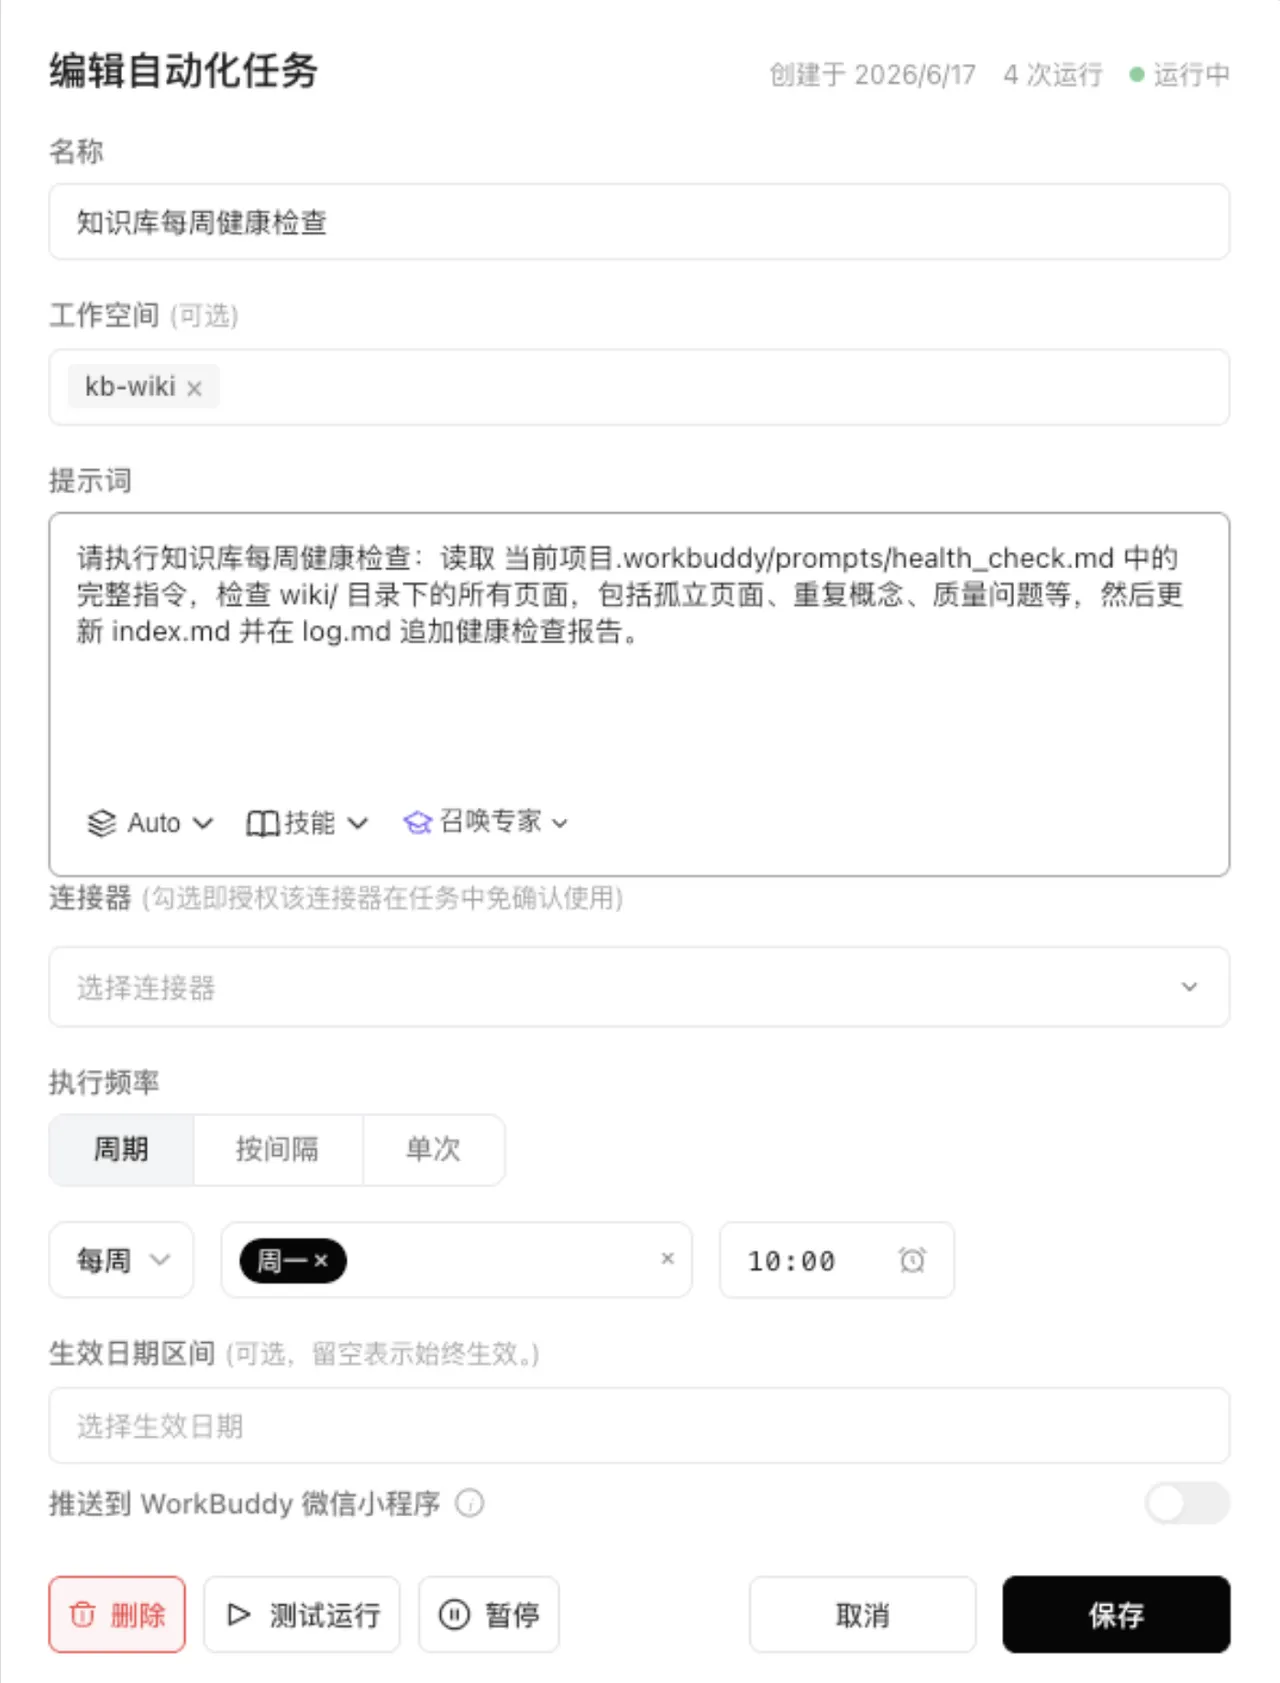
知识健康检查指令大致如下:
