
哈喽,大家好,我是刘小排。
GPT-6 Astra发布后,我常常遇到三个问题,这里做统一回答。
第一个问题:GPT-6 Astra和Claude Fable 5.1哪个强?
答:
GPT-6 Astra是当今世界唯一真神。
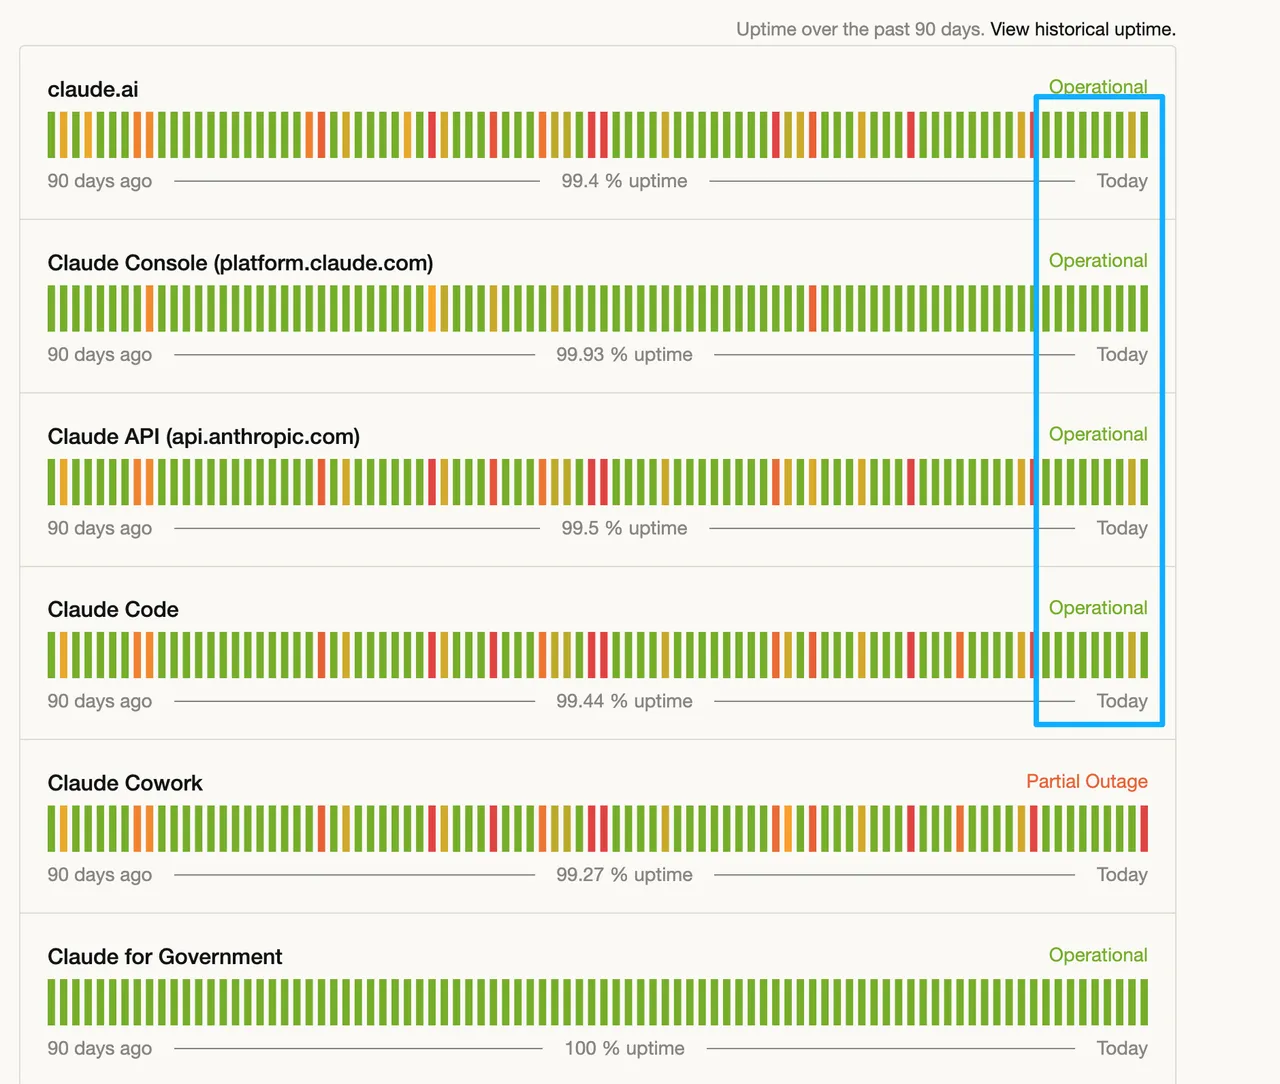
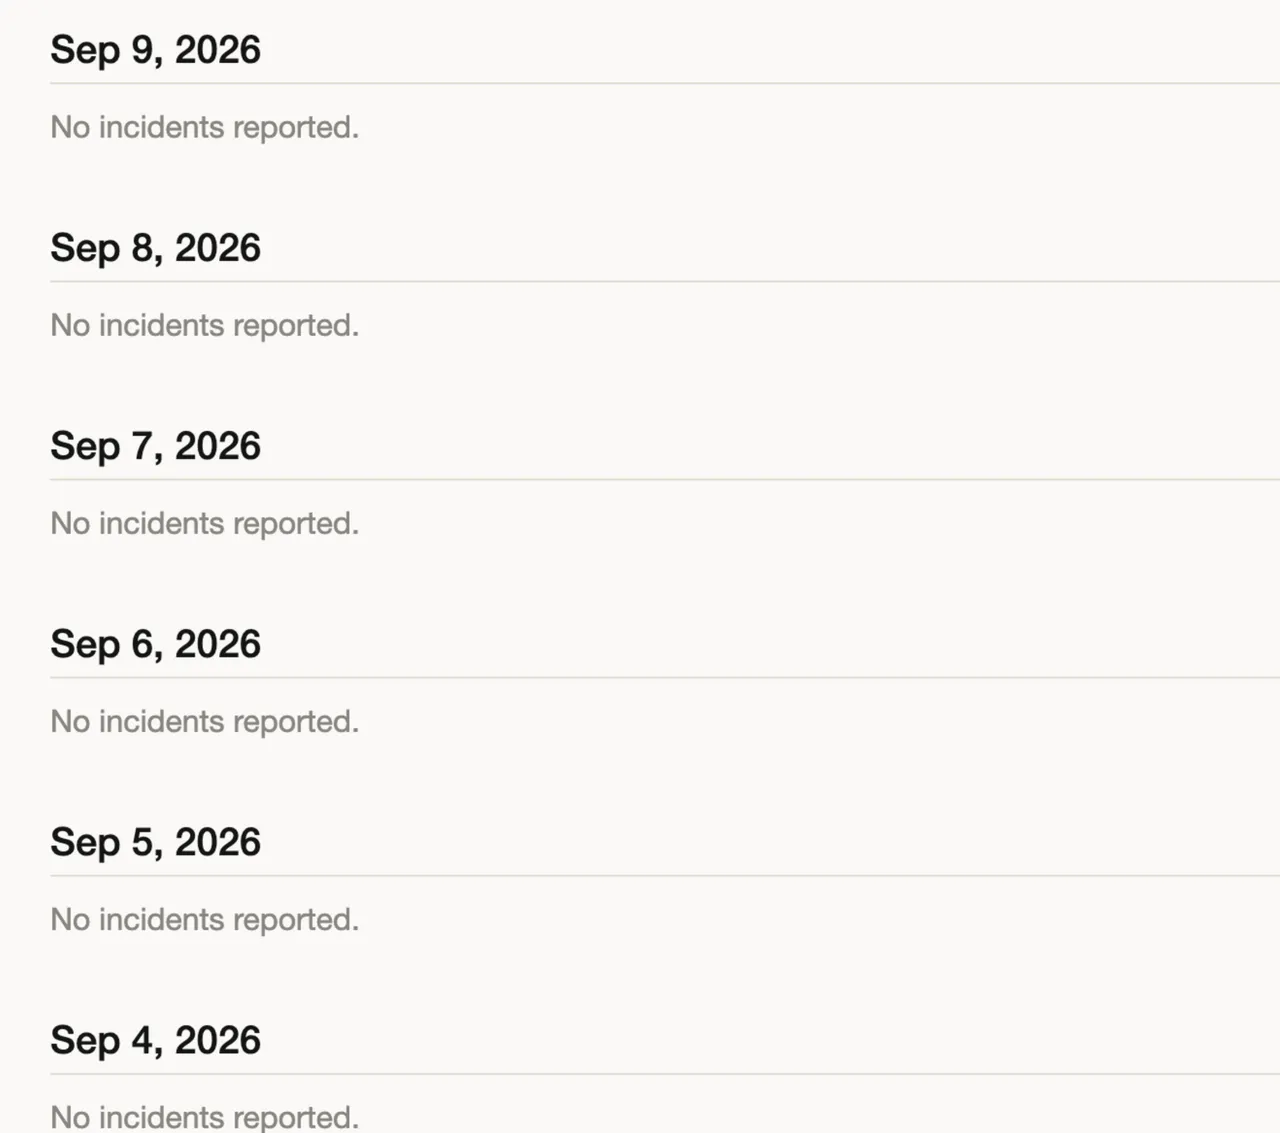
不信你看,GPT-6 Astra把Claude的服务都干成绿色了,Claude几乎迎来了史上最长的“连续零事故日”。
第二个问题: GPT-6 Astra选择什么档位比较好?
答:不需要选择Ultra,因为它太费额度了,带来的收益非常有限。
- 非编程任务&简单编程任务(比如套壳产品):low和medium
- 复杂编程任务:high和xhigh已经包打一切。
- 非常难啃的硬骨头:用ChatGPT聊天版里的6 Pro (不在Codex里,表现比Ultra更好),可以用官方的GitHub插件给上下文,可让它直接提交PR。 \$200/月的ChatGPT Pro 20x Plan每周可以问200个问题。
第三个问题:GPT-6 Astra 怎么才能用好?
答:好的,终于说到本文主题了 —— 这个问题非常重要,重要到,OpenAI 写了一篇使用教程。
简而言之,你不仅不需要更多的所谓“提示词技巧”,你需要的是“删除提示词”。
是的,OpenAI官方刚出的《Rethinking skills and prompts for GPT-6 Astra》教程,本质上是教你如何删提示词。
过去一年,我们为了让 AI 干活靠谱,写了很多规则,它们有的叫skills、有的叫agent.md、还有的叫“提示词工程”:
比如
- 先读哪些文档。
- 必须执行哪些步骤。
- 改完必须跑哪些测试。
- 遇到什么情况先问我。
- ……
这些规则以前有用。以前,模型没那么聪明,你得扶着它走。
GPT-6 Astra 很不一样。(说个客观的:Fable 5.1同理)
如果你还把它当上一代模型用,给它塞一大堆规则,结果可能更差。不是它能力不够,是你的指令挡住了它。
OpenAI 点名了三个地方:Skills、AGENTS.md、任务提示词。
一、Skill 不是越多越好
Skill 可以理解为一套可复用的工作说明。它通常以 Markdown 文件保存,也可以附带脚本、模板和其他资源。
问题在于,很多项目安装了大量 Skill,而且每个 Skill 的描述都写得很长。为了把它们塞进上下文,Codex 可能不得不缩短这些描述,最终反而更难判断当前任务应该调用哪一个。
OpenAI给了三个原则:
- Skill不是越多越好。
- 触发条件清晰。每个Skill都写清楚,只在不得不触发的时候,才触发。
- 渐进式披露。主文件只需要充当“路由器”,告诉模型在什么情况下读取哪份文档、使用哪个脚本。
任务需要什么,就加载什么。这样既节省上下文,也能减少无关规则对模型判断的干扰。
二、提前定义什么叫“完成”
GPT-6 Astra 很谨慎,这既是优点,也可能让人觉得它过早停下。
它有时会完成第一版实现,然后回来等待确认,即使后面还有启动项目、检查页面、修复报错等工作。
解决方法不是写一篇更长的提示词,而是把终点说清楚。
不要只说:
帮我实现这个功能。
可以改成:
实现这个功能,运行相关测试,启动项目检查实际效果,修复由本次修改引起的问题,确认功能可以正常使用后再结束。
重点不在于告诉 Astra 每一步应该怎么做,而在于明确最终需要交付什么结果、哪些操作可以自主完成,以及什么情况必须停下来询问。
换句话说,少规定路线,多定义终点,让GPT-6自己想办法达到终点。
三、懒人用法
前两条我单独写出来,是因为,上面两条需要你亲自学。
其他内容,我们就让AI自己学就行。
第三条不来自原教程,而是来自我的使用实践 —— 让AI自己学。
把这一条Prompt粘贴给Codex里的GPT-6 Astra,可以让你快速重新做人:
按照文章提出的原则,审视我机器级、项目级的所有skills、skill descriptions, AGENTS.md,帮我:删除不用的skills、精简skill descriptions、精简AGENTS.mdhttps://developers.openai.com/blog/rethinking-skills-and-prompts-for-gpt-6-astra让我可以充分适应GPT-6 Astra时代
执行完成后,我整机skills从30多个变成了个位数。
你也去试试吧!
对了,今天北京时间下午3点左右,Codex又重置额度了。
祝玩的愉快!
