
✍️ 作者: AI一手
今天上午,我打开 Codex 打算接着写周五没做完的一个桌面端小工具。
模型直接选了最新的 GPT-6 Astra(推理设为极高)。
动手之前特意看了一眼后台,5 小时的配额还是 100% 满格。
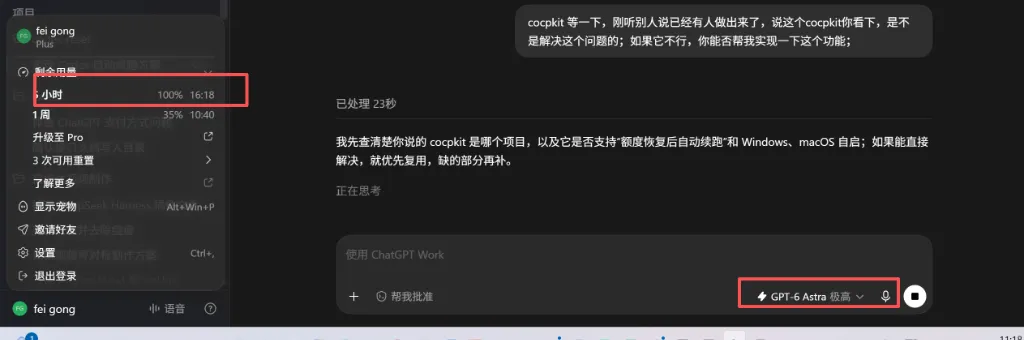
直接让它接着干。
结果才跑了 2 分钟 41 秒,直接歇菜了。
切到后台一看,刚才还满格的 5 小时配额,瞬间归零。
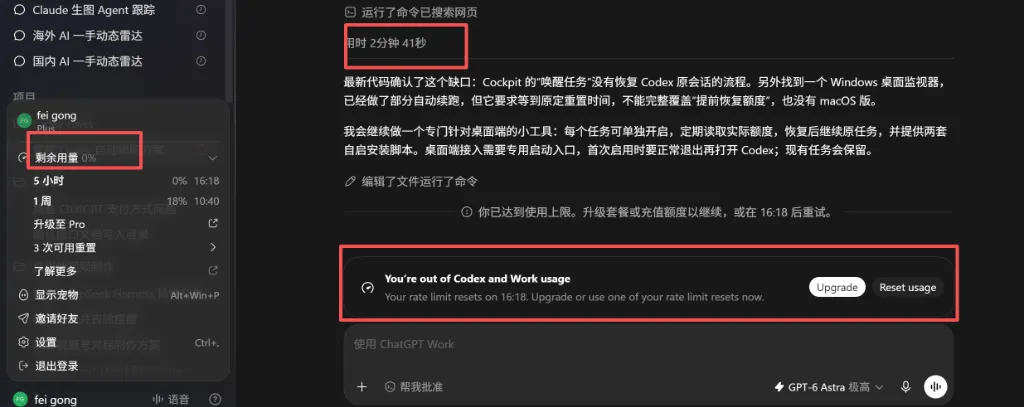
活还没干完,额度先空了。
用 Plus 的我们,根本不配用 Astra 啊。
必须承认,Astra 的模型推理能力确实非常强,处理复杂逻辑推导时几乎没有对手。
但如果像现在这样跑一个小工具就能把额度瞬间烧穿,普通开发者根本用不起。
问题到底出在哪?
一. 旗舰模型别拿来跑腿
看一眼它的工作方式,原因其实一目了然。
在传统的单 Agent 使用习惯里,很多人直接让 Astra 从头干到尾。
Astra 既要做顶层设计,又要亲自去扫目录、翻几十个源文件。
让一个被大家寄予厚望的顶级模型,天天去翻代码、改配置、补增删改查,多少有点杀鸡用牛刀。
这在本质上就是“大炮打蚊子”。
Astra 消耗极大,让它去干底层的体力活,额度不烧穿才怪。
大家需要的不是硬憋着少用,而是把模型的分工彻底理顺。
二. 把 Astra 和 Luna 配成上下级
针对这个痛点,GitHub 上的开发者 donvito 在 9 月 5 日开源了一个新项目:codex-astra-luna-orchestrator。
这个项目上线几个小时,就在社区迅速火了起来。
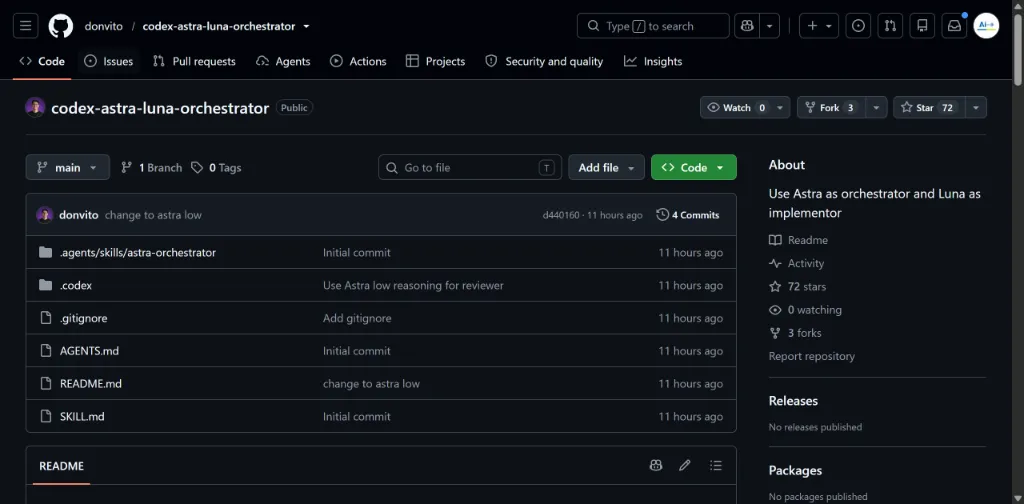
它的思路很干脆,利用 Codex Multi-Agent V2 的子 Agent 委托能力,直接配好了一套清晰的“上下级”分工编队:
让 GPT-6 Astra 退居幕后当总指挥,只管拆解任务、统筹进度和最终验收。
具体的体力活,全部绑定给便宜且响应极快的 GPT-5.6 Luna。
作者把具体的干活角色切成了 5 个固定子 Agent:
explorer负责代码库拓扑分析与文件依赖扫描。
worker负责有明确边界的具体代码实现与文件修改。
tester负责编写自动化测试用例并验证运行结果。
reviewer负责独立的代码审查与安全规范校验。
researcher负责外部技术文档查阅与依赖库检索。
动脑的高价值决策全归 Astra,跑腿的机械体力活全甩给 Luna。旗舰模型的额度瞬间得到了最大程度的保护。
三. 怎么在本地跑起来
最省事的办法不是自己去新建文件,而是直接把作者调校好的现成配置复制进项目。
作者在项目中采用了官方推荐的项目级安装(Project-scoped)方式,落地非常清晰:
第一步:复制三大核心文件到项目根目录
直接把开源项目里的这三部分,完整复制到你的代码仓库根目录下:
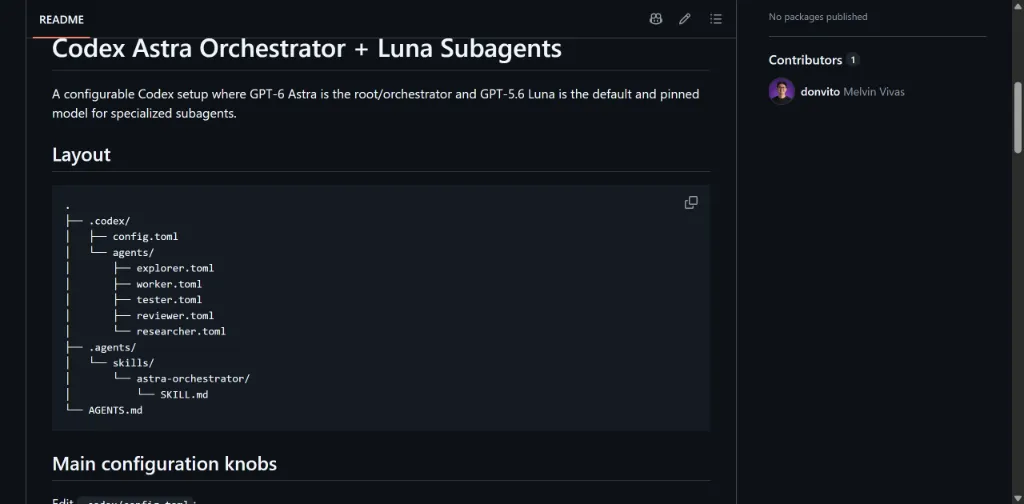
.codex/包含全局配置与 5 个子 Agent 规则文件
.agents/包含调度技能与流程设定
AGENTS.md协同规则与角色契约说明
只要放到项目根目录,从当前项目路径启动 Codex 就会自动生效。如果想全局生效,再合并进用户目录的 ~/.codex/。
第二步:确认核心配置的锁死机制
打开项目中的 .codex/config.toml,作者把上下级分工规则锁得很死:
model = "gpt-6-astra"
model_reasoning_effort = "high"

approval_policy = "on-request"
sandbox_mode = "workspace-write"

[agents]
enabled = true
max_concurrent_threads_per_session = 6
default_subagent_model = "gpt-5.6-luna"
default_subagent_reasoning_effort = "medium"根总指挥强制指定为 Astra,推理强度设为 high,保证顶层规划不走偏。
子 Agent 统一固定为 Luna,推理强度设为 medium,兼顾执行质量与响应速度。
第三步:看懂角色职责约束
在 .codex/agents/ 目录下,每个角色都锁定了具体的权限边界。
负责具体代码编写的 worker.toml:
name = "worker"
description = "Implementation subagent for bounded coding tasks."
model = "gpt-5.6-luna"
model_reasoning_effort = "medium"
sandbox_mode = "workspace-write"

developer_instructions = """
你是负责具体代码实现的子 Agent。
严格按照 Astra 分配的任务范围执行:
- 不擅自扩大修改范围
- 优先最小化改动
- 遵循项目现有代码规范
- 不擅自修改架构、API、数据库 Schema 或依赖
完成后向 Astra 汇报修改文件、测试结果和潜在风险。
"""负责测试验证的 tester.toml:
name = "tester"
description = "Verification subagent."
model = "gpt-5.6-luna"
model_reasoning_effort = "medium"
sandbox_mode = "workspace-write"

developer_instructions = """
你负责独立验证 worker 提交的代码。
优先运行最小范围测试,复现错误并保留完整错误信息。
除非 Astra 明确要求,否则不要为了让测试通过而修改生产代码。
最终汇报:
1. 执行了哪些命令
2. 测试是否通过
3. 关键错误信息
4. 尚未覆盖的问题
"""每个文件都显式固定了 model = "gpt-5.6-luna",无论你怎么切换默认模型,跑腿干活的永远不会误调用昂贵的 Astra。
第四步:在会话中直接派发任务
启动 Codex 并在对话框中直接输入:
$astra-orchestrator 实现新的账单批量导出接口。先让 explorer 梳理现有路径与数据流,worker 完成核心功能实现,tester 跑单测验证,最后由 reviewer 进行独立代码审查。回车后,Astra 会在对话中理出拆解规划,并在后台唤醒 Luna 分头行动。
几个节点同时读写代码、跑测试,最后由 Astra 汇总做最终确认。
实际使用时,记住两个清晰的边界:
增删改查、写单测这类体力活放手交给 Luna。
但底层数据库表结构、关键鉴权这类核心架构决策,必须要求 Astra 亲自输出方案。
另外并发也不要一口气拉爆,作者建议大项目控制在 6~8 条左右,避免文件改动冲突。
把传统的“全 Astra 硬刚”与这套编队摆在一起,差距非常直观:
| 维度 | 单模型跑到底(全 Astra) | 模型分工编队(Astra 统筹 + Luna 搬砖) |
|---|---|---|
| 工作机制 | 一个人既画图纸又搬砖、扫地 | Astra 专职架构与验收,Luna 批量跑腿 |
| 额度消耗 | 读文件改配置全烧旗舰配额,极易见底 | 绝大多数 Token 消耗在廉价的 Luna 上 |
| 等待体感 | 复杂任务全程高推理,耗时长且串行 | 子任务多线程并行推进,交付节奏极快 |
| 适合场景 | 几轮对话的小脚本、单文件修改 | 中大型工程重构、多模块协同、完整项目落地 |
算力再充沛,也不是拿来挥霍的。
顶级模型能力越来越强,聪明的开发者早就学会了不再让它做无意义的体力活。
把总指挥供在帅位上负责动脑,把工蜂撒出去批量搬砖。决定高级额度能撑多久的,往往不是你的配额上限,而是你如何分配手里的算力。
以上,如果觉得不错,随手点个赞、收藏、转发三连吧~如果想第一时间收到推送,也可以给我个星标 ⭐谢谢你看我的文章,你的关注是我持续更新的动力~
