
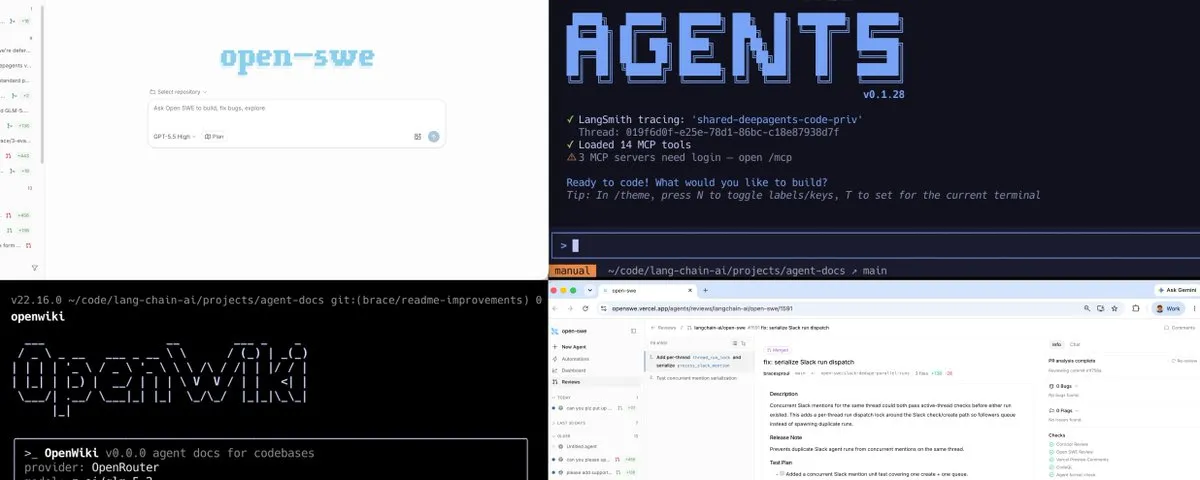
在 LangChain,我们会通过终端、Slack、Linear、GitHub 和 CI 与软件工程智能体协作。
不同工作流需要不同类型的智能体。本地写代码应该保持交互感;云端写代码应该能在后台运行并创建 PR;代码审查应该足够谨慎,并深度接入 GitHub;仓库文档应该贴近代码,为智能体提供有用上下文。
我们把这套系统做成了一组开源工具:
- dcode:用于本地编码
- OpenSWE:用于云端编码智能体
- OpenSWE Review:用于自动代码审查
- OpenWiki:用于仓库文档和智能体记忆
它们合在一起,构成了 LangChain 的软件工程智能体工厂。我们内部使用的形态就是这样:本地智能体、云端智能体、审查智能体、仓库记忆、开放模型,以及贯穿整个系统的 LangSmith traces。
为什么开源很重要
软件工程智能体会读取代码、编辑代码、审查 PR,并参与真实工程工作流。团队需要理解并控制这些智能体的行为方式。
如果智能体是封闭系统,这件事会很难。你只能使用供应商支持的模型、审查行为、集成方式和可观测能力。
我们希望团队能够检查、修改并适配智能体,让它们贴合自己的工作流,包括自己的审查标准、仓库约定、模型选择和内部工具。这也是这些项目开源的原因。
组成部分
dcode
dcode 是我们在终端里使用的本地编码智能体。
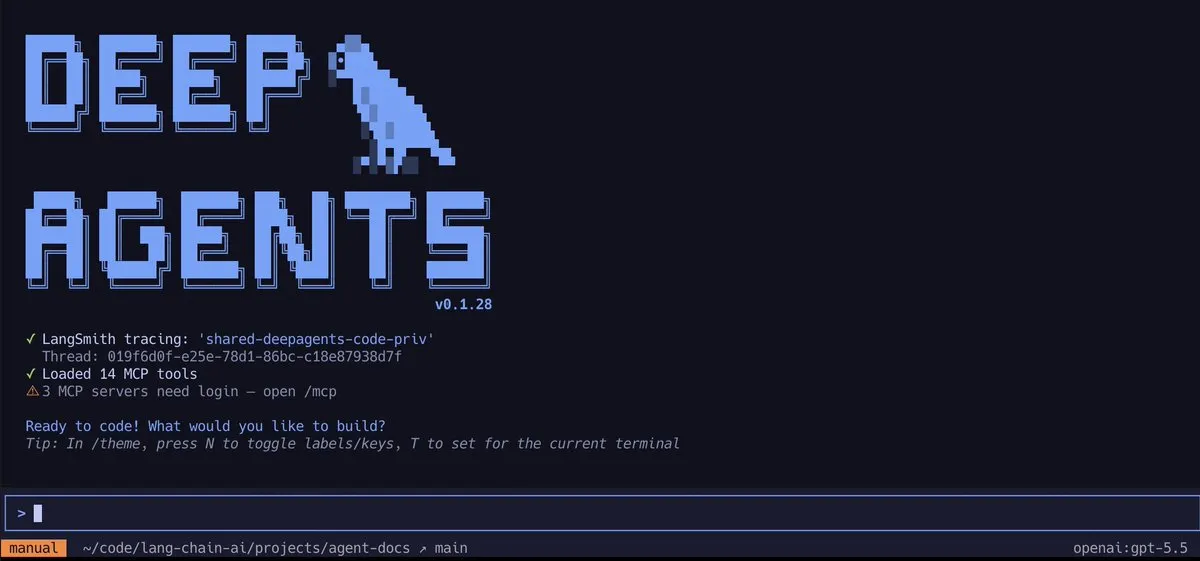
CLI 和智能体运行时会在你的本机运行,模型仍然可以托管在云端。这样开发者既能直接操作本地仓库,又能使用那些无法在笔记本电脑上运行的大型编码模型。
我们用 dcode 做交互式编码工作:探索仓库、修改代码,以及从终端执行实现任务。
OpenSWE
OpenSWE 是我们在需要后台处理任务时使用的云端编码智能体。
很多工程任务并不是从终端开始的。Bug 可能出现在 Slack 里,功能需求可能在 Linear 里,仓库维护任务可能需要按计划运行。
OpenSWE 可以从 Slack、Linear、GitHub 或 Web UI 触发。它会在云端运行、处理代码,并在完成后创建 pull request。
在 LangChain 内部,这已经成了我们最常用的智能体工作流之一。仅上周,我们就从 Slack 触发了近 1000 次 OpenSWE,这还不包括 Linear 或 UI 的使用量。
由于 OpenSWE 在云端沙箱中运行,我们可以并行运行大量编码智能体,而不会占用任何人的本地环境。
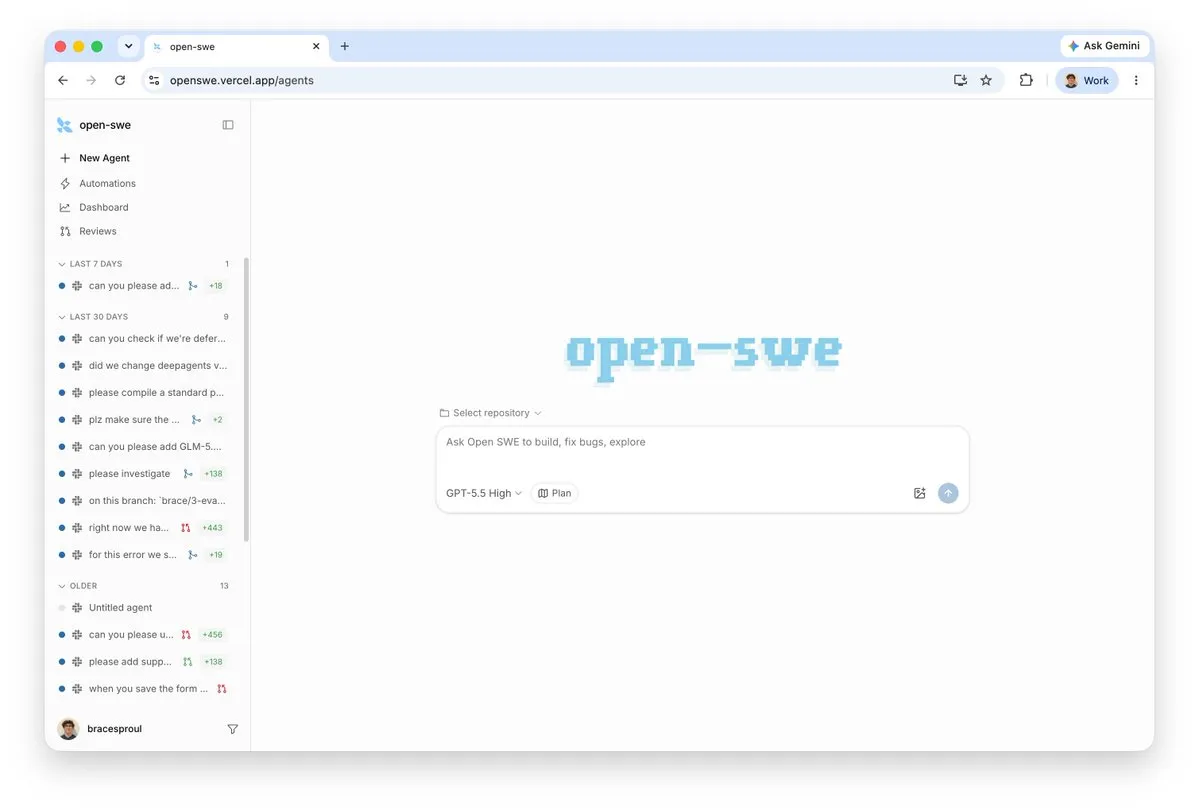
OpenSWE 还提供一个 UI,用来查看智能体工作过程、和云端编码智能体对话、配置模型和提示词、查看分析数据,并设置定时自动化。
OpenSWE Review
OpenSWE Review 会连接 GitHub,并自动审查 pull request。它可以在代码合并前识别 bug 和回归问题。
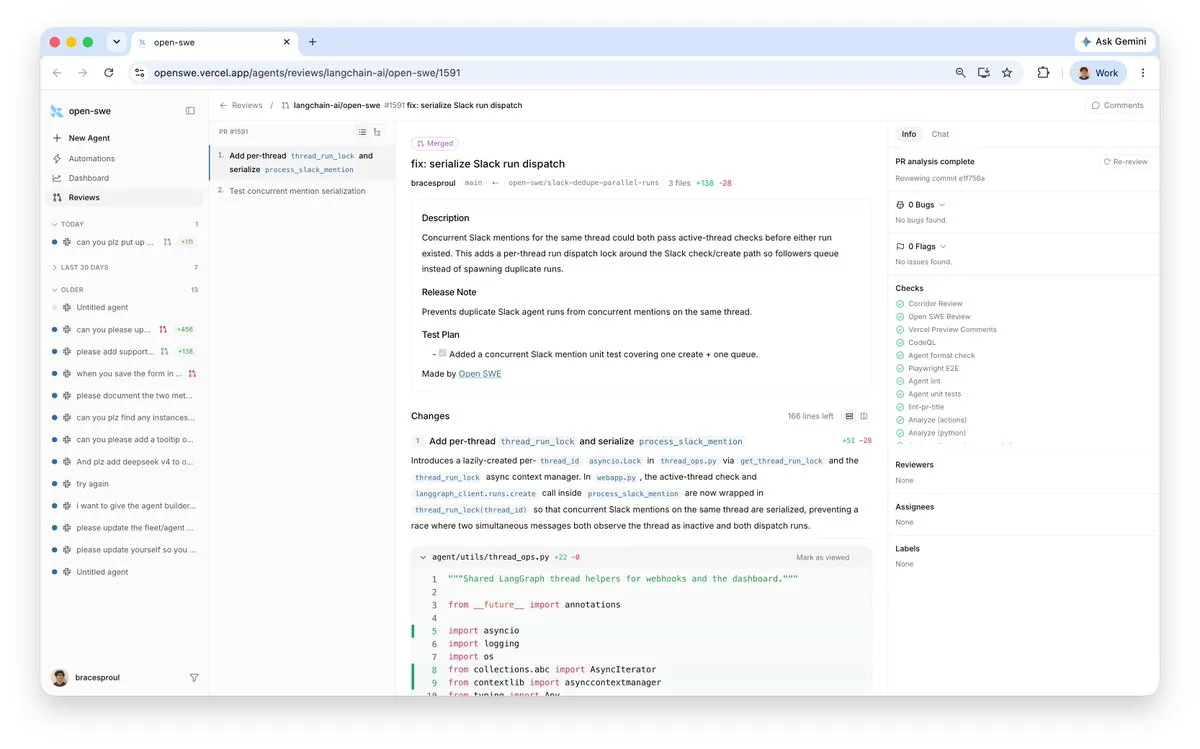
它在外部基准测试上的表现也很强。在 Offline Code Review Benchmark 中,OpenSWE Review 在使用 GPT-5.5、中等推理强度时得分 47%,整体排名第 6,并且在开源代码审查智能体中排名第 1。
代码审查高度依赖组织自身的习惯。不同团队关心的问题不同,评论措辞不同,对于智能体应该阻塞、建议还是保持沉默,也有不同偏好。
OpenSWE Review 给了我们一个很强的默认方案,同时可以通过修改提示词、工作流、模型选择和仓库专属行为来适配团队需要。
OpenWiki
OpenWiki 使用 Google 的 Open Knowledge Format 生成并维护代码库文档。
这些文档会和代码放在一起,并通过 GitHub Action 自动保持更新。这样,人类和智能体都能获得一层持续维护的仓库知识层,而且不需要手动维护文档,OpenWiki 会替你处理。
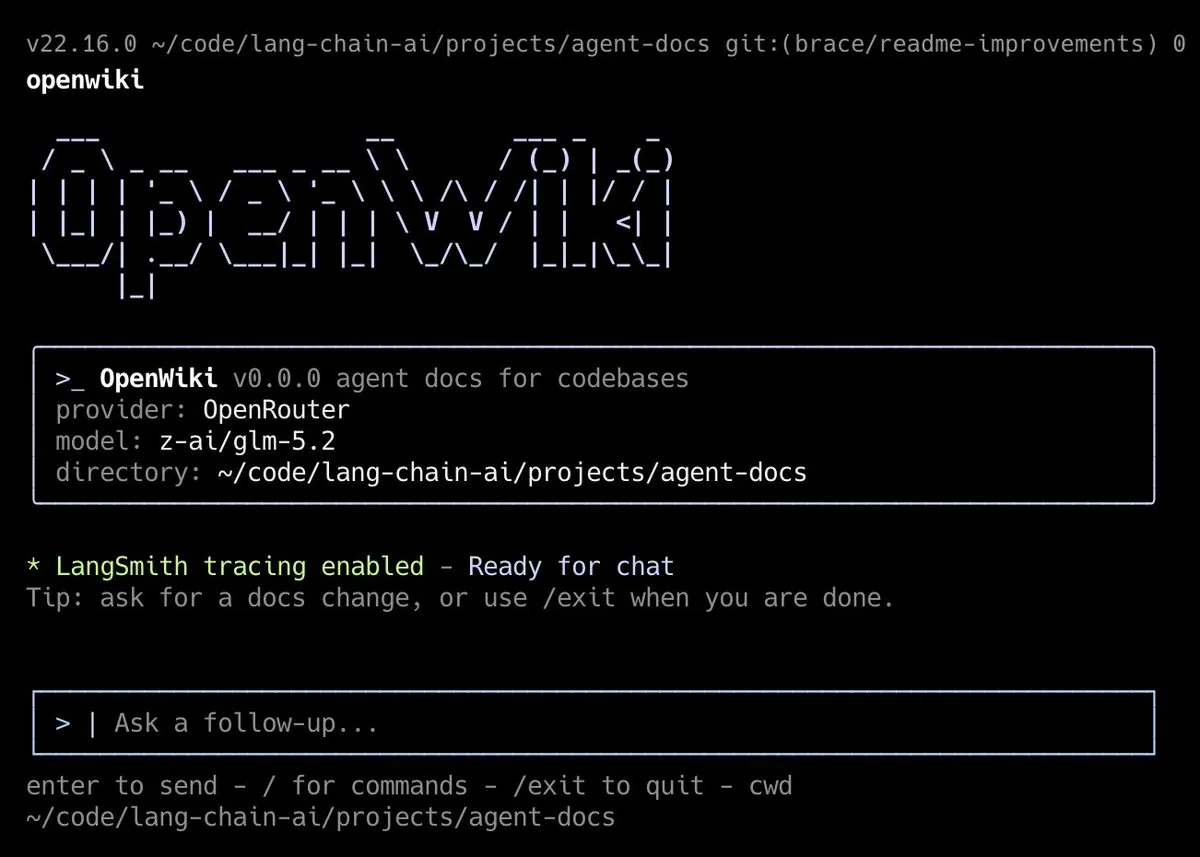
如果一个智能体每次运行都要重新发现仓库架构,它会浪费 token,也会错过重要约定。OpenWiki 给编码和审查智能体提供更好的起点,并支持自动更新流程,让你之后不必再操心智能体文档维护。
技术栈
Deep Agents
dcode、OpenSWE、OpenSWE Review 和 OpenWiki 都构建在 Deep Agents 之上。
这些工作流各不相同,但共享同一套底层智能体基础。这样我们就能用一致的方式,在本地编码、云端编码、代码审查和文档维护之间构建、定制和改进智能体。它们都基于同一个框架时,代码、资源和工程经验的复用也会更容易。
开放模型
我们针对开放模型优化了这套技术栈。
当软件工程智能体在组织范围内运行时,成本会很快上升。本地编码、云端编码、代码审查、文档维护、定时维护任务,以及重复的仓库分析都会消耗 token。
开放模型能让我们更好地控制成本,这是最关键的原因;同时也能控制延迟和部署选择。团队还可以把不同任务路由给不同模型,实验开放编码模型,甚至为自己的仓库和工作流微调模型。
LangSmith
我们用 LangSmith 跟踪这些智能体。
当智能体创建 PR、留下审查评论,或在任务中失败时,traces 会展示它查看过哪些文件、加载了哪些上下文、调用了哪些工具,以及卡在了哪里。
这些 traces 能帮助我们调试单次运行,并持续改进整个系统。我们会用它们识别失败模式、改进提示词、比较模型,并把更高质量的样例送入 LangSmith Engine 的持续改进工作流。
面向编码智能体的 Engine 是我们最近在实验的新工作流:让 Engine 读取编码智能体 traces,识别短板,并提出优化建议。由于 LangChain 每位员工触发的每一次编码智能体运行都会被追踪,Engine 可以从全局视角识别和执行这些优化,而不是只针对某个工程师的单次 trace 做局部分析。
构建你自己的软件工程智能体工厂
这套技术栈反映了 LangChain 内部使用软件工程智能体的方式。由于这些组成部分都是开源的,其他团队也可以根据自己的需求改造它们,并保留对自己软件工厂的完整控制权。
你可以从小处开始:
- 用 dcode 做本地编码。
- 加入 OpenSWE,从 Slack、Linear、GitHub 或 Web UI 运行编码智能体。
- 启用 OpenSWE Review 做自动 PR 审查。
- 使用 OpenWiki,为人类和智能体维护仓库知识。
- 如果你希望在整个系统中获得可观测能力和改进循环,可以连接 LangSmith traces。
目标不是把所有工程工作流都搬进同一个智能体界面,而是把合适的智能体放到工程工作本来发生的位置,并保留足够控制权,让它们适配你的仓库、模型和团队约定。
