
当编码智能体开始替你写代码时,真正的工程任务就变成了:定义什么才算“好”。
现在,编码智能体已经可以构建和改进其他智能体。你写下指令,运行智能体,找出它失败的地方,改写,再重复。这样的自我改进循环今天已经可以落地。我们开源的 agents-cli,也就是用于在 Google Cloud 上构建智能体的 CLI 和 skills,大部分工作就是在自动化这个流程。
但这个循环有一个盲点。
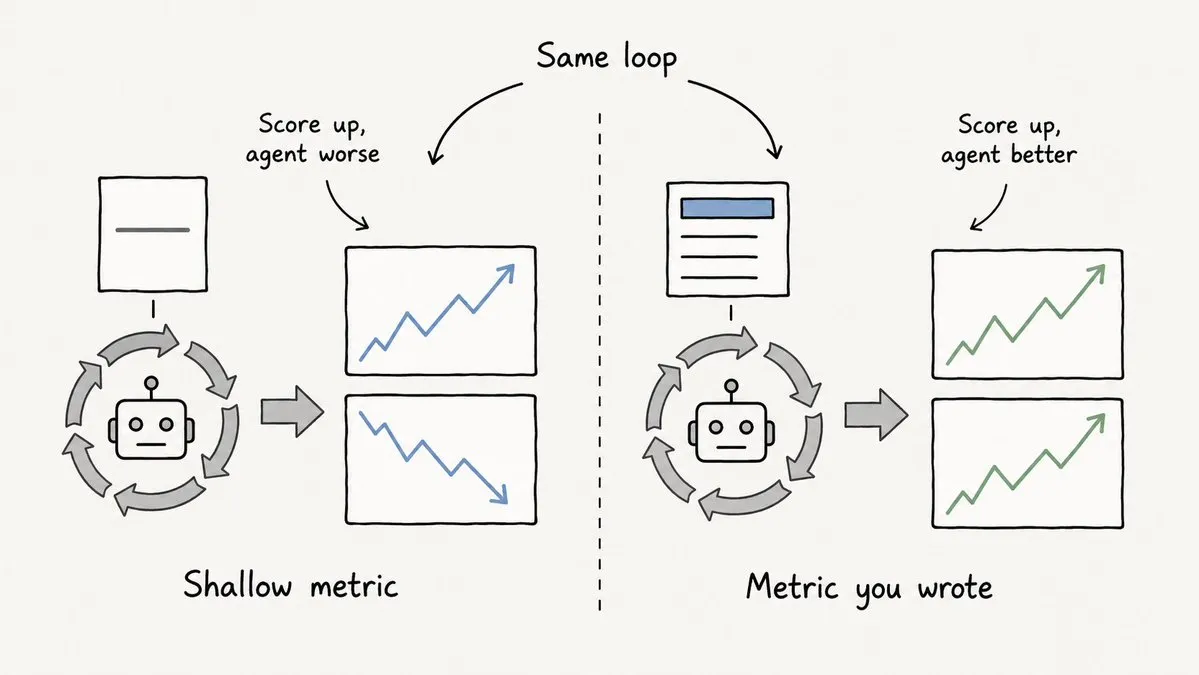
如果你给它一个浅层目标,它会把你的智能体优化成一个分数很好、实际更差的东西。然后它还会报告成功。因为按照它自己的衡量标准,它确实成功了。
这个循环可以自动化几乎所有事情,唯独不能替你定义“更好”到底是什么意思。
指标,就是你现在要编写的产物。 定义什么叫好,并把它测量到足以让循环朝着它改进,这才是工程判断真正转移过去的地方。本文会介绍这个循环如何运行,人类应该在哪里保持控制,以及让它不自欺的七条规则。
指标是你现在要编写的东西
软件团队一直都知道:你会得到你所衡量的东西。自我改进循环把这件事变成了字面意义上的现实。你给它哪个数字,它就改进哪个数字;而它内部没有任何机制能分辨,一个目标是真正反映了你想要的东西,还是只是分数看起来不错。
我们在构建这个工具时,一遍又一遍重新学到这一点。指标位于提示词、代码和行为的上游。循环会重塑这三者,让它们适配指标所奖励的东西。
每一次工具进步,都会把人的努力往上推一层。从汇编到编译器,从编译器到框架。而这一次,是从产物推到了标准。
质量是具体的,也属于你。
真正重要的“好”,很少是公共基准能测出来的。它可能是退款政策、升级处理规则、合规边界,或者客户能认出来的语气。
通用模型不知道这些东西,通用测试也不会检查这些东西。
设想一个客服智能体,它的规则是在确认取消之前,必须先提供挽留路径。模型可能在推理中遵守了这条规则,但最终回复里却把它漏掉。我们见过智能体以这种方式失败:内部状态是正确的,工具也调用对了,但发给用户的最终消息仍然复述了一个过期值。系统没有崩溃。快速扫一眼,输出也看起来没问题。但用户收到的答案是错的。
只有评估最终回复,而不是评估推理过程,才能抓住这种问题。 没有任何公共指标知道你的挽留规则存在。所以你要定义自己的指标:一个名为 retention_offered 的自定义指标,返回 0 或 1,并用一句话说明判定理由。只要写下来,这个定义就属于你:你可以拥有它、给它做版本管理,并随着新失败不断打磨它。
实际循环怎么跑
agents-cli 会把“测量并改进”的循环变成几条命令,用在基于 Agent Development Kit(ADK)构建的智能体上。先把它安装到你的编码智能体里:
agents-cli 会把“测量并改进”的循环变成几条命令,用在基于 Agent Development Kit(ADK)构建的智能体上。先把它安装到你的编码智能体里:
uvx google-agents-cli setup然后描述你想测量什么。
继续以上面的客服智能体为例。没有公共指标能捕捉它的挽留规则,所以你定义自己的指标:自定义指标 retention_offered,返回 0 或 1,并用一句话说明判定理由。这个定义就是后续一切判断所依据的标准。
编码智能体首先会在一组案例上运行你的智能体,生成执行轨迹:
agents-cli eval generate \
  --dataset tests/eval/datasets/cancellation_cases.json \
  -o artifacts/traces/
这时候最诱人的捷径,是让编码智能体读取自己的输出,并自行判断是否通过。但让智能体评价自己的回复,它通常会给出偏乐观的分数;而真正重要的失败,恰恰就是它最容易放过去的那类失败。
评分会打破这种循环论证。每条轨迹都按你的指标评分,而这个标准是编码智能体无法挪动的。因此,一个修复是否有效,是由提出修复之外的东西来判断:
agents-cli eval grade \
  --traces artifacts/traces/ \
--config tests/eval/eval_config.yaml现在,循环就可以自行改进了。每个失败案例都会带着指标给出的理由返回,而这个理由就是下一次尝试的方向。编码智能体读取理由,修改智能体指令,然后重新运行。接着,它会比较两次运行,确认改动确实有帮助,同时没有破坏别的东西:
agents-cli eval compare \
  artifacts/grade_results/results_baseline.json \
  artifacts/grade_results/results_after_fix.json
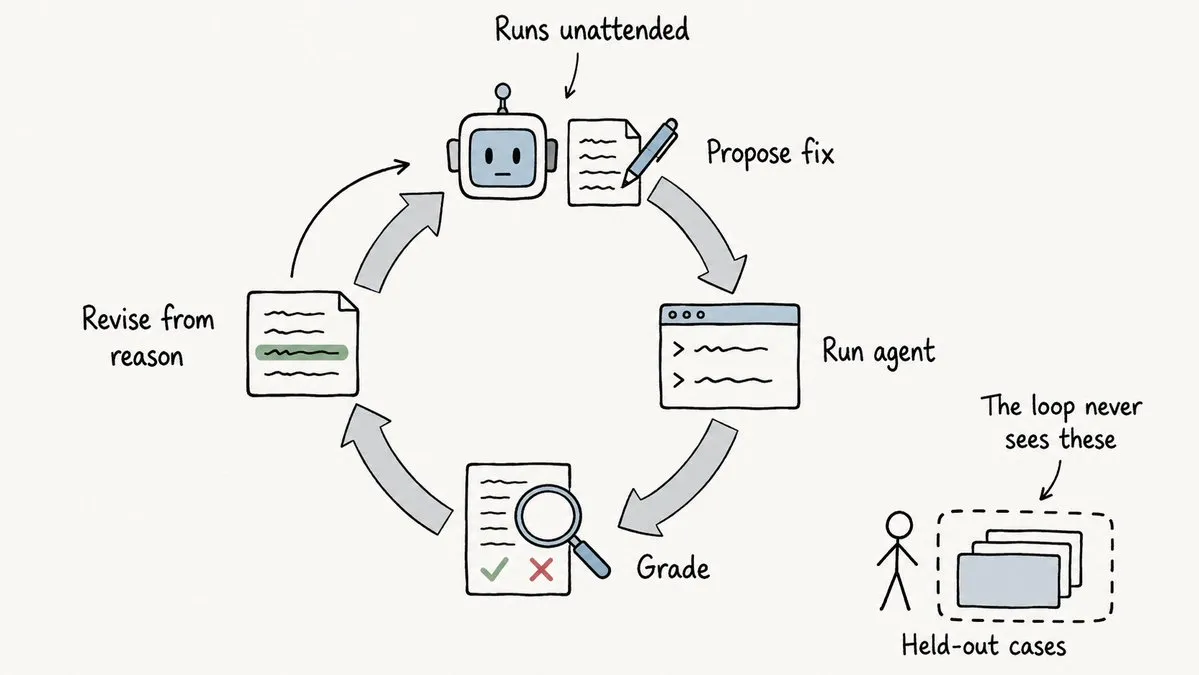
这个循环:提出修复、评分、根据理由继续修订,就是完整的优化过程。 它会在你的检查点之间自动运行:你设定目标并握住留出集,而循环用来转向的一切信息,都已经写在你定义的指标里。
自我改进循环的 7 条规则
把循环自动化是容易的。真正困难的是,在一个本来就被设计为无人值守运行的系统里,让人类仍然保持控制。以下七条规则就是我们的方法,现在它们也已经内置进 agents-cli 的 skills 中。
规则 1:从一个案例开始,而不是从一整套用例开始。 一个失败案例会告诉你下一步该修什么。二十个失败案例反而什么都说明不了。预期要迭代五到十次才通过,这是正常的。只有当它稳定通过后,再加入下一个案例。
规则 2:让评判器解释自己。 分数只告诉你失败了,理由才告诉你要改什么,而下一轮迭代正是从这个理由写出来的。确定性检查除外,因为断言本身就是解释。
规则 3:凡是答案确定的地方,都用代码。 “它是否在确认取消之前调用了挽留工具?”这是一个 Python 函数。精确、免费、没有评判器波动。把评判器留给语气、完整性,以及解释是否站得住脚。
规则 4:给行为打分,而不是给路径打分。 一个智能体在查询天气前先做地理编码,并不一定错。精确匹配执行轨迹,最后往往测到的是智能体变化了多少,而不是它变好了多少。
规则 5:把不稳定案例当成发现。 如果同一个案例在相同运行之间分数会波动,说明你的智能体存在你此前没注意到的非确定性,或者你的评判器有非确定性。把这个案例跑几次,看看到底是谁在变。删掉它,只是删掉了证据,不是删掉了行为。
规则 6:永远不要让提出方案的人移动标准线。 标准线有三种移动方式:降低阈值、编辑预期输出、悄悄删除案例。这三种都会让分数看起来在变好。这就是留出切片存在的意义。真正的提升也会出现在那里;被操纵出来的提升不会。
规则 7:只在最后做一次自动优化。 提示词优化很贵,而且它只会修措辞,永远不会补上缺失的工具调用。反复围绕它循环,只是在花几个小时重新发现失败理由早就告诉你的事。
它会随着时间复利
收益会随着时间增长。评测集会变成一份持久记录,记录你的组织到底如何定义质量。它可以在开发过程中按需运行,也可以在每次变更时跑在 CI 里,而且始终对应同一个“好”的定义。
部署之后,同一个定义仍然有效。开发时你叫它评测,生产时你叫它监控。它其实是同一个指标。
一个已经部署的智能体,本来就会导出自己的执行轨迹。启用提示词-回复日志后,它的提示词和回复会进入 BigQuery,因此在这张表上运行你的指标,本质上就是把同样的评分步骤应用到真实流量,而不是事先写好的数据集。
评测和可观测性,最终其实是同一个循环的两种采样方式。 一种采样你写下的案例,另一种采样你没有预先写下的对话。
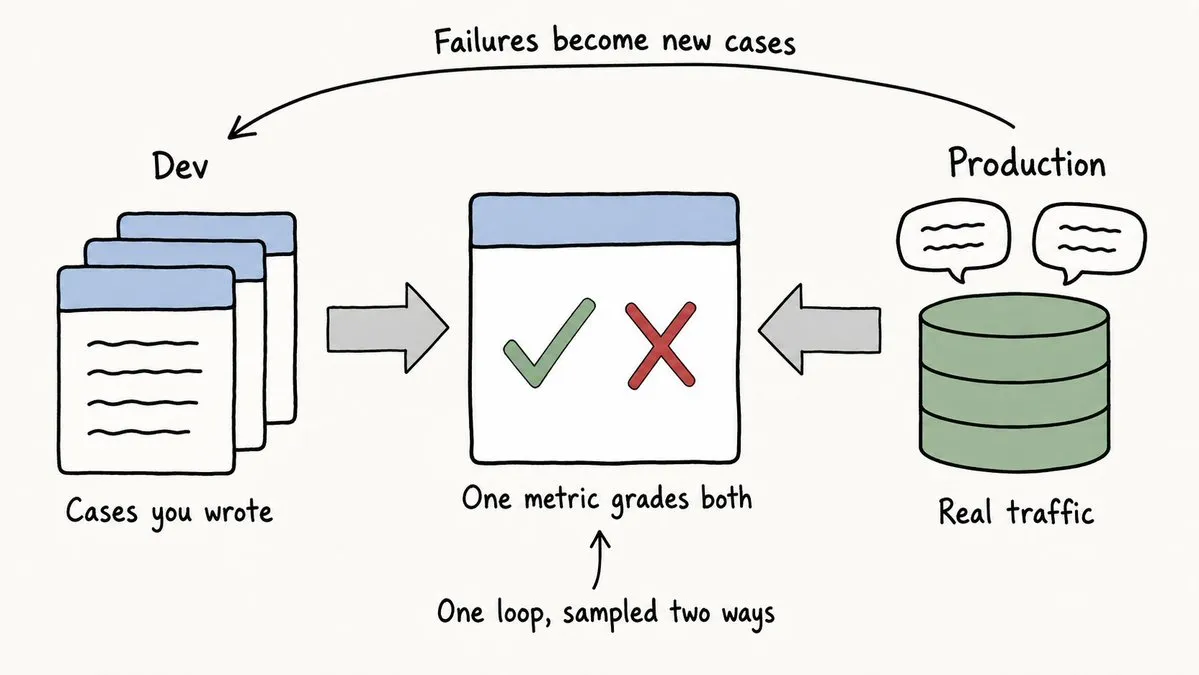
每一次出错的生产交互,都会变成一个新案例,并由同一个指标评分,从此守住这类回归。把每次评分都看成方向信号,而不是绝对真值;相比单个分数,更应该相信多次运行之间的变化趋势。
今天就开始
有一条规则高于其他七条。编码智能体负责迭代。它写提示词,运行智能体,找到差距,并把差距补上。它不能生成的,是那个它要朝着优化的“好”的定义。
在启动循环之前,先把这个定义写下来。并且把它放在循环够不到的地方。
然后从今天开始使用 agents-cli,从小处开始:
uvx google-agents-cli setup选一个你的智能体必须做对的行为。挽留规则,合规边界,或者你现在还需要靠阅读转录记录来检查的那件事。把它写成一个指标:返回通过或失败,并附上一句理由。加入一个失败案例。让你的编码智能体对准它,然后让循环跑起来。
第一轮就这么简单:一个指标,一个案例,一个循环。完整文档见 google.github.io/agents-cli。
你的智能体不必完美。它必须能够改进。
