
我有一台 RTX 5070 Laptop 的 Windows 笔记本,8GB 显存、32GB 内存——按社区说法这配置连视频模型的门槛都够不着。但我用它把一档艺术史短片系列的 出图、出视频、配音 全搬到了本地,云端只留了配乐。这篇把整套框架拆开写给你:谁干什么、用什么模型、装什么、以及哪些坑我已经替你踩完了。不是教你复刻我的片子,是给你一个能照着搭的技术框架。
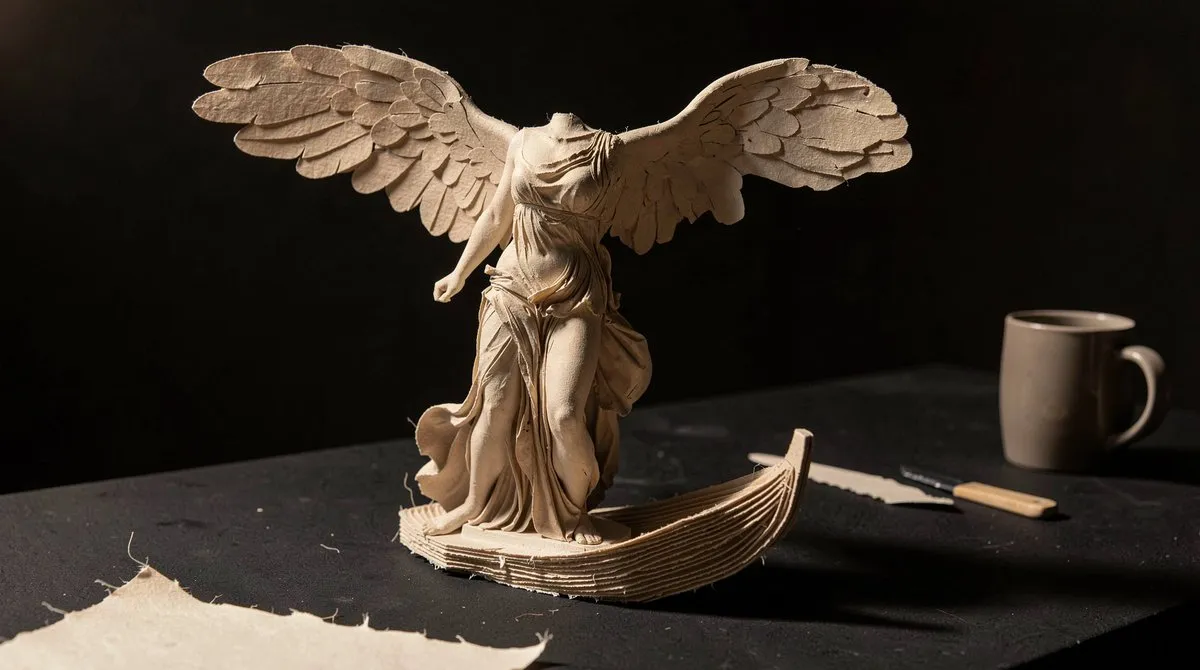
框架只有一句话:agent 当导演,本地模型当工人
很多人把 AI 做视频理解成"找一个最强的模型",其实真正的结构是:
一个部署在本地的 agent(Claude Code 或 Codex,两者都行)扮演导演 ——它不生成任何画面和声音,它负责:
- 立项、选题、写剧本、写台词
- 核查事实
- 拆分镜、决定每个镜头拍什么
- 写所有提示词 (出图的、运镜的)
- 看到结果不对,判断是哪一环的问题,改了再来
本地模型是工人,只执行导演给的提示词,各干一件事互不相干。
1 、导演 :Claude Code / Codex ,负责: 剧本、台词、核查、分镜、写全部提示词、判断返;
2、出图 | FLUX.2 Klein | 把作品重构成目标材质的关键帧 |
3、出视频 | MiniMax H3 | 关键帧 → 带镜头运动的片段 |
4、配音 | IndexTTS2 | 台词 → 旁白语音 |
5 、装配 | ffmpeg 脚本 | 画面+字幕+旁白+音乐+音效 → 成片 |
导演和工人 分在两台机器 :Mac 跑 agent 做所有创作决策,Windows 只跑 GPU 活,素材靠内网互传。这样分的好处是 Mac 不生成任何画面、Windows 不做任何创作决策 ,出问题时一眼知道该查哪边。
前期完全没有模型参与,全是 agent 在写:立项定选题(要维护一张"已用作品台账",选题前先查重)→ 写分段旁白( 旁白是整条流水线的时间基准 ,镜头数、切片长度、字幕时间码、配乐长度全由它推导,所以旁白不定稿别动任何画面)→ 事实核查 → 写分镜。核查这里我栽过一次:文字事实九项全过,但没人核对 参考图画的是不是那件作品 ,结果拿错了同一画家的另一幅画,而且那幅是已完成的,我的旁白整段在讲"这幅没画完"。核查清单一定要加这条。
最全工具下载地址,三条本地管线( HuggingFace )
出图 FLUX.2 Klein
  官方 9B        https://hf.co/black-forest-labs/FLUX.2-klein-9B
  ComfyUI 打包版  https://hf.co/Comfy-Org/flux2-klein
  NVFP4 量化版    https://hf.co/black-forest-labs/FLUX.2-klein-9b-nvfp4
  9B 配套编码器   https://hf.co/Comfy-Org/vae-text-encorder-for-flux-klein-9b

出视频 MiniMax H3(需 ComfyUI_MiniMaxH3_Director 节点)
  官方           https://hf.co/MiniMaxAI/MiniMax-H3
  ComfyUI 版     https://hf.co/Comfy-Org/MiniMax-H3
  INT4/NVFP4     https://hf.co/Abiray/Minimax-H3-nvfp4-INT4-INT8-Convrot
  GGUF           https://hf.co/Abiray/MiniMax-H3-GGUF

配音 IndexTTS2 https://hf.co/IndexTeam/IndexTTS-28GB 显存能跑 9B 出图 :NVFP4 量化版模型 5.37GB + 编码器 6.34GB,1920×1080 一张约 54 秒,显存峰值 6.6GB。RTX 50 系是 Blackwell 原生 FP4,ComfyUI 会自动走 FP4 路径,不用装额外节点。 8GB 也能跑 H3 INT4 出视频 (社区流传的"最低 12GB"不是硬门槛):864×480 / 124 帧 / 25 步 = 496 秒,峰值显存只有 6.2GB。 🔴 真正的瓶颈是 系统内存不是显存 ——显存还剩 2GB,32GB 内存却被吃到 29.7GB,要提分辨率先清内存。
出图最值钱的一条:参考图必须给两张
要把一件雕塑重构成"手工纸材质", 只给作品原图永远做不出来 ,出来一定还是石膏大理石。我写过 \CRITICAL MATERIAL RULE: NOT clay, NOT stone...\ 这种全大写强调,两轮都失败。原因是参考图注入的 latent 同时携带形态和材质,文字权重压不过它 。解法是链式两张参考图且顺序不能反:\文本编码 → ReferenceLatent(材质锚点) → ReferenceLatent(作品原图) → 出图\。第一张是材质锚点——一张 纯抽象的目标材质照片 ,不含任何具体作品;第二张才是作品原图。
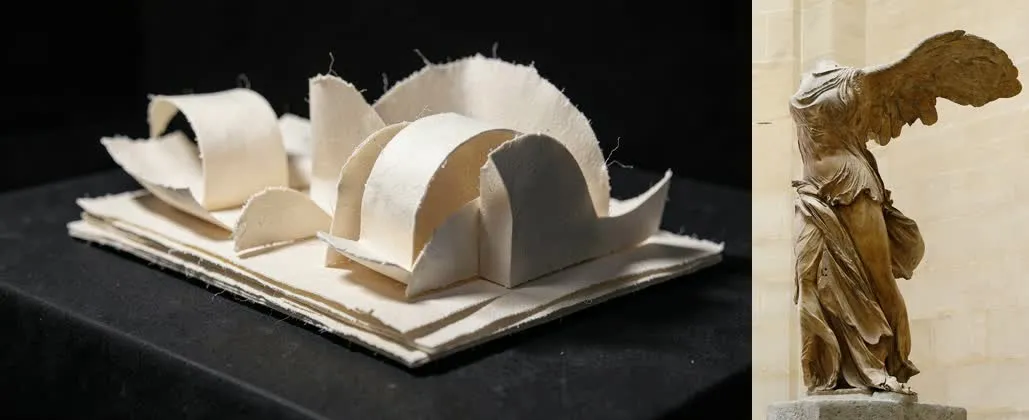
左=材质锚点,右=作品原图
我拿这套机制和 GPT-Image-2(LM Arena 榜首)跑过同题对比: 在"剪纸工艺质感"这一项上本地赢 ——它没有这种图像级的材质约束,纯靠文字压不住模型对"这件作品=石膏雕像"的先验,我明写 \not stone, not plaster\ 它照样出石膏。它赢的地方也很实在:雕塑形态和衣纹精度明显更高,那是训练规模的优势。
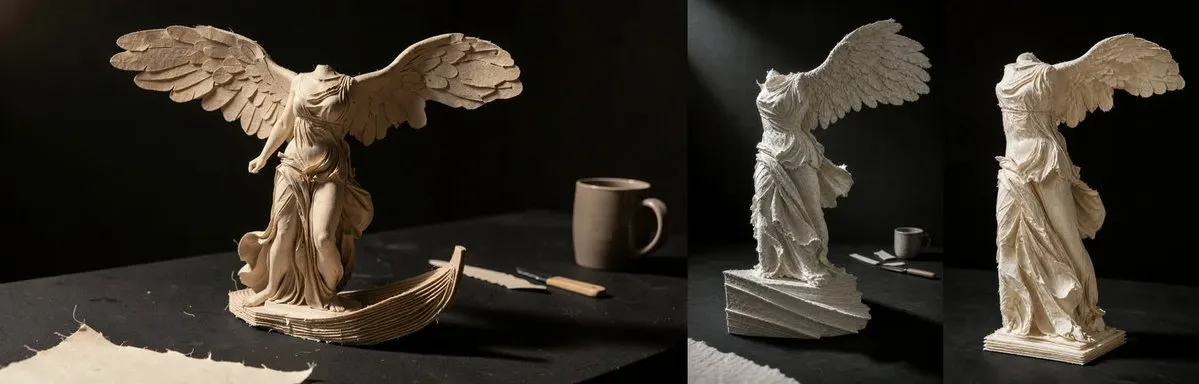
左=本地9B双参考,中=GPT-Image-2纯文字,右=GPT-Image-2给了参考图
出视频:必须用 fl2v,不能用 i2v
i2v 逐帧重新生成,主体宽窄、部件数量、底座形状 帧帧漂移 ,我实测末帧偏离首帧达 41(同口径 fl2v 只有 1.3)。fl2v 把 \startImage = endImage = 同一张关键帧\,两端钉死,结构完全锁住。 画面必须保持可辨认(名画、产品、人物)就只能用 fl2v。
fl2v 的能力边界这几条能省你几天: ✅ "整片纸离开原位"可以给大幅度(掀起、剥离、抽走、移出画面); ❌ "就地旋转/展开/伸展"一定塌,我让一片羽毛就地转 30°,模型把整只翅膀重画成了另一只——因为 fl2v 钉死首尾帧但中间帧仍是生成的,模型没有刚体旋转手段,要一个部件换姿态只能重画它。 🔴 还有个反直觉的: 首帧=尾帧所以动作必然往返 ,不可能单向,写"被抽走"实际是那片纸中途出现再消失, 解法在剪辑——每条切片只取一半 。算力上注意 长切片反而更慢 :5.17 秒切片每秒成片 96 秒,8 秒切片要 112 秒;覆盖 190 秒正片大约 5–6.5 小时 GPU,排期按整天算。
配音三条硬经验
\max_text_tokens_per_segment\ 必须调到 60 (UI 默认 120)——54 字的句子在 120 下超过 10 分钟不返回,60 只要 19 秒。 必须按句切分、一句一次请求 并做断点续跑,因为耗时随单次文本长度 非线性暴涨 :33 字几十秒,54 字约 5 分钟,148 字直接卡死。\length_penalty\ 提不了语速 (全区间只动 5%),要提速在后期做变速。
配乐我用 ChatCut 的 Claude Code 插件(原创曲、随片授权)。 🔴 两个坑:仓库 243M,默认 120 秒超时一定失败必须加环境变量;插件工具 只在新开的会话里出现 ,装它的那个会话里调不到。以下是安装::
CLAUDE_CODE_PLUGIN_GIT_TIMEOUT_MS=600000 \
  claude plugin marketplace add https://github.com/ChatCut-Inc/agent-plugin.git#main
claude plugin install chatcut@chatcut-inc提示词由谁写:导演写,而且要看着结果改
这点我想强调: 提示词不是一次性写好的文案,是一个带反馈的迭代过程 ,所以必须由能看到结果的 agent 来写。我的做法是 agent 写提示词 → 跑 → agent 自己看生成的图 → 判断哪里不对 → 改 → 再跑,每一轮的失败结论都写进一个 json 文件,下一集直接复用。
举个最贵的例子。我要一件 无头无臂 的雕塑:写两次 \headless / armless\ → 出来带完整双臂;写十一次 \no arms / no hands / no fingers\ → 手臂 更 完整;通篇不出现 arm/hand/head 任何一个词、只正面描述"剩下什么、纸在哪里停住" → 手臂当场消失 。否定词照样把概念送进条件里, 说得越多召唤得越狠 。补一句:这条规律在 4B 模型上成立,我在 9B 上重测发现 已经不成立了 ——所以这类经验一定要标注模型版本,别当永恒真理。
最后一个坑,不说会害你几小时
🔴 GPU 三类负载硬互斥,而且"开着不用"也照样占卡。 我有一次只把 TTS 服务起回来、忘了停 ComfyUI,配音直接从 2–4 倍实时掉到 约 60 倍实时 ,96 个字跑了 25 分钟。排查时千万别先怀疑模型参数(我实测 26 秒的参考音比 9 秒的还快), 先看是不是有另一个进程在抢卡 。另外 ssh 会话一断,Windows 会杀掉整个子进程树 ,\Start-Process -Hidden\ 也逃不掉,长任务要用 WMI 启动才能真正脱离。
这套框架适合:有一台带独显的机器(8GB 就够)、内容是 系列化 的(框架价值在复用,做一集不划算做二十集非常划算)、画面需要跨集稳定的统一风格、不想让素材离开本机。不适合的情况也说清楚: 追求极致镜头动态的话本地现在还差一截 ,我实测本地 fl2v 的镜头内动态只有云端方案的一个零头,这是首尾帧钉死换结构稳定必须付的代价,我的处理是混合——绝大部分本地跑,少数需要"物质性动态"的关键镜头走云端。
模型会换,坑不会。 agent 当导演、本地模型当工人、每条经验都标注模型版本 ,这三条我觉得能管挺久。
第一条出的时候需要你很有耐心的去多次纠正,给出标准的东西到了后面就很快了这个工作流就是我理想的工作样子了,再也不要 180 秒花 300 快钱,做出来图一乐,钱也花了,并没有什么流量,毫无价值,你只是给字节贡献了模型训练+给了钱+丰富了字节的闭环商业生态,每个环节都在薅你的血汗钱,成为合格的血包?
如何把你有的 Mac 电脑跟你的 Windows 机器关联起来,让你在外面喝咖啡的时候也能遥控家里的 windows 干活去看我上一篇文章,写的非常详细.
📎 原文信息
