
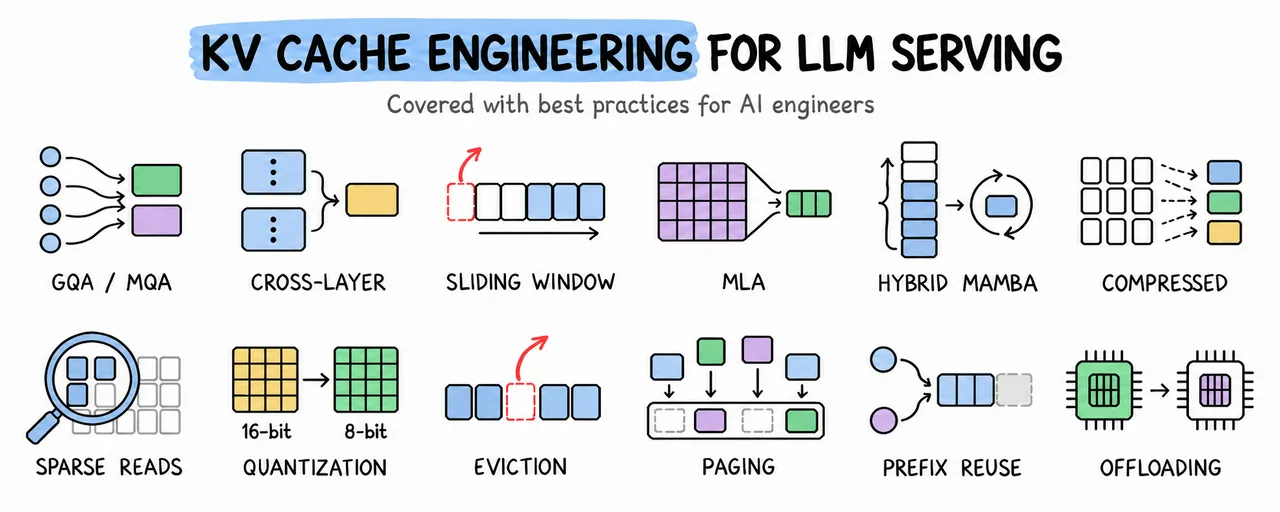
你需要了解的一切:为什么 KV 缓存会增长、模型和推理引擎减少它的 12 种方式、每种技术实际节省了什么,以及决定哪种适合你的工作负载的权衡。
加载 LLM 只是 GPU 内存规划的第一部分。
模型权重在推理期间大致保持固定。KV 缓存并非如此。它随序列中每个 token 的增长而增长,默认情况下,每个活跃序列都需要自己的缓存。
对于 Llama 3.1 70B,一个 128K token 的序列需要约 40 GB 的 BF16 KV 缓存。四个全长序列将额外增加 160 GB,尚未计入模型权重和推理开销。
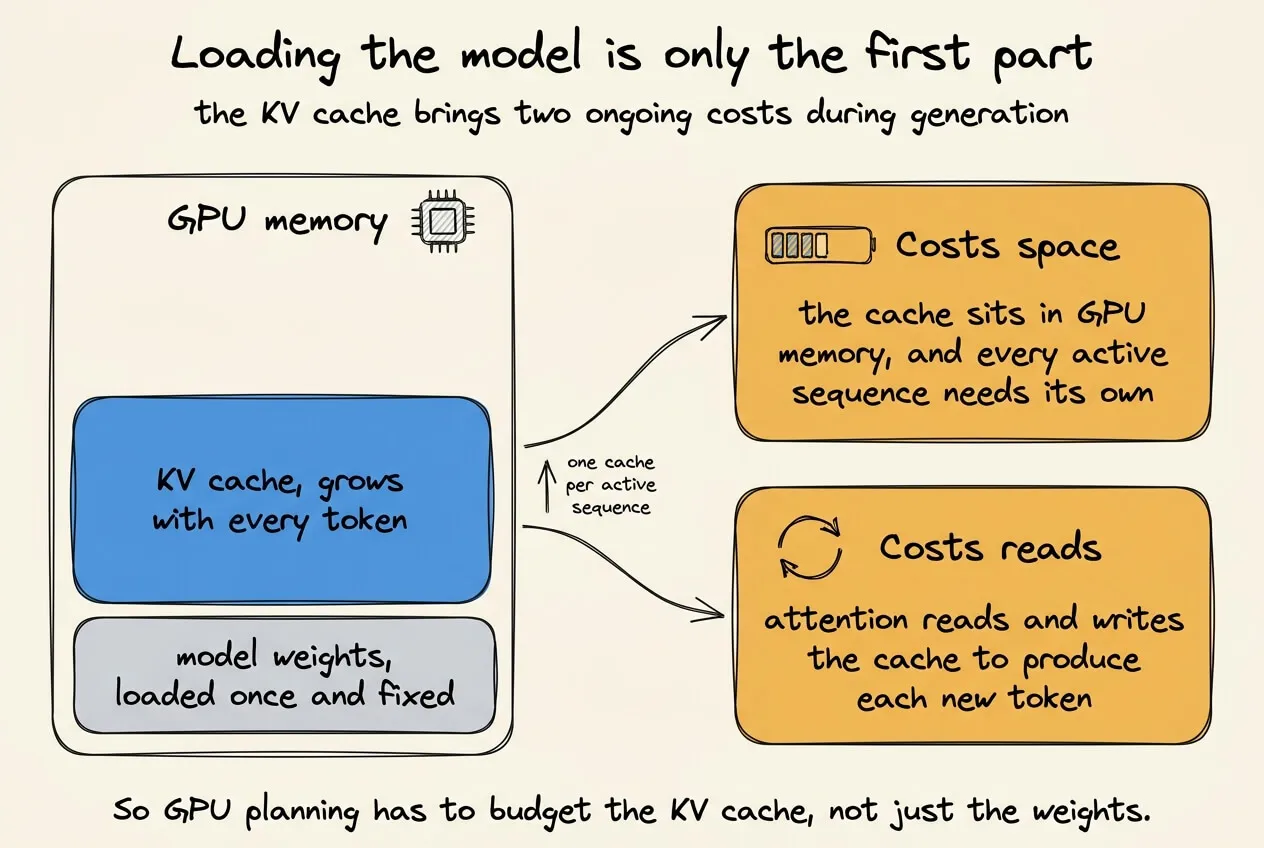
这产生了两种独立的成本。缓存占用 GPU 内存,而注意力层在生成新 token 时必须反复读取它。
描述为 KV 缓存优化的技术针对该问题的不同部分。有些改变模型存储的内容。有些保留更少的 token 或使用更少的位。其他保持逻辑缓存不变,并改进推理引擎读取、分配、共享或移动它的方式。
本文按它们减少的内容、何时可应用以及留下的权衡来组织十二种技术。每个部分包含一个可运行的小示例,用于解释主要思想。
缓存公式(The cache formula)
每个注意力层为每个保留的 token 存储一个键和一个值。
一个序列的原始缓存大小为:
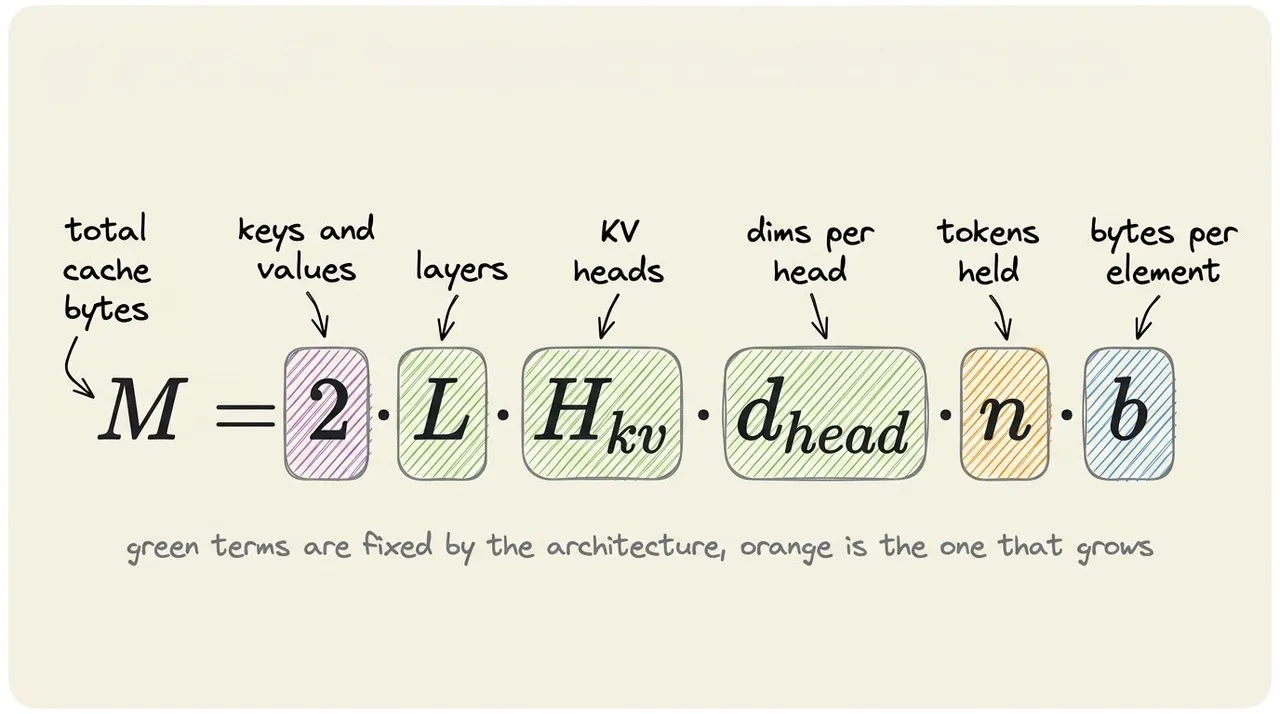
开头的 2 计算键和值。BF16 每个值使用两个字节,而 FP8 使用一个。
该公式也为我们提供了一种清晰的方法来对这些技术进行分组:
- GQA 和 MQA 减少了 KV 头的数量。
- 跨层注意力减少了唯一缓存层的数量。
- 滑动窗口和驱逐减少了保留 token 的数量。
- MLA 减少了存储表示的宽度。
- 量化减少了每个值使用的字节数。
- 混合循环层用固定大小的状态取代了不断增长的缓存。
- 分页和前缀复用减少了分配浪费和重复块。
稀疏注意力需要单独说明。它可能读取更少的 token 而不将其从内存中移除,因此可以在缓存容量不变的情况下减少注意力计算。
当 GPU 已满时,这种区别很重要。更快的注意力内核不会为另一个序列腾出空间,除非它也存储更少的字节。
技术图谱(Technique map)
下面的图表将所有 12 种技术集中在一处,显示每种技术改变了什么,以及其主要节省来自更少的头、层、token、维度、位还是重复内存。
上面的表格代表了每种技术试图解决的问题。
下面的象限图选取六种代表性技术,按它们是减少缓存内存、注意力计算还是两者兼有来重新组织。完整集合仍在上面的表格中。
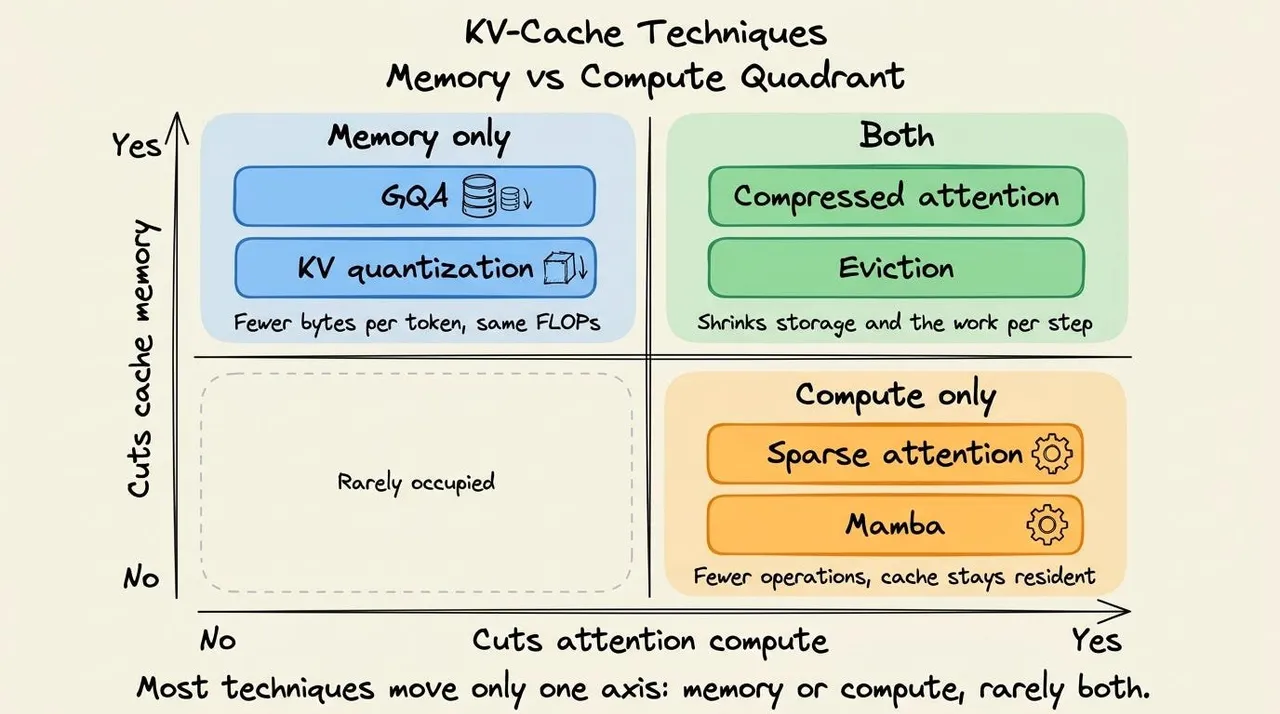
本文的其余部分按顺序详细讲解完整表格。
1. GQA and MQA(分组查询注意力和多查询注意力)缓存更少的头
上面的缓存公式包含一个 KV 头的项。减少该项是可用的最大架构节省之一。
在每个 transformer 层内部,每个 token 产生三种表示:
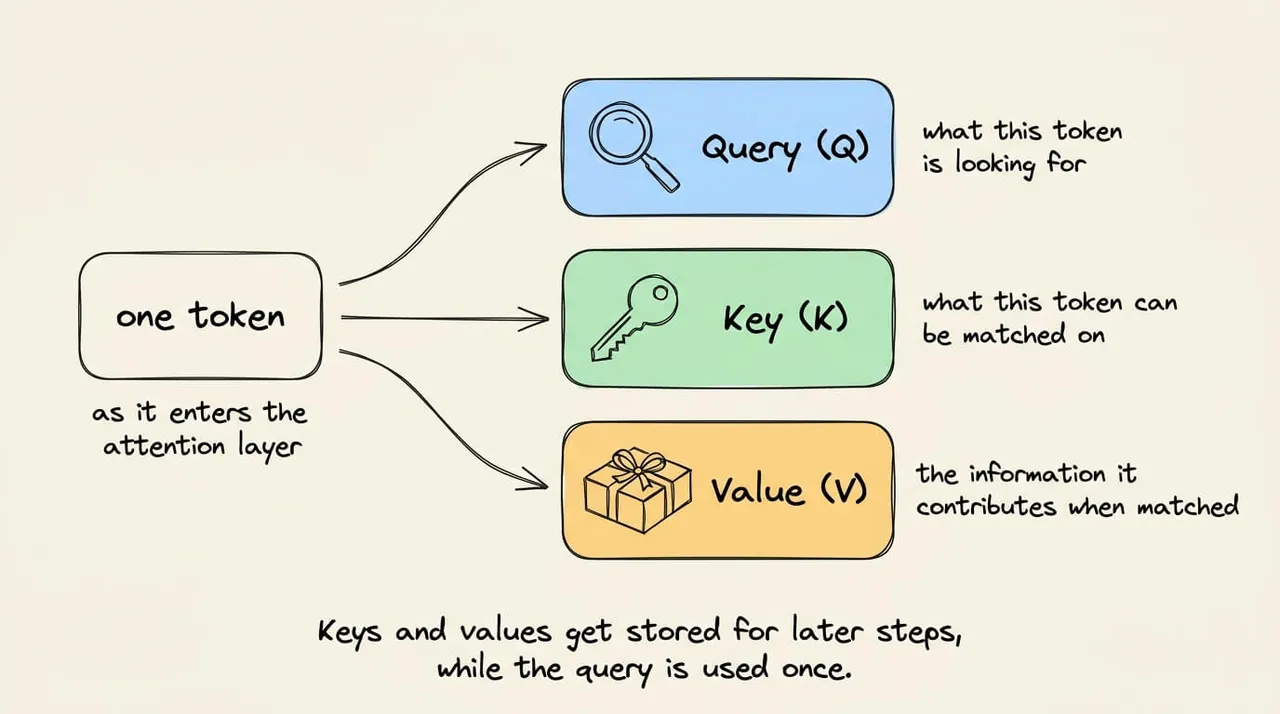
- 查询表示当前 token 需要的内容。
- 键描述每个早期 token 可以匹配的内容。
- 值携带当该匹配获得注意力时返回的信息。
在生成期间,当前 token 的查询与缓存的键进行比较。
注意力将这些表示拆分为更小的部分,称为头。
查询头是 token 查询表示的一个切片。它不是用户的提示词或单独的模型请求。不同的头可以学习关注同一序列中不同的关系。
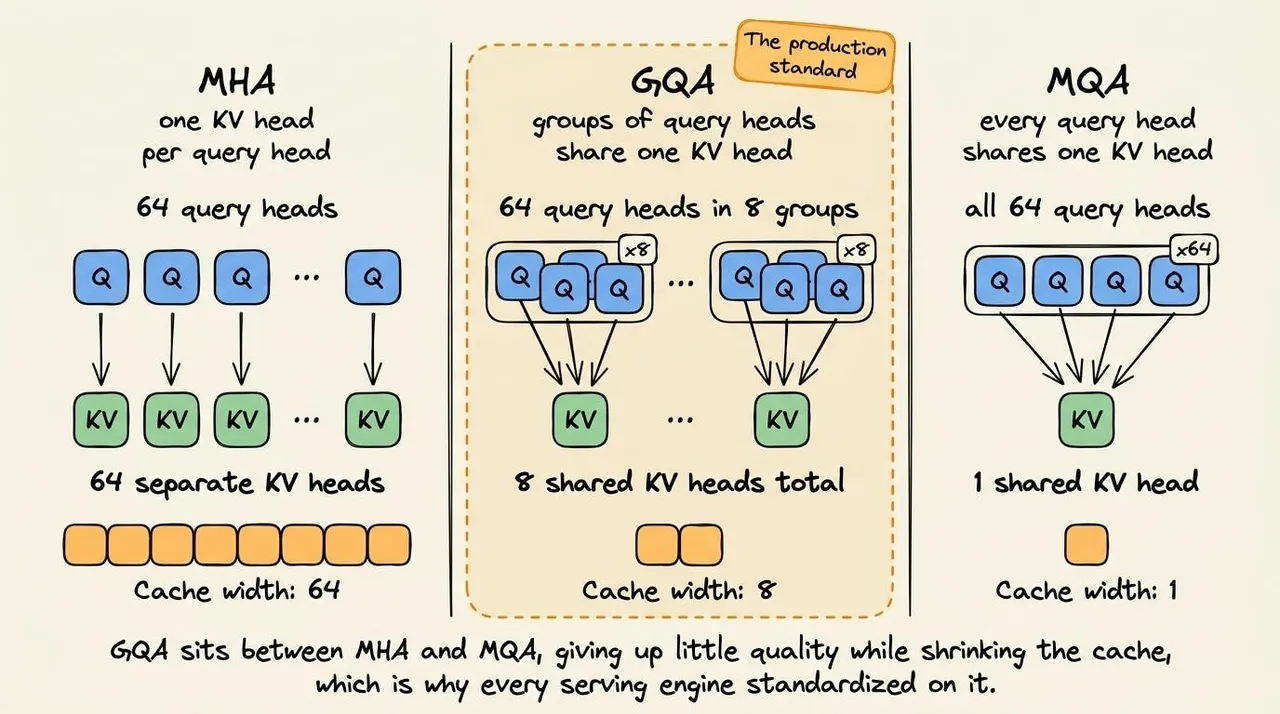
- 标准多头注意力(MHA)为每个查询头提供匹配的键头和值头。因此,一个有八个查询头的层会产生八个键头和八个值头。每个注意力层独立执行此投影并保留自己的 KV 缓存。
- 多查询注意力(MQA)保留所有八个查询头,但只产生一个键头和一个值头。每个查询头从该共享 KV 对中读取。这种共享不会跨越 transformer 层。
- 分组查询注意力(GQA)位于这两种布局之间。它将查询头分成组,并为每组分配一个 KV 对。对于八个查询头和两个 KV 头,四个查询头共享每个 KV 对。
这三种方法都在每个注意力层内部运作。它们仅在该层存储的 KV 头数量上有所不同。接下来要介绍的跨层注意力是一个独立的概念,它在层与层之间共享缓存信息。
GQA 论文将其描述为介于 MHA 和 MQA 之间的中间点。
作者转换了现有的 MHA 检查点,并使用了原始预训练算力的 5% 进行恢复训练。他们的升级训练 GQA 模型在质量上接近 MHA,同时接近 MQA 的速度。
以下示例使用八个查询头,展示了每个查询头读取哪个 KV 头,并统计了六个 token 的缓存标量数量:
query_heads = 8
tokens = 6
head_size = 8

for name, kv_heads in [("MHA", 8), ("GQA", 2), ("MQA", 1)]:
    queries_per_kv_head = query_heads // kv_heads
    mapping = [head // queries_per_kv_head for head in range(query_heads)]
    cached_scalars = 2 * kv_heads * tokens * head_size

    print(name, "mapping:", mapping)
    print(name, "cached scalars:", cached_scalars)

# Output:
"""
MHA mapping: [0, 1, 2, 3, 4, 5, 6, 7]
MHA cached scalars: 768
GQA mapping: [0, 0, 0, 0, 1, 1, 1, 1]
GQA cached scalars: 192
MQA mapping: [0, 0, 0, 0, 0, 0, 0, 0]
MQA cached scalars: 96
"""映射表为每个查询头列出一个 KV 头编号。MHA 每次都使用不同的 KV 头。GQA 让查询头 0-3 共享 KV 头 0,查询头 4-7 共享 KV 头 1。MQA 将每个查询头都映射到 KV 头 0。
缓存计数同时包括键和值,然后乘以六个 token 和每个头八个标量。
Llama 3.1 70B 使用 64 个查询头和 8 个 KV 头。在 128K 上下文长度下,这产生 40GB 的 BF16 缓存,而相同形状但使用 64 个 KV 头则需要 320GB。
这段代码证明了存储比例。它不测试质量,因为头共享改变了模型学习的内容,必须在训练后进行评估。
2. Cross-layer attention(跨层注意力)
GQA 在一个层内跨头共享键和值。跨层注意力则在相邻层之间共享它们。
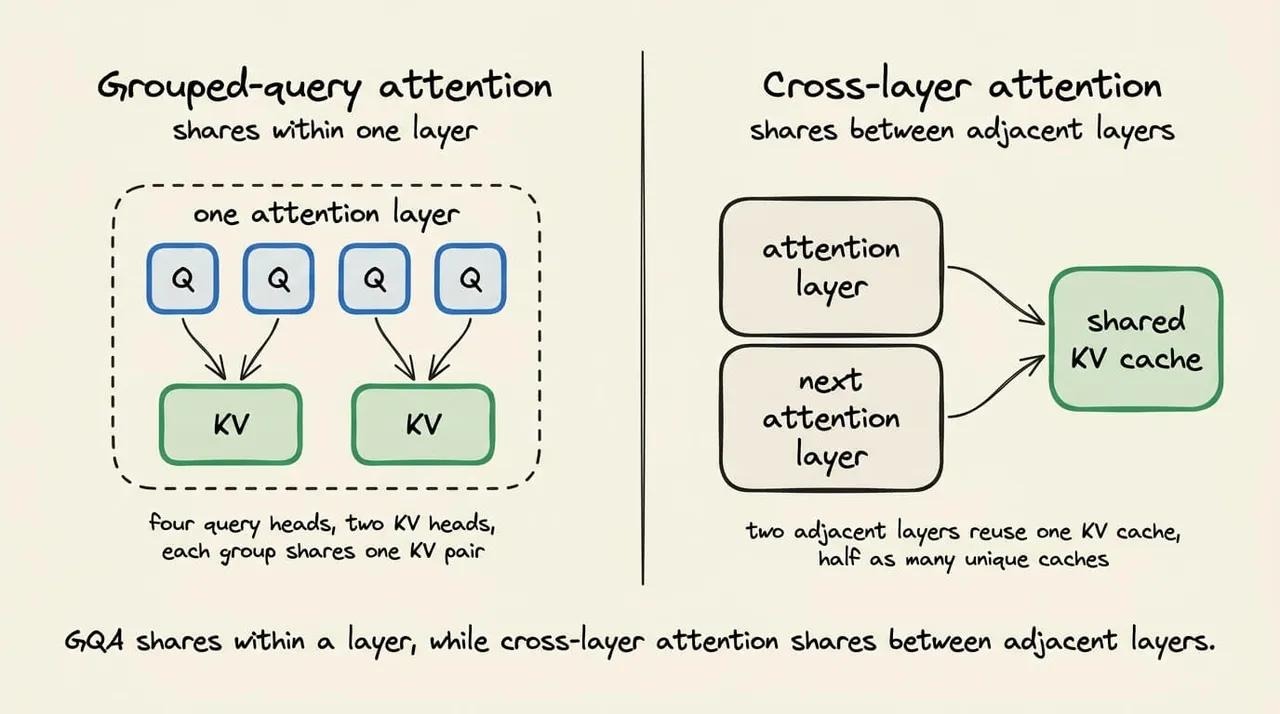
因此,共享因子为 2 意味着两个注意力层使用一组共享的缓存键和值。模型现在存储的独立层缓存数量减少一半。
跨层注意力(CLA)论文训练了 1B 和 3B 模型,报告了 KV 缓存再减少 2 倍的效果,同时保持了接近 MQA 基线的准确率。
接下来的脚本表示两个层共享一个缓存分配:
tokens = 32
kv_heads = 2
head_size = 8

one_layer_cache = 2 * tokens * kv_heads * head_size
shared_cache = {"stored_scalars": one_layer_cache}
layer_caches = [shared_cache, shared_cache]

separate_total = 2 * one_layer_cache
shared_total = shared_cache["stored_scalars"]

print("layers point to same cache:", layer_caches[0] is layer_caches[1])
print("two separate layer caches:", separate_total, "scalars")
print("one shared layer cache:", shared_total, "scalars")

# Output:
"""
layers point to same cache: True
two separate layer caches: 2048 scalars
one shared layer cache: 1024 scalars
"""这里一层会存储 1024 个标量。开头的 2 计数的是键和值。两个独立的层因此会存储 2048 个标量。
layer_caches 中的两个元素指向同一个 Python 对象。即使两个逻辑层都在使用,物理存储仍然是 1024 个标量。
跨层共享与 GQA 是叠加关系,因为它减少的是不同的项。GQA 减少每个层内存储的 KV 头数量。CLA 减少整个模型中存储的不同层缓存数量。
标准检查点会为每一层学习独立的 KV 投影。每一层期望使用由自身权重创建的缓存。将其重定向到另一层的缓存会改变模型的计算。
CLA 模型在训练时就已带有共享模式。训练让每个依赖层适应共享的缓存。服务引擎随后必须重现相同的所有权模式。
检查点和引擎必须就哪个层拥有哪个缓存达成一致。这就是为什么 CLA 不能作为通用的运行时标志启用。
3. Sliding windows(滑动窗口)
CLA 减少了存储层缓存的数量。滑动窗口注意力减少了选定层内存储的 token 数量。
在完全自注意力中,每个新 token 可以关注所有更早的 token。因此每个注意力层必须为整个序列保留键和值。随着序列增长,每一层的 KV 缓存也随之增长。
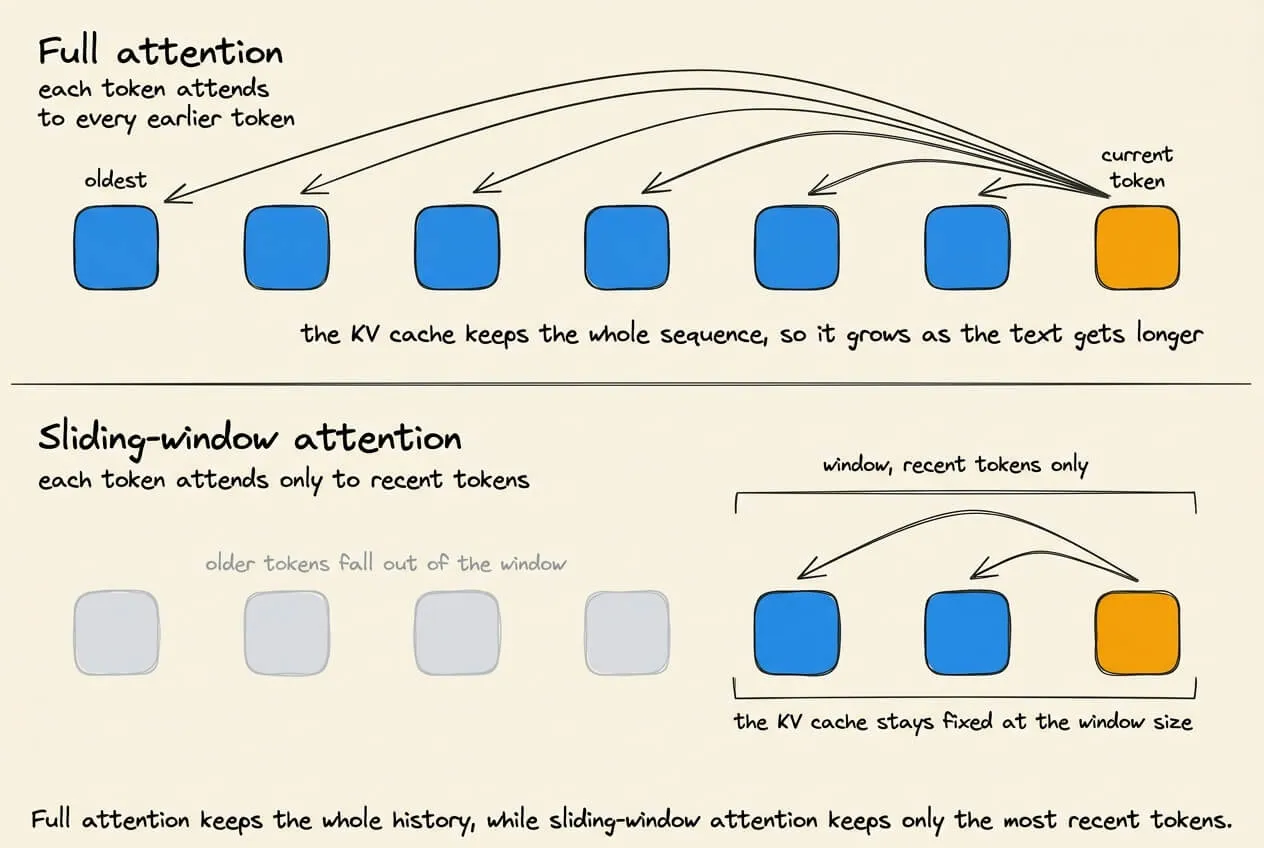
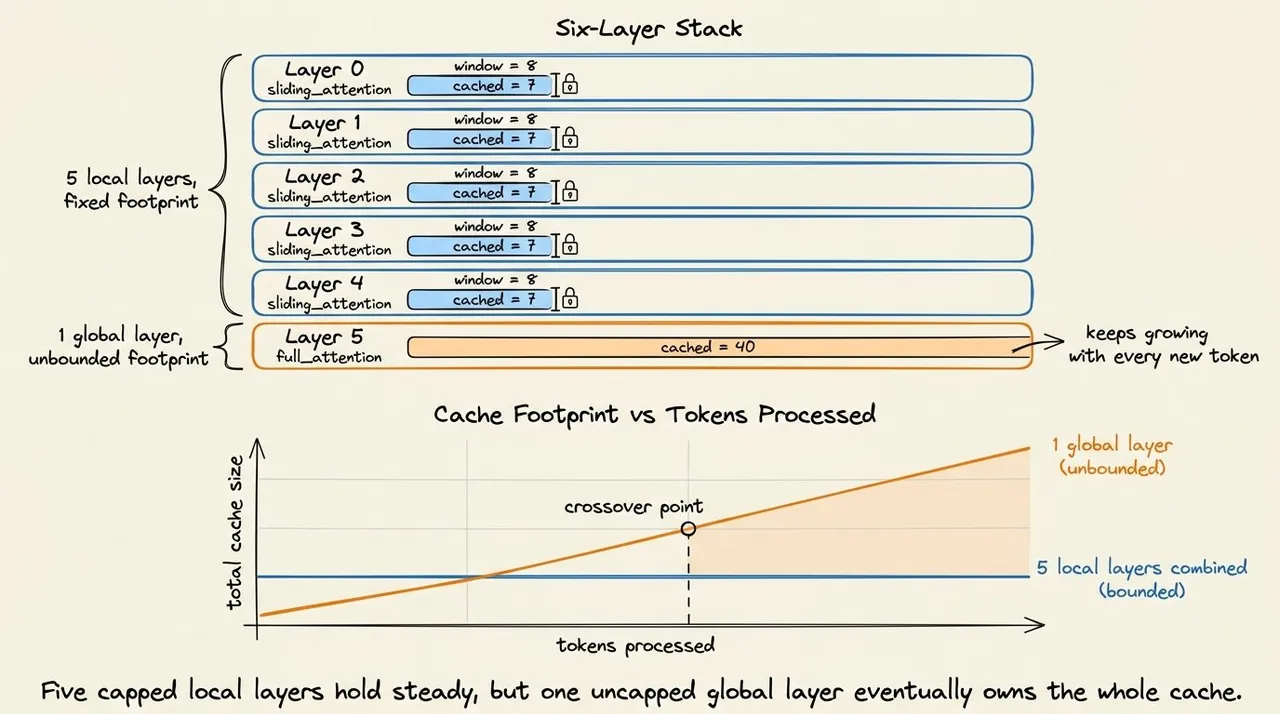
滑动窗口注意力将层限制为仅关注最近的 token。假设窗口包含 1024 个位置。该层只存储最近 1024 个 token 的 KV 条目。窗口填满后,每个新条目都会移除最旧的一个。它的缓存随后固定在 1024 个位置。
我们称之为局部层,因为它只看到附近的上下文。全局层仍然可以关注所有更早的 token。它的缓存会持续增长直到序列结束。
许多模型混合使用两种层类型。局部层提供了大部分内存节省。偶尔的全局层保留了对提示词远距离部分的访问。总缓存仍然在增长,但比处处使用完全注意力要慢得多。
例如,Gemma 3 使用五个局部层后跟一个全局层的重复模式。其局部窗口为 1024 个 token,而全局层支持完整的 128K 上下文:
以下示例跟踪一个四 token 窗口保留的位置:
window_size = 4
retained_positions = []

for position in range(10):
    retained_positions.append(position)

    if len(retained_positions) > window_size:
        retained_positions.pop(0)

    print(f"after token {position}: {retained_positions}")

print("maximum retained positions:", window_size)

# Output:
"""
after token 0: [0]
after token 1: [0, 1]
after token 2: [0, 1, 2]
after token 3: [0, 1, 2, 3]
after token 4: [1, 2, 3, 4]
after token 5: [2, 3, 4, 5]
after token 6: [3, 4, 5, 6]
after token 7: [4, 5, 6, 7]
after token 8: [5, 6, 7, 8]
after token 9: [6, 7, 8, 9]
maximum retained positions: 4
"""列表依次填入位置 0 到 3。当位置 4 到达时,列表变得过长。移除第一个元素会丢弃位置 0。
同样的步骤对每个后续 token 重复。生产引擎通常使用环形缓冲区,它在不移动其余条目的情况下覆盖旧槽位。
前四个 token 填满了可用槽位。Token 4 随后移除 token 0,窗口移至位置 1 到 4。每个后续 token 都将该范围向前移动一位。在 token 9 之后,只剩位置 6 到 9。分配在整个过程中始终固定在四个槽位。
比例也随上下文长度变化。在 1024 个 token 以下,两种布局保留相同数量的位置。节省只在序列超过局部窗口后才出现。
4. Multi-head latent attention(多头潜在注意力)
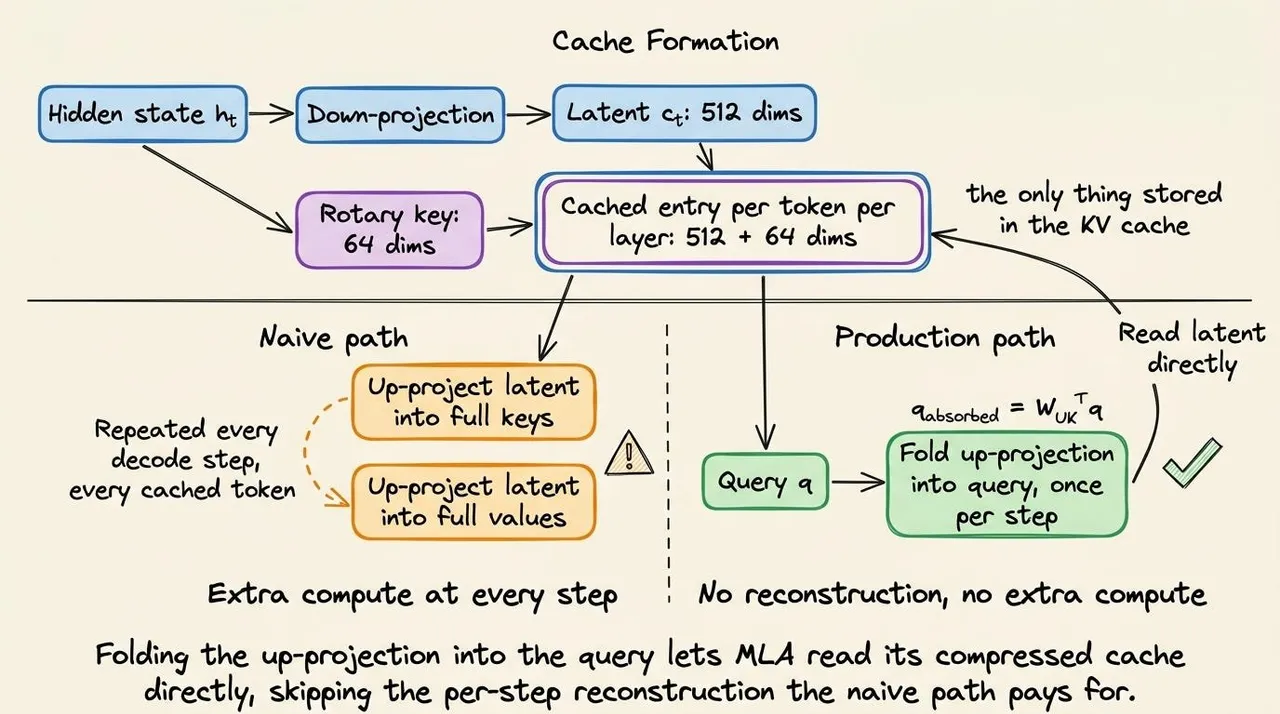
多头潜在注意力,即 MLA,不为每个头缓存完整的键和值。它将隐藏状态压缩成更小的潜在表示并存储该表示。
在解码过程中,模型使用学习到的投影来恢复注意力所需的信息。
实现可以将这些投影的部分吸收到查询和输出路径中,这避免了在内存中重建每个完整的 KV 张量。
DeepSeek-V2 引入了这一设计。论文报告称,与 DeepSeek 67B 相比,KV 缓存减少了 93.3%,最大生成吞吐量提高了 5.76 倍:
实际的 MLA 层使用学习到的矩阵来创建和使用潜在表示。这些矩阵运算在小例子中掩盖了基本的内存差异。
以下示例统计一个 token 的存储。维度有意设得很小,使两种布局的差异清晰可见。
kv_heads = 4
head_size = 8

standard_keys = kv_heads * head_size
standard_values = kv_heads * head_size
standard_total = standard_keys + standard_values

mla_latent = 8
mla_rotary_key = 4
mla_total = mla_latent + mla_rotary_key

print("standard cache:", standard_keys, "key +", standard_values, "value")
print("MLA cache:", mla_latent, "latent +", mla_rotary_key, "rotary key")
print("stored scalars per token:", standard_total, "->", mla_total)
print(f"example reduction: {standard_total / mla_total:.2f}x")

# Output:
"""
standard cache: 32 key + 32 value
MLA cache: 8 latent + 4 rotary key
stored scalars per token: 64 -> 12
example reduction: 5.33x
"""四个 KV 头各有八个标量,产生 32 个键标量。值需要另外 32 个。因此标准注意力每个 token 存储 64 个标量。
示例性的 MLA 布局存储八个潜在标量和四个位置标量。总计为 12。将 64 除以 12 得到示例比例。
5.33 倍这个数字仅适用于此示例。真正的 MLA 模型会选择不同的潜在维度和位置维度。
MLA 不是标准检查点的推理标志。其投影权重和缓存布局属于训练好的模型。转换其他模型仍需训练。
5. Replace growing cache with fixed state using Hybrid models(使用混合模型用固定状态替代增长的缓存)
Mamba 和循环线性注意力层不会为每个旧 token 存储一份键和值。它们会在序列增长时更新一个固定大小的状态。
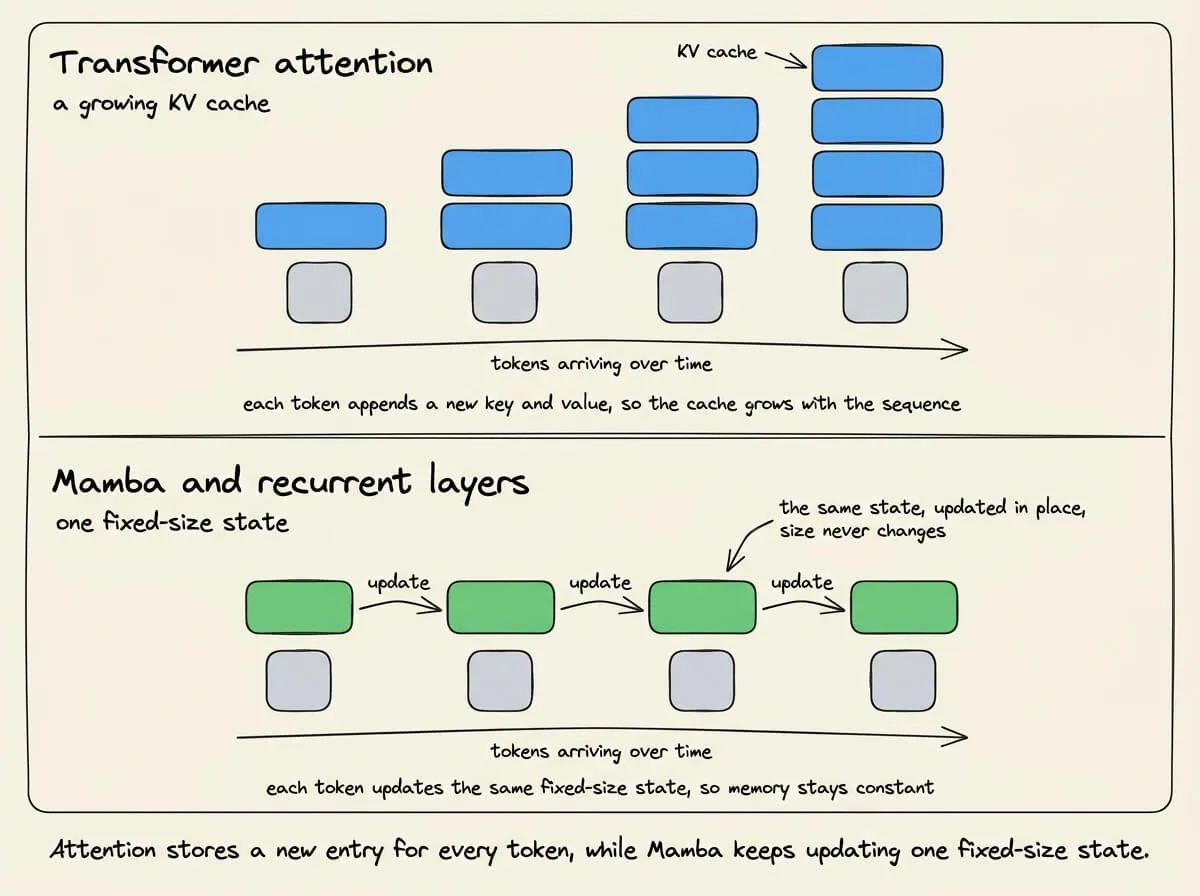
纯循环模型在上下文增长时内存几乎保持恒定,但完整注意力在许多场景下仍然更擅长精确检索。最近的模型将两者结合。
Qwen3-Next 有 48 层,排列为 12 个重复块。每个块包含三个 Gated DeltaNet 层和一个完整注意力层。只有那 12 个完整注意力层会创建标准增长的 KV 缓存。
模型卡报告这些注意力层有 16 个查询头、2 个 KV 头和 256 的头维度。
下一个示例比较它们的内存增长。注意力层为每个 token 存储一个 64 值的键和值。循环层保持一个固定的 64×64 状态。
width = 64
bytes_per_value = 4

attention_values_per_token = 2 * width
recurrent_state_values = width * width

for tokens in [128, 4096]:
    attention_kb = tokens * attention_values_per_token * bytes_per_value // 1024
    recurrent_kb = recurrent_state_values * bytes_per_value // 1024

    print(f"{tokens} tokens")
    print("  attention KV:", attention_kb, "KB")
    print("  recurrent state:", recurrent_kb, "KB")

# Output:
"""
128 tokens
  attention KV: 64 KB
  recurrent state: 16 KB
4096 tokens
  attention KV: 2048 KB
  recurrent state: 16 KB
"""注意力计算将每 token 的存储量乘以序列长度。循环计算完全不涉及 token。其状态在两种情况下的尺寸相同。
该示例仅跟踪内存。它不实现 Mamba 或 Gated DeltaNet。那些架构使用学习到的更新规则来决定固定状态保留什么。
注意力缓存在两个序列长度之间增长 32 倍。循环状态保持 16 KB。混合模型仅在完整注意力层承受线性缓存增长。
对于 Qwen3-Next 的注意力形状,12 个完整注意力层在 128K 上下文时需要 3 GB 的 BF16 KV。
如果全部 48 层都是完整注意力,增长部分将提升到 12 GB。
Jamba 展示了同样的设计选择,只是比例不同。它把一个注意力层与七个 Mamba 层交错排列。在 256K 上下文下,Jamba 论文报告其 KV 缓存为 4 GB,而 Mixtral 为 32 GB。
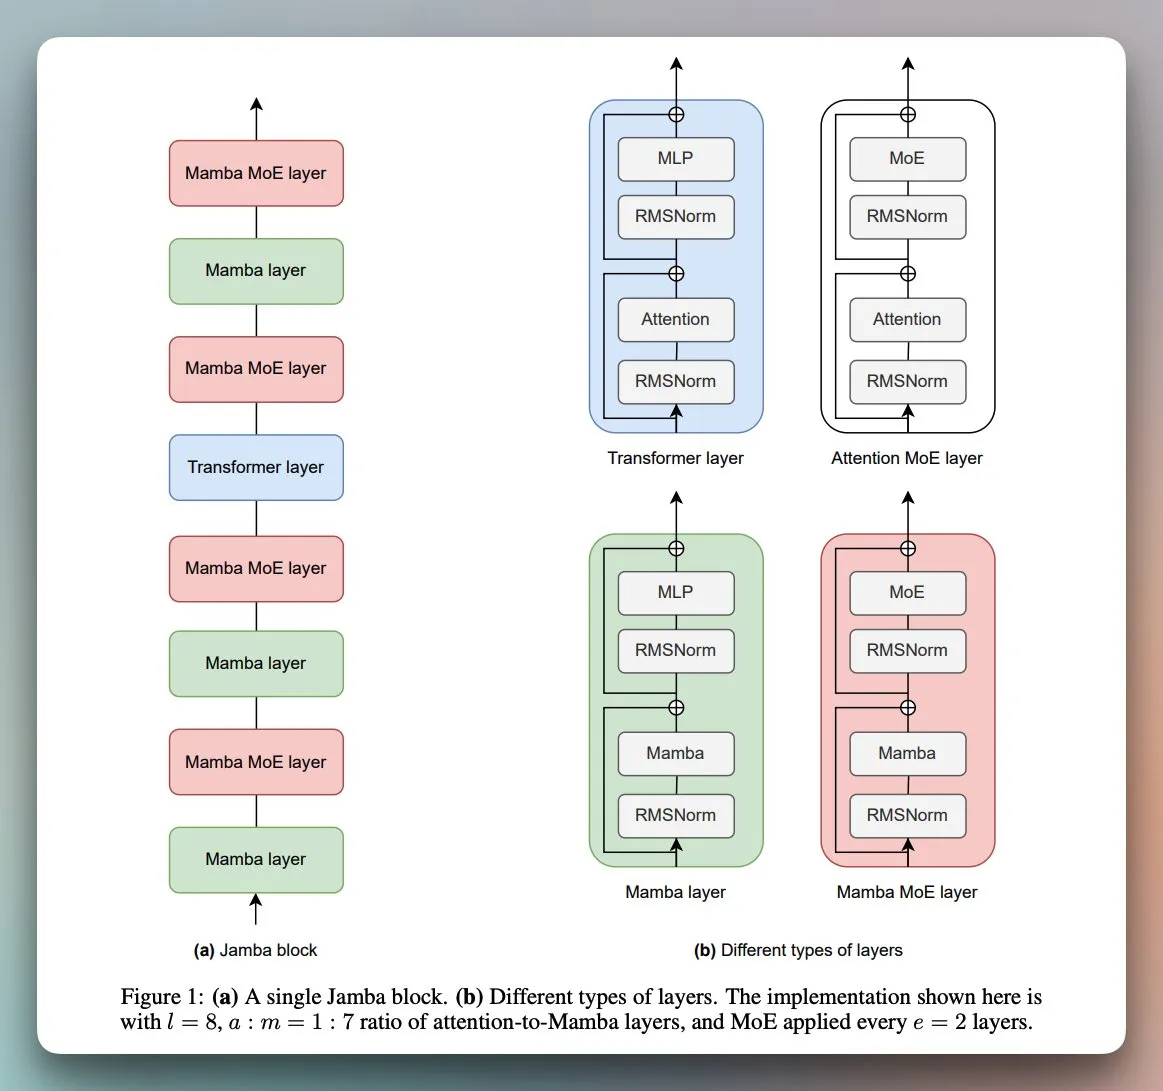
这种布局属于训练好的模型。服务引擎无法在运行时将任意注意力层替换为循环层。
6. Compressed sparse attention(压缩稀疏注意力)
完整注意力做两件开销很大的事。它为每个更早的 token 存储一条单独的 KV 条目,然后在生成下一个 token 时读取所有存储的条目。
稀疏注意力只改变第二部分。
它为每个新 token 读取更少的条目,但仍可能将完整缓存保留在内存中。这可以在不减小驻留 KV 缓存的情况下加快生成速度。
压缩稀疏注意力专注于同时优化这两部分。
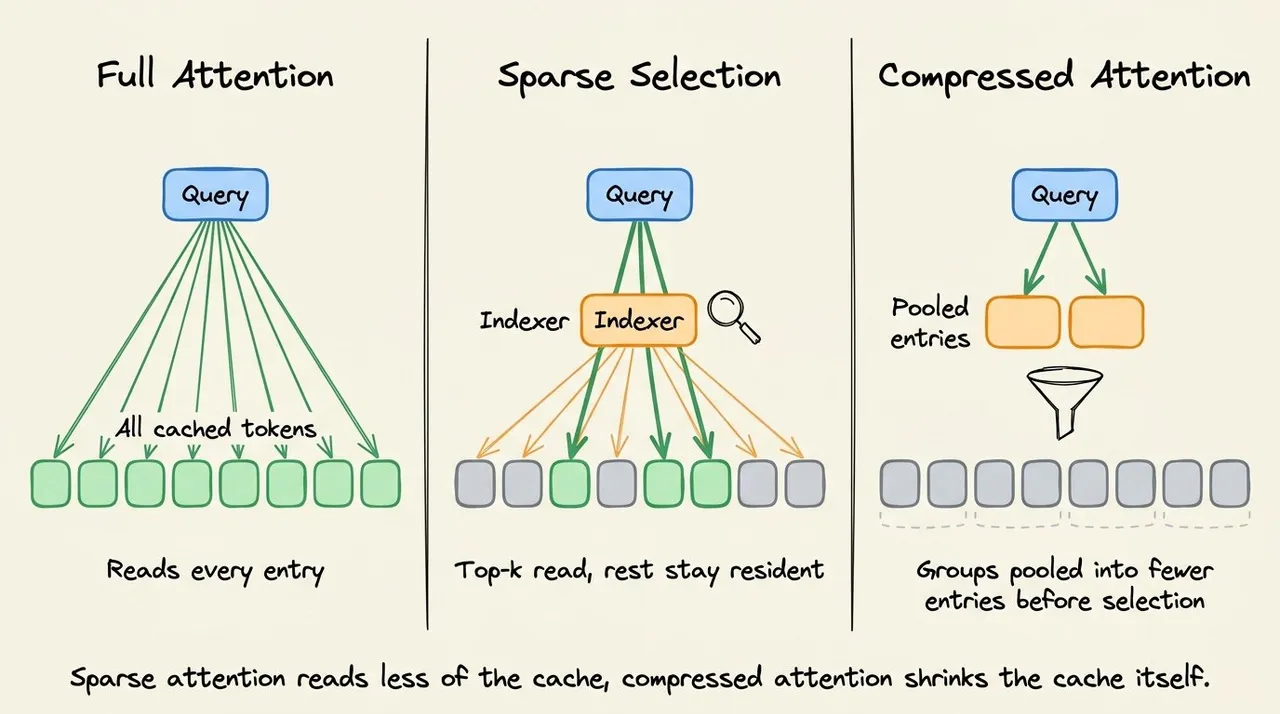
- 首先,它将几个相邻的 token 条目合并为一个压缩条目。它存储这个较短的序列,而不是为每个 token 存储一条长距离条目。
- 然后,对于每个新 token,一个选择器只挑选看起来最相关的压缩条目。注意力读取那个被选中的子集。
DeepSeek V4 采用了这种设计。
如果压缩因子是 m,每 m 个 token 条目变成一个存储条目。因此 n 个 token 的上下文大约产生 n / m 个压缩条目。
然后模型从中选择 k 个条目用于注意力。一个小型滑动窗口为最近的 token 保留更精细的细节。
在一百万 token 下,DeepSeek 报告 V4-Pro 使用 DeepSeek V3.2 所需 KV 缓存的 10% 和单 token 推理 FLOPs 的 27%。V4-Flash 更进一步,缓存为 7%,FLOPs 为 10%。
这些是整体模型的结果。它们包含 V4 的混合注意力布局和精度选择,因此不应被解读为压缩技术单独产生的效果。
下一个模块将两种缩减分开。将 32 个长距离条目按每组四个压缩,留下八个存储条目。如果注意力选择这八个中的两个,它在本步骤只读取两个压缩条目。
full_token_entries = 32
tokens_per_group = 4
selected_entries = 2

compressed_entries = full_token_entries // tokens_per_group

print("full token entries:", full_token_entries)
print("compressed entries stored:", compressed_entries)
print("compressed entries read:", selected_entries)
print("storage reduction:", f"{full_token_entries / compressed_entries:.0f}x")

# Output:
"""
full token entries: 32
compressed entries stored: 8
compressed entries read: 2
storage reduction: 4x
"""将 32 个 token 分成每组四个,产生八个压缩条目。这是存储缩减。选择这八个中的两个是单独的注意力工作缩减。
缓存现在保存八个长距离条目而不是 32 个。注意力读取其中两个。一个小型局部窗口单独保留最近的 token 细节。
这项技术必须内置于模型和训练过程中。服务引擎无法通过更改缓存设置将现有完整注意力模型转换为压缩稀疏注意力。
7. Query-aware sparse reads(查询感知的稀疏读取)
前面的技术同时减少了存储和注意力工作。
有时,改变模型架构不是一个选项。我们可能仍希望减少每个解码步骤读取的缓存量。
回顾模型生成 token 时发生的过程。新 token 产生一个查询,它像一个搜索信号。完整注意力将其与每个存储的键进行比较。因此,长提示词会迫使 GPU 反复加载大量缓存。
Quest 是一种在不删除任何 KV 条目的情况下减少这些读取的技术。
- 它将缓存分成页面。
- 一个页面是一小组相邻的 token 条目。
- 每个页面还存储其中包含的最小和最大键值。
对于每个新查询,Quest 首先对这些简短的页面摘要进行评分。然后它只加载得分最高的页面。完整缓存仍然被保留,因为现在被忽略的页面之后可能变得重要。
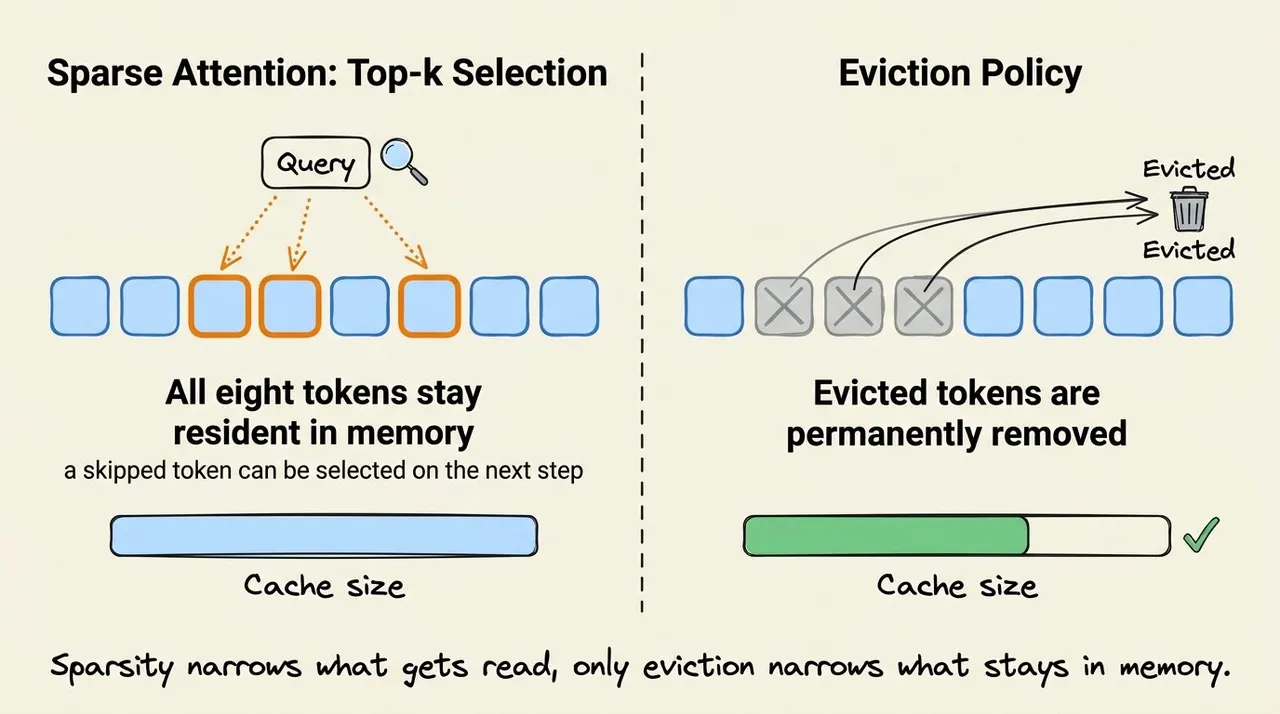
Quest 论文报告其自注意力延迟最多降低 7.03 倍。其完整推理系统实现了最多 2.23 倍的加速。
下面的示例使用四个页面。每个页面包含两个键。这里每个键只有两个数字,这样可以让评分过程清晰可见。
import numpy as np

pages = np.array([
    [[1, 0], [2, 1]],
    [[5, 1], [4, 2]],
    [[0, 6], [1, 5]],
    [[-2, -1], [-1, 0]],
])
query = np.array([1.0, 0.5])

page_min = pages.min(axis=1)
page_max = pages.max(axis=1)
page_scores = np.maximum(query * page_min, query * page_max).sum(axis=1)
selected_pages = np.argsort(page_scores)[-2:]

for page, score in enumerate(page_scores):
    print(f"page {page} score: {score:.1f}")

print("selected pages:", np.sort(selected_pages).tolist())
print("KV entries read:", len(selected_pages) * 2, "of", pages.size // 2)
print("KV entries still stored:", pages.size // 2)

# Output:
"""
page 0 score: 2.5
page 1 score: 6.0
page 2 score: 4.0
page 3 score: -1.0
selected pages: [1, 2]
KV entries read: 4 of 8
KV entries still stored: 8
"""pages 数组总共包含八个键。接下来的两行代码为每个页面创建一个最小摘要和一个最大摘要。Quest 使用类似的摘要来估算页面可能达到的最佳注意力分数。
该查询在两个键维度上都偏好较大的值。页面 1 和页面 2 获得了最高的分数,因此示例读取了它们的四个键。在此步骤中,另外四个键保持不变。
如果你注意最后一行,该步骤读取了四个条目,但所有八个条目都驻留在内存中。Quest 减少了缓存流量和注意力计算量,但并未减少保存完整缓存所需的内存。
在实际应用中,Quest 使用多维键和专门的 GPU 代码。它还会为每个查询重复进行选择。
8. Quantization(量化)
Quest 保留每一个 KV 条目,但跳过部分读取。量化则走了另一条路。它保留所有条目,但用更少的位数来存储每个数字。
键和值通常包含浮点数。BF16 用 16 位存储每个数字。FP8 使用 8 位,因此其原始数据大小约为前者的一半。4 位格式将数据大小缩减至 25%。
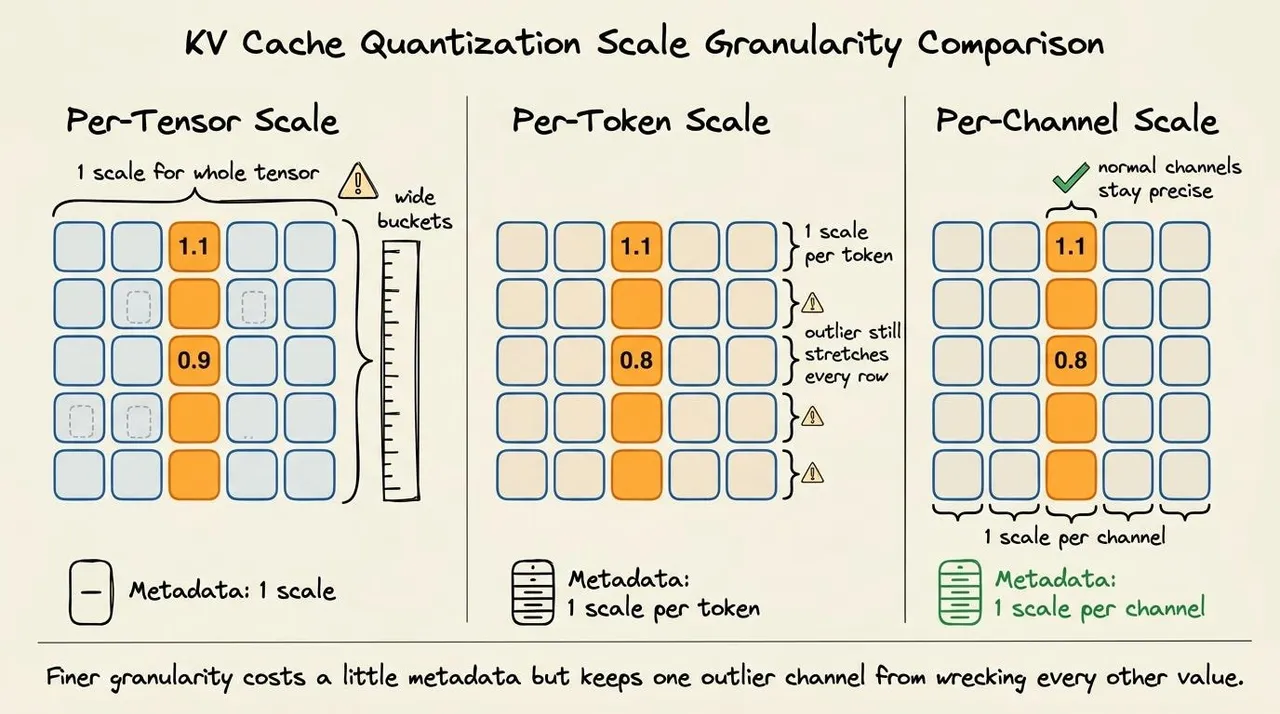
量化将许多原始数字映射到一组较小的允许值上。一个缩放因子控制这些值之间的间隔。引擎存储小的整数编码以及足够的缩放信息,以便稍后解释它。
缩放因子的选择会影响精度。一个极端的值可能会使共享的缩放因子过宽。这样大多数普通值就会被过度取整。
KIVI 对键和值的处理方式不同。它按通道对键值进行分组,这意味着将同一特征跨 token 分组。它按 token 对值缓存中的数字进行分组。KIVI 论文报告其 2 位缓存将峰值内存降低了 2.6 倍,并支持最大 4 倍的批处理规模。
下面的小示例展示了基本的映射过程。它将六个 BF16 风格的值转换为有符号的 4 位编码。然后,它再将这些编码转换回近似值。
import numpy as np

values = np.array([-1.0, -0.55, -0.10, 0.25, 0.60, 1.0])
bits = 4
largest_code = 2 ** (bits - 1) - 1
scale = np.max(np.abs(values)) / largest_code

codes = np.rint(values / scale)
codes = np.clip(codes, -largest_code, largest_code).astype(np.int8)
restored = codes * scale

print("original values:", values.tolist())
print("4-bit codes:", codes.tolist())
print("restored values:", np.round(restored, 3).tolist())
print("raw payload:", len(values) * 16, "bits ->", len(values) * 4, "bits")

# Output:
"""
original values: [-1.0, -0.55, -0.1, 0.25, 0.6, 1.0]
4-bit codes: [-7, -4, -1, 2, 4, 7]
restored values: [-1.0, -0.571, -0.143, 0.286, 0.571, 1.0]
raw payload: 96 bits -> 24 bits
"""在这个示例中,有符号的 4 位存储提供的编码范围是从 -7 到 7。将每个原始值除以缩放因子,即可映射到一个编码。再乘以相同的缩放因子,就得到了在注意力计算中使用的近似值。
你可能已经注意到,还原后的值很接近,但并不完全相同。这种取整差异就是量化误差。最后一行只统计了六个存储的值。真实的缓存还会存储缩放元数据。
该示例对所有六个值使用一个缩放因子。KIVI 使用更小的分组,因为每个分组可以适配自己的数值范围。这通常会减少取整误差,尽管它需要更多的缩放元数据。
如果你使用 vLLM,它可以直接暴露 FP8 缓存存储:
MODEL_ID=Qwen/Qwen2.5-7B-Instruct
vllm serve "$MODEL_ID" --kv-cache-dtype fp8第一行定义了模型名称。第二行启动一个 vLLM 服务器,并要求其以 FP8 格式存储 KV 缓存。此命令会持续运行,因为它启动了推理服务器。
较新的 vLLM 版本还可以让选定的层保持其原生数据类型。当滑动窗口层被证明更敏感时,这很有用:
MODEL_ID=google/gemma-3-4b-it
vllm serve "$MODEL_ID" \
  --kv-cache-dtype fp8 \
--kv-cache-dtype-skip-layers sliding_window这个版本将滑动窗口层保留在其原始格式。它对其余的缓存层进行量化。当那些局部注意力层在 FP8 下损失过多精度时,此选项很有帮助。
量化保留了每一个 token 位置。下一项技术则通过移除位置来减少内存。
9. Eviction(驱逐)
量化保留了所有 token 位置。对于长上下文来说,这可能仍然太大。驱逐策略设定一个固定的位置预算,并丢弃超出该预算的条目。
困难的问题在于哪些位置不应被驱逐。最近的 token 通常很重要,因为它们包含当前的对话。较旧的 token 可能仍然携带着后续需要的指令、事实或工具结果。
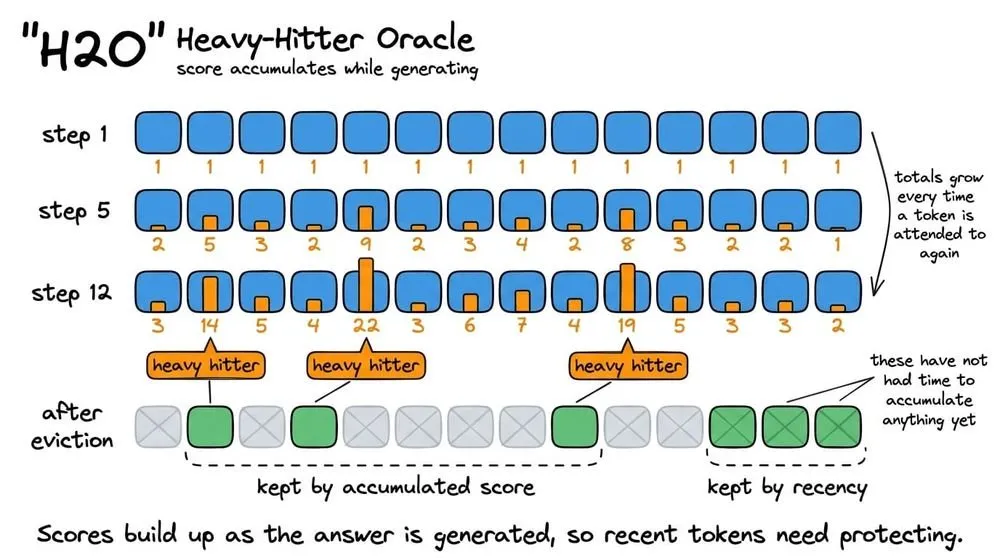
H2O 是一种保留最近位置和较早的重击者(heavy hitter)的技术。重击者是指在早期步骤中积累了高注意力的 token。一旦 H2O 驱逐了另一个 token,其 KV 条目就不再可用。
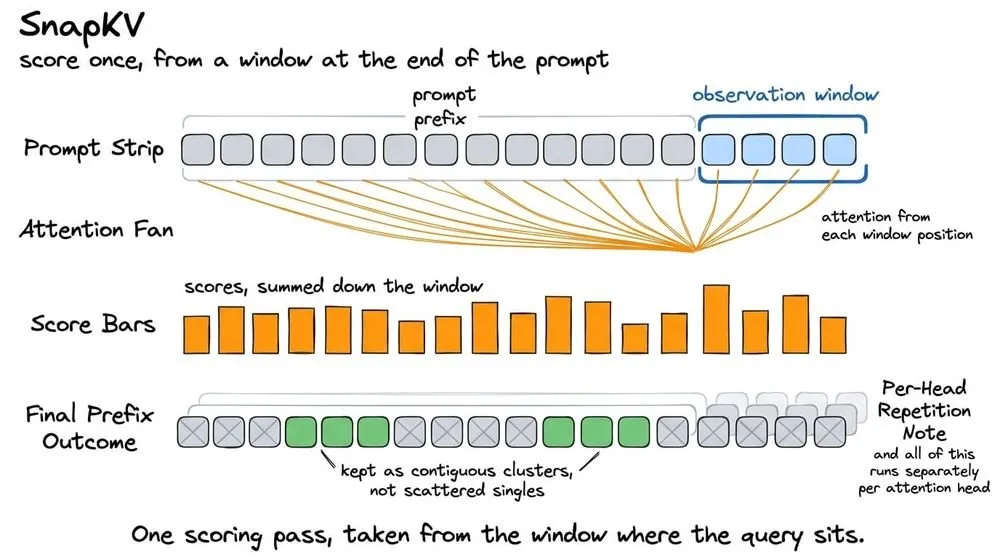
其他方法以不同方式估计重要性。SnapKV 研究输入提示词末尾附近的注意力。它使用该观察窗口在生成之前选择提示词位置。
根据其作者报告的注意力模式,PyramidKV 为较低层分配更大的预算,为较高层分配较小的预算。
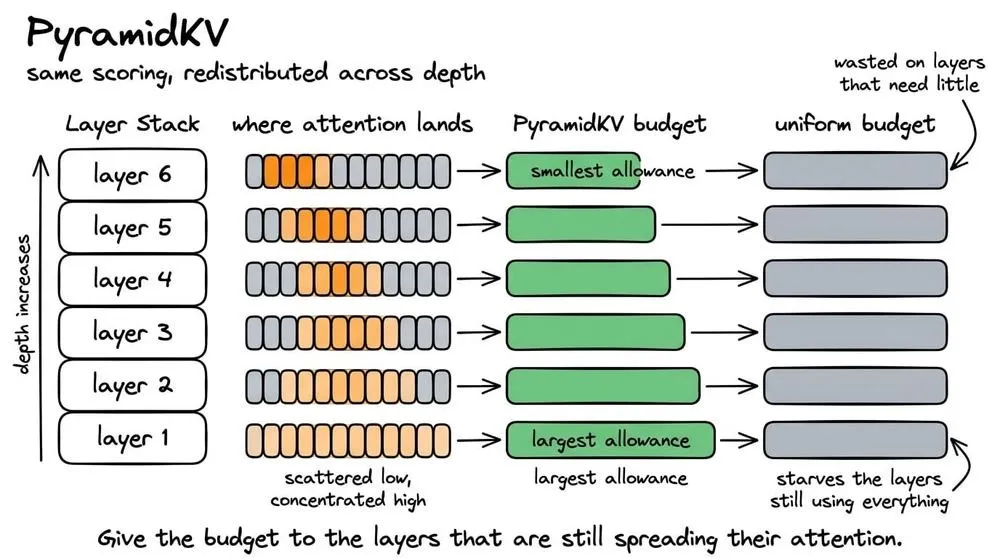
SnapKV 报告在 16K token 输入下内存效率提高 8.2 倍,生成速度提高 3.6 倍。PyramidKV 报告在其 LongBench 实验中,保留 12% 的缓存即可达到与完整缓存相当的性能。
下面的示例在十个 token 之后进行快照。它们的分数代表在早期解码步骤中积累的注意力。缓存只能保留六个位置,包括最新的两个。
scores = [9.0, 0.2, 4.0, 0.1, 0.3, 6.0, 0.2, 0.4, 0.1, 0.2]
budget = 6
recent_count = 2

positions = list(range(len(scores)))
recent = positions[-recent_count:]
older = positions[:-recent_count]

heavy_hitter_count = budget - recent_count
heavy_hitters = sorted(
    older,
    key=lambda position: scores[position],
    reverse=True,
)[:heavy_hitter_count]

retained = sorted(heavy_hitters + recent)

print("heavy hitters:", sorted(heavy_hitters))
print("recent positions:", recent)
print("retained positions:", retained)
print("cache entries:", len(retained), "of", len(scores))

# Output:
"""
heavy hitters: [0, 2, 5, 7]
recent positions: [8, 9]
retained positions: [0, 2, 5, 7, 8, 9]
cache entries: 6 of 10
"""位置 8 和 9 因为是最新的而被保留。还有四个槽位。排序选择了位置 0、2、5 和 7,因为它们在较旧的 token 中拥有最大的分数。
这两组的并集构成了最终的六个位置缓存。位置 1、3、4 和 6 被丢弃。
真实的 H2O 会在生成过程中更新其重击者统计信息。这个较小的示例从已累积的分数开始,以便选择规则保持可见。
话虽如此,驱逐策略需要谨慎评估。重要性会随着对话轮次而变化。一个现在很少受到注意力的工具结果,在多次调用之后可能会变得必要。系统指令和分隔符也可能具有不成比例的重要性。
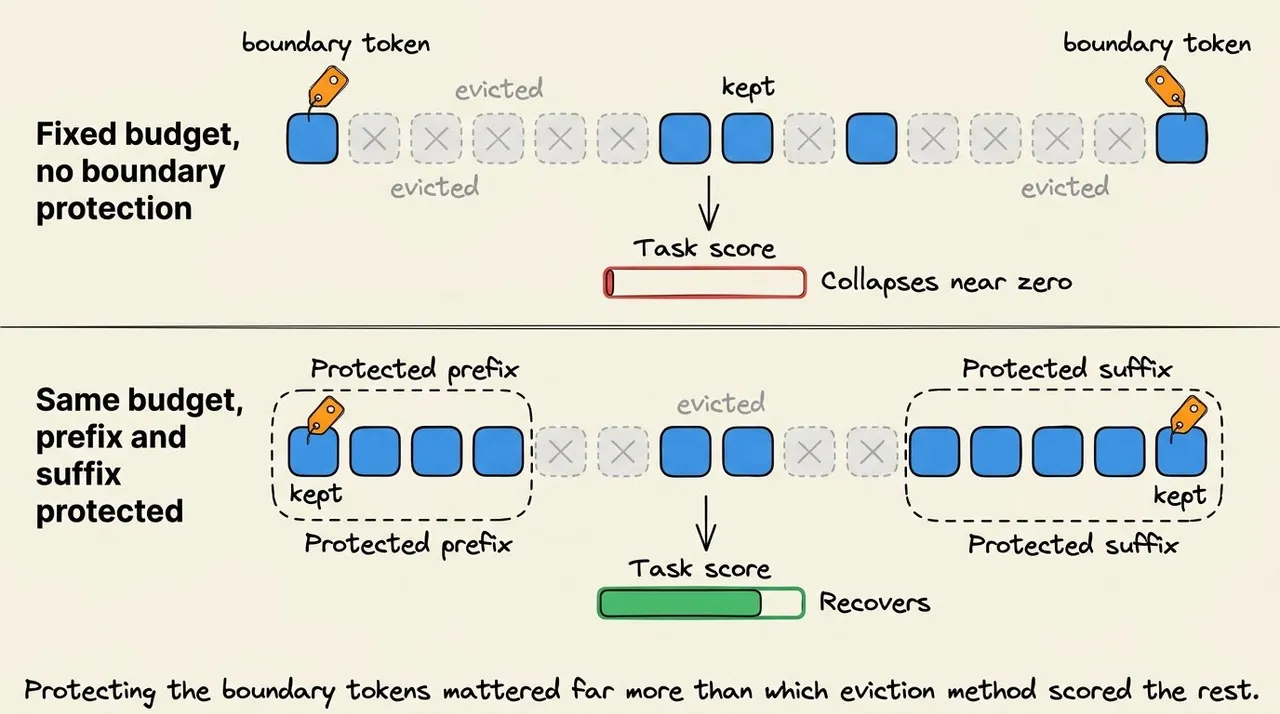
因此,驱逐策略的评估应使用完整的智能体轨迹和延迟引用。它们还应包括结构化的提示词。一个良好的 “大海捞针” 分数并不能涵盖这些情况。
10. Paging(分页)
到目前为止,我们已经探讨了单个请求存储或读取了什么。分页解决的是另一个问题:服务引擎如何在多个请求之间分配缓存内存。
一个简单的分配器可能会为每个请求预留一块连续的内存区域。它通常会为该请求的最大长度预留足够的空间。较短的请求会留下部分区域未使用。随着请求完成,空闲空间也会被分割成碎片。
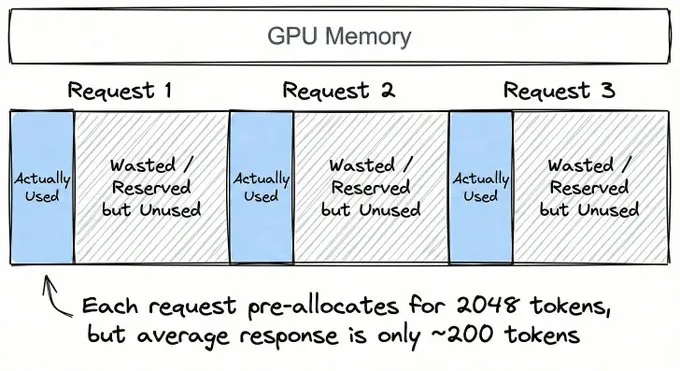
PagedAttention 将 GPU 缓存内存划分为大小相等的块。每个块为固定数量的 token 保存 KV 条目。一个请求可以使用共享池中任何位置的块,因此它的块不需要彼此相邻。
当一个请求完成时,分配器会将其块归还给池。另一个请求可以立即重用它们。PagedAttention 论文报告称,与测试的系统相比,KV 缓存浪费接近为零,吞吐量提高了 2 到 4 倍。
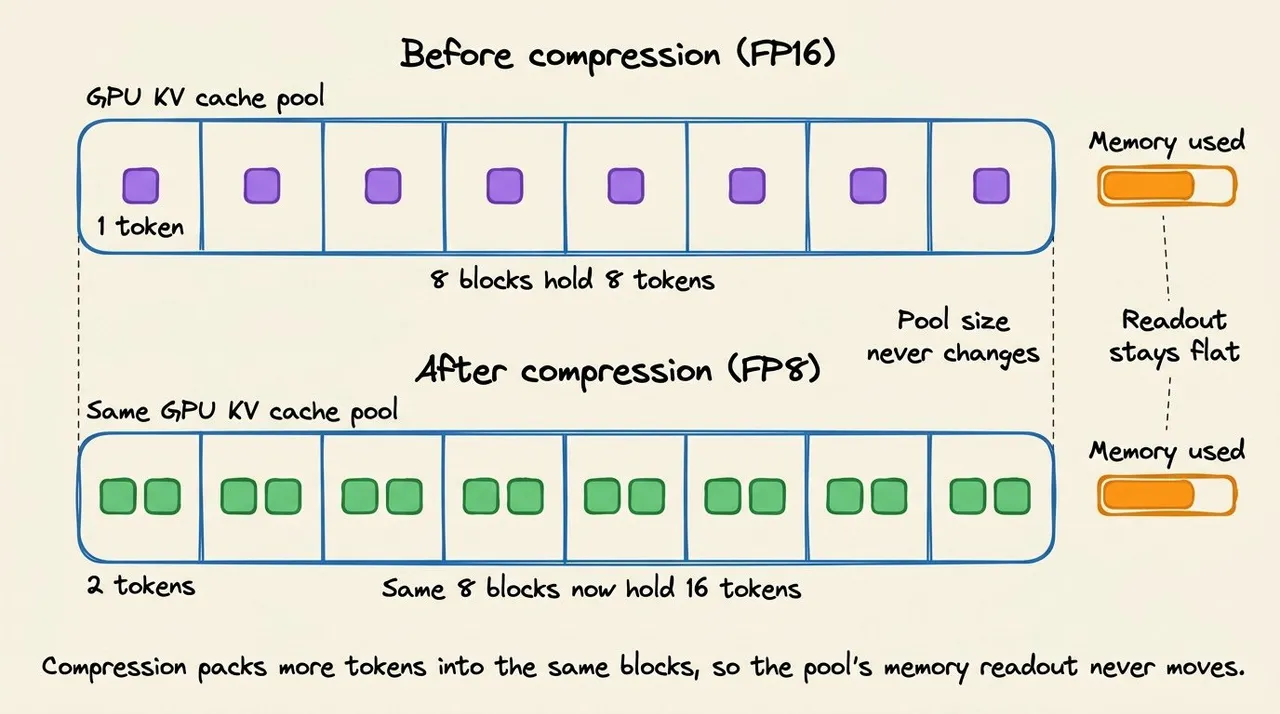
一个固定的池可能会掩盖量化的效果。引擎在启用 FP8 前后可能会预留相同的 8 GB 内存。更小的条目增加了能放入该池中的 token 数量。nvidia-smi 显示的已分配内存可能保持不变。
下面的示例以六个空闲块开始。请求 A 占用三个块,请求 B 占用两个块。随后 A 完成并归还其块,然后请求 C 到达。
free_blocks = [0, 1, 2, 3, 4, 5]

request_a = free_blocks[:3]
free_blocks = free_blocks[3:]

request_b = free_blocks[:2]
free_blocks = free_blocks[2:]

free_blocks.extend(request_a)
free_after_a = free_blocks.copy()
request_c = free_blocks[:2]
free_blocks = free_blocks[2:]

print("request A blocks:", request_a)
print("request B blocks:", request_b)
print("free after A finishes:", free_after_a)
print("request C blocks:", request_c)

# Output:
"""
request A blocks: [0, 1, 2]
request B blocks: [3, 4]
free after A finishes: [5, 0, 1, 2]
request C blocks: [5, 0]
"""A 完成后,空闲池包含块 5 和 A 归还的块。请求 C 占用块 5 和块 0。这些块编号不相邻,但块表记录了它们在 C 中的顺序。
这是分页的核心思想。分配器重用可用块,而不是寻找一个大的连续区域。
vLLM 还跟踪每个请求拥有哪些块。其注意力代码可以按逻辑顺序读取不相邻的块。这个简短示例隔离了分配和重用。
量化仍会改变该池内的容量。一个 8 GB 的池子在每 token 320 KB 时可容纳 26,214 个 token,相比之下,每 token 160 KB 时可容纳 52,428 个 token。在这两种情况下,分配的 GPU 总内存都保持为 8 GB。
11. Prefix Reuse(前缀重用)
分页在请求完成后重用块。前缀缓存可以在多个请求仍然活跃时共享块。它适用于这些请求以完全相同的 token 开头的情况。
这在系统提示词和工具定义中经常发生。如果没有前缀缓存,引擎会为每个请求计算并存储另一个 KV 副本。重复的前缀消耗内存,并重复产生它的预填充工作。
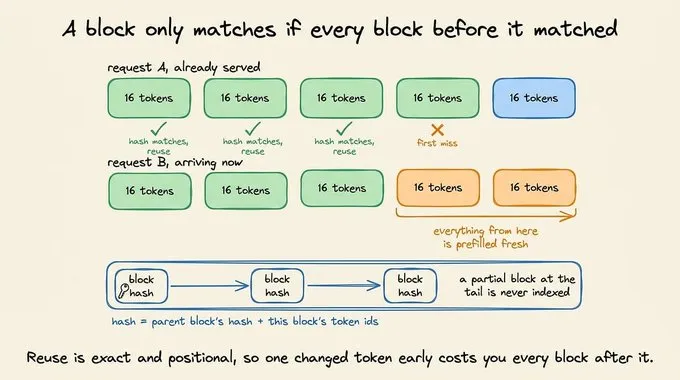
自动前缀缓存将每个已完成的前缀块存储在查找键下。当另一个请求具有相同的 token 前缀时,它指向现有的 KV 块。新的计算仅在请求出现分歧后开始。
vLLM 根据当前块及其前面的块构建每个查找键。当适配器标识等细节影响兼容性时,也会包含在内。vLLM 的前缀缓存设计文档记录了这一结构。
下面的示例使用四个 token 的块。每个查找键包含到该块为止的整个前缀。这是 vLLM 链式哈希的一个可读替代。
def prefix_keys(tokens, block_size):
    block_ends = range(block_size, len(tokens) + 1, block_size)
    return [tuple(tokens[:end]) for end in block_ends]

first = [10, 11, 12, 13, 20, 21, 22, 23, 30, 31, 32, 33]
second = [10, 11, 12, 13, 20, 21, 22, 23, 40, 41, 42, 43]

cache = set()
first_keys = prefix_keys(first, block_size=4)
first_hits = sum(key in cache for key in first_keys)
cache.update(first_keys)

second_keys = prefix_keys(second, block_size=4)
second_hits = sum(key in cache for key in second_keys)

print("first request reused:", first_hits, "of", len(first_keys), "blocks")
print("second request reused:", second_hits, "of", len(second_keys), "blocks")
print("second request computes:", len(second_keys) - second_hits, "new block")

# Output:
"""
first request reused: 0 of 3 blocks
second request reused: 2 of 3 blocks
second request computes: 1 new block
"""第一个请求没有可重用的缓存条目。它为前四个、八个和十二个 token 添加键。第二个请求具有相同的前八个 token,因此它的前两个键匹配。
最后四个 token 不同。这改变了最后一个前缀键,因此第二个请求计算一个新的块。
使用完整前缀可以防止错误匹配。两个请求不能仅仅因为四个 token 在中间某处匹配就重用同一个块。它们前面的上下文也必须匹配。
前缀重用取决于精确的 token 化前缀。系统提示词中的时间戳、工具模式中重新排序的 JSON 键或不同的聊天模板空白都可能破坏匹配。
因此,稳定的提示词模板可以提高命中率。模型和缓存格式可以保持不变,同时重复存储减少。
12. Cache Offloading from GPU(从 GPU 卸载缓存)
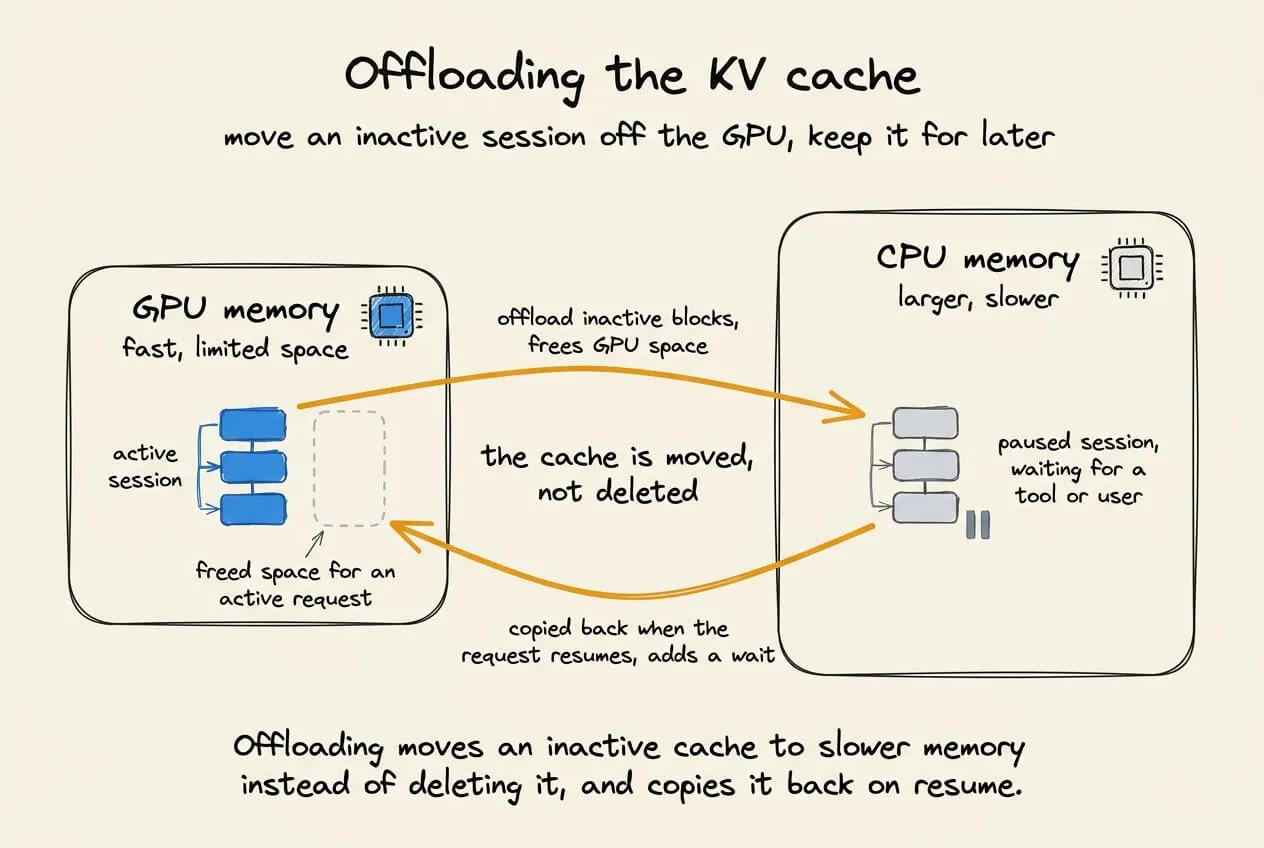
前缀重用有助于当另一个请求以引擎已处理的 token 开头时。卸载处理不同的问题。它将当前不需要的 KV 块从 GPU 内存移动到更大但较慢的内存层,通常是 CPU 内存。
这些块可能属于调度器暂停的序列,或保留用于重用的缓存前缀。当引擎再次需要它们时,它会将它们复制回 GPU。
有一个重要的限制。新的 OpenAI 兼容 API 请求不会自动从早期请求恢复 KV 缓存。只有当引擎仍然跟踪序列、识别精确的前缀缓存匹配或通过外部存储系统恢复缓存时,才会发生重用。
卸载释放 GPU 内存而不删除存储的 KV 数据。它不会减少跨 GPU 和 CPU 内存持有的总字节数。当引擎必须在计算继续之前将这些块传输回来时,这种权衡就会出现。
下面的示例为 GPU 提供了两个会话的空间。添加会话 C 将最旧的会话 A 移动到 CPU 内存。恢复 A 将其带回并将 B 移出。
gpu_cache = ["cache-a", "cache-b"]
cpu_cache = []

# Cache C needs GPU space, so cache A moves to CPU memory.
cpu_cache.append(gpu_cache.pop(0))
gpu_cache.append("cache-c")

print("GPU after cache C arrives:", gpu_cache)
print("CPU after cache C arrives:", cpu_cache)

# Cache A is needed again, so it returns to the GPU.
cpu_cache.remove("cache-a")
cpu_cache.append(gpu_cache.pop(0))
gpu_cache.append("cache-a")

print("GPU after cache A returns:", gpu_cache)
print("CPU after cache A returns:", cpu_cache)

# Output:
"""
GPU after cache C arrives: ['cache-b', 'cache-c']
CPU after cache C arrives: ['cache-a']
GPU after cache A returns: ['cache-c', 'cache-a']
CPU after cache A returns: ['cache-b']
"""第一次移动将缓存 B 和 C 保留在 GPU 上,而缓存 A 在 CPU 内存中仍然可用。当再次需要缓存 A 时,示例将其带回并将缓存 B 移出。
列表包含缓存名称而不是张量。真正的引擎对 KV 块执行此操作,并跟踪每个块属于哪个请求或可重用前缀。
示例假设引擎已保留足够的信息以便稍后识别缓存 A。发送带有相同标签的不相关 API 请求不会自动恢复它。
vLLM 可以直接启用 16 GB 的 CPU 卸载缓冲区:
MODEL_ID=Qwen/Qwen2.5-7B-Instruct

vllm serve "$MODEL_ID" \
  --kv-offloading-size 16 \
--kv-offloading-backend native第一个选项设置 CPU 缓冲区大小(以 GB 为单位)。第二个选项选择 vLLM 的原生 CPU 后端。像前面的服务命令一样,此进程在启动后保持运行。
卸载以 GPU 容量换取传输时间。在启用大型卸载层之前,请测量恢复延迟和 CPU 带宽。
How to use them together(如何将它们结合使用)
其中一些方法可以组合,因为它们减少不同的项。架构级方法仍然取决于检查点的训练方式。
例如,以第一个示例中的 40 GB GQA 缓存为例。
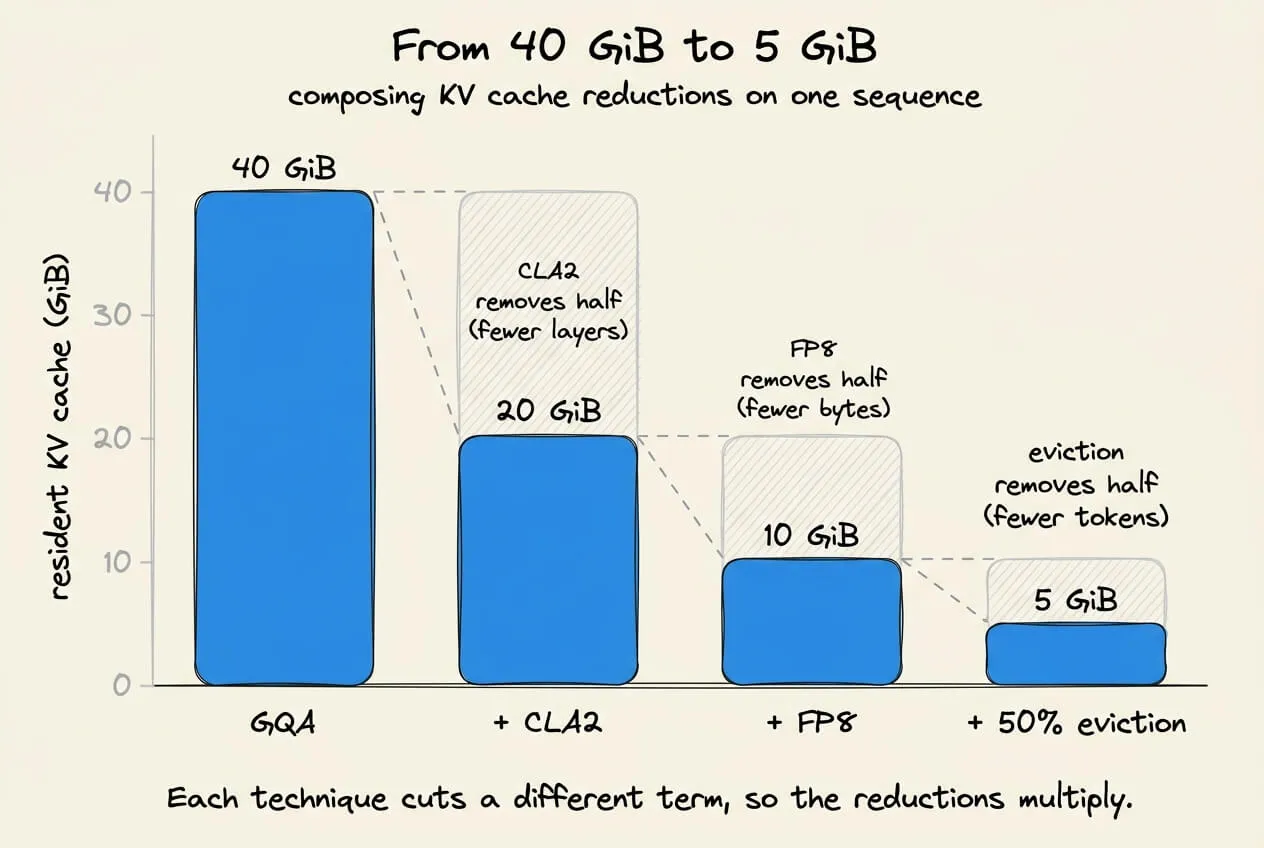
- CLA2 可以将唯一层数减半,产生 20 GB。
- FP8 可以将每个值的字节数减半,产生大约 10 GB。
- 50% 的 token 预算可以将常驻缓存减少到大约 5 GB。
这种乘法对于容量规划很有用,但它掩盖了模型质量和内核支持。
- CLA 需要训练。
- FP8 引入量化误差。
- 驱逐会丢弃上下文。
- 并且服务引擎还必须支持生成的布局。
以下是一些你可能遇到的情况以及解决方案:
- 选择模型时 → 检查 KV 头数量、局部与全局层比例、潜在注意力维度和循环层。这些决定了部署前的起始缓存。
- 服务现有模型时 → 先测试 FP8,然后标准化前缀。两者都能保持 token 集合不变。仅在经过特定工作负载质量测试后添加驱逐策略。
- 当内存看似未变时 → 检查缓存容量和块数。固定池可能吸收节省的内存,而分配的 GPU 内存总量保持不变。
- 当延迟成为问题时 → 测量缓存读取和注意力时间。Quest 风格的稀疏读取即使不释放容量也可能有帮助。
- 当非活跃会话占用 GPU 时 → 测试卸载和调度。移动冷块可能比进一步压缩活跃块更重要。
每种技术有了明确目标后,KV 缓存缩减就更容易理解了。
此表总结了所有我们涵盖的技术、它们改变了什么、从中得出的要点以及它们未处理的部分:
从您需要更改的约束开始,然后选择处理该约束的技术。
👉 轮到您了:在生产环境中,您如何减少 KV 缓存?
