
最近,Jev 因一种不同于聊天模型的工作方式受到不少关注:开发者提前定义输出范围,模型接收输入后,直接返回结构化判断和对应概率。比如面对一封客服邮件,它可以在“账单、技术问题、退款、其他”几个类别中直接做出选择。
TypeSafe 将这类模型称为 System One Models,主要面向分类、路由、打分、提取和分支决策等任务。官方还提到,Jev 支持并行输出,并通过 RLCD 学习校准后的概率。
Jev 的完整技术细节目前还没有公开。不过,两个月前,卡内基梅隆大学的一篇论文恰好研究了一个相近的问题:如果答案已经限定在几个候选项里,语言模型还需要把答案逐 Token 生成出来吗?
论文「Punching Above Their Weight: Classification-Head Fine-Tuning of Tiny Language Models for Verifiable Multiple-Choice Tasks」研究了 30 亿参数以下的小语言模型。保留 Transformer 主干,只把原本的下一 Token 预测改成分类打分,看看这种更直接的输出方式会带来什么变化。
选择题背后的两件事
先看我们现在怎么让语言模型回答选择题。假设模型看到这样一道题:
一个人在屋顶拆瓦片。

A. 他开始给滑雪板缠包装
B. 他拆下一些瓦片
C. 他拿着魔方
D. 他开始掀开屋顶材料

请选择 A、B、C、D。在常见的监督微调中,模型会根据带有正确答案的训练数据继续学习。对于选择题,我们通常把完整问题和候选项交给模型,再训练它生成正确答案对应的字母:D。
这看起来很顺理成章。但从计算任务本身看,其实当中多了一层转换。
首先,模型需要理解:第四个候选项最符合上下文。随后,再继续完成:第四个候选项 → 字母 D → 对应 Token → 生成这个 Token。这样,一个“从几个答案里选一个”的问题,被转换成了一次语言生成任务。
论文把这种方法称为 Label-Gen SFT。模型看到所有候选项,最后通过语言模型原有的输出头预测正确答案对应的字母 Token。训练时,损失主要落在这个答案 Token 上。
对于足够大的模型,这层转换并不麻烦。但模型缩小到 0.6B、1.7B 后,它就开始成为一笔额外的能力开销。
把“生成答案”改成“给答案打分”
论文采用的方法很简单:不再让模型生成 A、B、C、D,而是把问题分别与每个候选答案组合成独立输入,再交给模型逐一判断。
还是刚才那道题,模型会分别看到:
问题 + 候选答案 A
问题 + 候选答案 B
问题 + 候选答案 C
问题 + 候选答案 D随后,每一条候选序列都会经过同一个语言模型。模型读完“问题 + 候选答案”后,会取最后一个位置的内部表示,再通过一个简单的分类头,为这个候选答案打分。
A → 1.2
B → 2.7
C → 0.4
D → 5.6最后选择得分最高的 D。论文把这种方式称为 Classification-head SFT,也就是分类头监督微调。
对于 Qwen3-0.6B,它最后的隐藏维度是 1,024,因此这个分类头本身只有 1,024 个可训练参数。模型主体仍然保留原来的预训练能力,同时通过 LoRA 完成任务微调。
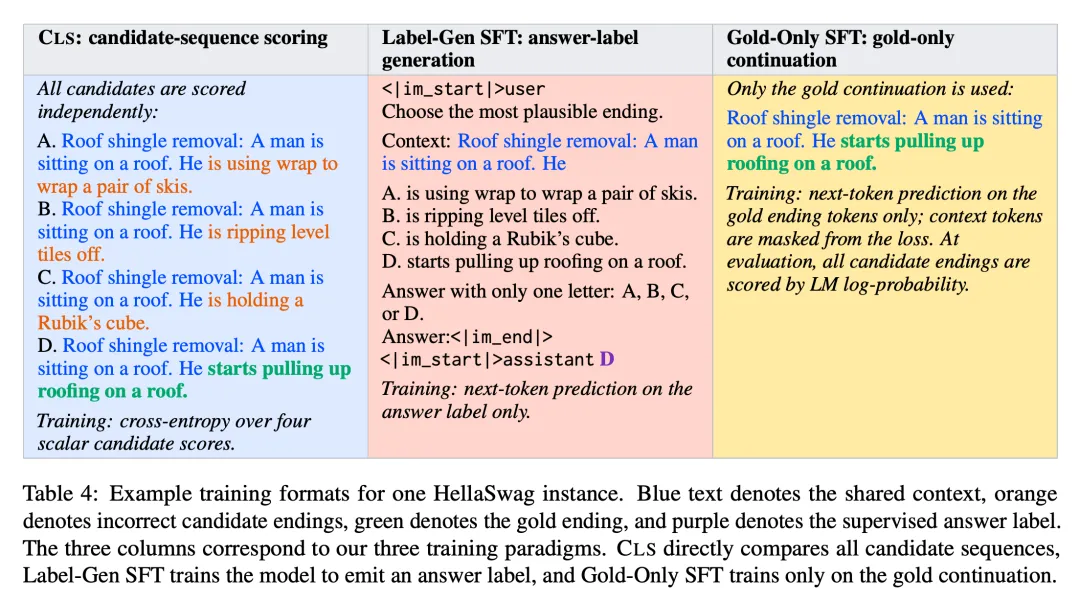
图注:三种训练方式对比
上图将三种路线放在了同一个例子里:
- 左边:所有候选项分别打分;
- 中间:让模型生成 A/B/C/D;
- 右边:只拿正确答案继续做下一 Token 预测。
分类头改变了模型的训练目标
看起来,分类头只是把“生成字母 D”换成了“给 D 一个更高的分数”,但两种方式背后的训练目标并不一样。
在 Label-Gen SFT 中,模型虽然能看到四个候选答案,训练时的监督信号主要集中在正确答案对应的 Token 上。比如正确答案是 D,模型的目标就是学会生成 D。至于 D 为什么比 A、B、C 更合适,需要模型自己从训练过程中逐渐学出来。
分类头的训练方式会同时比较四个候选项的得分:正确答案的分数被拉高,错误答案的分数被压低。这样,每道题都会直接告诉模型“哪个候选项更合适”,模型学到的是候选项之间的相对差异。
这对小模型尤其有帮助。Label-Gen SFT 还需要模型把判断结果进一步映射成 A、B、C、D 这样的答案 Token;分类头则省掉了这一步,让有限的模型能力更多用于比较候选内容本身。论文中的结果也符合这个解释:在 0.6B 和 1.7B 模型上,分类头带来的提升最明显;到了 4B 和 8B,两种训练方式的差距明显缩小。
如果放到实际程序里,这种区别会更容易理解。假设程序最终只需要根据模型结果判断用户意图是否为 refund,模型真正需要完成的任务,就是在几个候选类别中让 refund 得到最高分。
如果先让模型生成 "refund" 这个字符串,再由程序把它解析成对应的类别,整个过程中还多了一层从语言生成到程序状态的转换。
小模型上的性能差距
为了验证这个想法,作者选择了 Qwen3 系列的四个模型:0.6B、1.7B、4B 和 8B。其中 0.6B 和 1.7B 被论文划进 TLM(Tiny Language Model);4B 和 8B 用来观察模型规模继续提高后会发生什么。
测试覆盖五个数据集,其中 HellaSwag、WinoGrande、PIQA 主要测试常识判断,SciQ 和 ARC-Challenge 更依赖科学知识。所有方法都使用 LoRA,在统一配置下训练。
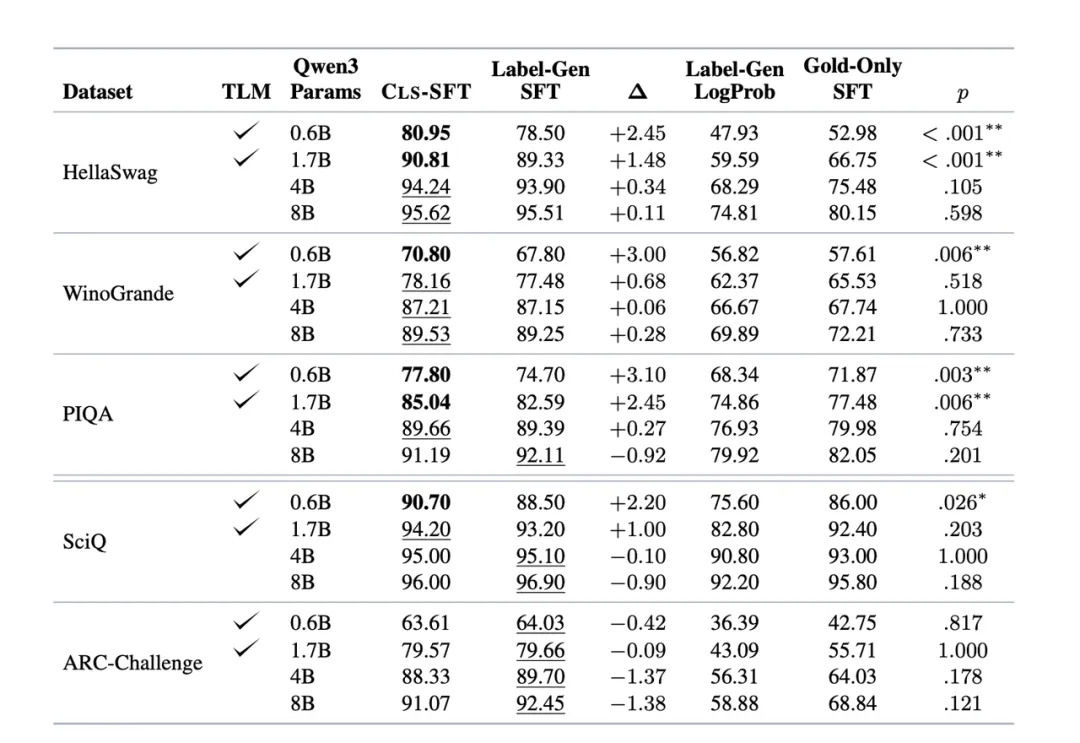
图注:不同模型规模和训练方式的完整结果
从结果来看,分类头带来的收益主要集中在较小的模型上。
以 0.6B 为例,HellaSwag 的准确率从 78.50% 提高到 80.95%,WinoGrande 从 67.80% 提高到 70.80%,PIQA 从 74.70% 提高到 77.80%,SciQ 从 88.50% 提高到 90.70%。四个数据集的提升都在 2~3 个百分点左右,而且差异具有统计显著性。
对于一个只有 0.6B 参数的模型来说,作者没有增加模型规模,也没有换更多训练数据,只是改变了模型“怎么回答问题”,就获得了比较稳定的提升。换句话说,小模型原本的一部分能力,可能就消耗在了“把判断结果转换成答案 Token”这个过程里。
到了 1.7B,这种优势仍然存在,但已经开始缩小。HellaSwag 提升 1.48 个百分点,PIQA 提升 2.45 个百分点,WinoGrande 和 SciQ 的差距则分别缩小到 0.68 和 1.00 个百分点。其中只有 HellaSwag 和 PIQA 的差异仍具有统计显著性。继续放大到 4B 和 8B 后,两种训练方式基本拉平。HellaSwag 和 WinoGrande 上只剩零点几个百分点的差距,PIQA、SciQ 和 ARC-Challenge 中,Label-Gen 甚至开始略高一些,而且这些差异都没有统计显著性。
这也和作者前面的解释对应上了:模型越小,省掉“候选答案 → 字母 → Token”这层转换越有帮助;模型规模扩大以后,这点额外负担逐渐变得不重要。
ARC-Challenge 还提供了另一个观察角度。即使在 0.6B 上,分类头也没有带来提升,准确率反而从 64.03% 降到 63.61%。到了 4B 和 8B,Label-Gen 同样略高。
这说明分类头解决的主要还是模型如何表达判断结果。如果一道题真正卡在知识、理解或者推理能力上,换一个输出接口并不会凭空补上这些能力。
微调目标与预测接口的耦合
论文还做了一个很值得注意的实验:训练完成后,故意换一种和训练目标不匹配的方式读取答案。
以使用分类头训练的 Qwen3-1.7B 为例,它在 HellaSwag 上通过分类头预测时,准确率为 90.81%;如果改用语言模型输出头,根据候选文本的概率来判断答案,准确率会降到 59.15%。在 PIQA 上也有类似现象,准确率从 85.04% 降到 70.24%。
反过来同样如此。使用 Label-Gen 训练的模型,原本学的是生成正确答案对应的字母;如果再改成根据候选序列概率打分,HellaSwag-4B 的准确率会从 93.90% 降到 68.29%。
模型主体和任务数据都没有变化,变化的只有训练目标和答案读取方式。论文据此指出,两者之间存在明显耦合:模型在训练阶段以什么方式学习回答,评测时就应该用对应的方式读取结果。对于小模型来说,这种不匹配带来的影响尤其明显,准确率甚至可能下降几十个百分点。
小模型与历史大模型的对比
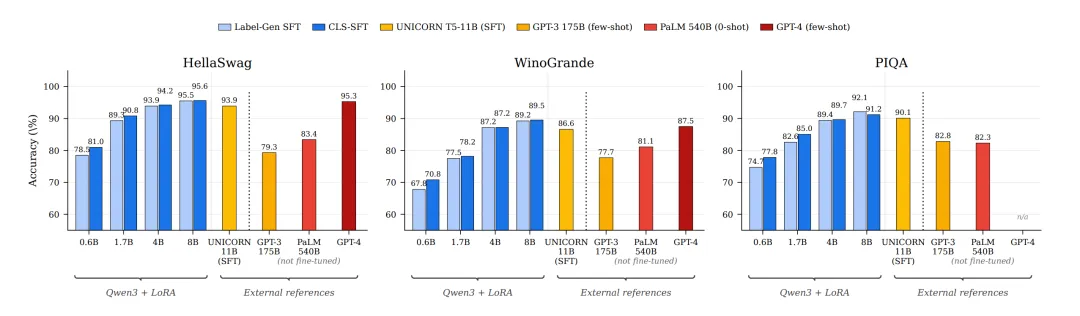
图注:Qwen3 小模型与外部模型结果对比
论文还把 Qwen3 小模型与一些历史模型放在了一起。经过分类头微调后,Qwen3-1.7B 在 HellaSwag 和 PIQA 上的结果高于论文引用的 GPT-3 175B 和 PaLM 540B,在 WinoGrande 上也高于 GPT-3。
不过,这组结果不能直接用于比较模型的通用能力。Qwen3 接受了针对具体数据集的 LoRA 微调,而 GPT-3、PaLM 和 GPT-4 在图中主要采用零样本或少样本结果。它更多说明的是:在输出范围明确的任务中,小模型经过针对性训练,也能取得很高的准确率。
从生成接口到决策接口
这篇论文研究的范围并不大:实验只覆盖 Qwen3 一个模型家族,任务也集中在英文的有限候选场景,没有涉及开放式生成、推理链和多语言任务。作者也提到,Prompt 格式、分类头结构以及更大的模型规模,都可能影响最终结果。
不过,它讨论的问题恰好和 Jev 最近受到关注的方向接上了。Jev 官方给出的分类、路由、打分、判断和提取等场景,都有一个共同特点:输出范围可以提前定义。TypeSafe 因此让模型直接返回预定义的结构化结果,并称这些输出可以通过 Parallel Sampler 并行产生。
论文还没有走到 Jev 这一步。它依然使用 Qwen3 这样的自回归 Transformer,也没有 Jev 所说的新模型架构和并行采样器;论文中的分类分数也不能直接等同于 Jev 强调的校准概率。
但两者指向了一个相近的问题:当程序真正需要的只是一个类别、一个分数或者一个明确的分支,模型是否还需要先把判断结果生成成文本?
对于写文章、写代码和开放式推理,逐 Token 生成依然自然;对于分类、路由、过滤、验证和固定候选决策,模型也可以直接输出程序需要的结果。这篇论文用一组相对简单的实验说明,当输出范围已经确定时,改变模型表达判断结果的方式,也可能明显影响小模型的表现。
从这个角度看,Jev 带来的讨论也就不只是在于一种新的模型,而在于一个新的接口问题:软件究竟需要模型生成什么,又应该怎样把模型的判断接进程序。
相关推荐
论文解读:DeepSeek DSpark 在真实高并发推理服务中,如何保证 Token 生成又好又快?
#Jev #小语言模型 #模型微调 #分类任务 #模型接口 #LLM
