
Stripe 的编码智能体每周合并超过 1000 个拉取请求。
在 Uber,超过 70% 的拉取请求现在来自智能体。
Spotify 已合并超过 250 万个自动化维护的 PR。
这些公司没有一家使用单一 AI 智能体。每家都使用一组智能体,每个智能体根据任务不同而设计不同:需要一种模型来审查代码,另一种来调查系统故障,还有第三种来回答关于数据的问题。
好消息是他们在写关于这些的内容。Stripe、Uber、DoorDash、Shopify、Meta、Microsoft、Cloudflare 等公司的工程团队已经发布了关于他们的智能体如何运作的信息,包括架构和实际指标。
我浏览了 70 多篇这样的帖子,将它们归类为 10 种设置。
我为每一种准备了:
- 智能体做什么
- 它如何构建
- 公司的示例
- 如果你想拥有自己的,从哪里开始
最后还有一个现成智能体设置的仓库列表,你可以直接安装。
每个智能体是如何构建的(How every agent is built)
如果抛开品牌特定功能不谈,本文提到的所有智能体本质上拥有相同的核心。
OpenAI 的指南将其分为三个部分:
- 模型:负责推理和决策的 LLM
- 工具:它可以调用的函数和 API
- 指令:它如何行为的规则
Anthropic 的定义更简短:智能体 “通常只是 LLM 在循环中基于环境反馈使用工具。”
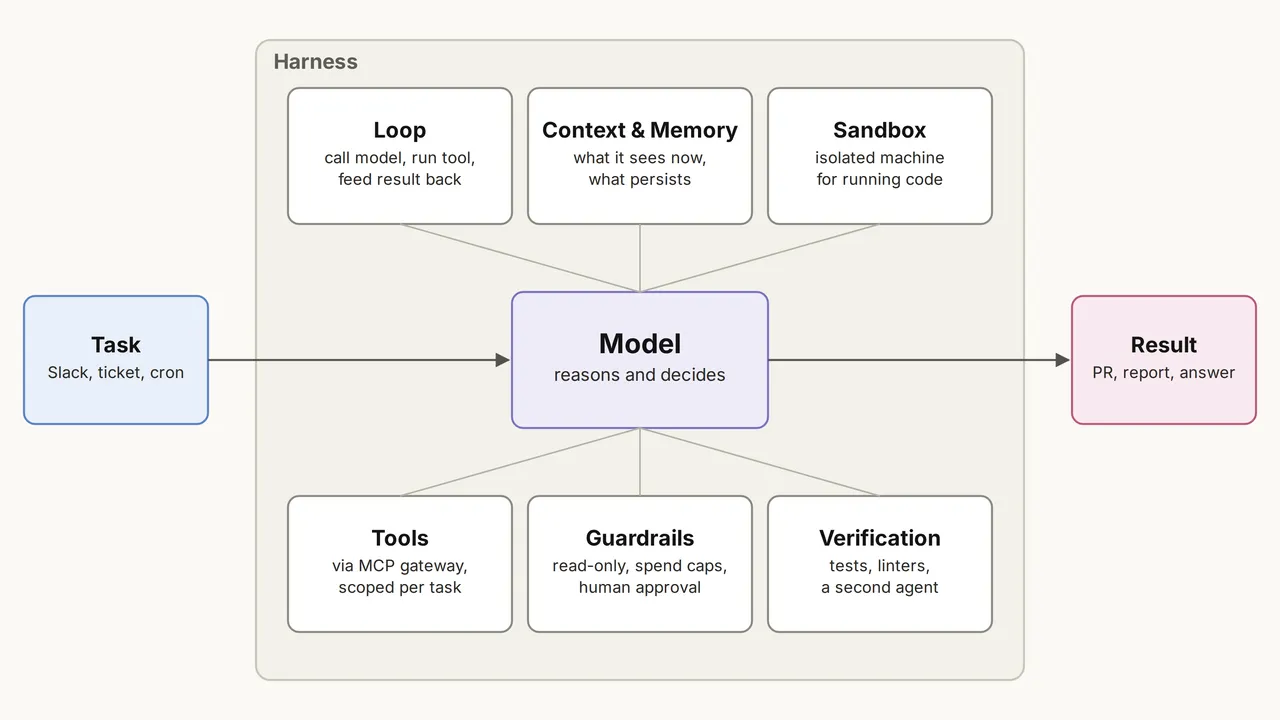
模型是最小的部分。公司实际上花费数月时间的是围绕它的所有东西,即框架(harness):
- 循环:调用模型,运行请求的工具,返回结果,重复
- 上下文和记忆:智能体在本轮中看到什么,以及将保留到下一会话的内容
- 沙盒:一个隔离的机器,可以在其中运行代码而不触碰任何真实系统
- 工具访问:通常通过 MCP 网关实现,该网关确定哪些工具将用于执行每个任务
- 护栏:默认只读、支出上限、对风险操作的人工审批
- 验证:测试、linter 或第二个智能体在交付前检查工作
工作流或智能体(Workflow or agent)
这些系统分为两类:
- 工作流:模型和工具通过预定义的代码路径运行
- 智能体:模型自行决定步骤和工具调用
实际上,大多数生产设置混合了两者。Stripe 称其为 “蓝图”:固定步骤如 lint 和推送,中间穿插需要判断力的智能体循环。
五种模式(The five patterns)
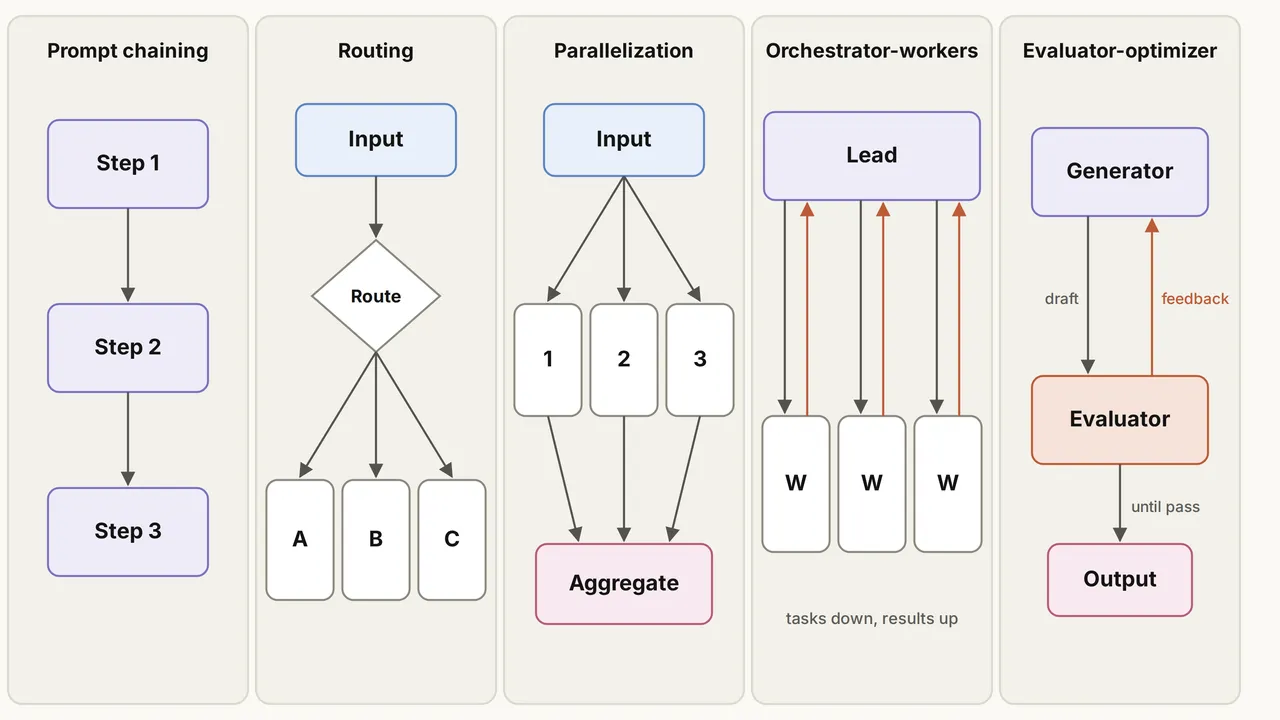
以下几乎所有设置都基于这些构建:
- 提示词链:每一步处理前一步的结果
- 路由:对输入数据进行分类并发送到专门的处理器
- 并行化:将工作分解为多个部分,或多次执行相同任务并比较结果
- 编排器 / 工作者:主导智能体分解任务,将部分交给工作者,合并结果
- 评估器 / 优化器:一个智能体创建,另一个批判,如此循环直到结果被批准
单一智能体还是多个(One agent or many)
先从如何最高效地使用单个智能体入手。只有在指令变得过于混乱或工具开始重叠时,才考虑拆分它们。
微软在这方面吃了亏。他们的 Azure SRE 智能体第一版有 100 多个窄工具和 50 多个专用子智能体。系统在数据传输过程中出现故障。据他们反馈,超过四次传输的链路几乎总是以失败告终。经过重组,最终保留了几个通用智能体和五个核心工具。
所以经验法则是:当第二个智能体承担真正不同的工作时才添加,比如检查第一个智能体的工作成果。
Setup 1: Background coding agent(配置一:后台编码智能体)
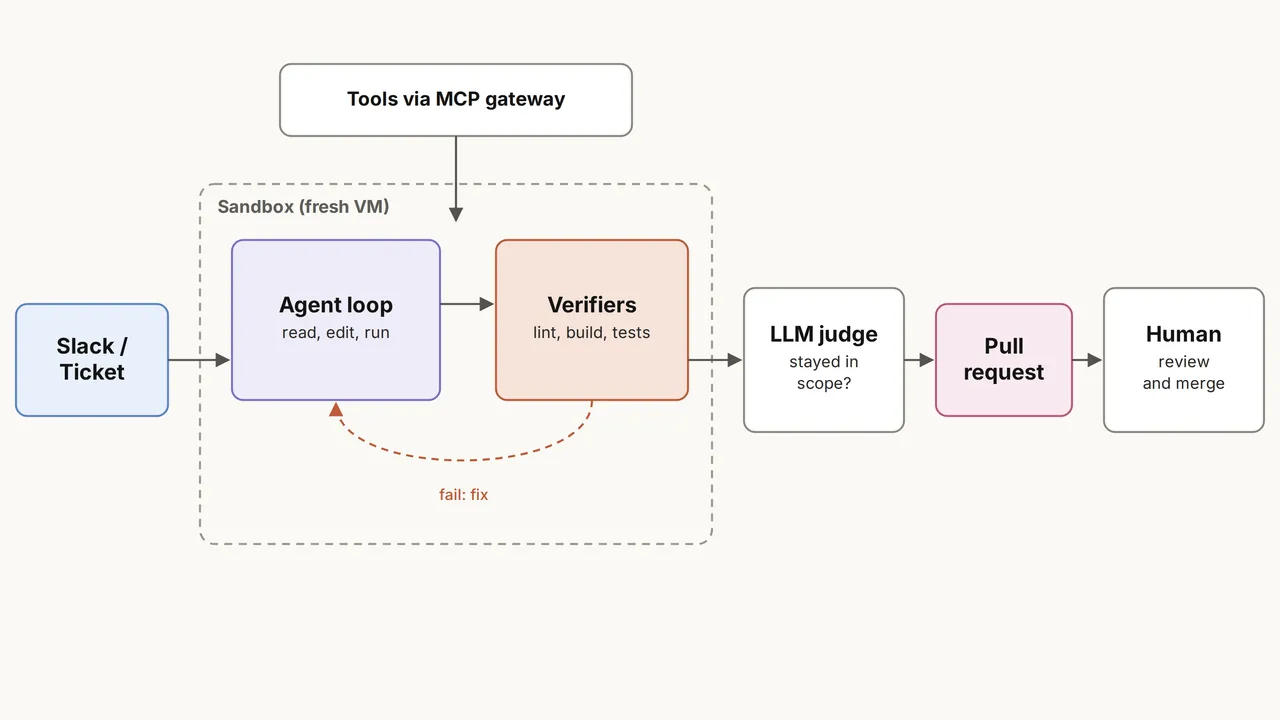
它的作用:工程师在 Slack 上发布任务或创建工单,离开,回来时拉取请求已经准备好了。
How it’s built:(如何构建:)
- 触发:Slack 消息、工单或定时任务
- 沙箱:每个任务配备一台全新的隔离开发机器,预加热以便在几秒内启动
- 工作流:固定步骤(代码检查、推送、创建 PR)与实际编码的智能体循环相结合
- 验证器:在任何 PR 生成之前,自动运行格式检查、构建和测试
- 人工:负责审查和合并,智能体从不执行
Who runs it:(谁在运行:)
Stripe, Minions。每周合并超过 1,000 个 PR,全部由智能体从头到尾编写。每次运行都遵循代码中定义的工作流 “蓝图”,并从 Toolshed(一个供数百个智能体访问的内部 MCP 服务器)获取所需工具。
来源:stripe.dev/blog/minions-stripes-one-shot-end-to-end-coding-agents
Spotify, Honk。智能体只能看到代码并调用验证器。停止钩子会在 PR 打开前触发每次检查。然后一个 LLM 评判员将差异与原始任务进行对比,约有四分之一的会话因超出范围而被否决。
来源:engineering.atspotify.com/2025/12/feedback-loops-background-coding-agents-part-3
Shopify, River。你在公共 Slack 频道中标记 (@) river。Shopify 目前每八个合并的 PR 中就有一个由其合著:30 天内合著了 3,536 个 PR。
来源:shopify.engineering/under-the-river
从这里开始:anthropics/claude-code-action。在 GitHub 问题或 PR 上提及 @claude,它会在 GitHub Actions 中工作并为你打开 PR。
Setup 2: Code review agent(配置二:代码审查智能体)
它的作用:在人工审查之前审查每个拉取请求,并只保留值得阅读的评论。
How it’s built:(如何构建:)
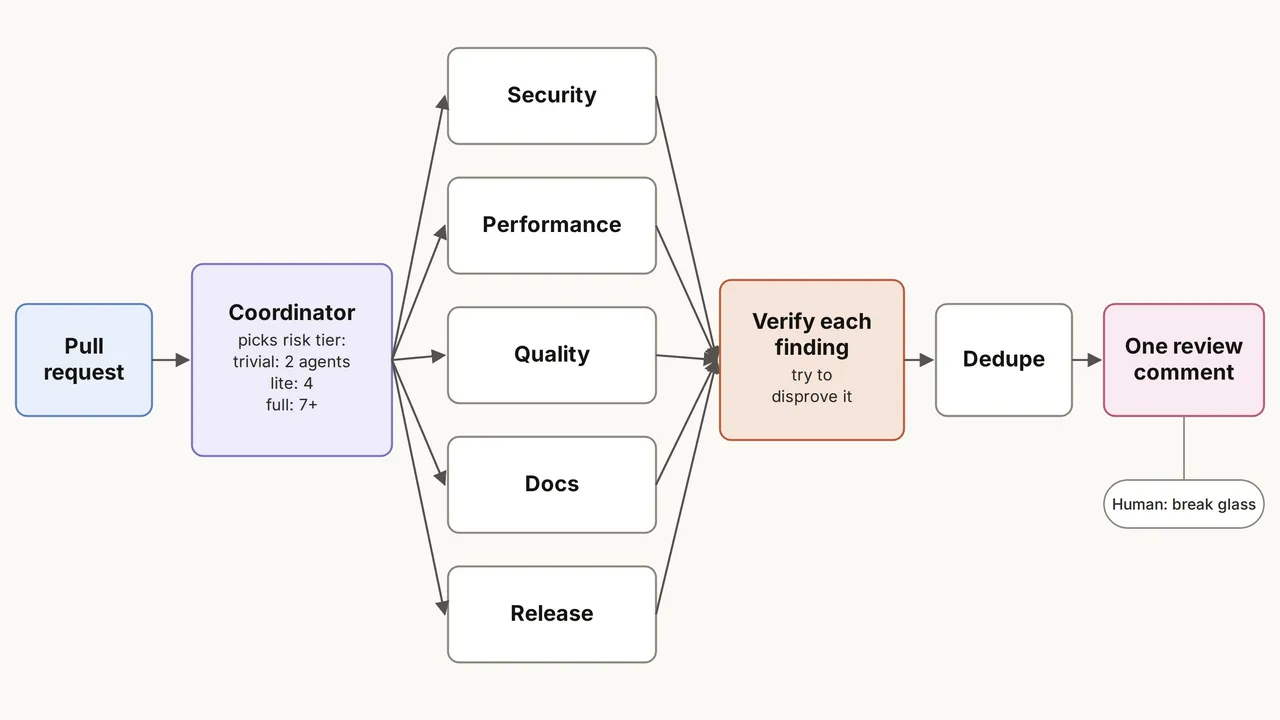
- 协调者:读取差异并判断其风险程度
- 专家:分别负责安全、性能、代码质量和文档的独立审查者,每个都有自己的提示词
- 验证:每个发现都必须经过第二次检查才能发布
- 去重:重复评论被合并为一次审查
- 覆盖:人工始终可以强制合并
风险越大,召回的审查者就越多。拼写错误修复不需要安全审计。
Who runs it:(谁在运行:)
Cloudflare。协调者根据风险级别指派最多 7 个专业审查者。在一个月内:在 48,095 个合并请求中进行了 131,246 次审查运行,中位时间 3 分 39 秒,中位成本 \$0.98。工程师仅在 0.6% 的 MR 上覆盖了机器人。
来源:blog.cloudflare.com/ai-code-review
DoorDash。首席侦察员标记可疑区域,两名专家审查员检查它们,每条评论在发布前必须经过反驳阶段。每周超过 10,000 个 PR。60.2% 的高严重性发现导致了代码更改,而他们之前的第三方工具为 46%。每次审查约 \$3。
来源:careersatdoordash.com/?p=15891
Uber, uReview。三个生成器产生评论,一位专家评估每条评论,过滤掉低价值类别。75% 的评论被评为有用,65% 以上实际被处理。
来源:uber.com/blog/ureview
从这里开始:garrytan/gstack 中的 /review 命令,或 obra/superpowers 中的代码审查技能。
Setup 3: Migration agent(配置三:迁移智能体)
它的作用:承担一个需要在数千处进行的单一重复性更改(如新的测试库、新的 API、移除旧函数标志)并应用所有这些更改。
How it’s built:(如何构建:)
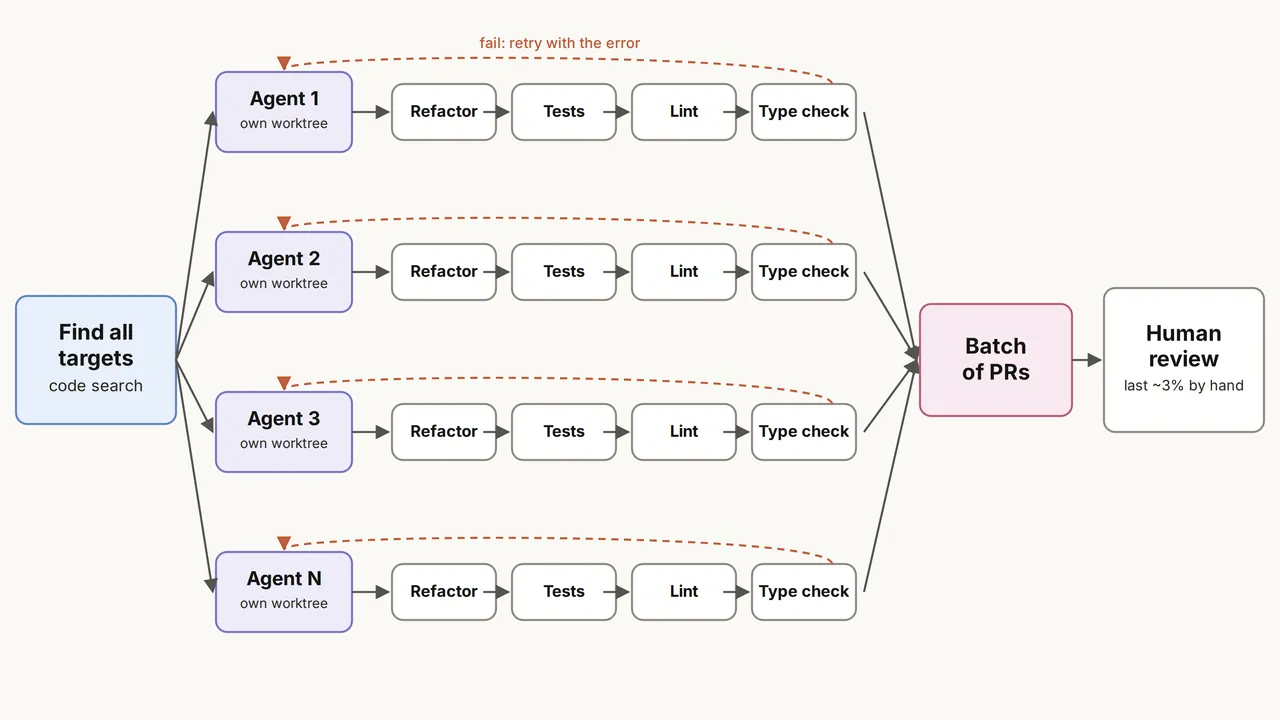
- 查找:脚本或代码搜索列出所有需要更改的文件或标志
- 分发:每个文件或每个项目对应一个智能体,多个并行运行,各自在独立的 Git 工作树中
- 关卡:每个文件通过固定检查(测试、代码检查、类型检查)并且仅在通过时才前进
- 重试:如果 / 当检查失败时,错误信息连同下次尝试的信息一起发送回智能体
- 人工:审查批量 PR,手动修复最后几个百分点的内容
关键在于状态机。智能体从不决定完成,而是测试决定。
Who runs it:(谁在运行:)
Airbnb。将约 3,500 个测试文件迁移到新的测试库。每个文件经过重构 → 测试 → 代码检查 → 类型检查,失败时反馈错误。97% 自动完成。人工估计:1.5 年。实际:6 周。
来源:medium.com/airbnb-engineering/accelerating-large-scale-test-migration-with-llms-9565c208023b
Google。使用内部代码搜索找到每个位置,用微调的 Gemini 生成差异,通过构建和测试验证。在一次 ID 迁移中,80% 的代码更改完全由 AI 编写。JUnit 3 到 4:3 个月内 5,359 个文件。
来源:arxiv.org/abs/2501.06972
DoorDash。编排者挑选过时的功能标志并写报告供人工批准。然后每个仓库最多 4 个移除智能体在并行工作树中工作。测试通过且更改行覆盖率达到 95% 之前不产生 PR。50 个标志中有 45 个达到可合并状态,每个标志花费 \$4.79 和 13.8 分钟。
来源:careersatdoordash.com/blog/automating-feature-flag-cleanup-at-scale-with-a-multi-agent-llm-system
从这里开始:obra/superpowers 中的 dispatching-parallel-agents 和 using-git-worktrees 技能。
Setup 4: On-call / SRE agent(值班/SRE 智能体)
功能:在警报触发的那一刻加入事件处理,当人类还在打开笔记本电脑时就开始调查,并发布其发现。
How it’s built:(如何构建:)
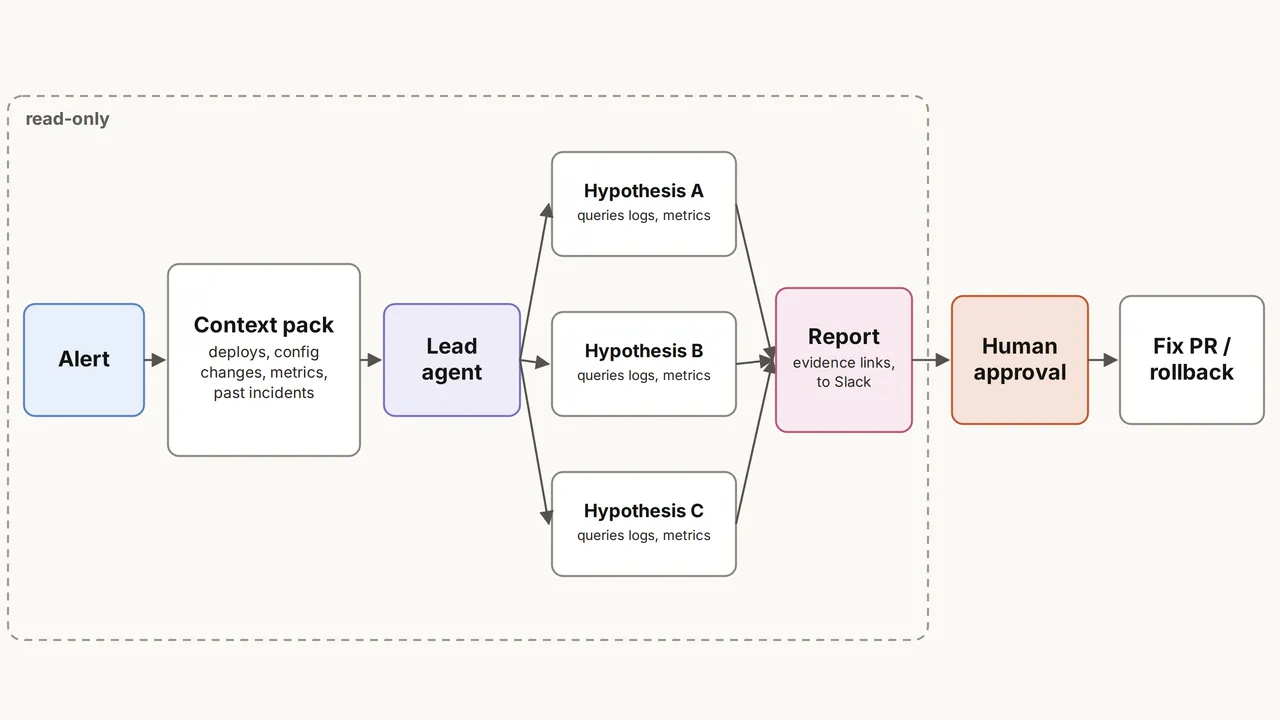
- 触发:来自 PagerDuty、Datadog 或事件 Slack 频道的警报
- 上下文优先:在模型开始之前,确定性检查会拉取最近的部署、配置更改、仪表板和类似的过往事件
- 假设:并行调查多个可能的原因,每个由各自的子智能体负责
- 证据规则:每个结论都必须指向特定的查询、日志行或图表
- 只读:智能体可以查看一切,但不能更改任何内容
- 审批:重启、回滚和修复都需要人工按下按钮
Who runs it:(谁在运行:)
微软,Azure SRE 智能体。 最初拥有 100 多个窄工具和 50 多个子智能体,后来围绕少数具有广泛 CLI 访问权限和代码执行能力(用于指标分析)的通才进行了重建。9 个月里,它独立处理了 35,000 多个事件。对于一个服务,缓解时间从人工平均 40.5 小时降至 3 分钟。
来源:techcommunity.microsoft.com/blog/appsonazureblog/context-engineering-lessons-from-building-azure-sre-agent/4481200
Ramp,OCA。 加入事件频道,约 5 分钟内发布首次更新,约 13 分钟内发布完整报告。所有地方只读,破坏性操作只能通过 Slack 审批按钮进行。四周内,它协助处理了 1,220 个事件修复 PR 中的 575 个,拉入的工程师减少了 37%。
来源:builders.ramp.com/post/how-we-built-oca-our-ai-on-call-assistant
Meta。 每个结论都必须引用特定的工具查询,并由架构强制执行,因此模型无法凭空捏造数据。从检测到缓解的中位时间从 9.5 小时降至 3.8 小时。
来源:atscaleconference.com/?p=1037753
从这里开始: OpenAI 的 cookbook “构建用于事件响应的 SRE 智能体”。审批门控的回滚,调查状态保存在 Slack 线程中。
Setup 5: Security agent(安全智能体)
功能:对安全警报进行分类,在代码中搜寻漏洞,并起草修复方案,这样安全团队只需查看真实的问题。
How it’s built:(如何构建:)
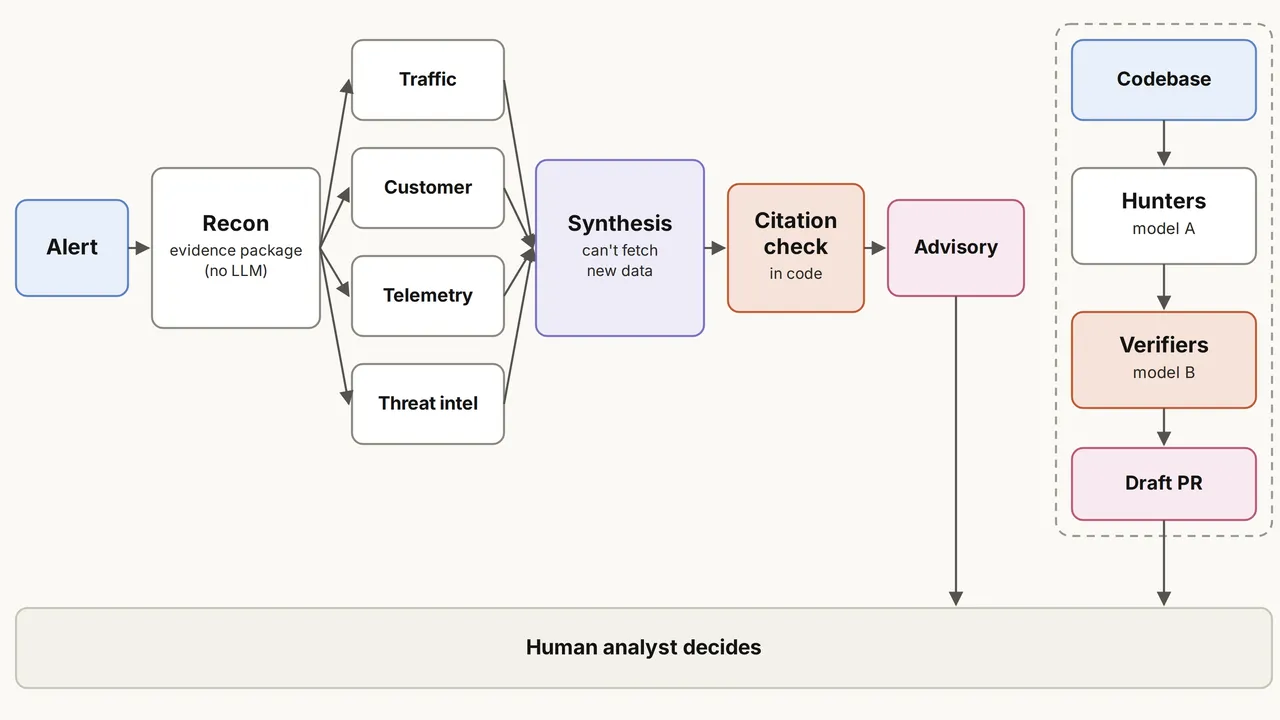
- 证据优先:在调用任何模型之前,普通代码先将日志、流量和上下文收集到一个包中
- 专家:独立的智能体并行从不同角度(流量、用户上下文、威胁情报)进行分析
- 猎手与检查者:发现问题的智能体和验证问题的智能体运行在不同的模型上
- 代码中检查引用:没有真实证据支持的发现会被丢弃
- 人类做决定:智能体提出建议,PR 以草稿形式打开,由人来批准缓解措施
Who runs it:(谁在运行:)
Cloudflare。 本周发布。在任何模型运行之前,代码会构建一个带版本控制的证据包。四个专家智能体并行工作,然后一个综合智能体编写通告。它不能获取任何新内容,必须从经过批准的词汇表中选择。每个引用都由应用程序代码检查。没有证据,就没有结论。
来源:blog.cloudflare.com/agentic-security-operations
Figma。 一个便宜的模型对每个警报进行路由,一个更强的模型使用 Okta、Wiz 和 Panther 进行分类。当分析师纠正它时,智能体会更新自己的指导文件。智能体的 PR 被强制设为草稿。结果:解决时间加快 71%,值班呼叫减少 20%。
来源:figma.com/blog/how-we-secure-figmas-internal-systems-with-agents
Shopify,Dispatch。 将每个应用拆分成多个部分,对每个部分并行运行漏洞猎人,然后用刻意选择的不同模型验证发现。六周内:80 多个应用中发现了 300 多个问题,相当于约 40 万美元的漏洞赏金价值。一次完整扫描花费 50 到 300 美元。
来源:shopify.engineering/building-an-agentic-harness-that-outlasts-the-model
从这里开始: trailofbits/skills,来自 Trail of Bits 的 42 个安全插件,用于代码审计、智能合约和逆向工程。
Setup 6: Data analyst agent(数据分析师智能体)
功能:公司里的任何人都可以用通俗英语提问(“为什么上周俄亥俄州的订单下降了?”),并得到附带 SQL 的答案。
How it’s built:(如何构建:)
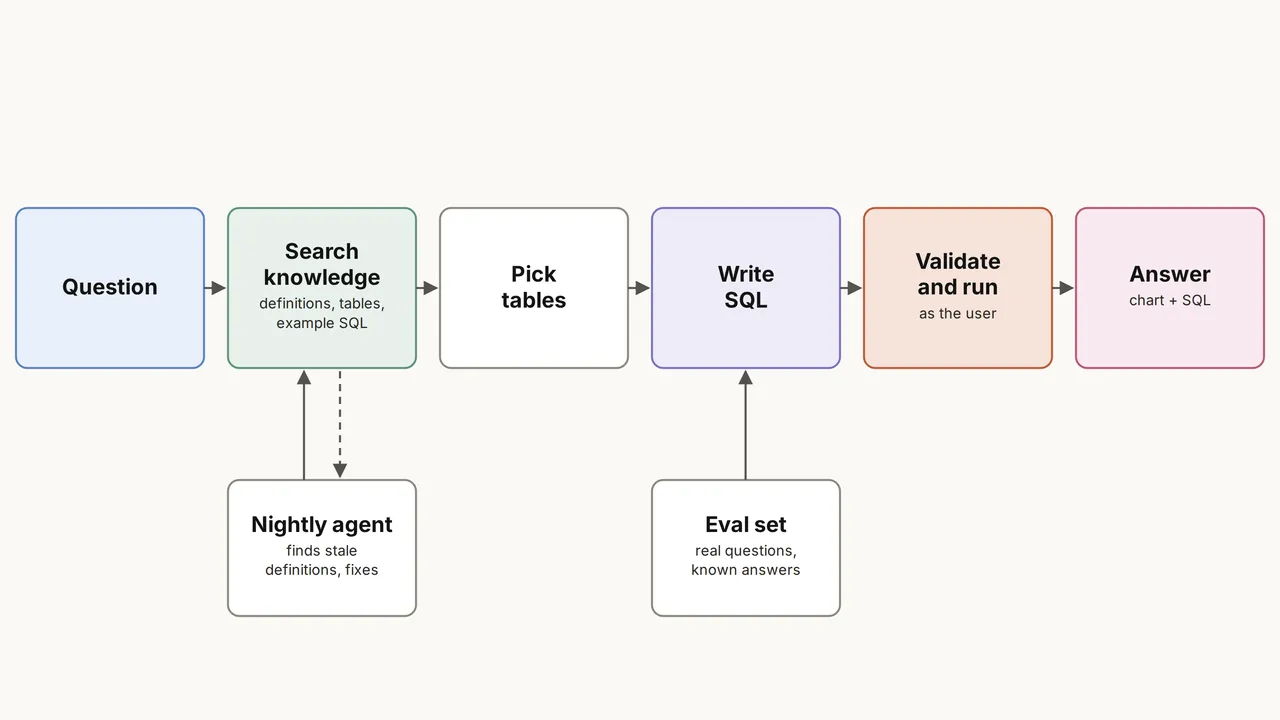
- 知识层:表描述、指标定义、示例查询和业务规则,智能体会首先搜索这些
- 检索:在写任何 SQL 之前先找到正确的表:模型编写查询,框架验证并运行它
- 权限:查询使用用户自己的访问权限运行,因此没有人能看到他们不应该看到的数据
- 评估:一组已知正确答案的真实问题,每次更改后重新运行
- 审批:对于繁重的分析,智能体会先展示计划并等待同意
模型的重要性比你想象的要小。大部分工作在于知识层。
Who runs it:(谁在运行:)
DoorDash,Vera。 覆盖 200,000 多个数据集。新数据源在通过评估阈值之前保持关闭状态。在 1,900 多个评估中,通过率从 43% 提升至 90%。在同一个模型上,Vera 得分为 2.60(满分 3 分),而普通的 Claude Code 得分为 2.16,因此框架起到了决定性作用。
来源:careersatdoordash.com/blog/inside-vera-doordashs-data-agent
Notion,Data Scout。 10 月 8 日发布。查询在每个员工自己的 Snowflake 凭证下运行。定义保存在共享的 Notion 数据库中,夜间智能体负责发现过时或冲突的定义。两个月内,向数据团队提出的请求下降了约 80%。
来源:notion.com/blog/how-we-built-a-personal-data-scientist-for-every-notion-employee
OpenAI。 他们的内部数据智能体堆叠了六层上下文,从表的使用情况到机构知识,并且每当用户纠正它时都会保存记忆。超过 600 PB 的数据上有 3,500 多个内部用户。
来源:openai.com/index/inside-our-in-house-data-agent
从这里开始: anthropics/knowledge-work-plugins 中的 data plugin。
Setup 7: Customer support agent(客户支持智能体)
功能:回答客户和支持人员的提问,解决它能解决的问题,并将剩余问题连同已收集的上下文转交给人工处理。
How it’s built:(如何构建:)
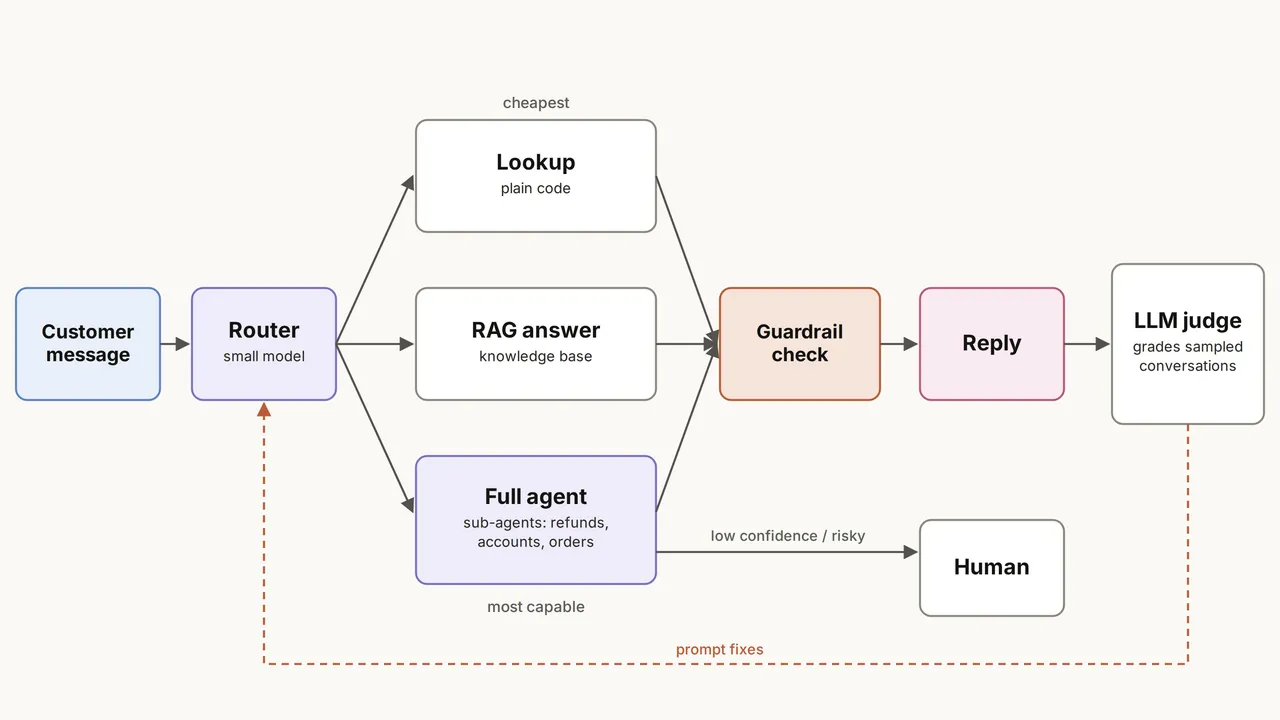
- 路由器:一个小而便宜的模型读取请求并决定其去向
- 成本阶梯:简单的查询走普通代码,常见问题走 RAG,只有复杂的情况才会到达完整的智能体
- 专家:独立的子智能体分别处理退款、账户、配送,各自拥有自己的工具
- 护栏:每个答案在发出前都会经过政策、幻觉和泄露检查
- 评判员:每天有一个 LLM 对真实对话样本进行评分
- 移交:当信心不足或操作有风险时,升级给人工处理
Who runs it:(谁在运行:)
Lyft。 一个元智能体将请求路由给子智能体,有些是手工构建的,有些是根据 JSON 配置生成的。每轮对话都运行安全检查,LLM 评判员审查抽样的生产轨迹。构建一个新的支持智能体从大约 6 个月缩短到大约 2 周。AI 解决率提升 16%。
来源:langchain.com/blog/lyft-built-a-self-serve-ai-agent-platform-for-customer-support-with-langgraph-and-langsmith
DoorDash。 对配送司机的支持基于过去已解决案例的 RAG,然后有两层护栏和一个 LLM 评判员对每个答案进行评分。幻觉下降 90%,严重合规问题下降 99%。
来源:careersatdoordash.com/blog/large-language-modules-based-dasher-support-automation
Coinbase, CEEcil。 一个小模型选择路由,确定性处理器在一两秒内给出答案,只有开放式问题才会到达完整智能体。它可以开 PR 修复问题,但永远不会合并它们。
来源:coinbase.com/blog/ceecil-engineering-a-support-teammate-with-human-memory
从这里开始: customer-support-agent 快速入门,位于 anthropics/claude-quickstarts。
Setup 8: Research agent(研究智能体)
它的功能: 接受一个宽泛的问题,同时搜索数十个来源,并返回一份每个说法都带有引用的报告。
How it’s built:(如何构建:)
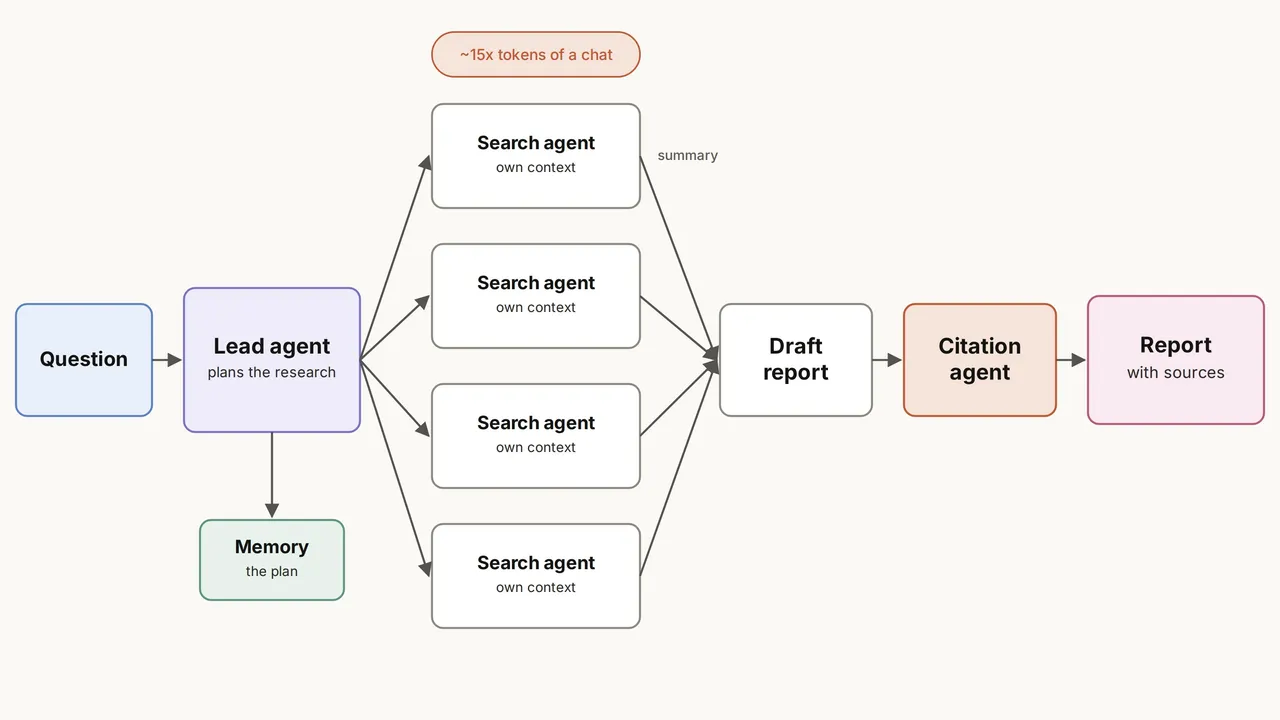
- 主导智能体:规划研究并将计划保存到记忆中,以便在长运行中持续
- 并行工作者:子智能体,每个在其自己的干净上下文中搜索一个角度
- 压缩:每个工作者只返回一个简短摘要,而不是它读到的所有内容
- 引用通过:一个单独的智能体在最后将每个说法与其来源匹配
- 成本:这是本列表中最消耗 token 的设置,用于值得花钱的问题
Who runs it:(谁在运行:)
Anthropic。 Claude 中的研究功能:一个 Opus 主导生成 Sonnet 子智能体并行搜索,然后一个引用智能体完成报告。在他们的内部评估中,它比单个 Opus 智能体高出 90.2%。缺点是:它使用的 token 大约是普通聊天的 15 倍,而 token 使用量单独就解释了 80% 的性能差异。
来源:anthropic.com/engineering/multi-agent-research-system
Harvey。 根据公司的剧本进行法律合同审查。每个规则一个子智能体,数十个并行运行,每个编辑自己分支的文档。一个协调步骤像 git 一样合并编辑并升级冲突。红线标记质量从 53% 上升到 87%,代价是延迟增加了 47%。
来源:harvey.ai/blog/rebuilding-playbook-review-as-a-multi-agent-system
Perplexity。 Deep Research 现在并行运行数千个检索步骤,模型编写代码来组装自己的搜索。BrowseComp 得分从 40.7% 上升到 83.8%。
来源:perplexity.ai/hub/deep-research
从这里开始: assafelovic/gpt-researcher,一个规划器、执行智能体和一个撰写最终报告的发布器。
Setup 9: Knowledge agent (second brain)(知识智能体(第二大脑))
它的功能: 捕捉专家所知道的东西,那些从未被写下来的内容,并将其提供给每个智能体和每个新员工。
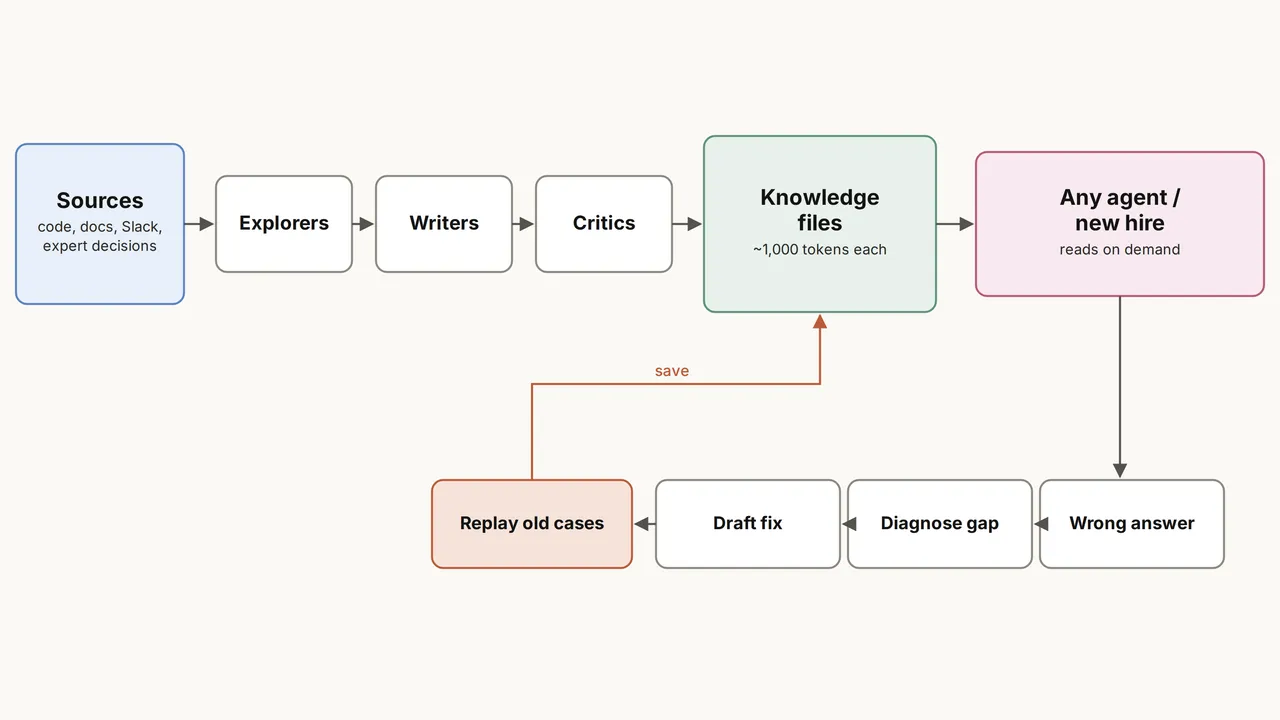
How it’s built:(如何构建:)
- 知识文件:简短、结构化的笔记(关键文件、规则、非显而易见模式),而不是巨大的文档
- 构建者:智能体读取代码、文档和过去的决策,并撰写这些笔记
- 批评者:其他智能体在笔记被保存前对其进行审查
- 记忆规则:除非有东西再次确认,否则事实会过期,冲突会被标记
- 自我改进:当答案错误时,系统找到缺失的部分,起草修复方案,并在保存前针对旧案例进行测试
目标是指南针,而不是百科全书。Meta 将每个文件保持在约 1,000 个 token。
谁在运行:
Meta,部落知识。 50 多个智能体(探索者、分析师、作家、批评者)将 4,100 多个数据管道文件映射到 59 个上下文文件中。AI 上下文覆盖率从约 5% 上升到 100%,智能体每项任务的工具调用减少了 40%。
来源:engineering.fb.com/2026/04/06/developer-tools/how-meta-used-ai-to-map-tribal-knowledge-in-large-scale-data-pipelines
Meta,组织第二大脑。 200 多个知识文件加上包含方法但不包含事实的 “配方”。当出错时,子智能体起草修复方案,一个对抗性智能体审查它,并且在发布前会重放旧案例。每个问题的 token 减少了约 80%,专家的数天工作减少到几分钟。
来源:engineering.fb.com/2026/09/02/ml-applications/organizational-second-brain-ai-learns-from-experts
Notion, Lore。 为智能体构建的共享记忆,作为五个关联的 Notion 数据库。除非被强化,否则事实会过期。有记忆的智能体在 149 个测试场景中通过了 102 个,没有记忆的通过了 82 个。
来源:notion.com/blog/building-shared-memory-for-ai-agents-in-notion
从这里开始: /undefined-ui/second-brain-os
Setup 10: Scheduled automation agent(定时自动化智能体)
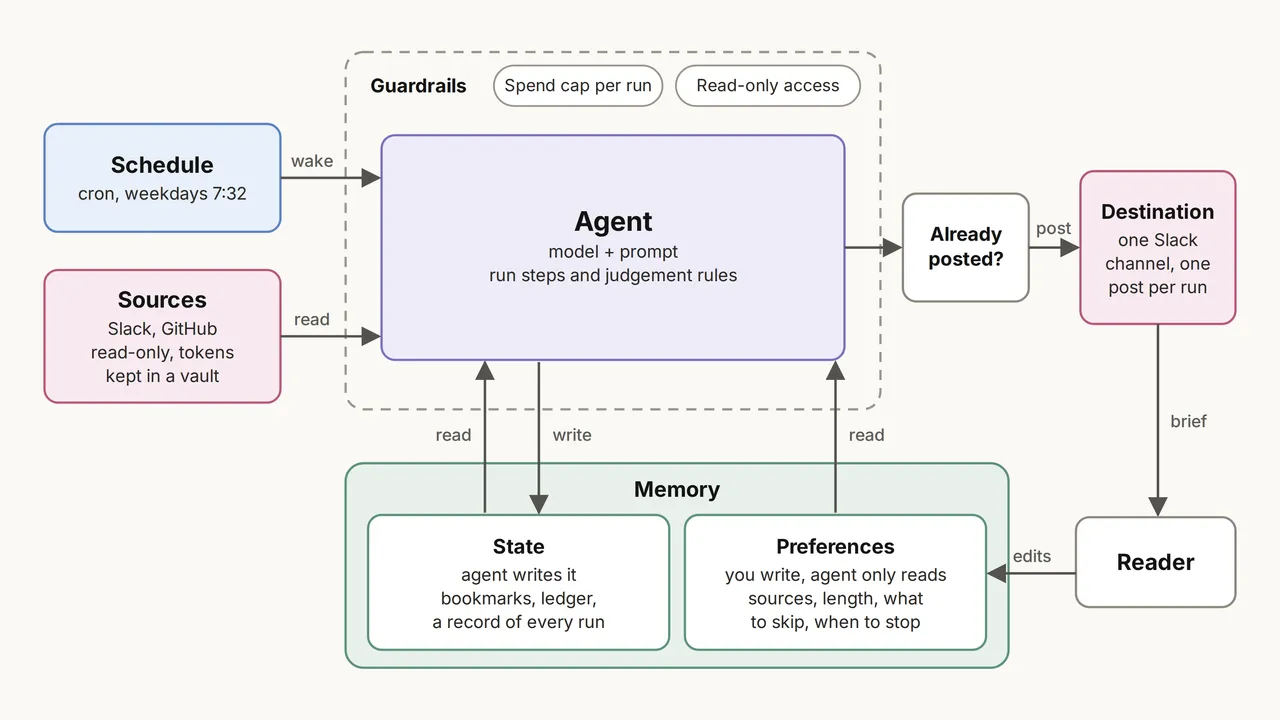
它的功能: 按计划唤醒,检查你的来源,只告诉你哪些发生了变化以及哪些需要你。无需提示词。
How it’s built:(如何构建:)
- 日程:一个 cron 作业每次运行时启动一个全新的会话
- 来源:只读访问权限,凭证存放在智能体外部的保险库中
- 书签:智能体记住它在每个来源中停止的位置,而不是读取 “最近 24 小时” 的内容
- 记忆分为两部分:你写的偏好设置,以及智能体为自己保留的状态
- 安全发布:检查今天的报告是否已经存在,只有在目的地确认后才算作已发送
- 预算:每次运行有支出上限,这样卡住的循环不会烧钱
谁在运行:
Anthropic。 “在 Anthropic,简单的智能体自动化经常被使用。” 他们的参考每日简报每个工作日早上在 Managed Agents 上运行,从每个来源的书签读取 Slack 和 GitHub,将失败的来源报告为不可读而不是安静的一天,并且每次运行上限为 5 美元。
来源:claude.dev/blog/building-effective-agent-automations
GitHub。智能体工作流以 Markdown 编写,并按日计划编译成 GitHub Actions。默认只读,仅通过批准的 “安全输出” 写入,拉取请求从不自动合并。GitHub Next 表示,他们 “几乎每天都能发现智能体工作流的新用途”。
来源:github.blog/ai-and-ml/automate-repository-tasks-with-github-agentic-workflows
微软。Azure SRE 智能体也可以按计划任务运行。同一智能体在计划任务上的评分为 4.5/5,而在通过广泛响应计划处理事件时仅为 1.7/5。狭窄、重复性的工作正是智能体的闪光点。
来源:techcommunity.microsoft.com/t5/apps-on-azure-blog/getting-the-best-out-of-azure-sre-agent/ba-p/4559745
从这里开始:managed-agents/daily-brief 位于 anthropics/claude-quickstarts 中。同一文件夹中还有一个计划任务的 Sentry 分类示例。
What every setup has in common(所有设置的共同点)
十种不同的工作、十家不同的公司,同样的规则反复出现:
- 独立的检查器。执行工作的智能体从不给自己打分。Spotify 使用 LLM 评判,DoorDash 采用 “反驳它” 的验证流程,Shopify 则使用完全不同的模型。
- 代码先于模型。先用普通代码获取数据、运行检查和收集证据。模型只负责需要判断力的部分。
- 默认只读。任何改变现实世界的操作都经过人工:草稿 PR、批准按钮、计划签署。
- 每项结论都要有证据。没有日志行、查询或来源支撑的结论会被丢弃。
- 每项任务权限最小化。每个任务只获得它需要的工具,不多给。
- 真实测试用例。过去的事件、问题、PR,在每次变更后重放。
照搬这六条,上述任何一个设置都能经得起考验。
Where to start(从哪里开始)
不要一次性构建全部十种。选择与你这周最烦人的事匹配的那一个:
- 淹没在大量小工单中:后台编码智能体
- PR 等待数天无人审查:代码审查智能体
- 一处改动需要在 500 个地方进行:迁移智能体
- 被警报吵醒:值班智能体
- 每天都遇到相同的数据问题:数据分析师智能体
- 每天都遇到相同的客户问题:支持智能体
- 每天早上要检查五种工具:计划自动化
从狭窄、只读、加上一个检查器开始。本文中的每家公司都是这样起步的:一个枯燥的任务,先衡量,然后再做下一个。
模型是最简单的部分。围绕它的设置才是让它运转的关键。
