
终于!!!我的 Codex 也能生成 Opus5.5 级别的动效了!!!
新版下载:
idea 的起源是这个帖子:
鉴于 Codex 做出来的效果实在是太差,而无法使用 Claude 的缘故,我动手分析了 100 多个国外开源的 Claude 动画的源码,并将其每一项进行了双盲实验、消融实验。
大致你可以理解为先让模型学习前 50 个,然后后 50 个作为双盲组,也就是让模型先隔离生成动画,然后再跟结果进行对比、学习、改进。
最终烧完两个 20 倍 Codex 账号,迭代了几十个版本,跑通了这样一个 hype-video 的 skill。
以下展示一些成果(纯盲测生成,无参考),效果我是直接把下巴都跌下来了。
观看五组完整对照:hypeyolo.com/motion/
我说的这种 Claude 感,我估计用过的都能懂。
但是确实很难用一个画风概括。剪纸、像素小镇、机械结构,长得完全不一样,但有些作品就是能让我觉得这个像 Claude 做的。
最终,折腾了几轮,我把源码、绘图模块和模型整理成了 Claude Motion。下面五组对照,能看到它实际用在新题目里是什么样子。
前面三组,左边是不用这套 Skill 的 GPT,右边使用 Claude Motion。后面两组,左边使用 Lemo 官方 Skill,右边使用 Claude Motion。两边都是 GPT。
同样的是,最终成片都是 one shot,没有进行打磨精修,只用最原始状态去对比。
天文台:借用景深和造型工具,重新写一个故事
统一提示词:维护机器人醒来,打开卡住的穹顶,透过望远镜看流星雨。
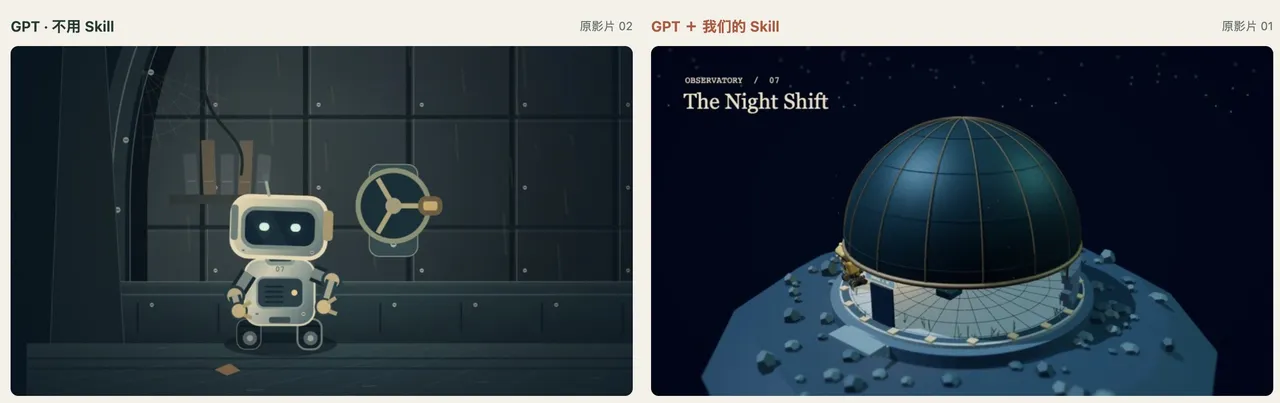
hypeyolo.com/motion/#observatory
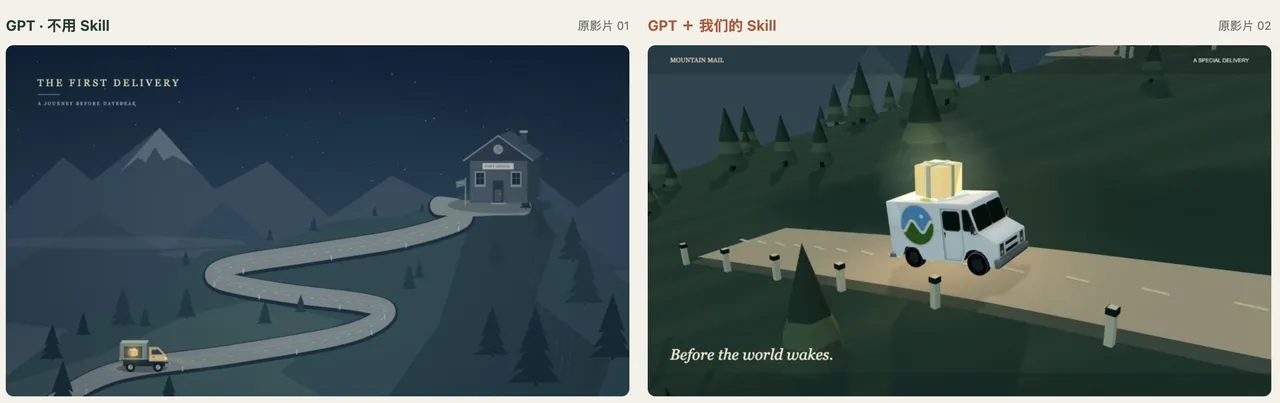
山顶包裹:完整模型也能带来变化
统一提示词:一辆货车沿山路运输发光的包裹,把它送到山顶邮局,最后邮局在日出时亮起来。
阅览室:把接触和动作继续磨细
同一段提示词:午后的阅览室,一阵风吹动窗帘,翻过一页书,房间重新安静下来。
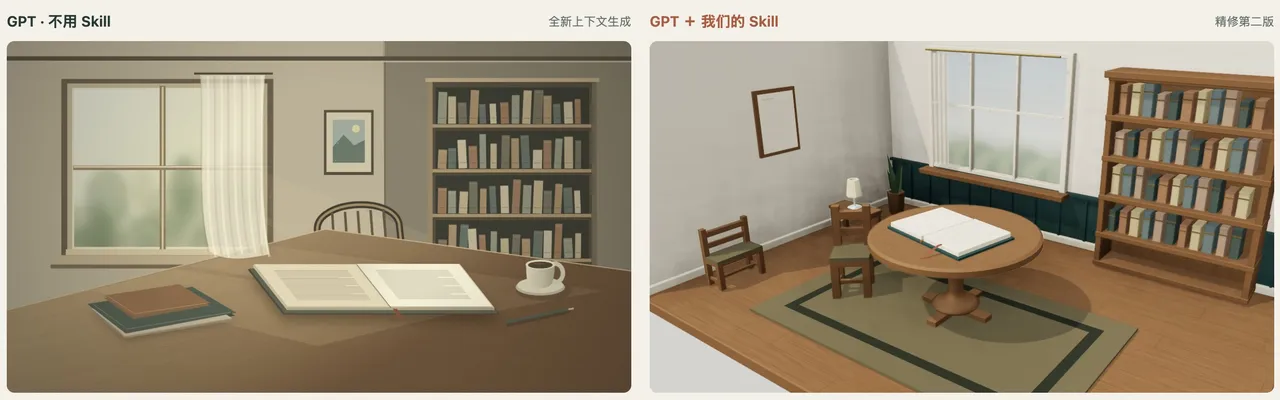
hypeyolo.com/motion/#reading-room
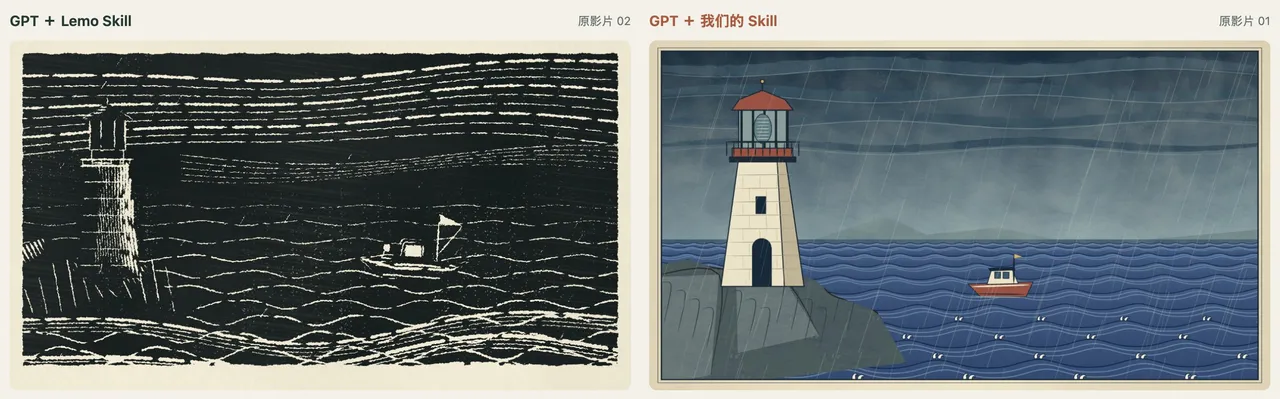
灯塔:skill 真实进步
下面的这些是我在测试自己的 skill 是否真的有用而使用这位博主的 skill 进行同一段提示词生成的
同一段提示词:风雨中,守塔人修好卡住的旋转透镜。灯光重新扫过海面,小船找到港口。
光圈:素材库里没有这个模型,竟然也可以做得那么好
题目是展示机械光圈如何控制通过的光线:看清重叠的叶片,一起打开和收拢,最后留下完整结构。
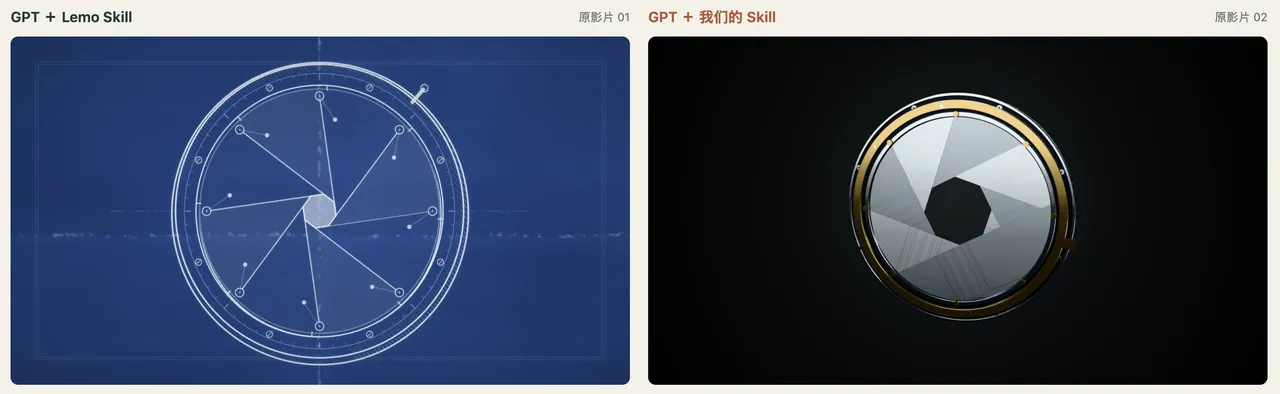
右侧没有找到一个现成的光圈模型。它选中了玻璃产品案例的影棚和金属处理,保留条形灯反射、环境光及金属拉丝,再新建八片叶片、外壳和开合逻辑。
由此你可以看到这个 skill 的自我递归能力,以及其收集的素材库对于视频渲染能力的提升。
看来对标还是 AI 最擅长的。
备注:
五组用的是各轮已经生成的成片,每支 18 秒、720p、24 帧。并排视频只缩放、加条件标签,保留完整时间线,播放右侧原配乐。
概括这个 skill 的底层原理:让 GPT 创作时可以直接查阅素材库里的案例,并使用里面的绘图代码。
比如一种印刷效果,原项目已经写好了怎么生成刻线、怎么叠加色版、怎么让油墨落到纸上。做新题目时,GPT 可以保留这些实现,再重新设计主体、动作和镜头。
如果只提炼成一句“画面要有手工质感”,具体怎么画,还是得重新猜。
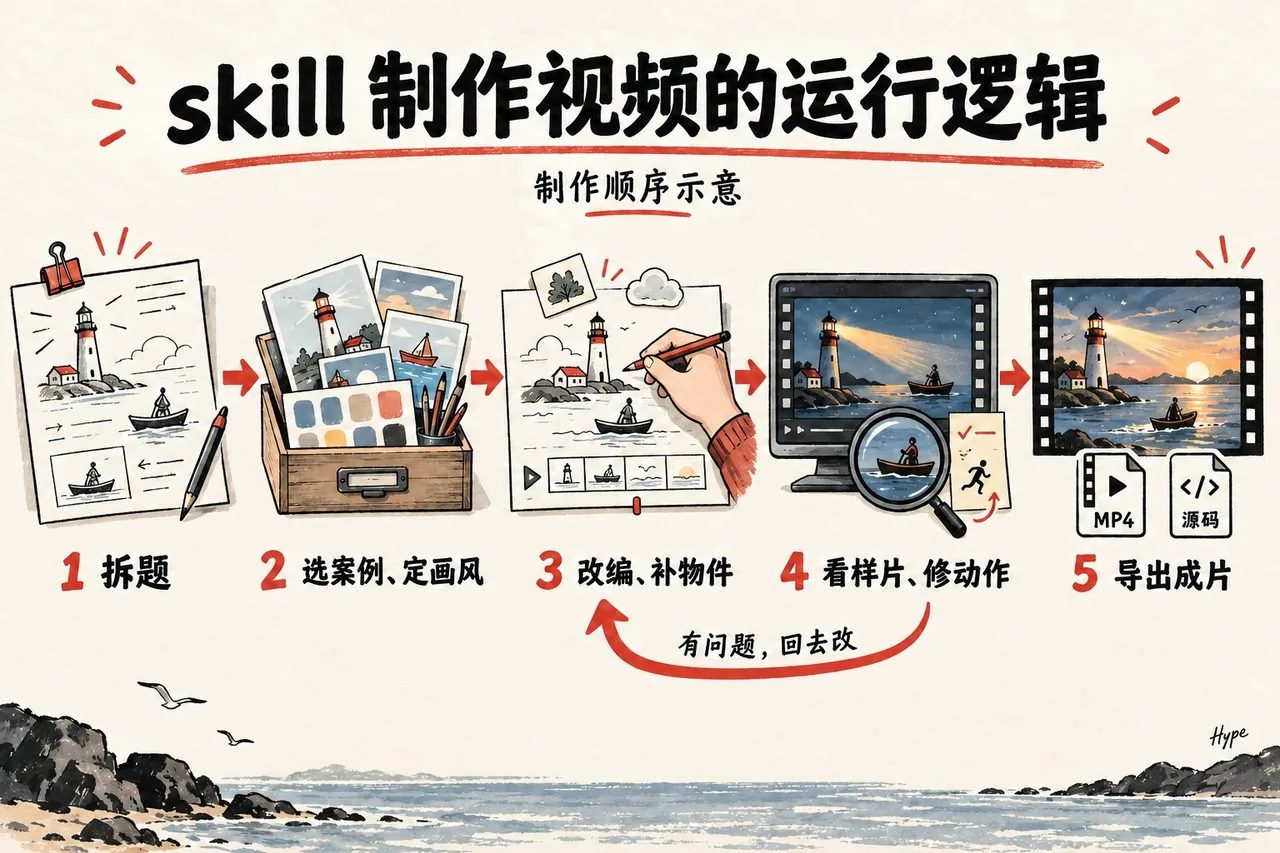
这个 Skill 从输入到成片,具体做了什么
文字规则负责指导选择,源码和模型提供绘制能力,GPT 负责改编与编排。 这三部分一起工作。
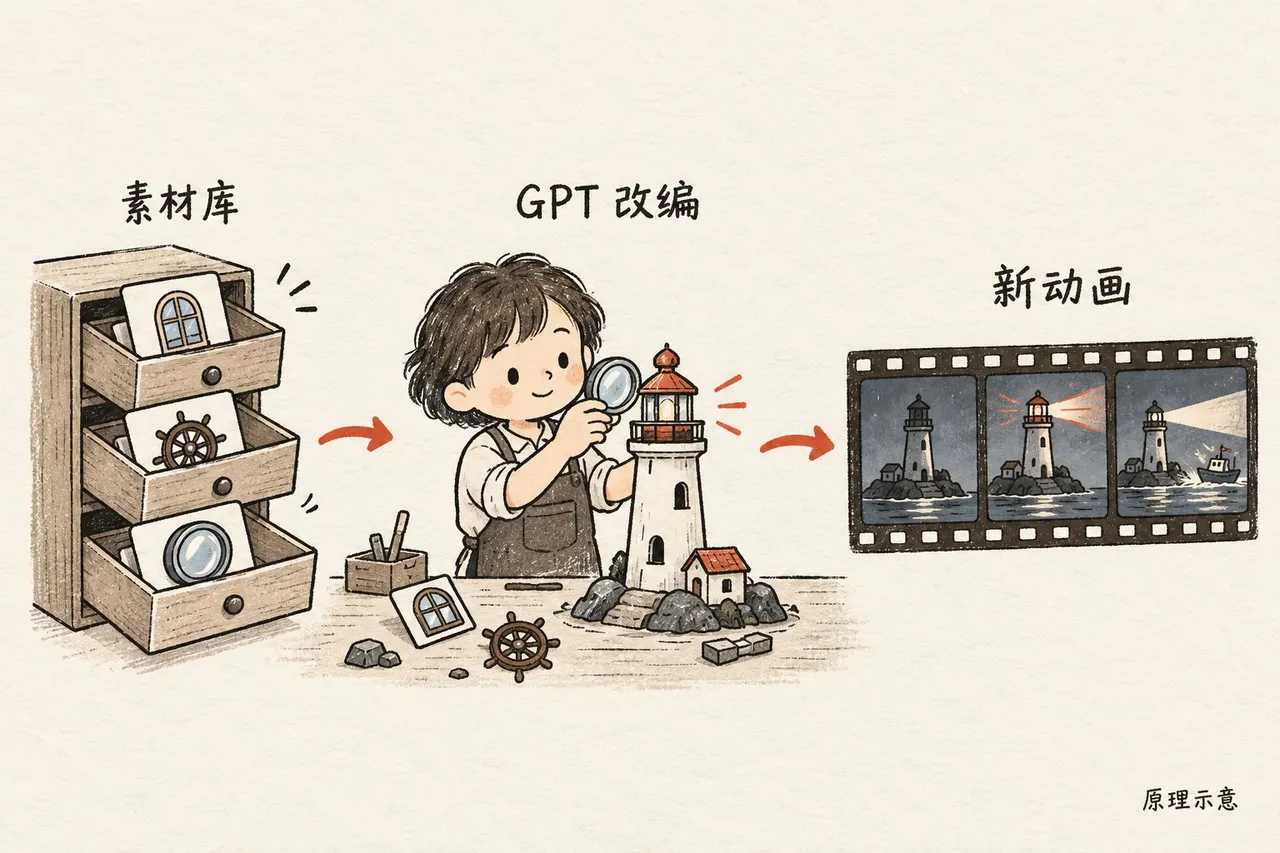
先判断这个题目需要什么
输入“修好灯塔,让小船回港”,GPT 要先识别需要画哪些东西、发生什么动作、观众要看懂什么关系。
灯塔题需要修理动作和光束扫海,光圈题需要重叠叶片和同步开合。题目里都有“光”,实际需要的实现完全不同。
接着查目录,找适合这些需求的案例、场景或模型。
包里的检索脚本按中英文标签匹配,给出候选和源码位置。它没有一个能自动判断美感的评分模型;最后仍要由 GPT 读实现、看预览、判断适不适合。
选定画风,再挑具体部件
GPT 会查看候选案例的造型、材质和运动代码,选择一个主方向。
比如灯塔片选二维印刷,光圈片选产品影棚,天文台选微缩三维。决定后,整支片子的比例、色彩、轮廓、光照和运动节奏要放在一起考虑。
复制能用的实现,再重新写新题目
Skill 有几种创建入口:复制原案例、复制已接通的场景或制作系统、提取完整模型。相关许可证和来源一起保留。
复制完以后,GPT 还要重写主体、事件、镜头与时间线。 创建工具只是给出工程起点,不会自己把旧故事变成新故事。
天文台保留景深和几何工具,山顶包裹保留货车模型,光圈保留影棚和材质。不同题目保留的部分不同,不要求每次都调用同一套代码。
最关键的是,那些实现必须真的参与最后的绘制。只读过源码,然后重新画几个方块,再加一层噪点,原来的能力还是丢了。
素材库缺东西,就按同一套规则补
不可能提前准备好任何故事里的所有物件。
缺少对象时,可以组合已有部件,也可以新写绘图路径或三维几何。需要更复杂的模型,再引入许可清楚的外部资产,统一比例、材质和动作。
光圈就是一个例子:主体重新建,周围的影棚与材质实现继续复用。二维印刷故事需要新人物时,也可以沿用原来的线条与墨色机制,不必突然切换成三维。
三维建模并非每支片子的必经步骤。只有需要绕拍、空间遮挡或立体结构的题目,才有必要用三维。
看代表片段,修动作,再导出
先看能代表成片的一段画面与关键动作。如果主体造型、材质或者接触关系不成立,就先修这一段,再扩成完整时间线。
最后让浏览器按指定时间逐帧绘制,由 FFmpeg 合成为 MP4。声音需要工程单独提供;没有音频就不会自动配乐,也不会因为我用中文提问就擅自加中文字幕。
交付时除了视频,还会保留可编辑代码,以及一份说明:用了谁的资源、保留了什么、改写了什么、实际检查过什么。
文件和视频检查能发现加载失败、解码错误等问题。至于是否精致,还是得把成片打开看。
素材库里有什么
这次整理的 v0.2.0-beta.1 包含:
- 源码案例:47 条
查阅并调用原来的绘制实现。
- 制作系统:5 套(含 10 个开发示例)
从接通好的工程改编。
- 场景入口:14 个(其中 3 个实验组件)
复用场景结构和时间线。
- 物件包:30 条
复用几何、贴图,以及部分骨骼动作。
47 条源码中,36 条有原例抽帧,11 条还存在预览缺口;阅览室场景另外附带 14 个家具文件,不计入那 30 条物件目录。
库里有 JavaScript 绘图代码,也有 GLB 模型、贴图、预览图和许可文件。它们都随 Skill 文件夹提供,需要时再读取,不会每次把全部源码塞进上下文。
新对话调用这个 Skill,会重新查找和使用这些文件。
我做的是把已有的绘图能力整理成 GPT 创作时能用的工具。
安装和使用
把下面这段话复制给 Codex,让它帮你完成安装:
请帮我安装这个动画 Skill:https://github.com/Hype-yolo/claude-motion-skill 。按照仓库的安装说明,下载当前发布版本,安装所需依赖并完成验证。如果已有同名 Skill,先备份。安装完成后,告诉我如何调用它来生成视频。
装好后,直接告诉它你想做什么视频,以及时长、声音和字幕要求即可。
skill来源:Lemo Opuscar、ReelMimic、animate、ClaudeAnimationBase,以及 Khronos 示例资产、Kenney 和 Quaternius。原作者署名、固定版本与各自许可保留在包内。
