
审批有可能是在给Agent当人肉外包
01 前言 01/07
本篇文章主要纪实于一位 舍得放开权限 的朋友和一位 不舍得放开权限 的小伙伴,在跟 Agent 的聊天的过程当中,两种截然不同的心态,以及他们在处理事情时,不同的解决问题思路。
供大家在与 Agent 交流时,更快速地找到解决问题的思路。
02 一位舍得放开权限的朋友 02/07
前段时间有个博士朋友正在写一份论文报告,数据准备得差不多了,接下来准备要把一批 论文截图 给插入文档。人工一张张截实在有点费劲,于是就想着让 Codex 帮忙做这件事。
他在让 Codex 干活的过程中发现,要不断地审批,审批带来的时间消耗,感觉比人工截图还累。
然后他来问小编说,有没有什么更好的解决方法,既能让 Codex 帮忙截图,又能少一点 点击 。
周一给他分析道:可以考虑把对话框的 替我审批 改成 完全访问 。在『替我审批』的模式下,只要涉及到一次鼠标点击, Codex 就会来问一次。那 点10次 , Codex 就会来 问10次 。
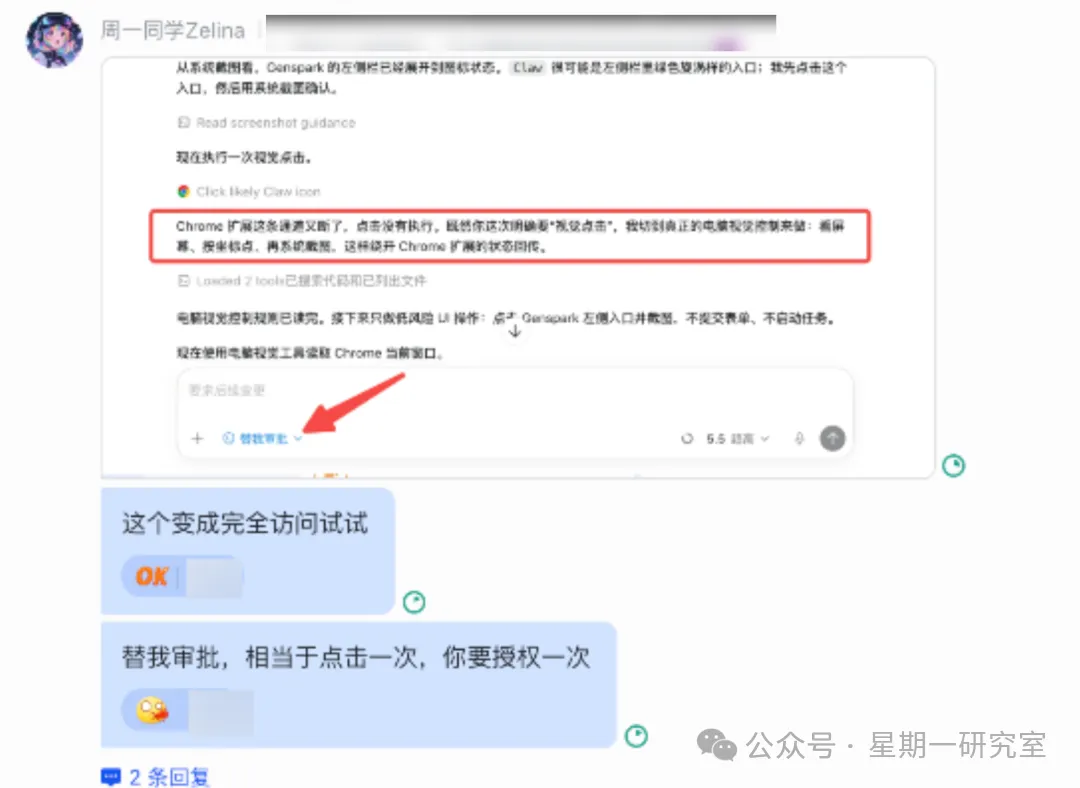
修改Codex访问权限
他是那种会直接开权限的人,小编给他讲完原理后,他听完二话不说,把『 完全访问 』给开了。
放权并提醒Agent安全
过了片刻之后,这位小伙伴发来消息,他说:截图快速搞定,非常丝滑地解决了。
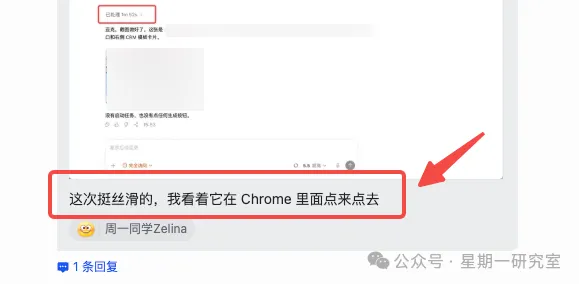
完全访问后的丝滑体验
一般来说,Agent的默认权限是『 替我审批 』。但殊不知的是, 替我审批 这个操作本身就是危险的,每一步都要自己点击确认,并且 需要人类的判断力 ;
真到了那一步,有可能连把事儿交给它都做不到,最终还是得自己手动来做这件事情。
03 一个不舍得开权限的小伙伴 03/07
后来,又有一位用户。这位用户的卡点是,授权 飞书CLI 过程中,反反复复,怎么都过不去。
这位小伙伴是『替我审批』的重度用户,他搞了这个权限,审批完、权限也有了,但活儿愣是没干完;
隔一天又开始授权,每天都在授权。然后他开始诉苦,一天要授权十几个小时,比 Agent 还累。轮到自己上手操作 飞书 CLI ,系统一路问他要各种各样的权限,他点了半天,一个都没成,最后人直接炸了。
这位小伙伴的心态belike:
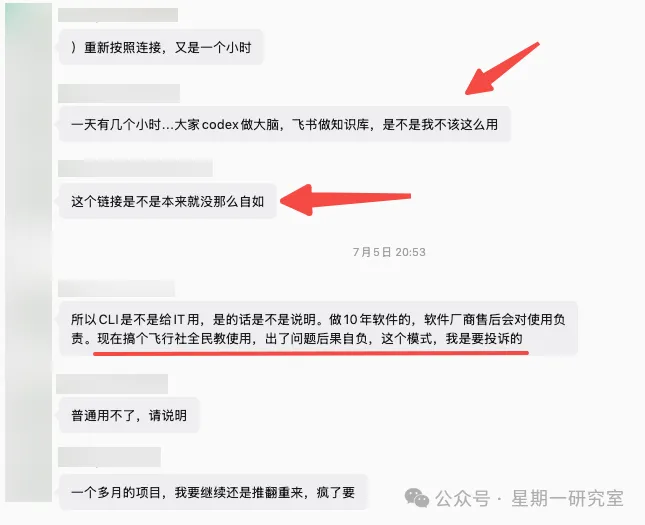
飞书CLI授权崩溃吐槽
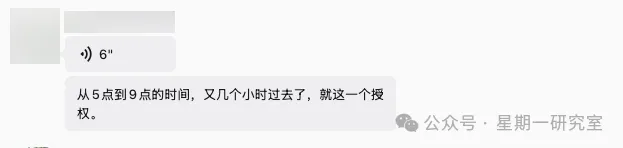
数小时只完成一次授权
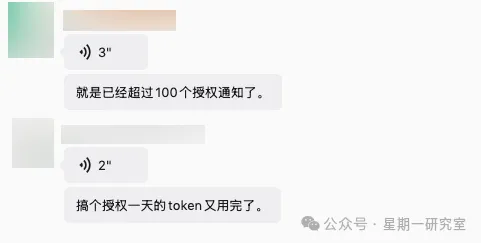
百次授权通知与短效凭证
一位社群的小伙伴解释到:
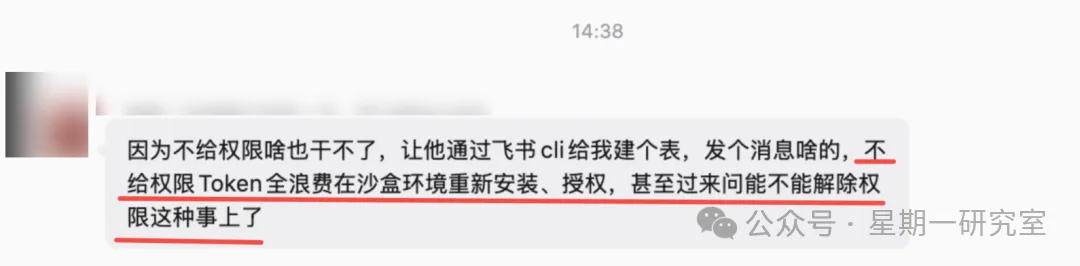
权限不足导致重复授权
且频繁地在权限之间兜来兜去,会把整个上下文给堆满了:
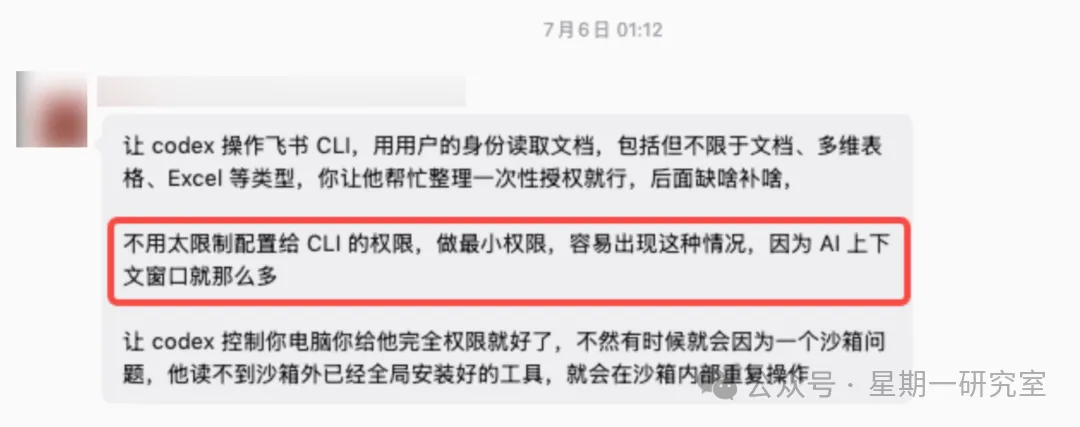
权限限制挤占上下文
我们会发现,同样是让 Agent 干活,一个顺顺利利,一个骂骂咧咧。差别到底出在哪?
第47次权限确认
04 审批有可能是在给 Agent当人肉外包 04/07
先思考一个问题: 审批模式 到底在防什么?防的是 Agent 干坏事。
可 Agent 干坏事的前提,是它真的有那个权限。而我们在 审批模式 下,每一步都在替它确认。说白了,我们才是那个最终执行的人。
这里有个很反直觉的坑,叫 审批疲劳 。
我们第一次看到『是否允许 Codex 执行此操作』的弹窗,还会眯着眼睛看两眼;等到第五十次、第一百次,我们早就麻了,手指头比脑子快,闭着眼就点 允许 。
我们可以试想下, Agent 干一个稍微复杂点的活儿,弹个二十次确认很正常。
但是等我们点到第十次,哪还记得前面都点过什么?真正危险的那一步,恰恰就混在这一堆 允许 里,被我们的肌肉记忆给放行了。
这里有点像 Web 安全里的 XSS 攻击 。 XSS 的危险,不在于用户主动想执行什么,而在于攻击者把恶意内容混进了一个看起来正常的页面里;用户只要 照常打开 、 照常点击 ,浏览器就可能替他执行了不该执行的代码。
比如,当你用了不合规的Agent软件时,XSS有可能会注入的位置可能会在意图识别卡里、或者是每次点击允许的按钮里。
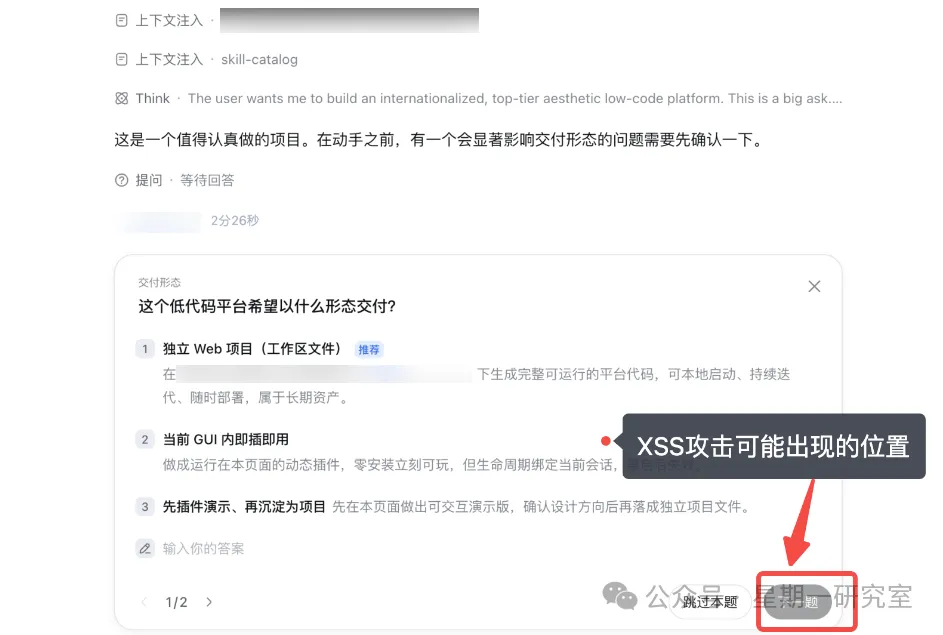
意图卡中的XSS风险
审批疲劳 也是一样。真正危险的操作,往往不会单独跳出来告诉你『 我是恶意的 』,它会伪装在一连串看起来都差不多的确认框里。有可能我们时常觉得自己是在正常完成流程,但实际上是在用 肌肉记忆 替 Agent 执行高风险动作。
所以,安全不能只依赖『最后让人点一下确认』。如果入口本身不可信,确认次数越多,人反而越容易变成 攻击链条 的一部分。
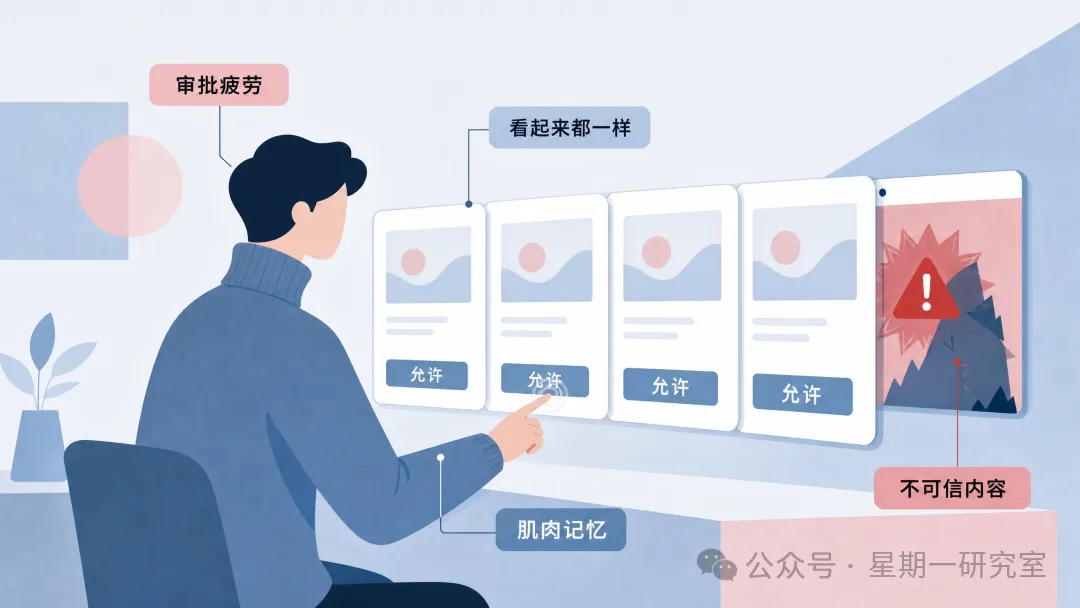
审批疲劳放行恶意操作
更要命的是,每拦我们一次,自动化的意义就少一分。 Agent 的价值在于连续作业,一口气把活干完。我们每点一次确认,就是把它打断一次。本来十秒能跑完的流程,陪着它点五分钟的确认,最后算下来,那不如自己点,说不定还更快。
你看那位情绪比较冲动的小伙伴,多半就是这么被磨疯的。不是工具不好用,是每走一步都被『 是否允许 』拦住,来回折腾,耐心归零,情绪爆炸。
所以我们会发现,『替我审批』根本不是安全,它更像是 用麻烦感换安全感的自我安慰 。你以为你在把关,其实你既没把住关,还把效率和注意力全搭进去了。
真要说把关,也得先搞清楚,这个 Agent 到底有没有干坏事的入口。
05 又怕又要,是另一种自我感动 05/07
这位情绪比较波动的小伙伴,其实还有一层问题:他授权了 飞书 CLI ,可又舍不得把数据全量交给 Agent 去处理。钥匙给出去了,数据捂得死死的。
这有点微妙的是,我们给了它工具,又不给它完整的上下文。Agent 手里信息是残缺的,活儿干出来四不像,我们更不放心,然后更不敢给数据……完美闭环。一边被各种权限卡着,一边又舍不得放手,两头都占不着。
试想一下,一个连完整资料都拿不到的 Agent ,它怎么干活?只能靠 脑补 。脑补对了,是运气好;脑补错了,回头还要骂它不靠谱。这哪是跟 Agent 协作,这是互相折磨。
有点像是 钥匙都递出去了 ,还把门里的东西全锁起来。表面是说在用 Agent ,实际是请了个 只能靠猜的外包 。
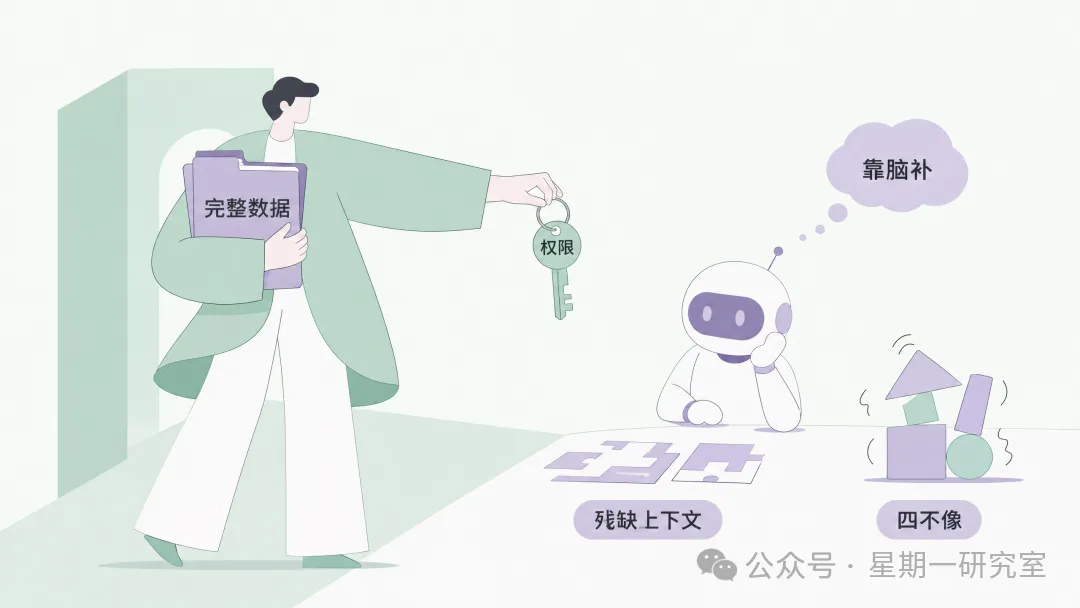
权限已给但数据残缺
06 从大模型层面理解安全 06/07
绕了这么多,这里还想说的一个核心是:别再把安全当成一个『权限开关』了,更好的方式是 从大模型层面 去理解它。
只有明白 Agent 到底是怎么『思考』的,才知道真正该防的是什么。
第一,它只按我们给的边界行动。
Agent 没有自己的小心思,它只会用我们 能调用的工具 、 能看到的上下文 去干活。我们给它多大的权限,它就有多大的活动半径。风险从来不是它『想不想』,而在于我们给它留了什么入口。入口留对了,它再猛也翻不出我们的手心。
第二,它的记忆和判断全部来自上下文。
对 Agent 来说,数据可见,就等于能力可达。我们让它处理数据又不给它数据,它就只能瞎猜。它就像一个 执行力爆棚但刚入职的实习生 :不给全资料,只能靠脑补填坑;填出来的东西对不对,全看命。
第三,真正的安全,从来不是『每一步都审』。
核心在于三件事:
- 最小权限——只给它完成任务够用的入口,多了不给;
- 沙箱隔离——让它在一个独立的环境里折腾,出事儿也殃及不到我们的系统;
- 全程可审计——日志回溯整理明白,真出事了,能查、能止损。
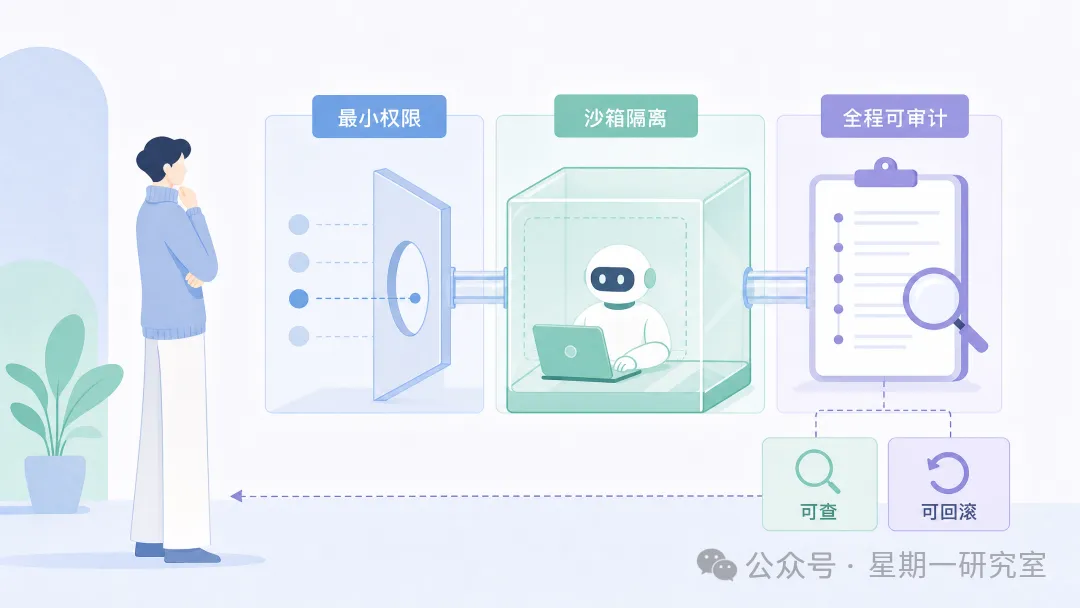
大模型安全三重保障
除了以上三点,还有两个容易忽略的细节。
数据可以做 分级处理 ,不用一刀切。敏感的东西,脱敏、降级之后再给它; 能给的,就尽量给全。 钥匙全给、数据捂死,其实是最拧巴的配置。当你捂得越死,它干得越差,你越不放心,就越想捂住。这个循环越早解开,两边都会轻松很多。
也可以把「不做什么」提前说清楚。把任务边界写明白,比反复叮嘱「你小心点啊」要管用得多。Agent 是最听话的同事, 只要你说得够清楚,它就不会越界 。
说到底,信任的底气应该是随时能查、能快速止损,而不是每一步都要问一遍。前者防不住什么,还把自己累个半死;后者,才是让人踏实的安全感。
07 结束语 07/07
回头看这两位朋友,差别不在胆子大小,而在于 判断力 花在了哪儿。
博士朋友把判断放在动手之前:边界在哪、最坏能坏到什么程度,想清楚就一次性把权限开到位,剩下的交给 Codex 一口气跑完。那位情绪炸了的小伙伴,把同样的判断力摊平进了几十次点击,每一次都很认真,加起来却什么也没防住。
最后我们会发现,不舍得放权并不能说明是 安全意识强 ,更像是点确认能立刻给人掌控感。
更进一步的是,最小权限、沙箱、日志这些东西,都值得在动手之前把边界考虑好。真出问题那天,我们能顺着日志倒回去看:它到底动了哪些东西、从哪一步开始跑偏,排查起来心里也会更有底。
所以下次再纠结要不要放权,可以先问自己一句:万一它真乱来了,我查得出来吗?收得回来吗?答得上来,就大胆撒手;答不上来,该补的也不是审批,是那个边界盒子。
以上就是本文的全部内容,我们下期见🦩🦩🦩
