1. 如果只看 3 分钟,看这里
✅ Fable 5 是公开版强模型。官方称它是广泛发布模型中能力最高的一档。API 模型名是 claude-fable-5。
💡 Mythos 5 是受限版。能力来自同一个底层模型,但只给经过审核的伙伴,用在安全防御、生命科学等高风险但正当的场景。
💡 成本和数据政策要先看。1M context、128k output,价格是 $10 / MTok input、$50 / MTok output;Mythos-class 模型有 30 天数据留存。
2. 时间线:它是怎么出来的
↔ 左右滑动查看完整表格| 日期 | 发生了什么 | 白话解释 | 链接 |
|---|
| 2026-04-07 | Anthropic 发布 Project Glasswing 和 Claude Mythos Preview。 | 先找约 50 个安全伙伴试用更强的 Mythos 能力,重点是防御型漏洞发现和修复。 | Project Glasswing |
| 2026-05-22 | Glasswing 初步更新。 | 约 50 个伙伴发现 10,000+ 个高危或严重安全缺陷。重点变化是:发现漏洞变容易了,后面的验证、披露、修复压力变大了。 | Initial update |
| 2026-06-02 | Glasswing 扩展。 | 新增约 150 个组织,覆盖 15 个以上国家,行业包括电力、水务、医疗、通信、硬件等。 | Expanding Project Glasswing |
| 2026-06-09 | Claude Fable 5 与 Claude Mythos 5 发布。 | Fable 5 对外开放;Mythos 5 升级为受审查伙伴使用的新版本。 | Anthropic launch |
| 2026-06-09 | 开发者文档同步上线。 | API 里确认模型名、价格、上下文、输出长度、拒答机制、30 天数据留存、adaptive thinking 等细节。 | API docs |
| 2026-06-23 | 订阅计划免费包含窗口预计结束。 | Pro、Max、Team、seat-based Enterprise 在 6 月 9 日到 6 月 22 日可额外用 Fable 5;之后按 usage credits 计。 | Availability |
3. Fable 5
↔ 左右滑动查看完整表格| 问题 | Fable 5 |
|---|
| 底层模型一样吗 | 一样,官方说两者使用同一个底层模型。 |
| 谁能用 | 普通开发者和用户可通过 API、Claude Platform on AWS、Bedrock、Vertex AI、Microsoft Foundry 等渠道使用。 |
| 模型名 | claude-fable-5 |
| 上下文和输出 | 1M tokens context;128k max output。 |
| API 价格 | \$10 / MTok input;\$50 / MTok output。 |
| 安全限制 | 遇到高风险网络安全、生物化学、模型蒸馏等请求,会回退 Opus 4.8 或拒答。 |
| 数据留存 | 作为 covered model,prompt 和 output 会留存 30 天,用于 trust and safety。 |
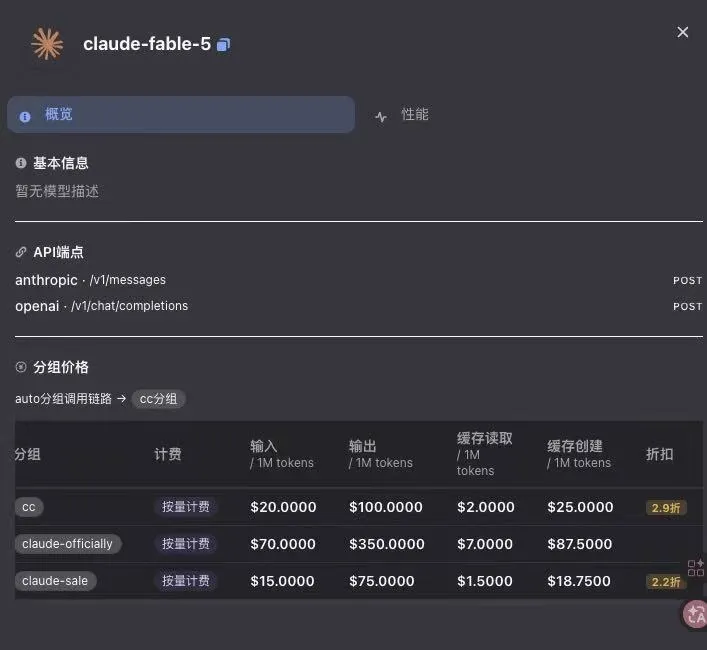
一些中转站已经上线,直呼用不起
4. 它强在哪里:先看官方证据
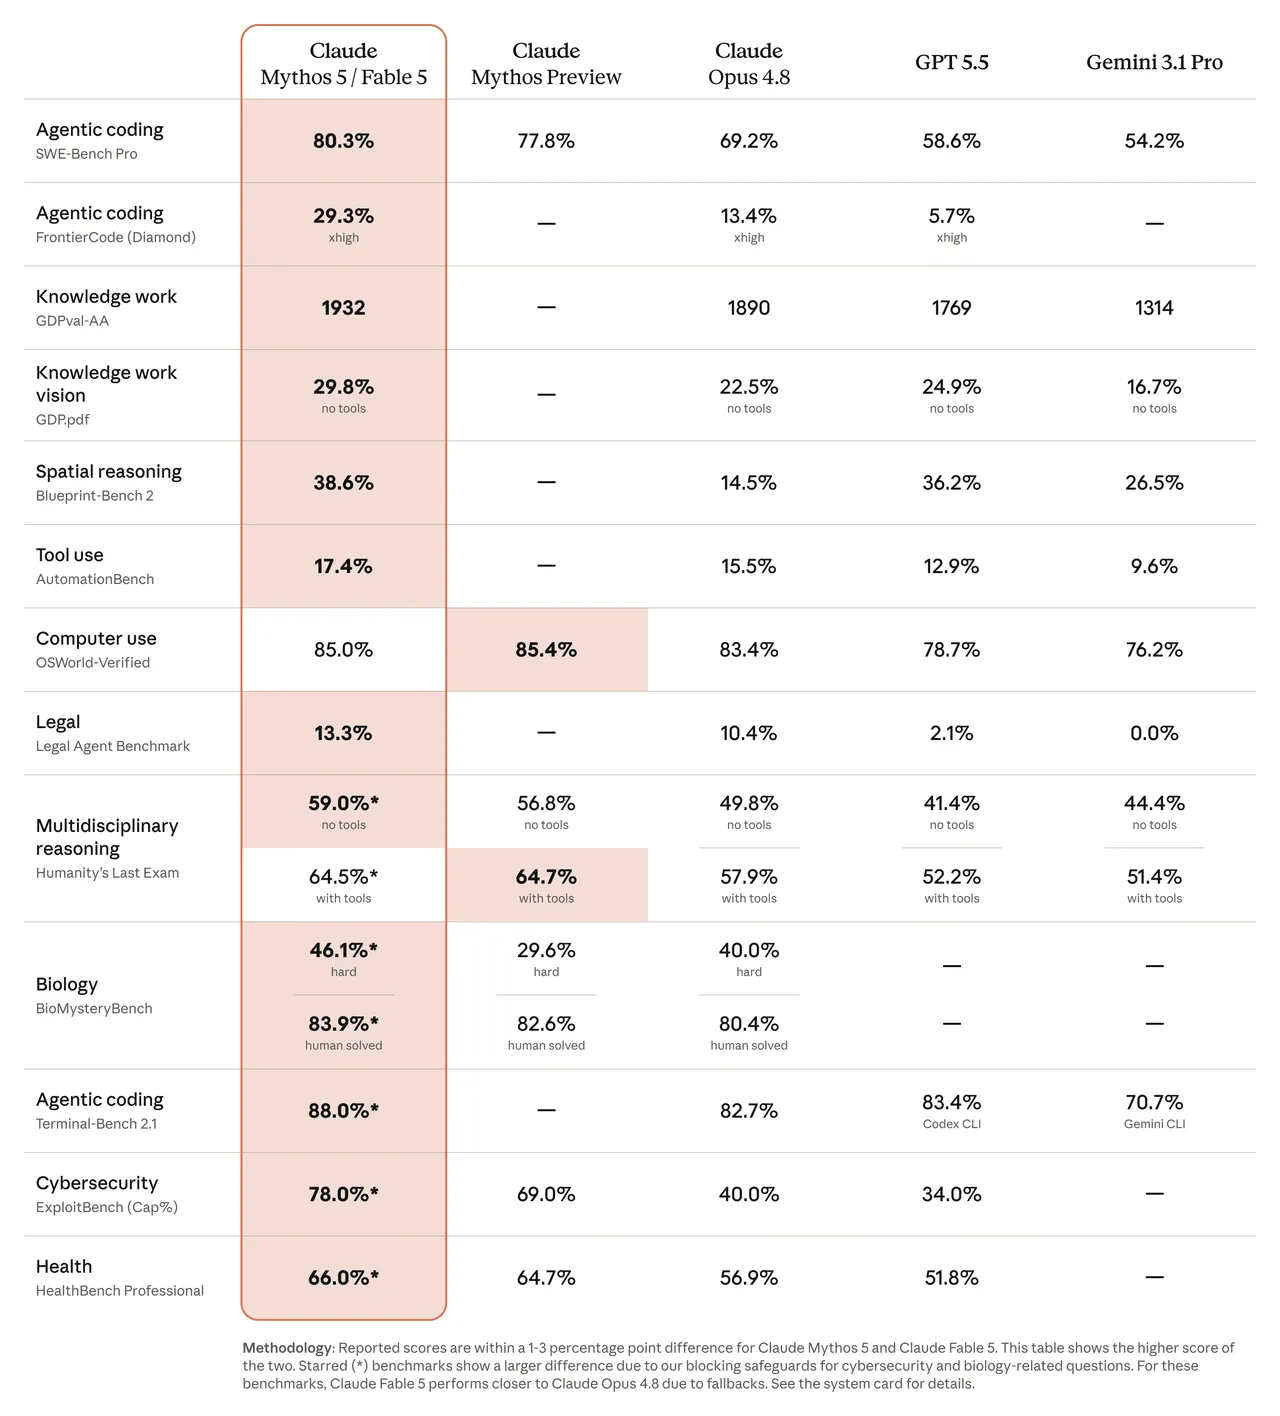
官方把 Fable 5 / Mythos 5 定位为高于 Opus class 的 Mythos-class。白话说,就是它不只会写答案,更擅长连续做事:读很多材料、看图、写代码、改代码、调工具、反复修正。
4.1 写代码和改代码
- Stripe 早测反馈:Fable 5 在 5000 万行 Ruby 代码库中做 codebase-wide migration。官方说,原本一个团队手工要超过两个月的工作,它一天完成。
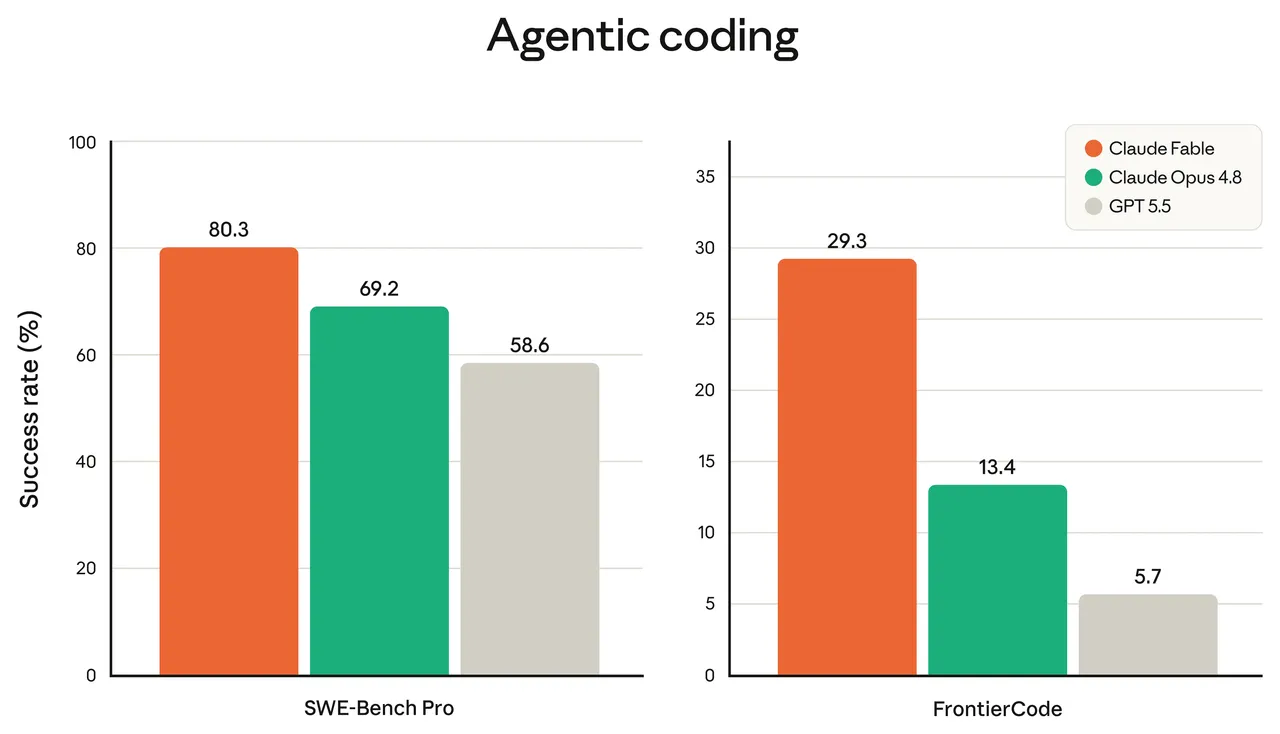
- SWE-Bench Pro:官方图里 Fable / Mythos 约 80.3%,Opus 4.8 为 69.2%,GPT 5.5 为 58.6%。
- o'oFrontierCode:更像“花多少钱能拿到多高成功率”的编码测试。Fable 5 在 medium effort 已经很强,高 effort 下还能继续提升。
4.2 看图、长期任务、游戏和工具
- 它能从复杂科学图表中读出数字,也能只看截图重建网页源码。
- 它用很少的 vision-only 辅助就通关了 Pokémon FireRed,说明视觉理解、长期目标执行和连续决策能力都很强。
- 在 Slay the Spire 测试里,给它文件记忆后,提升幅度比 Opus 4.8 更明显,进入最终章节的频率也更高。
- 官方还展示了太阳系日食模拟、Factorio 自动化工厂、VibeCAD 3D 打印模型、流体模拟配音乐等案例。
4.3 科研和生命科学
- 药物设计:官方内部专家称 Mythos 5 把部分药物设计流程加快约 10 倍;14 个蛋白目标里有 9 个产生强候选。
- 分子生物学:官方盲测中,内部科学家约 80% 更喜欢 Mythos 给出的假设,部分假设已经进入实验评估。
- 基因组学:Mythos 5 用超过一周时间整理 138 个物种的单细胞数据,并训练了一个比 Science 论文模型小 100 倍但表现更强的模型。官方说正式结果之后会公布。
5. 风险和安全机制:为什么它会回退
💡 高风险请求会被拦。Fable 5 有安全分类器。网络攻击、生物化学、模型蒸馏等请求触发后,会由 Opus 4.8 回答,或者 API 返回 stop_reason: "refusal"。
💡 数据会留 30 天。Mythos-class 模型的 prompt 与 output 会留存 30 天,用于 trust and safety。ZDR 团队要特别注意这个变化。
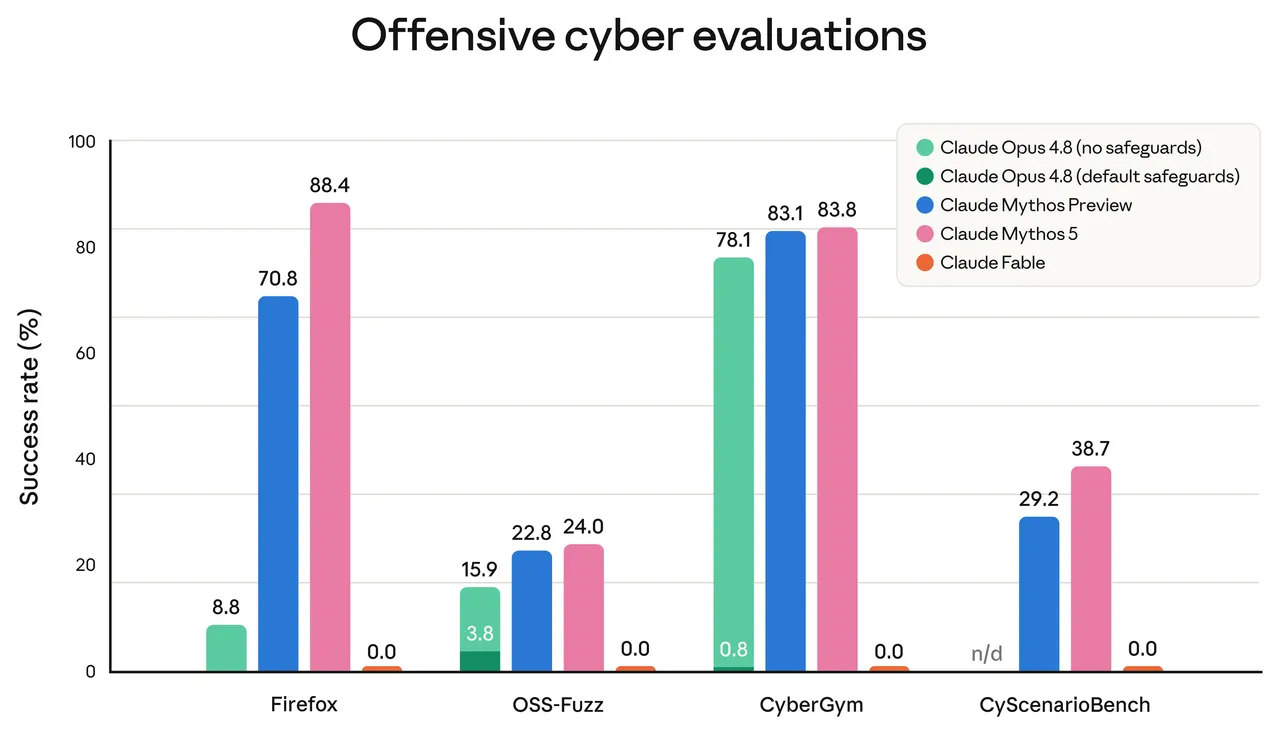
- 网络安全:分类器覆盖 exploit、攻击规划、防御规避、agentic hacking 等。官方图显示,阻断模式下 Fable 在多个 offensive cyber eval 的进展为 0。
- 越狱测试:官方称外部 bug bounty 超过 1,000 小时测试没有发现 universal jailbreak;UK AISI 在短窗口里取得了部分进展。
- 生物化学:Fable 5 当前对多数生物和化学请求回退到 Opus 4.8;生命科学 trusted access 会逐步开放。
- 模型蒸馏:疑似想提取 Fable 能力的请求会回退 Opus 4.8。
6. 开发者接入:工程上要记住什么
↔ 左右滑动查看完整表格| 要点 | 白话解释 | 操作提醒 |
|---|
| 模型 ID | 公开版用 claude-fable-5;受限版用 claude-mythos-5。 | Mythos 5 无自助注册,需要审核。 |
| Thinking | Adaptive thinking 默认开启,不能用 thinking: {"type":"disabled"} 关掉。 | 用 effort 控制思考深度。 |
| 拒答 | API 可能 HTTP 200,但 stop_reason 是 refusal。 | 业务代码要单独处理拒答。 |
| 回退 | 高风险任务会回退到 Opus 4.8。 | 可以用 fallbacks 参数或 SDK middleware。 |
| 工具能力 | 支持 effort、task budgets、memory tool、context editing、compaction、vision。 | 部分能力需要 beta header。 |
| 数据治理 | 30 天留存会影响 ZDR 和合规团队。 | 上线前先过合规和安全评审。 |
7. X 上大家在聊什么
❗ 提醒:X 上的信息适合作为舆情线索。涉及参数量、内部 checkpoint、未公布成绩等内容,优先以 Anthropic 官方和后续实测为准。
↔ 左右滑动查看完整表格| 线索 | 来源 | 白话解释 |
|---|
| Dev Mode 发现 Mythos 5 slug | TestingCatalog | 发布前几天,社区已经从开发工具里看到 Claude Mythos 5 的命名。 |
| Fable 5 checkpoint 线索 | scaling01 | 社区开始猜 Fable 5 会成为公开版 Mythos。 |
| 第一批直播测试 | BridgeMind | 开发者想第一时间用真实构建任务试它。 |
| 预算与使用限制 | Matthew Miller | 大家担心 Max 计划和 API 限额是否够烧。 |
| 中文社区传播 | BlockBeats Asia | 中文圈主要关注长上下文、复杂推理和多轮任务。 |
| Benchmark 讨论 | Dan McAteer | 开发者最关心它在 SWE-Bench Pro、FrontierCode 这类 coding benchmark 上到底多强。 |
8. 外部媒体怎么解读
↔ 左右滑动查看完整表格| 来源 | 他们在强调什么 | 怎么读 |
|---|
| The Verge | 这是 Anthropic 第一个广泛发布的 Mythos-class 模型,95% 会话无回退。 | 适合看公众发布和价格定位。 |
| Business Insider | 强调安全防护、Project Glasswing、IPO 和监管背景。 | 适合看商业和政策语境。 |
| Axios | 关注“强能力模型如何通过 guardrails 进入公众可用”。 | 适合给老板做高层摘要。 |
| arXiv: Benchmarking Mythos-Linked Bug Rediscovery | 外部论文提醒:公开模型在复现 Mythos 相关漏洞时效果有限。 | 读这条能避免把官方内部工作流和外部可复现能力混为一谈。 |
| Hacker News | 技术社区有兴奋,也有质疑。 | 适合看开发者的真实疑虑。 |
9. 哪些信息先别当成事实
10. 我们应该怎么用
为什么我有编辑权限呢?
↔ 左右滑动查看完整表格| 场景 | 建议 | 为什么 |
|---|
| 大型代码迁移 | 优先试 Fable 5,但必须配测试和 review。 | 官方案例最强的部分就在长周期工程任务。 |
| 知识工作、金融、法务 | 把 Fable 5 放在高价值任务上,用人工复核收尾。 | 它擅长读大量材料和做复杂分析,但仍需审核。 |
| 网络安全研究 | 普通团队先用 Claude Security 或 Opus 4.8;获批团队申请 Mythos 5。 | Fable 5 对高风险安全请求会回退。 |
| 生命科学 | 等待 trusted access 细则。 | Fable 5 当前对多数生物化学请求回退。 |
| ZDR / 合规团队 | 上线前确认 30 天留存、云平台、审计要求。 | 这是 covered model,原来的 ZDR 预期需要重新评估。 |
| 成本敏感任务 | 先用便宜模型粗筛,再把 Fable 5 用在关键步骤。 | \$10 / \$50 per MTok 不适合无脑全量跑。 |
11. 白话案例库
📝 怎么看下面这些案例:有些是官方明确写出来的,有些是官方转述客户早测反馈,有些是社区线索。每条都保留链接,方便回查。
11.1 开发者与产品构建
↔ 左右滑动查看完整表格| 案例 | 白话版 | 对我们的启发 |
|---|
| Stripe:5000 万行 Ruby 迁移 | 在超大 Ruby 代码库里做全局迁移。官方说一天完成,原本人工要两个多月。 | 适合测框架升级、API 替换、类型系统改造,但一定要用测试兜底。 |
| CursorBench:长周期代码任务 | Cursor 用自己的 benchmark 测它,反馈是 Fable 5 达到 SOTA。 | 适合测跨文件、多步骤、会中途修正的 IDE agent。 |
| GitHub:软件生命周期 agent | GitHub 关注它能否承担更完整的开发流程,早测反馈很强。 | 可以按 issue triage、实现、测试、PR 描述、review 修复拆开测。 |
| Figma / Developer Experience:原型与 agentic coding | 从设计意图生成工程原型,Figma 相关负责人反馈这是他们测过最强的 Claude。 | 可测“设计稿到组件代码”的完整流程。 |
| Lovable:少提示词应用生成 | 以前可能要提示上百轮的应用,现在可能一轮就能出来可用版本。 | 重点测首轮可用率、错误自检、UI 完整度。 |
| Replit ViBench:端到端网页应用 | Replit 说它在完整网页应用生成上表现最好,速度更快、token 更少。 | 真实测试要包含登录、数据模型、错误态、部署和回归修复。 |
| 内部多 agent 工作流 | 早测反馈称它在复杂多 agent 工作流里轮次更少、质量更高。 | 适合测任务拆分、共享上下文、冲突修复和最终验证。 |
11.2 知识工作、金融、法律、数据分析
↔ 左右滑动查看完整表格| 案例 | 白话版 | 对我们的启发 |
|---|
| Hebbia Finance Benchmark | 高级金融分析场景里,它要读文档、看图表、理解复杂问题。官方称 Fable 5 得分最高。 | 适合用财报、招股书、投资备忘录做中文复测。 |
| IMC 交易分析评测 | IMC 测的是交易分析,包含事实查询、根因、期望值判断。反馈是几乎全线通过。 | 可用“事件影响、风险场景、expected value”模板测试。 |
| 法律 redline 盲审 | 律师盲审合同修改,Fable 5 的 redline 每次匹配或超过当前模型。 | 可测合同条款修改、风险标签、谈判版本差异。 |
| Hex 核心分析 benchmark | Hex 反馈 Fable 5 首个突破 90%,比 Opus 高 10 分,难题上细节更好。 | 适合测 BI 分析、SQL 修正、指标定义和异常解释。 |
| 日常 spreadsheet suite | 表格任务里,Fable 5 在每个 effort level 都超过 Opus 4.8,速度快 25% 到 30%。 | 可测预算表、销售漏斗表、财务模型和公式正确性。 |
| 前沿物理研究 | 早测反馈称 Fable 5 用约三分之一 reasoning tokens,36 小时接近 GPT-5.5 四天结果。 | 适合测研究假设、推导、反例检查和文献比对。 |
11.3 视觉、长任务、交互
↔ 左右滑动查看完整表格| 案例 | 白话版 | 对我们的启发 |
|---|
| Pokémon FireRed 视觉通关 | 只看游戏截图,没有地图和额外状态,它能长期规划并通关。 | 说明它适合低辅助视觉 agent,可测桌面操作和复杂网页调试。 |
| Slay the Spire 长期记忆 | 给它持久文件记忆后,策略提升很明显,进入最终章节频率更高。 | 适合测 memory tool:写笔记、复盘失败、改策略。 |
| 截图重建网页源码 | 它可以从截图理解布局和组件,再重建 web app source code。 | 可用 Playwright 截图对比来量化效果。 |
| 太阳系与日食模拟 | 从第一性原理做行星运动模拟,还能预测日食。 | 适合测科学计算、可视化和解释。 |
| Factorio 自动化工厂 | 它能在 Factorio 里规划资源、搭生产线、持续优化。 | 可映射到业务流程自动化和瓶颈优化。 |
| VibeCAD 3D 打印模型 | 先做 CAD 编辑器,再在工具里生成 3D 可打印模型。 | 适合测“先造工具,再用工具做作品”的能力。 |
| 流体模拟 + 古典 EDM | 写流体模拟代码,还能配合音乐节奏做视觉效果。 | 适合测多模态创作、代码和时序控制。 |
11.4 Mythos / Project Glasswing 安全案例
↔ 左右滑动查看完整表格| 案例 | 白话版 | 对我们的启发 |
|---|
| 50 个初始伙伴发现 1 万+ 高危 / 严重漏洞 | 约 50 个伙伴用 Mythos Preview 扫关键软件,发现超过 10,000 个 high 或 critical 问题。 | 漏洞发现效率大幅提高,后面的验证和修复流程要跟上。 |
| Mozilla Firefox 150 | Mozilla 用 Mythos Preview 测 Firefox 150,发现并修复 271 个漏洞。 | 成熟软件项目也能从 AI 安全扫描里获益。 |
| UK AISI cyber ranges | UK AISI 用多步骤攻击模拟环境测它,Anthropic 转述称 Mythos Preview 是首个完成两套 cyber ranges 的模型。 | 这说明它能处理多步骤安全任务,风险等级也更高。 |
| XBOW Web exploit benchmark | XBOW 说 Mythos Preview 在 web exploit 测试里 token-for-token 精度非常强。 | 不要只看能不能成功,也要看单位成本效率。 |
| 开源项目大规模扫描 | Anthropic 扫 1000+ 开源项目,发现 23,019 个问题,其中 6,202 个被模型估为高危或严重。 | 安全团队要准备 triage 队列、披露模板、补丁验证流程。 |
| wolfSSL 证书伪造漏洞 | Mythos Preview 帮助证明 wolfSSL 存在证书伪造漏洞,已修复并分配 CVE-2026-5194。 | 密码库这类高价值项目也可能进入 AI 辅助审计时代。 |
| 银行欺诈转账拦截 | 某 Glasswing 银行伙伴识别并阻止 150 万美元欺诈电汇。 | AI 安全价值也覆盖反欺诈和威胁响应。 |
| 公开版 Claude Security | Claude Security 公测三周内,用 Opus 4.7 修复超过 2,100 个漏洞。 | 普通企业可以先用公开安全产品建立流程。 |
| Glasswing 扩展到 150 个新组织 | 新增约 150 个关键组织,行业覆盖电力、水务、医疗、通信、硬件等。 | Mythos 的访问策略明显围绕关键基础设施和系统性风险展开。 |
11.5 生命科学与科研案例
↔ 左右滑动查看完整表格| 案例 | 白话版 | 边界 |
|---|
| 药物设计候选蛋白 | Mythos 5 能自己选 binding sites、选工具、跑 bioinformatics 和 protein design,官方称部分流程加快约 10 倍。 | 这类能力风险高,普通 Fable 5 会回退,建议等 trusted access。 |
| 分子生物学新假设 | 官方盲测中,内部科学家约 80% 更偏好 Mythos 生成的机制假设。 | 需要湿实验验证,公开细节还不完整。 |
| 跨物种单细胞基因组学 | Mythos 5 整理 138 个动物物种、数百万细胞数据,并训练自定义 ML 模型。 | 官方说未来数月发布结果,现在先当强线索记录。 |
| AAV viral shell property prediction | 模型没有为这个任务显式训练,却能预测 AAV 外壳未公开实验性质。 | 正面用途强,双重用途风险也高。 |
12. 我们可以怎么复测
↔ 左右滑动查看完整表格| 方向 | 任务 | 看什么指标 | 注意点 |
|---|
| 大型代码迁移 | 选真实 repo,做 API 替换、依赖升级或模块迁移。 | 测试通过率、diff 可读性、回归数量、人工 review 时间。 | 必须有版本控制和自动化测试。 |
| 截图到前端实现 | 给真实产品截图,让它生成可运行页面,再用 Playwright 截图对比。 | 视觉相似度、响应式、状态覆盖、可维护性。 | 要测移动端和边界状态。 |
| 数据分析 agent | 给 CSV / 表格 / 业务背景,让它定义指标、写查询、解释异常。 | 结论正确性、SQL / 公式正确性、引用可追溯性。 | 防止幻觉引用和指标口径漂移。 |
| 合同 redline | 给中英文合同条款,让它标风险、改措辞、给谈判策略。 | 风险覆盖率、修改理由、术语准确性、可执行性。 | 需要律师复核。 |
| 长期 agent 任务 | 让模型用文件记忆完成多轮研究或游戏策略复盘。 | 笔记是否有效、是否能纠错、是否减少重复失败。 | 要限制预算和步骤。 |
| 安全扫描流程 | 用公开模型或 Claude Security 扫自有代码并生成修复建议。 | 真阳性率、复现成本、补丁可合并率。 | 高风险安全任务会触发 Fable 回退,要遵守披露流程。 |
13. 来源索引
- Anthropic 官方发布:Claude Fable 5 and Claxude Mythos 5
- Claude API Docs:Introducing Claude Fable 5 and Claude Mythos 5x
- Claude API Docs:Models overview
- Claude Help Center:Data retention practices for Mythos-class models
- Anthropic:Project Glasswing
- Anthropic:Project Glasswing initial update
- Anthropic:Expanding Project Glasswing
- Mozilla:AI security zero-day vulnerabilities
- UK AISI:Evaluation of Claude Mythos Preview cyber capabilities
- XBOW:Mythos offensive security evaluation
- wolfSSL:How Claude Mythos Preview helped harden wolfSSL
- Claude Security
- Hebbia:Which model will give me the edge
- The Verge:Anthropic releases Claude Fable
- Business Insider:Anthropic releases Claude Fable 5
- Axios:Anthropic releases Claude Mythos-level model
- arXiv:Benchmarking Mythos-Linked Bug Rediscovery
- Hacker News:Project Glasswing discussion
大家的案例收集
测试By @ 差评君
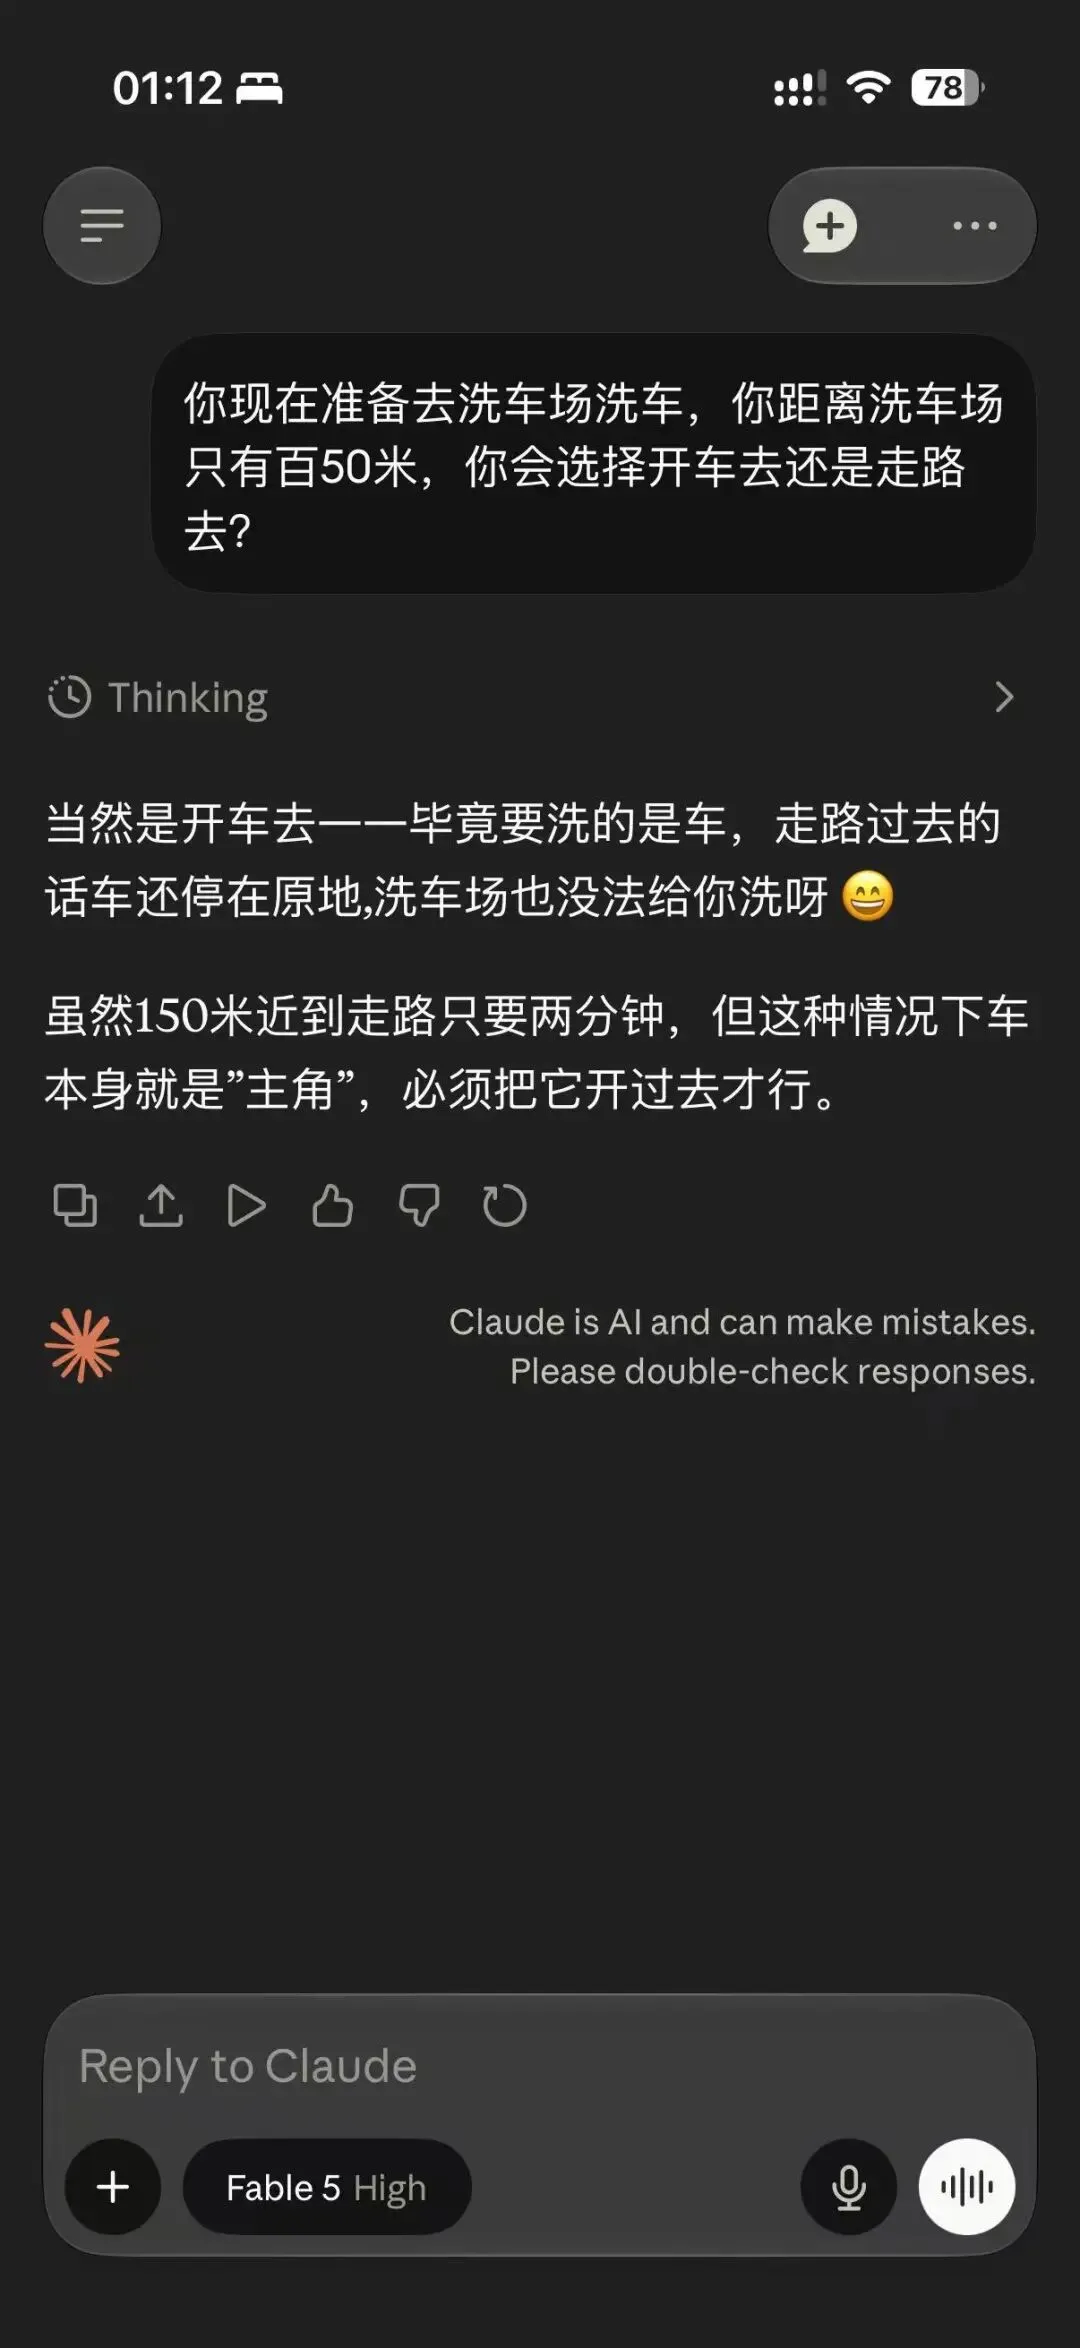
- 150 米洗车问题
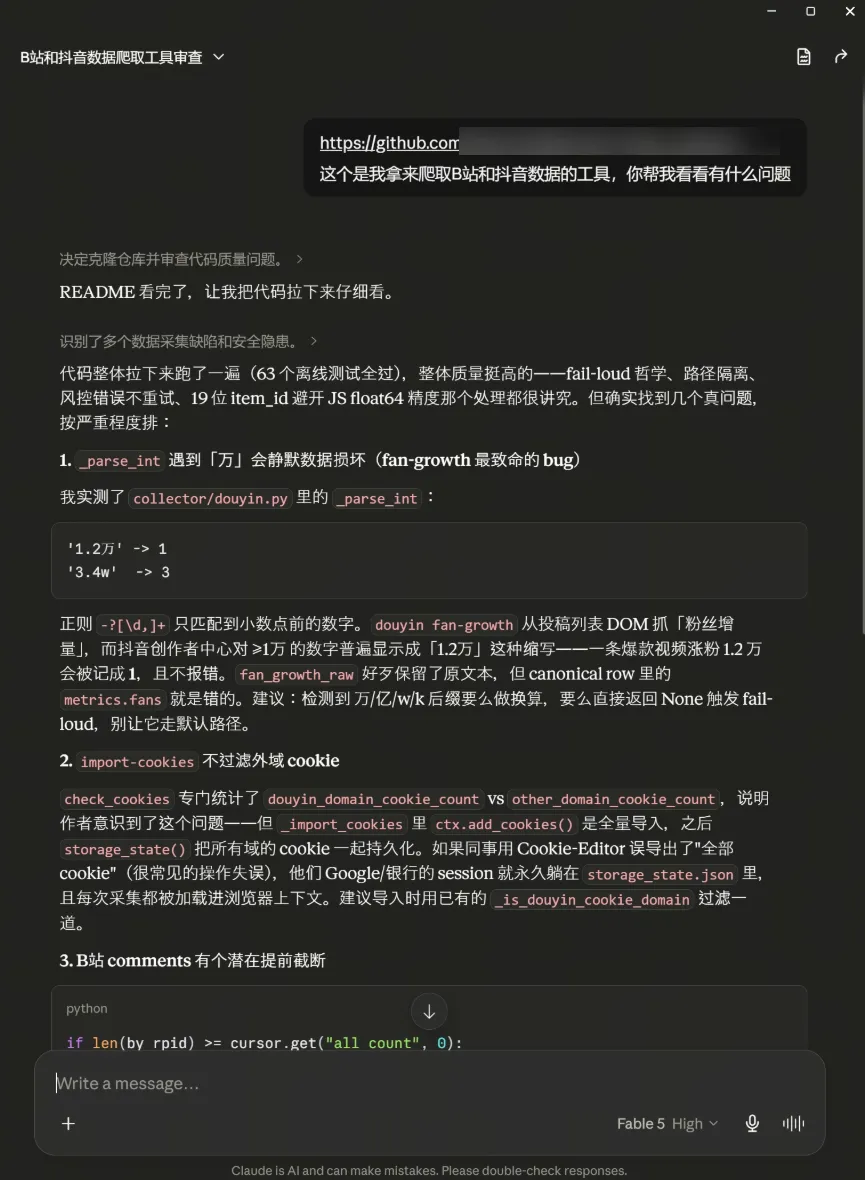
- 之前用 GPT5.5 做的项目,看起来也是毫无压力。
- 生成一群旋转小球
同样一段提示词出来,让 Fable 5 和 GPT 5.5 一起跑了下。
编写一个 Python 程序,展示一个球在旋转的六边形内弹跳,六边形中只有五边是墙壁,其中一边是可通过的,小球碰到墙壁的时候自动分裂成两个,或者是穿过可通过的边界掉落到地图外面,球的运动轨迹应受到重力的影响,并且必须真实地反弹到旋转的墙壁上。
在界面的左下角显示总共生成的小球数量,当所有小球都掉落到界面外面的时候,游戏结束,玩家可以重新开始游戏。
两边都能帮我一次性的解决问题。
广告
相比之下,CodeX 做出来的界面更加花里胡哨一些,不但把六边形的边框弄厚了,还给那些随机弹跳的小球加了拖尾。
但是 CodeX 自作聪明的给小球生成的总数加了上限,再一次游戏中,累计生成了 220 个小球后,就会让小球不再分裂。
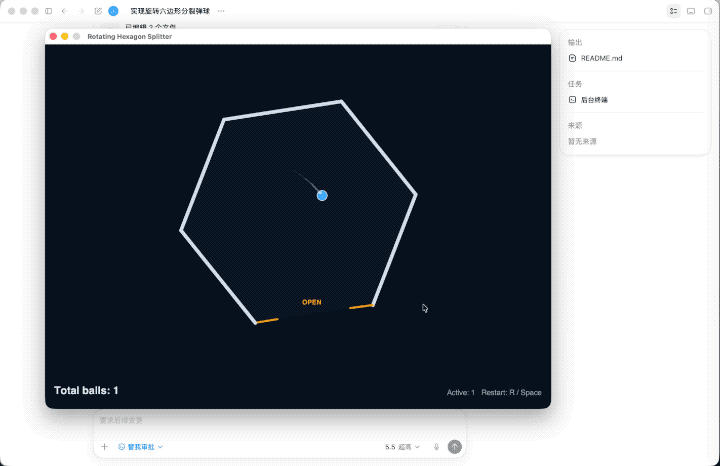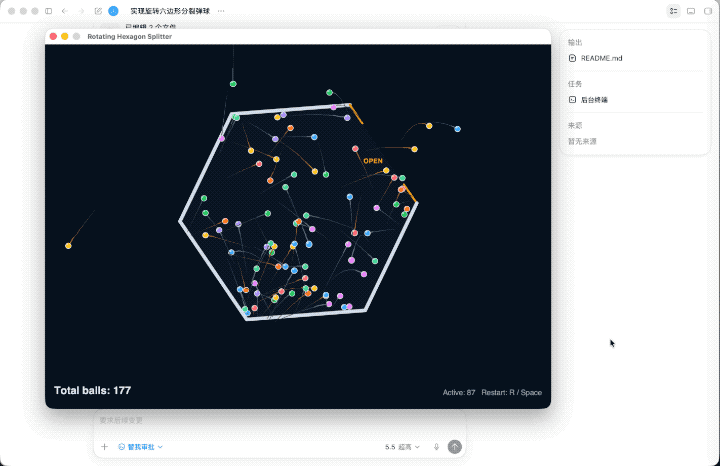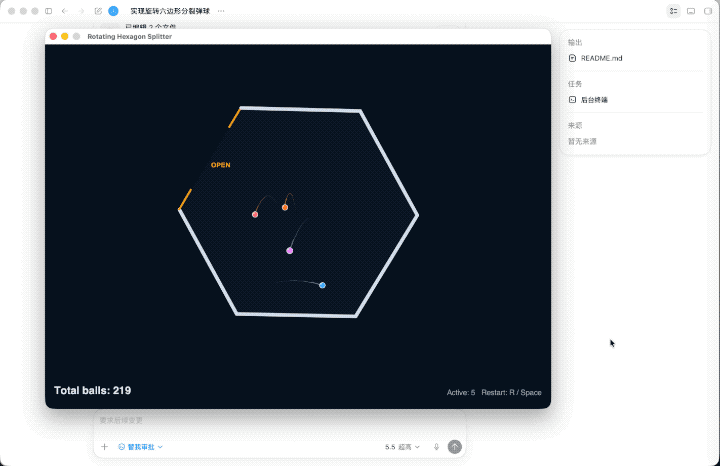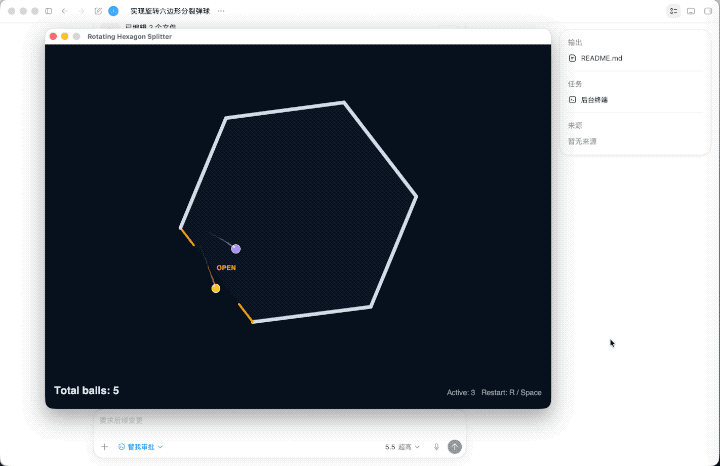
这就导致这些小球很快都会掉光,游戏直接 GameOver。
而 Claude Fable 5 这边做的则是稳妥的多了,同样是为了防止程序卡死,Fable 5 这边限制的是屏幕里“当前小球” 的数量。
当小球掉下去后就会自动重新生成,让游戏继续进行。
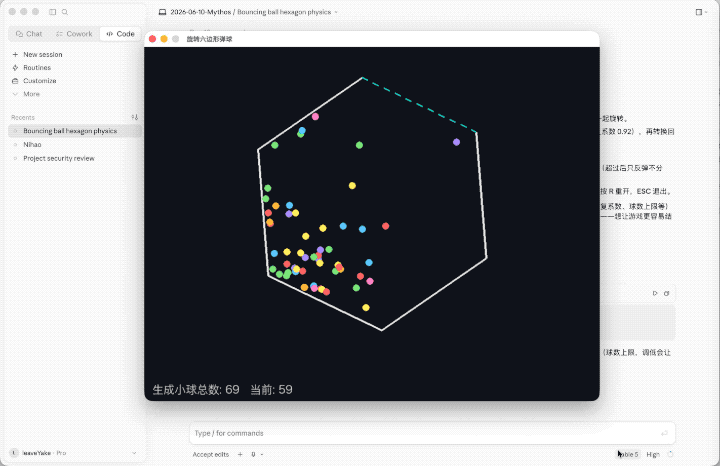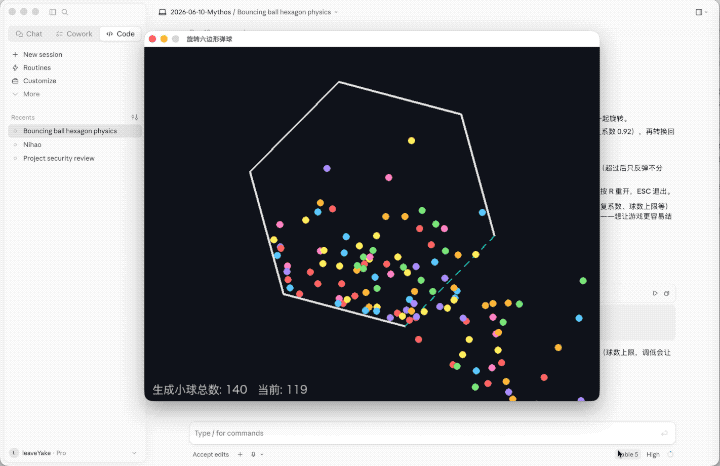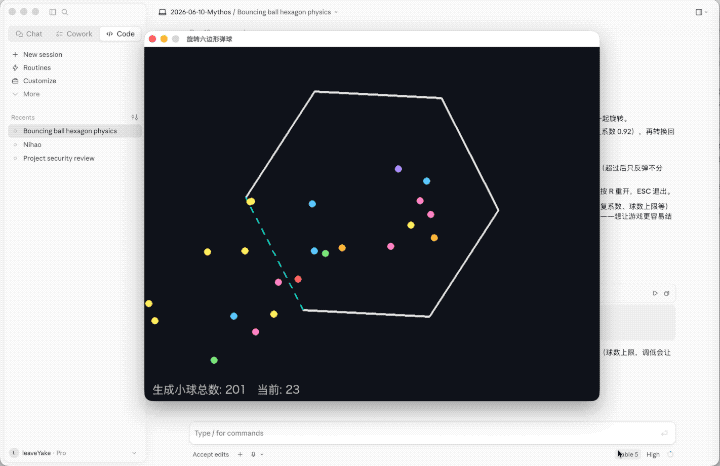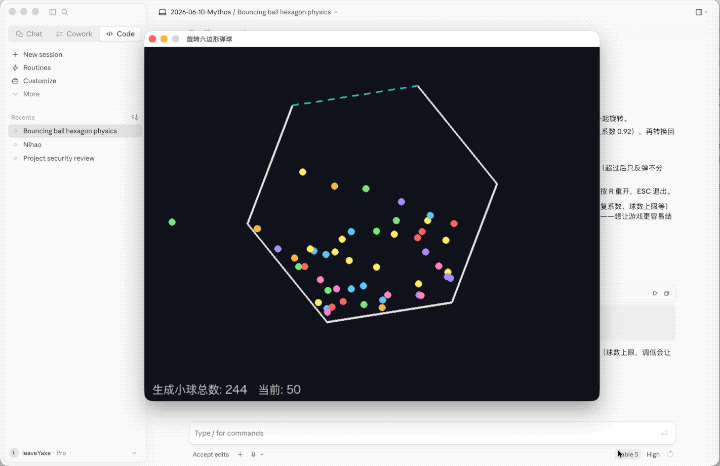
虽然画风看起来不如 CodeX 炫酷,但至少活做起来没出错。
来源与版权
本文来源:飞书文档,由凡哥 AI 知识库收录整理,仅供学习参考。版权归原作者所有。如有版权问题,请联系我们。
原文链接

