
大多数 AI 教程一上来就是代码。
它们跳过了真正重要的部分。
概念。
于是你做出了一个半好不坏的聊天机器人。你不知道它为什么会有幻觉,不知道上下文窗口到底是什么意思,也不知道为什么你的 RAG 系统会返回错误文档。
你是在摸黑调试。
下面是每个开发者在写第一行代码前都必须理解的 10 个 AI 概念。
先收藏。它会帮你省下好多时间。
1. Token:AI 实际读取的东西
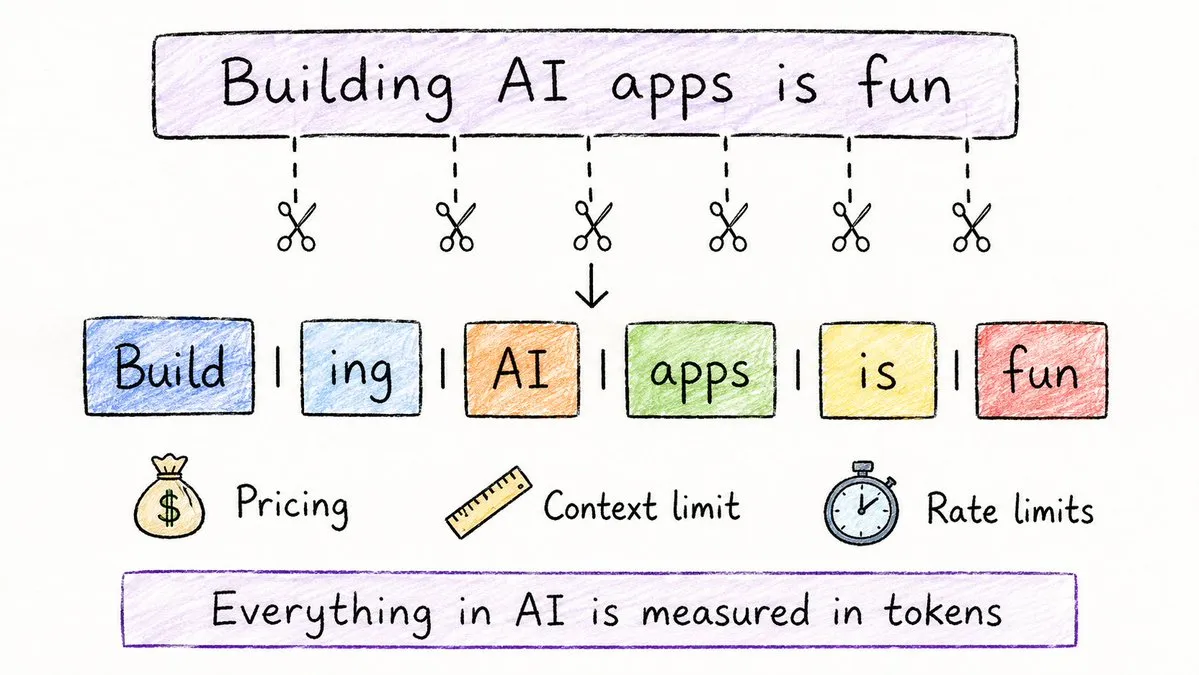
你写下一句话。模型看到的不是一句话。
它看到的是 token。
token 是一小段文本。
→ 有时是一个完整单词:build → 1 个 token
→ 有时是单词的一部分:building → build + ing → 2 个 token
→ 有时是标点:. → 1 个 token
Building AI apps is fun → 6 个 token
为什么这对开发者很重要:
AI 里的所有东西,几乎都是按 token 定价、限制和计量的。
→ API 成本 = 每 1,000 个 token 的价格
→ 上下文窗口 = 一次请求中最多能放多少 token
→ 速率限制 = 每分钟可用多少 token
一旦你理解了 token,就不会再困惑于:
→ 为什么你的提示词被截断
→ 为什么 API 账单比预期更高
→ 为什么模型“忘记”了你之前说过的话
经验法则:1,000 个 token 大约等于 750 个英文单词。
2. Embedding:AI 如何理解语义
文本变成 token 之后,还会变成数字。
这些数字叫做向量。
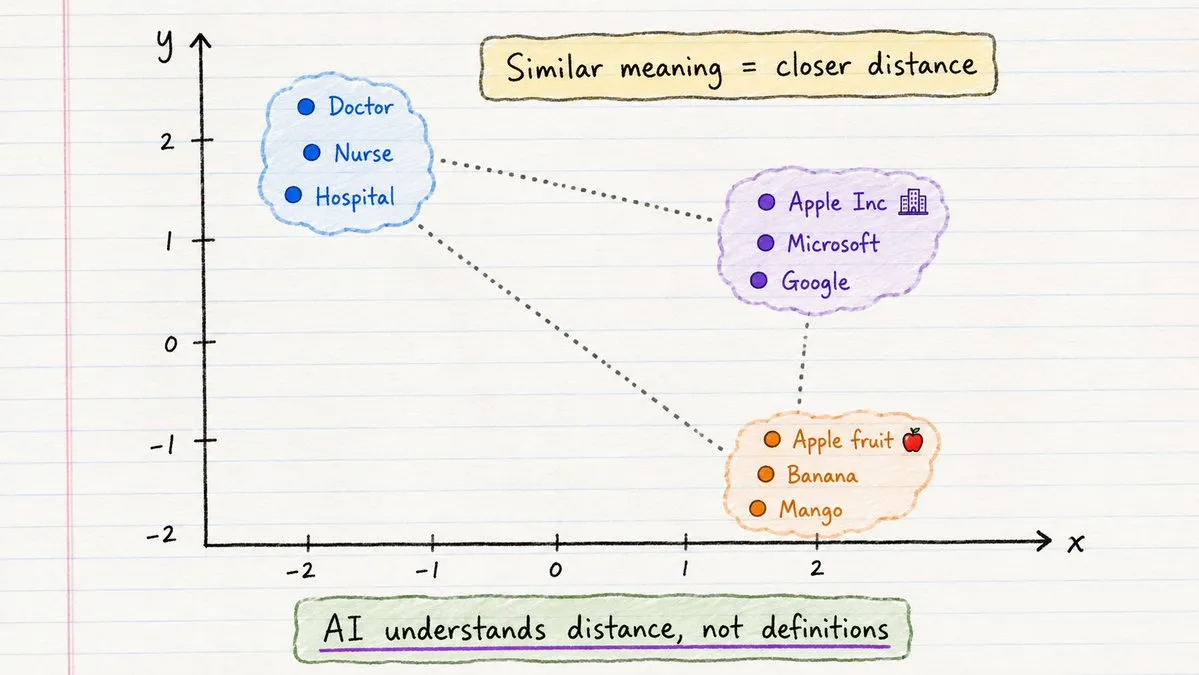
每个单词、句子或文档,都会被转换成一个向量,也就是一长串代表其语义的数字。
关键洞察是:
语义相似 = 数字相似 = 在空间中距离更近。
→ Doctor 会靠近 Nurse
→ “作为水果的 Apple”会离“作为公司的 Apple”很远
→ King 减去 Man 加上 Woman,大致接近 Queen
AI 理解语义的方式和你不同。
它理解的是距离。
为什么这对开发者很重要:
所有“理解意图”的能力,底层都离不开向量:
→ 语义搜索:找的是语义,不只是关键词
→ 推荐系统:寻找相似项目
→ RAG 系统:寻找相关文档
→ 和 PDF 聊天:把你的问题匹配到正确页面
如果你的搜索返回了错误结果,通常应该先检查向量模型。
3. Attention:AI 如何理解上下文
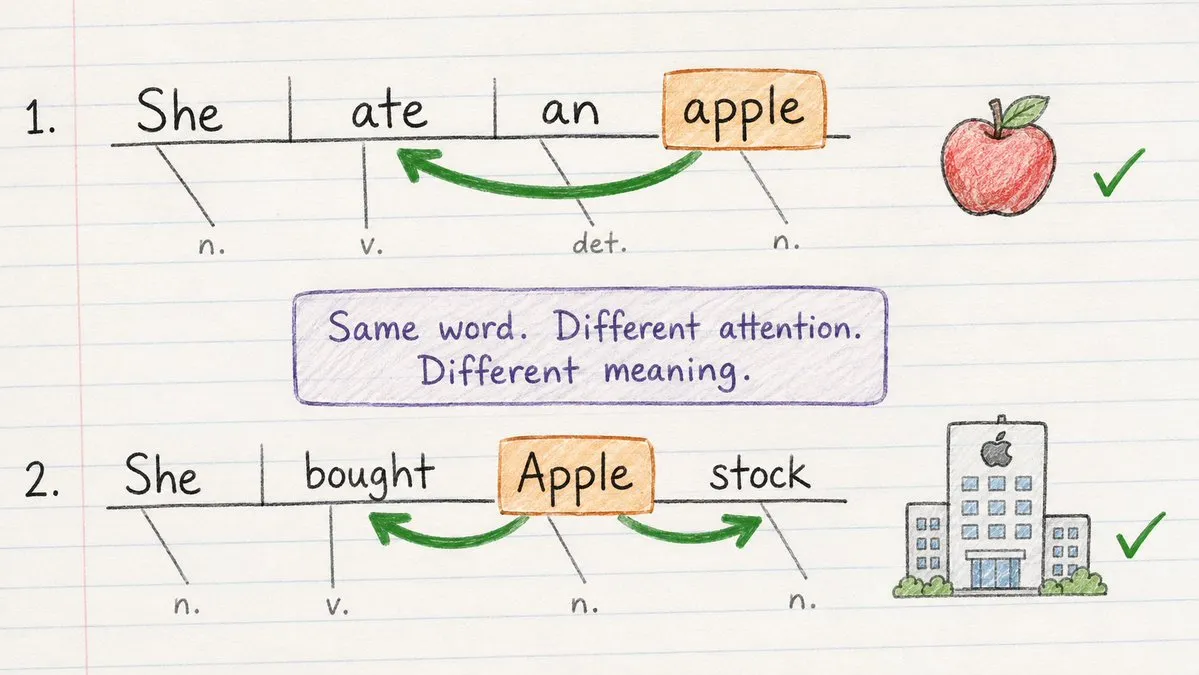
同一个词,语义可以完全不同。
→ She ate an apple → 水果
→ She bought Apple stock → 公司
模型怎么知道是哪一种?
靠注意力机制。
注意力机制让每个词都能查看句子里的其他词,并判断哪些最重要。
它不是从左到右机械阅读,而是一次看到整句话,并动态连接线索。
在 She bought Apple stock 里:
→ Apple 会高度关注 bought 和 stock
→ 模型推断:这里指公司
在 She ate an apple 里:
→ apple 会高度关注 ate
→ 模型推断:这里指水果
在 attention 之前,模型逐词读取,速度慢,而且容易错过远距离关联。
有了 attention 之后,模型可以一次看到整体。
这个单一想法,就是AI 能够工作的原因。
为什么这对开发者很重要:
理解 attention,可以解释这些现象:
→ 当上下文清楚时,模型能很好地处理长提示词
→ 含糊的提示词会产生不稳定输出
→ 给提示词补充上下文,会显著改善结果
4. Transformer:一切背后的引擎
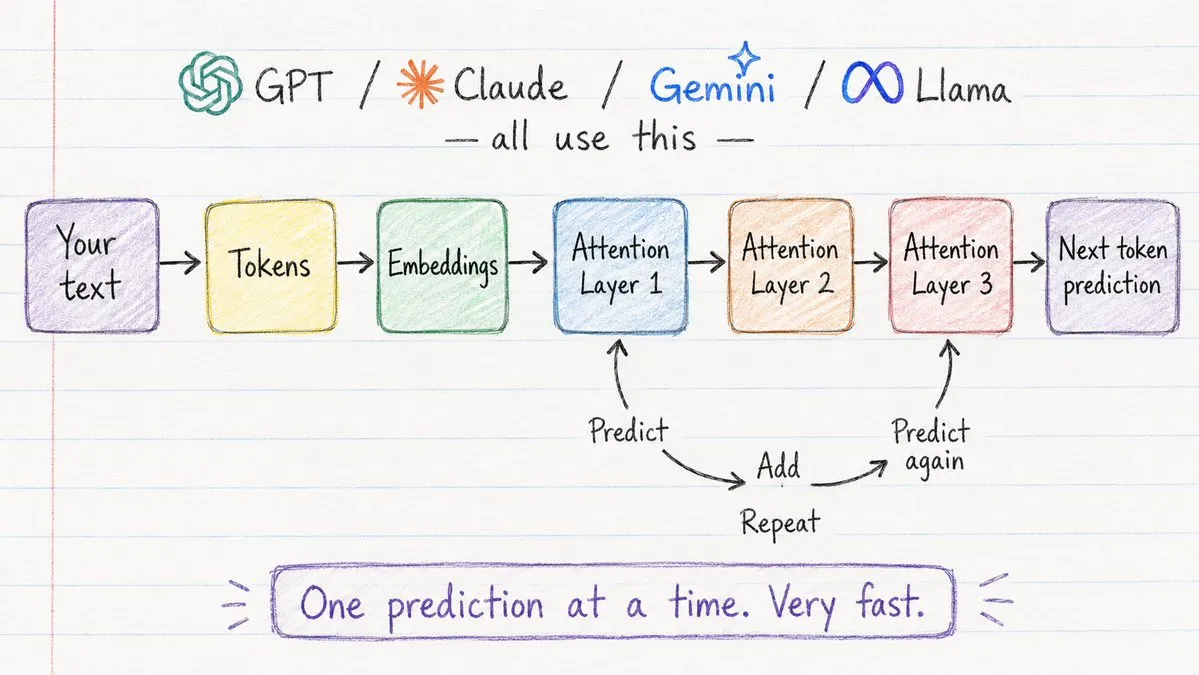
GPT、Claude、Gemini、Llama、Mistral。
它们都是 transformer。
transformer 是你会用到的几乎所有现代 AI 模型底层的架构。
它的流程可以简化为:
文本 → token → embedding → attention 层 → 预测
模型不是一次生成完整句子。
它一次预测一个 token。
→ 预测下一个 token
→ 把它加入序列
→ 再次预测下一个 token
→ 不断重复
这个循环每秒运行数十亿次,最终生成你看到的文本。
为什么这对开发者很重要:
理解 transformer 流程,可以解释:
→ 为什么输出越长,耗时越长:预测循环更多
→ 为什么模型具有“非确定性”:每一步都是概率选择
→ 为什么前面的 token 会影响后面的 token
→ 为什么在思路中间截断上下文会破坏输出质量
你不需要亲手构建一个 transformer。你需要理解自己正在调用的盒子里发生了什么。
5. LLM:它到底是什么
LLM 是一种在海量文本上训练出来的 transformer,它只做一件事:
预测下一个 token。
仅此而已。
训练数据包括:书籍、网站、代码、维基百科、Reddit、文档。
规模是数万亿 token。
训练任务听起来简单,似乎不足以解释这些模型能做的事:
→ 看到文本
→ 预测接下来会出现什么
→ 检查预测是否正确
→ 轻微调整权重
→ 重复数万亿次
结果是:模型深度学会了人类语言的模式,所以它能写代码、推理问题、翻译语言,并解释复杂概念。
这些能力都不是被显式编程进去的。
它们是在大规模下一个 token 预测中涌现出来的。
开发者最重要的一点认知是:
LLM 不是数据库。它不会查找答案。它会根据模式预测答案。
这个区别解释了一切,包括它为什么会产生幻觉。
6. Hallucination:AI 为什么会自信地说错
这件事一定会在生产环境里发生。
用户向你的 AI 应用提问。AI 给出一个自信、结构良好、但完全错误的答案。
这就是幻觉。
原因在这里。
模型并不是在努力讲真话。
它是在努力预测概率最高的下一个 token。
如果一个错误陈述基于训练模式看起来像是“接下来应该出现的内容”,模型就会生成它。没有验证,没有查询,只有模式补全。
它会:
→ 引用不存在的论文
→ 描述从未创建过的 API 函数
→ 用十足信心给出虚假的统计数据
→ 编造听起来合理但错误的代码
危险之处在于:它听起来从不犹豫。
开发者应该怎么处理:
→ 使用 RAG:获取真实数据,不要依赖模型记忆
→ 在向用户展示输出前加入验证层
→ 使用工具调用:让模型检查,而不是猜测
→ 生产环境中的事实性内容,不要在没有检查的情况下直接使用原始 LLM 输出
7. Temperature:创造力旋钮
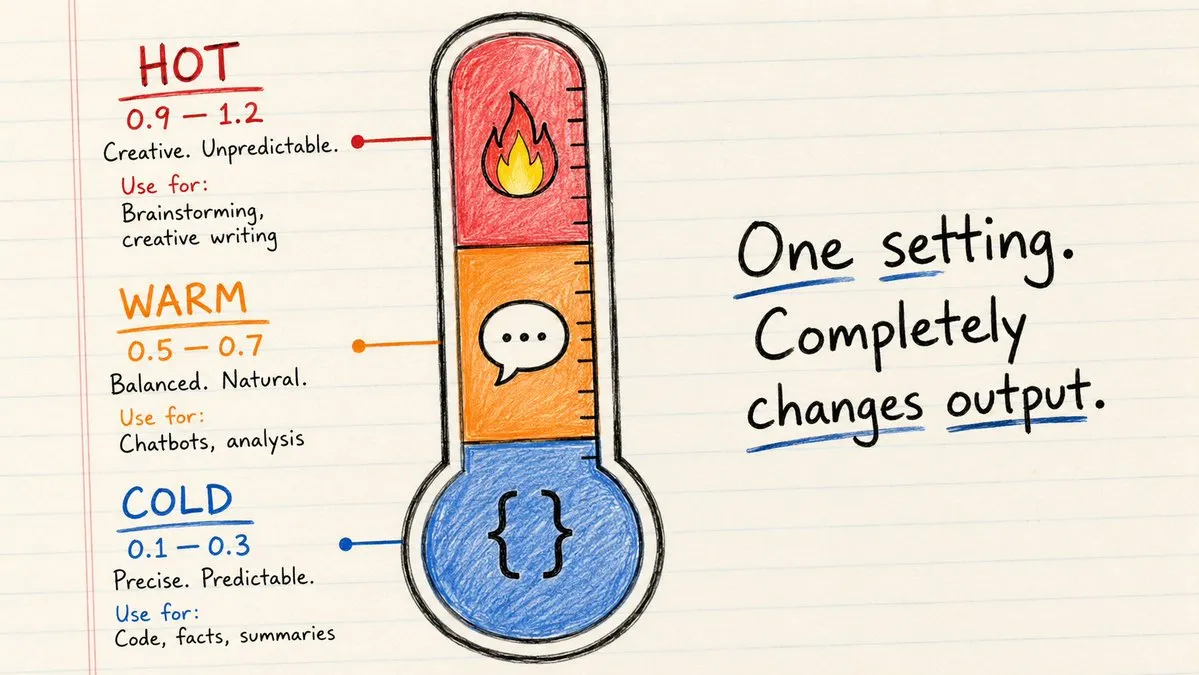
AI 每生成一个 token,都会为所有可能的下一个词计算概率。
temperature 控制接下来会发生什么。
→ 低 temperature:几乎总是选择最可能的 token。安全、可预测。
→ 高 temperature:从概率分布中更随机地选择。更有创意、更多变化。
开发者可以参考的设置:
| 用例 | Temperature |
|---|---|
| 写代码 | 0.1-0.2 |
| 事实问答 | 0.2-0.3 |
| 摘要 | 0.3-0.5 |
| 聊天机器人回复 | 0.5-0.7 |
| 创意写作 | 0.8-1.0 |
| 头脑风暴 | 1.0+ |
多数初学者最常犯的错误:
所有场景都使用默认 temperature,通常是 0.7-1.0。
然后困惑为什么自己的代码助手写出了很有创意但坏掉的代码。
temperature 只是一行代码。请有意识地设置它。
8. Context Window:AI 的工作记忆
每个 AI 模型一次只能“看到”固定数量的文本。
这个限制就是上下文窗口。
它包含一次请求里的所有内容:
→ 你的 system prompt
→ 对话历史
→ 你传入的文档
→ 模型自己的回复
→ 你当前的消息
所有内容加在一起,都必须放进这个窗口。
当前限制:
→ GPT-4o:128,000 个 token
→ Claude 3.5 Sonnet:200,000 个 token
→ Gemini 1.5 Pro:1,000,000 个 token
更大听起来更好。但有个问题。
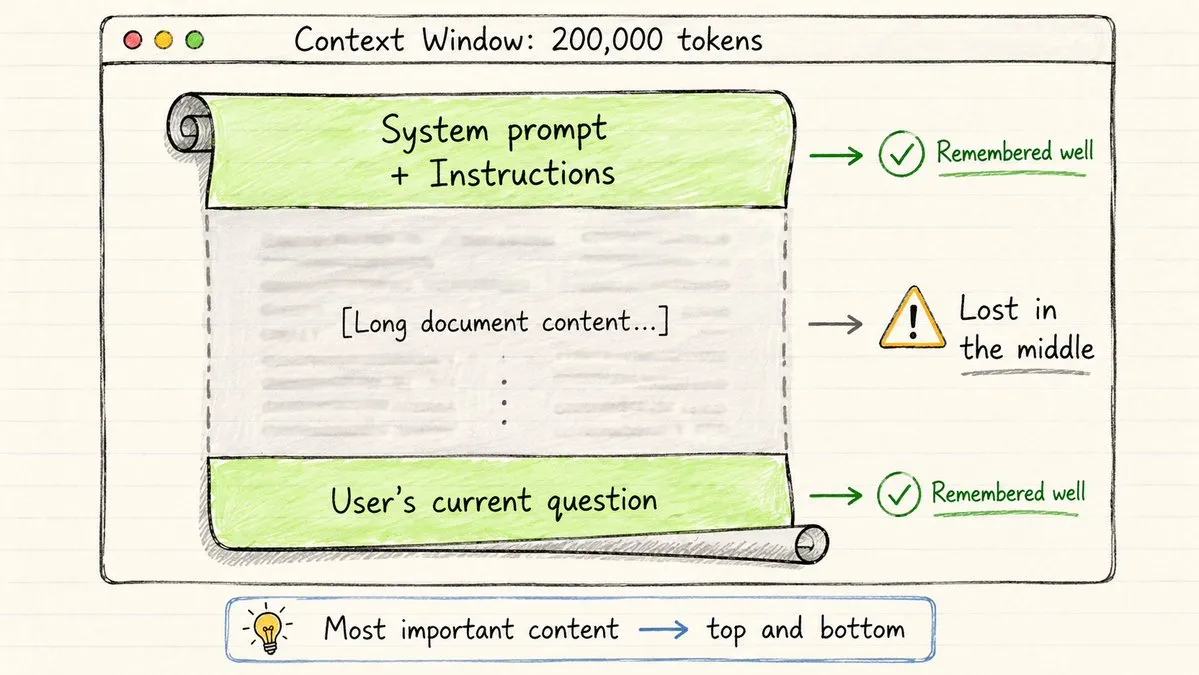
模型并不会均匀阅读上下文。
它会更多关注开头和结尾。
中间部分呢?经常被忽略。
这叫作“Lost in the Middle”问题。
这对开发者意味着:
→ 把最重要的指令放在 system prompt 顶部
→ 把最重要的上下文放在用户问题之前
→ 不要因为你放进去了,就假设模型一定“看见”了
→ 对长文档做切块和摘要,而不是整篇塞进去
上下文管理是 AI 工程中最重要的技能之一。
9. RAG:AI 如何使用你的数据
LLM 的训练数据只覆盖到某个截止日期。
它们不知道:
→ 你公司的内部文档
→ 上周的新闻
→ 你的产品文档
→ 你的用户数据
RAG 解决这个问题。
RAG = Retrieval-Augmented Generation,检索增强生成。
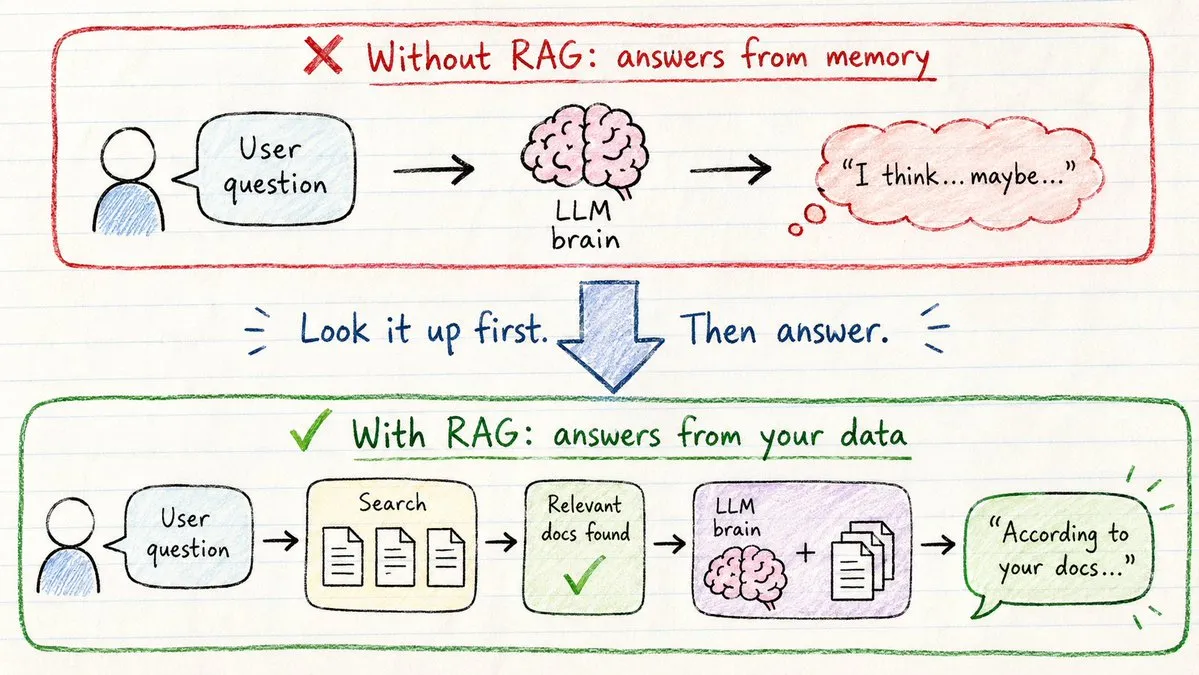
模型不再只凭记忆回答,而是先搜索知识库,再基于找到的内容作答。
每个开发者都需要知道这个流程:
- 用户提出问题
- 问题 → 向量 → 搜索向量数据库
- 取回最相关的文档
- 文档 + 问题一起发送给模型
- 模型使用真实、具体的数据作答
为什么对多数用例来说,RAG 比微调更合适:
→ 你的数据变了?只要更新文档,不需要重新训练。
→ 需要来源引用?文档就在手边。
→ 可以大幅减少幻觉。
→ 可以用于不应进入训练数据的私有数据。
你用过的每个专业的AI产品,底层几乎都有 RAG。
客服机器人、文档助手、法律工具、内部知识库。
如果今年只学一种架构模式,就学 RAG。
10. AI Agent:真正会做事的 AI
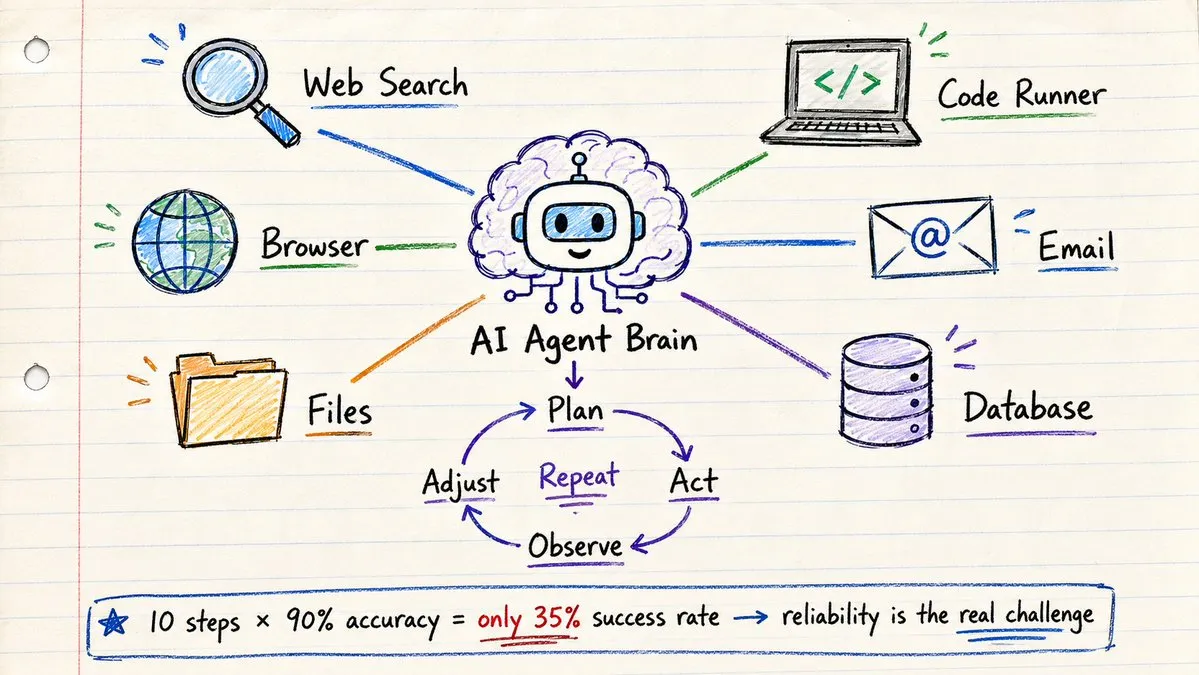
标准 LLM:
→ 你提问,它回答,结束。
AI Agent:
→ 你给目标,它规划,使用工具,检查结果,调整,完成任务。
差别在于一个循环。
智能体循环:
- 理解目标
- 决定下一步做什么
- 使用工具执行
- 检查发生了什么
- 决定下一步
- 重复,直到完成
智能体可以使用哪些工具?
→ 网页搜索
→ 代码执行
→ 文件读写
→ API 调用
→ 数据库查询
→ 邮件和日历
→ 浏览器控制
真实例子:调试智能体。
→ 读取错误
→ 在代码库中搜索相关文件
→ 识别问题
→ 写出修复
→ 运行测试
→ 发现仍有 2 个测试失败
→ 阅读失败测试
→ 调整修复
→ 再次运行
→ 所有测试通过
→ 完成
模型是大脑,工具是双手。
对开发者来说,智能体难在哪里:
每一步都有失败率。三步,每步 90% 准确率,任务完成率是 72.9%。十步则是 34.8%。
这就是为什么可靠性工程才是智能体真正的挑战,而不是构建智能体本身。
如果你从零开始,建议按这个顺序学习:
→ 1. Token:理解所有东西被计量的单位
→ 2. Embedding:理解语义如何变成数字
→ 3. Attention:理解上下文如何工作
→ 4. Transformer:理解架构
→ 5. LLM:把前面所有概念连起来
→ 6. Hallucination:理解核心失败模式
→ 7. Temperature:学会控制输出风格
→ 8. Context Window:学会管理记忆
→ 9. RAG:学会使用自己的数据
→ 10. Agent:学会构建能够行动的系统
这是一套完整的 AI 工程心智模型。
一旦你理解这 10 个概念,AI 就不再像魔法。
它会开始像工程。
也正是在那个时候,你才真正开始构建能工作的东西。
