
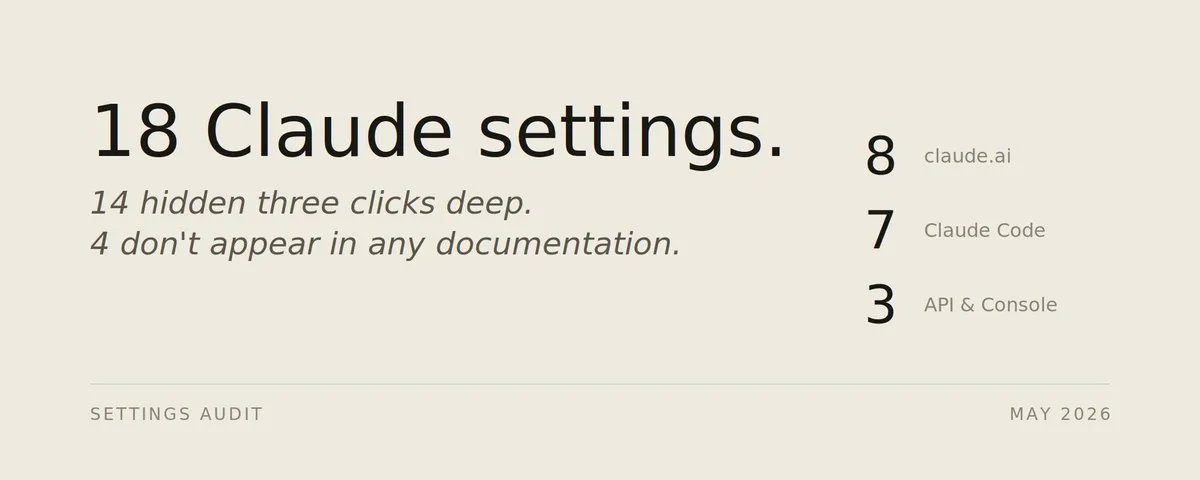
Anthropic 在 Claude Code 的 settings.json 里放了 125+ 个 key。官方文档大概只覆盖了其中 40 个。
缺失的设置里,有 14 个藏在 Claude.ai UI 里,要点三次才看得到。还有 4 个根本不出现在任何文档中。你只能靠读 GitHub issue、看工程师在 Discord 里不小心透露的信息,或者凌晨 1 点去 grep Claude Code 的二进制文件才能找到。
大多数 Claude 用户还在用 Anthropic 半年前的默认配置。账单慢慢变高,输出慢慢跑偏,然后他们开始怪模型。
下面是 18 个真正影响 Claude 运行方式的设置。
8 个在 Claude.ai 里。
7 个在 Claude Code 里。
3 个在 API 和 Console 里。
每一项都会讲:它在哪里、它做什么,以及简单的解决办法。
第一节:Claude(8 个设置)
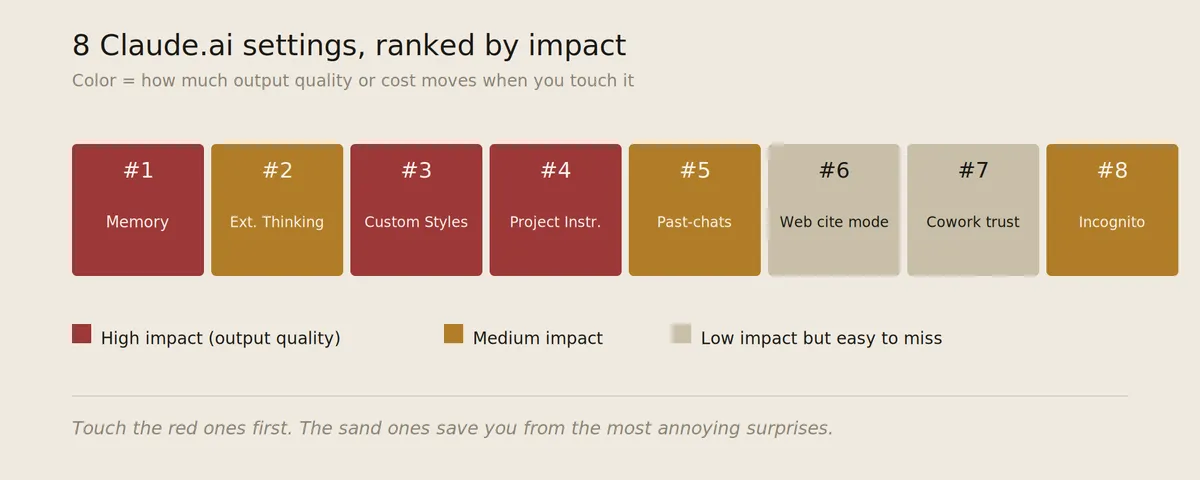
1. Memory:作用域、排除项,以及“忘记此项”命令
位置: Settings -> Capabilities -> Memory
作用: Memory 在 2026 年 3 月面向 Free 和 Pro 用户推出。默认情况下,Claude 会保存它认为值得保存的一切。大多数人会漏掉三个控制项:按项目划分作用域、排除列表,以及聊天中即时触发的遗忘命令。
为什么重要: 默认 memory 会逐渐漂移。4-6 周后,它会塞满一次性的纠正(比如你只在某个文件里说过一次“我写 Python 更喜欢 tab”)、泄漏到无关聊天里的项目事实,以及过期的角色上下文。输出质量会下降,因为 Claude 开始为错误的“你”做优化。
解决办法:
- 打开 project-scoped memory:Settings -> Capabilities -> Memory -> Scope per Project。Project 内产生的 memories 留在这个 Project 里。光这一项就能修掉大多数漂移。
- 把不希望在无关聊天中出现的话题加进 exclusion list。例如:离婚、医疗、薪资数字、客户名称。只要不排除,这些内容就可能跨上下文持续存在。
- 在任何聊天里直接使用 inline forget command:forget what you remembered about [topic]
Claude 会用这句话去匹配你的 memory store,并确认它删除了哪些内容。不需要菜单,也不需要进设置页。
2. Extended Thinking:每个聊天单独控制的开关
位置: chat input -> model selector dropdown -> Extended Thinking: Off / Light / Full
作用: Extended Thinking 会在回答前增加一轮 <thinking> 推理过程。Anthropic 对 Opus 默认开启。这个三档开关是 per-chat 的,会覆盖全局设置。
为什么重要: Extended Thinking 很适合数学、debug、多步规划。但对摘要、翻译、格式整理、改写和快速查询来说就是浪费。它会给这些任务增加 3-12 秒延迟,并多消耗 20-40% token,换来的却是同样的答案。
解决办法: 默认设为 Light(只在模型判断有用时使用 thinking),遇到真正困难的工作再显式切到 Full。我给别人演示这项设置后,大多数人在第一周就能把 Opus token 花费降 18-25%。
3. Custom Styles:它不是“语气”,而是输出契约
位置: chat input -> style selector -> Create New Style
作用: Styles 最开始只是语气切换(“Formal / Concise / Explanatory”)。但 Custom Styles 实际上是输出契约。你可以粘贴一份 200-1500 词的指令文件。该 style 下的每次回复都会在生成前应用它。
为什么重要: 大多数人只用 Styles 来“写短一点”。真正的用法,是不必反复粘贴提示词,也能把结构规则稳定应用到每次回复里。比如引用格式、禁用词、必需章节、代码块语言、长度上限,以及是否询问后续问题。
解决办法: 为每个 workflow 创建一个 Style。我的例子:
# Style: Draft for X

输出契约:
- 开头使用一个具体数字或命名实体。不要用 “I've been thinking...”
- 句子尽量控制在 18 个词以内。
- 除非节奏确实需要,否则不要用 em dash。
- 不要使用 “delve”、“leverage”、“robust”、“unlock”、“game-changing”。
- 如果列出 3 项以上内容,用短横线列表,不要用编号列表。
- 结尾用陈述句,不要用问题。

如果草稿超过 280 个字符,而用户没有要求写 thread,
先说明这一点,再给出答案。
轮流使用三套这样的 style(Draft for X、Code review、Summarize PDF),就能替代我 80% 的 saved prompts。
4. Projects:大多数人都会留空的 “instructions” 字段
位置: any Project -> top-right ⋯ -> Edit project instructions
作用: Projects 是持久化工作区。instructions 字段相当于 system prompt,会注入该 Project 的每次聊天。Anthropic 介绍 Projects 时重点说的是 knowledge upload,这也是多数人记住的功能。但 instructions 字段就在同一个页面,而我见过的真实 Projects 里,70% 都是空的。
为什么重要: 没有它时,Project 里的每个新聊天都会冷启动。有了它,你就不用反复重建上下文。(“这是一个 Polymarket 研究 workflow。默认保持怀疑。始终展示概率计算。绝不推荐交易,只展示 EV 框架。”)
解决办法: 把它当作 Claude 里的 CLAUDE.md。控制在 400 词以内。写清角色、默认怀疑程度、格式规则,以及永远不要做什么。每个月重读一次并修剪。
5. Search past chats(Pro+)以及真正有效的搜索方式
位置: Settings → Profile → Search past chats(需要启用)
作用: 允许 Claude 在相关时搜索你的对话历史。仅 Pro+ 可用。
为什么重要: 即使是 Pro,新账号默认也是关闭的。打开后还有个技巧:它做的是关键词匹配,不是语义搜索。你问 “What did we discuss about Chinese robots yesterday” 可能什么都找不到,除非过去的聊天里真的出现过 “Chinese robots”,或者同时出现过 “China” 和 “robots”。
解决办法: 打开它。然后学会正确的 query 形态:用内容名词,不要用元描述词。“Polymarket Iran” 有效。“That thing we talked about last week” 无效。
6. Web search:每个对话的开关,以及 citation 行为
位置: chat input -> + -> Web search: On / Off
作用: web search toggle 是 per-conversation 的,但它的行为还会受另一个不太知名的设置影响:Settings -> Capabilities -> Web search citations: Inline / Footnotes / Hidden。
为什么重要: 默认是 Inline。Inline citations 会破坏复制粘贴体验。你把 Claude 的答案复制到别处时,会把一堆没有上下文的引用标记也复制过去。Footnotes 模式会让正文保持干净,把来源放到末尾。
解决办法: 如果你会把 Claude 的 web-search 答案复制到其他文档、邮件或消息里,就切到 Footnotes。只有在完全在 Claude 里阅读时,才保留 Inline。
7. Connectors:Cowork 里的 “trust this folder” 陷阱
位置: Settings -> Connectors -> Cowork -> Trusted folders
作用: Cowork(2026 年 4 月 GA)让 Claude 可以访问你机器上的某个文件夹。默认情况下,Anthropic 会在每次 session 前询问是否信任该文件夹。trusted-folders list 是绕过这个询问的白名单。
为什么重要: 一个文件夹一旦进入 trusted,Claude 就会在每个 Cowork session 里不再提示地读取它。如果你 3 月测试时加过一个文件夹,后来忘了删,它可能从那时起就在每次 session 中被静默读取。
解决办法: 打开 trusted folders。移除所有不属于当前活跃项目的文件夹。这个列表增长得比你想象中快。
8. Incognito mode 实际跳过了什么
位置: sidebar -> New incognito chat(或 Cmd/Ctrl + Shift + N)
作用: Incognito chat 不会保存,不会写入 memory,不可搜索,也不会用于 model improvements。关闭后聊天会被删除。
为什么重要: 很多人以为 Incognito 只是把聊天从侧边栏隐藏起来。它实际跳过了四套系统:memory 写入、chat history、past-chats search index,以及训练数据 opt-in(如果你打开了)。
解决办法: 对任何敏感数据有意识地使用它:薪资、医疗、家庭、法律草稿、客户名称。三个按键,不需要纠结。
第二节:Claude Code(7 个设置)
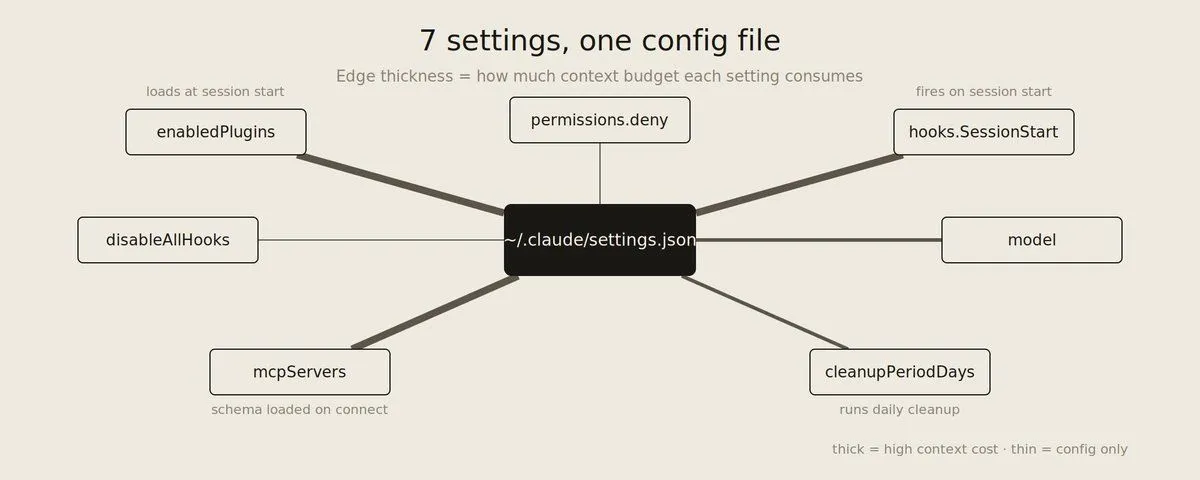
这些设置在 ~/.claude/settings.json(用户级)或 .claude/settings.json(项目级)里。后者优先级更高。
v2.1.105 的二进制文件里总共有 125+ 个 key。下面 7 个是真正能影响结果的。
9. enabledPlugins:禁用,不要卸载
位置: \~/.claude/settings.json -> enabledPlugins
作用: 设置 session 启动时加载哪些已安装插件。Plugin marketplace 让安装变得容易,但卸载更麻烦,而且多数时候没必要。只要把值设成 false 就行。
为什么重要: 每个 active plugin 都会把它的 hooks、SKILL.md 内容和 tool schemas 加载进你的 context budget。三个你已经忘掉的插件,可能在你输入任何内容之前就先吃掉 3-8K token。
我刚开始做这次审计时启用了 14 个插件。现在只保留 4 个 active。
解决办法:
{
  "enabledPlugins": {
    "formatter@acme-tools": true,
    "deployer@acme-tools": false,
    "analyzer@security-plugins": false,
    "old-experiment@personal": false
  }
}
false 会保留插件安装状态,但不加载。真正需要时,再用 /plugin enable name@marketplace 在当前 session 中重新启用。
10. permissions.deny:你需要知道的 bug
位置: \~/.claude/settings.json -> permissions.deny
作用: 阻止 Claude 运行特定工具或访问特定文件。设计意图是:防止 rm -rf,防止读取 .env,防止写到项目外。
为什么重要: 这里有一个已知 bug。deny rules 有时不会拦截。已经有多个 GitHub issue。被引用最多的一个(anthropics/claude-code#11544)记录了 hooks 虽然配置合法却没有加载的问题;类似模式也影响 deny enforcement。规则明明在 config 里,但 debug log 显示 “0 matchers found”。Claude 还是读了文件。
解决办法:
{
  "permissions": {
    "deny": [
      "Read(.env)",
      "Read(.env.*)",
      "Read(**/*secret*)",
      "Bash(rm -rf:*)",
      "Bash(sudo:*)"
    ]
  }
}
在文件系统层面再加一层防护。chmod 600 .env,这样即使 Claude 尝试读取,OS 也会拒绝。不要只相信 deny list。进 Claude Code 后用 /permissions 验证。如果规则没出现,重启 session。
11. hooks.SessionStart:让我减少 30% context bloat 的 4 行配置
位置: \~/.claude/settings.json -> hooks.SessionStart
作用: SessionStart 会在你从某个目录打开 Claude Code 时触发。你可以运行任何东西:打印 env 信息、检查 git 状态、注入上下文文件、预热缓存。
为什么重要: 大多数人注入了太多东西。CLAUDE.md 会膨胀到 5K token,因为每条项目规则都被塞进去了。SessionStart 让你只加载当前分支或目录真正相关的规则。
解决办法:
{
  "hooks": {
    "SessionStart": [
      {
        "matcher": "startup",
        "hooks": [
          {
            "type": "command",
            "command": "cat .claude/context-$(git branch --show-current).md 2>/dev/null || true"
          }
        ]
      }
    ]
  }
}
你的 main 分支加载 context-main.md。你的 feat/auth 分支加载 context-feat-auth.md。每个文件都保持很小,context budget 不再持续失血。
12. disableAllHooks:紧急开关
位置: \~/.claude/settings.json -> disableAllHooks: true
作用: 用一个 toggle 禁用所有 hook。2026 年 3 月更新中发货。多数人不知道它存在。
为什么重要: 当 Claude Code 开始表现奇怪时(phantom commands 在跑、session 启动时卡住、出现神秘文件写入),80% 情况是 hook 误触发。逐个禁用 hook 太慢。这个开关可以一次全部关掉,方便你隔离问题。
解决办法: 平时保持 false。出问题时改成 true,重启,看问题是否消失。如果消失,就逐个重新启用 hook。如果没有,bug 在别处。
13. model 的项目级 override
位置: .claude/settings.json(项目根目录)-> model
作用: 设置该项目的默认模型。会覆盖全局设置。
为什么重要: 很多人全局设置 Opus,因为他们想在困难工作上用它。然后打开一个主要是 markdown 编辑或 shell scripts 的项目,结果为 Haiku 用 1/20 成本就能完成的任务支付 Opus 价格。
解决办法:
// In your /docs project:
{ "model": "claude-haiku-4-5-20251001" }

// In your /infra project:
{ "model": "claude-sonnet-4-6" }

// In your /core-engine project:
{ "model": "claude-opus-4-7" }
Project-level overrides 优先。打开项目时,自动得到合适的模型,然后继续工作。
14. mcpServers 的 enabled flag
位置: \~/.claude/settings.json -> mcpServers
作用: MCP servers 把 Claude 连接到外部工具。每个已连接的 server 都会把完整 tool schema 加载进 context。每个 server 大概 800 到 6,000 token。
为什么重要: 很多人连接 MCP servers 只是为了测试,后来从不主动断开。三个月后你会有 12 个 connected,其中真正常用的只有 3 个。那 9 个不用的 server 会在每次 session 启动时消耗大约 25-40K token 的 context schema。
解决办法: 用 enabled flag 保留连接配置,但不加载。
{
  "mcpServers": {
    "github":   { "command": "...", "enabled": true },
    "postgres": { "command": "...", "enabled": true },
    "slack":    { "command": "...", "enabled": false },
    "linear":   { "command": "...", "enabled": false }
  }
}
真正需要时,再按 session 切到 true。我大多数日子只保持 2-3 个 active。做规划的日子,可能开到 6 个。
15. cleanupPeriodDays:没人提起的缓存
位置: \~/.claude/settings.json -> cleanupPeriodDays
作用: 设置 Claude Code 保留 transcripts、debug logs 和中间 session 数据的天数。默认是 30。
为什么重要: Dreaming 和 past-chat search 都依赖这些 transcripts。默认 30 天窗口下,Dreaming 只能从一个月的工作里学习。六个月能给它 6 倍信号。磁盘成本大概 200MB。
解决办法:
{ "cleanupPeriodDays": 180 }
保留 180 天 session history,供 Dreaming、memory consolidation 使用,也方便你自己 grep:“我三月份到底跟 Claude 说过那个 auth bug 的什么来着?”
Claude Code artifact:一份应用了全部 7 个设置的 settings.json
把这段复制到 ~/.claude/settings.json。根据你的实际情况调整路径和 plugin 名称。重启 Claude Code。重新运行 /permissions 和 /hooks 验证配置已经加载。
{
  "model": "claude-sonnet-4-6",

  "enabledPlugins": {
    "formatter@acme-tools": true,
    "old-experiment@personal": false
  },

  "permissions": {
    "deny": [
      "Read(.env)",
      "Read(.env.*)",
      "Read(**/*secret*)",
      "Bash(rm -rf:*)",
      "Bash(sudo:*)"
    ]
  },

  "hooks": {
    "SessionStart": [
      {
        "matcher": "startup",
        "hooks": [
          {
            "type": "command",
            "command": "cat .claude/context-$(git branch --show-current).md 2>/dev/null || true"
          }
        ]
      }
    ]
  },

  "disableAllHooks": false,

  "mcpServers": {
    "github":    { "command": "npx", "args": ["@modelcontextprotocol/server-github"], "enabled": true },
    "postgres":  { "command": "npx", "args": ["@modelcontextprotocol/server-postgres"], "enabled": false },
    "slack":     { "command": "npx", "args": ["@modelcontextprotocol/server-slack"], "enabled": false }
  },

  "cleanupPeriodDays": 180
}
Project-level overrides 放在项目根目录的 .claude/settings.json。最值得在那里设置的是:
// .claude/settings.json (in a docs project)
{ "model": "claude-haiku-4-5-20251001" }
第三节:API 和 Console(3 个设置)
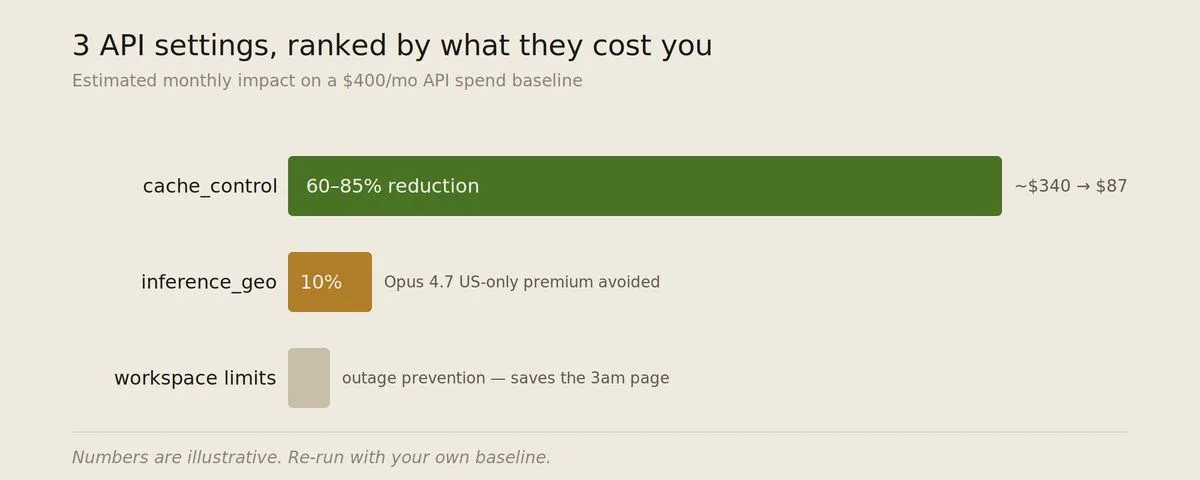
这些设置存在于代码或 Anthropic Console 中。它们是本文里对成本影响最大的设置。每一项都可能让你的账单变化 30-90%。
16. cache_control breakpoints:该放在哪里
位置: API request body,任何 content block 上的 cache_control 字段
作用: 标记 prompt 的某个前缀可缓存。后续请求如果有相同前缀,大约只按 input rate 的 10% 收费,而不是全价。
为什么重要: 这是 API 里最大的成本杠杆。很多人知道它存在,但多数人把 breakpoint 放错,结果只拿到部分节省,而不是完整节省。在我自己的设置里,修正 breakpoint 后,月账单从 340 美元降到了 87 美元。
解决办法: breakpoint 应该放在 静态内容和动态内容的边界。breakpoint 前的内容会被缓存,之后的内容会重新计算。
# WRONG — breakpoint after user message, nothing reusable cached
messages = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": user_question,
     "cache_control": {"type": "ephemeral"}}
]

# RIGHT — breakpoint after stable system prompt, full cache hit on next call
messages = [
    {"role": "system", "content": SYSTEM_PROMPT,
     "cache_control": {"type": "ephemeral"}},
    {"role": "user", "content": user_question}
]
可用 TTL 有两个:5-minute ephemeral(默认)和 1-hour。对于 session 间不会变化的 system prompts,用 1-hour:
{"cache_control": {"type": "ephemeral", "ttl": "1h"}}
Cache write 比基础 input 贵 25%。Cache read 是基础 input 的 10%。分界点是:同一个缓存前缀只要在 TTL 窗口内被读取 2 次以上,就能回本。
17. inference_geo 与 data residency tax
位置: API request -> inference_geo parameter
作用: 把 inference 路由到特定地理区域。比如 US-only residency、EU-only 等。
为什么重要:US-only data residency 会让 Opus 4.7 及以上模型多 10% premium。 这不在标准 pricing card 上。你会在 invoice 里看到它。
解决办法: 如果你的合规制度并不真的要求 regional residency,就不要设置 inference_geo。很多 app 会默认设置它“以防万一”,因为法务说过“确保数据留在美国”。确认这个要求到底是合同义务,还是只是愿望。如果只是愿望,省略这个参数,每次 Opus 调用省 10%。
如果确实需要它,要把这 10% 算进模型选择里。Sonnet 的 3 美元基础价格会变成等效 3.30 美元,这会改变 Opus-vs-Sonnet 的 break-even。
18. Workspace-level rate limit:防止凌晨 3 点故障的那个设置
位置: Console -> Settings -> Workspaces -> [your workspace] -> Per-feature rate limits
作用: 为每个 workspace、每个 feature 设置 rate limit,与账号级别 limits 分开。
为什么重要: account-level limit 保护你不至于花到破产。workspace-level limit 保护你的交互式产品,不会在某个 runaway batch job 吃光整个 ITPM allowance 时一起挂掉。你发布了新 feature,它有 bug,开始循环,吃掉所有额度,面向客户的 chat 开始返回 429。Workspace limits 可以避免一个 feature 饿死另一个。
解决办法: 每个 surface 建一个 workspace(interactive chat、batch processing、internal tools、experimental)。把每个 workspace 的 rate limit 设为账号 tier 的 60-70%。保留 30% 给需要 burst 的 workspace。
本文提到的第四个未记录设置是:每个 workspace 内部还有一个 feature-level cap,只有点进具体 feature card 才能看到,不在 workspace overview 上。默认值是 unlimited。
如果一个 workspace 里有三个 features,其中一个可以饿死另外两个,而 workspace-level limit 并不会拦住它。任何会做 batch work 的东西,都要设置 per-feature caps。
第四节:18 点检查清单
走一遍。20 分钟。12 个月里你都不碰的东西,大概率永远也不会碰。
## Claude.ai
- [ ] #1  Memory: project-scoped on, exclusion list populated
- [ ] #2  Extended Thinking: default = Light
- [ ] #3  Custom Styles: at least one workflow style created
- [ ] #4  Project Instructions: filled for every active Project
- [ ] #5  Past-chats search: on (Pro+)
- [ ] #6  Web search citations: Footnotes mode
- [ ] #7  Cowork trusted folders: reviewed, pruned
- [ ] #8  Incognito: keyboard shortcut memorized

## Claude Code
- [ ] #9  enabledPlugins: only active ones = true
- [ ] #10 permissions.deny: env files + sudo + rm -rf blocked, OS-level backup in place
- [ ] #11 hooks.SessionStart: branch-aware context loader
- [ ] #12 disableAllHooks: false (know where the switch is)
- [ ] #13 model: per-project override set for docs/infra/core projects
- [ ] #14 mcpServers: enabled flag used, not full deletion
- [ ] #15 cleanupPeriodDays: 180

## API / Console
- [ ] #16 cache_control: breakpoint after stable system prompt, 1h TTL for daily-stable prefixes
- [ ] #17 inference_geo: only set if compliance actually requires it
- [ ] #18 Workspace rate limits: per-workspace AND per-feature caps set
第五节:审计脚本(每周运行一次)
把它放到 ~/bin/claude-audit.sh。每周运行。它会标记 Claude Code 这半张清单,以及 API 侧的 cache_control 检查。
#!/usr/bin/env bash
# claude-audit.sh — flags settings drift across the 7 Claude Code + 1 API checks

CLAUDE_DIR="$HOME/.claude"
SETTINGS="$CLAUDE_DIR/settings.json"

echo "=== Plugins enabled ==="
jq '.enabledPlugins // {} | to_entries | map(select(.value==true)) | length' "$SETTINGS" 2>/dev/null
echo "Target: 3-5 active. Re-enable per session for the rest."

echo
echo "=== MCP servers enabled ==="
jq '.mcpServers // {} | to_entries | map(select(.value.enabled==true)) | length' "$SETTINGS" 2>/dev/null
echo "Target: 3 always-on. Per-session enable rest."

echo
echo "=== permissions.deny rules present ==="
jq '.permissions.deny // [] | length' "$SETTINGS" 2>/dev/null
echo "Target: >=5 rules. .env / sudo / rm -rf at minimum."

echo
echo "=== SessionStart hook configured ==="
jq '.hooks.SessionStart // [] | length' "$SETTINGS" 2>/dev/null
echo "Target: >=1 entry."

echo
echo "=== cleanupPeriodDays ==="
jq '.cleanupPeriodDays // 30' "$SETTINGS" 2>/dev/null
echo "Target: 180."

echo
echo "=== Per-project model overrides ==="
find . -maxdepth 3 -name "settings.json" -path "*/.claude/*" 2>/dev/null | while read f; do
  model=$(jq -r '.model // "—"' "$f")
  echo "  $f → $model"
done
echo "Target: docs → haiku, infra → sonnet, core → opus."

echo
echo "=== API cache_control check (set API_KEY to run) ==="
if [ -n "$ANTHROPIC_API_KEY" ]; then
  echo "Manual check: every system_prompt over 1K tokens should have cache_control with 1h TTL."
else
  echo "Skipped — set ANTHROPIC_API_KEY to enable."
fi
保存,chmod +x ~/bin/claude-audit.sh,每周运行,直到每一行都进入目标区间。
第六节:未纳入清单的内容
发布前我删掉了 4 个候选项。值得点名,这样你就不用浪费时间去追它们。
Adaptive Reasoning toggle。 Anthropic 已经默认开启它。覆盖设置在 Settings → Capabilities → Reasoning mode。30 天对比下来,我没找到哪个 workflow 在手动覆盖它后结果有明显变化。相信默认值,继续往前。
Skill auto-activation。 你可以切换 Claude 是否根据相关性检测自动加载 skills,或要求显式调用。我原本以为这会很重要,结果并没有。Auto-activation 配合 progressive disclosure(只在需要前加载 SKILL.md metadata)已经调得不错。保持开启。
Dispatch mobile-to-desktop control。 这是有用功能,但不是设置审计项。你的 workflow 要么适合它,要么不适合。没有什么隐藏 toggle 会改变结果。
Per-workspace max_tokens ceiling。 你可以强制每次回答在 800、2000 或 4000 token 截断。它确实能给话多的 workflow 省钱,但会破坏需要长输出的代码生成。值得按 workspace 测试,不值得作为默认推荐。
结束
今晚走一遍检查清单。大多数人会修掉 6-8 项。少数人会修掉 14 项以上。你的 billing dashboard 和 usage graph 会告诉你,这 20 分钟到底值不值。
今晚收藏并走一遍检查清单。如果它帮你省掉一个月“Claude 变笨了”的挫败感,转发出去。
