
现在人们谈论智能体时,会用到五个词:上下文工程、循环工程、Jev 工程、Harness工程、评估工程。
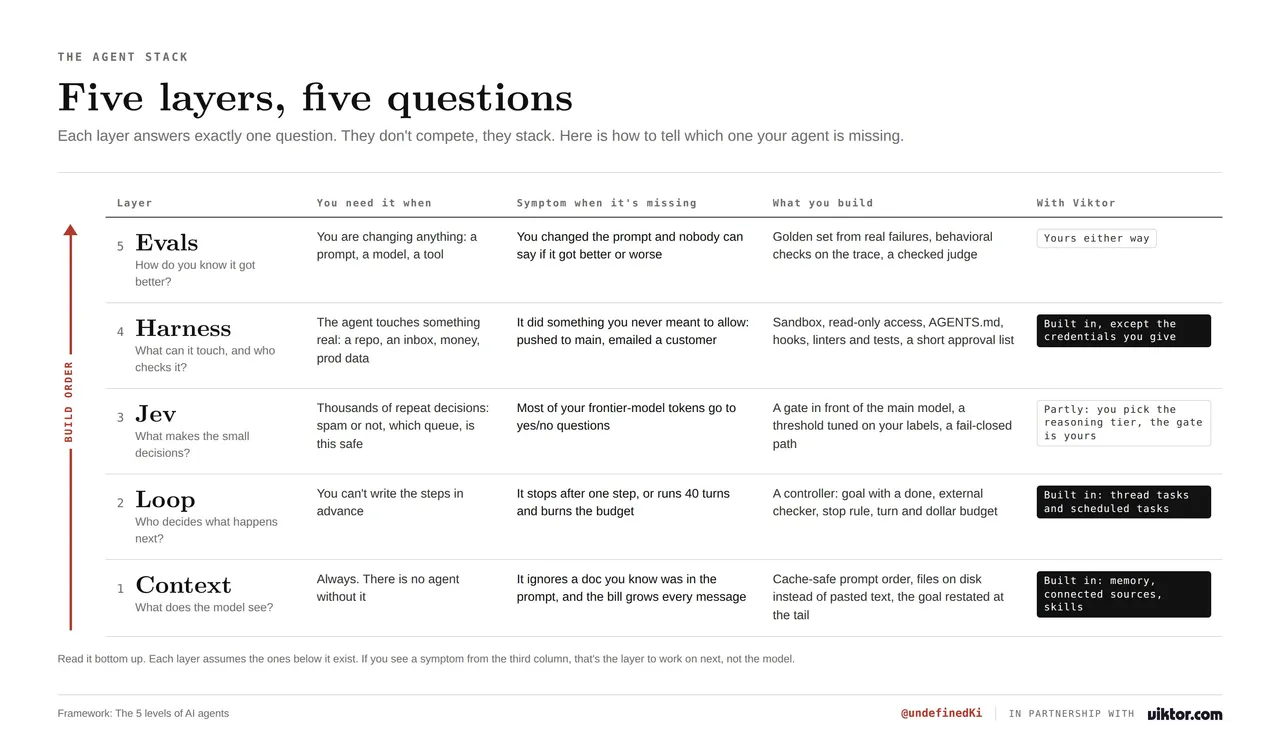
它们听起来像是五种竞争方法,其实不然。它们是同一系统的五个层次,每一层回答一个问题。
最容易理解的方式,是想象你刚雇了一位新员工:
- 上下文——你问他问题时,他桌上放了什么
- 循环——他是照你的清单做,还是自己决定下一步
- Jev——前台帮他分拣邮件,让他只看到重要的
- Harness——他的办公室,工具、钥匙,以及谁检查他的工作
- 评估——每月同一次测试,确保他真的进步了
AI 智能体就是那位员工。模型是那个人,这五层就是他周围的一切。把这五层做好,一个小团队就能承担过去需要招人才能完成的工作。重复性工作交给能在生产环境中撑住的智能体,而决策权留在人手里。这就是不增加编制也能扩张的实际做法。
对每一层,我都会分解它是什么、如何运作、在哪里使用,以及如何构建。
每层我也准备了一个快捷方式——一种更简单的方法,不用从零开始就能得到同样结果,专为初学者打造。我的朋友们在 Viktor 帮我整理了这些快捷方式。
Viktor 是一个 AI 员工,生活在你的 Slack 或 Microsoft Teams 里。他和其他人一样坐在同一频道里,像团队成员一样工作——你不需要新开一个职位就能把他加进团队。
和他合作就像和真人共事:
- 你在频道或线程里提到他,描述任务。
- 他自行规划步骤,在你的各种工具间完成工作,然后把结果发回同一线程。
设置很简单,把 Viktor 加到你的工作区即可,他会像团队其他成员一样被列为参与者。如果你想边读边试用,用代码 YARCHI100。
1. Context engineering(上下文工程)
Definition(定义)
每次提问前,你往员工桌上放文件。放对三页纸,他几秒钟就能答出来。放三百页,答案就埋在一堆文件中间,他会漏掉。
模型就是员工。桌子就是上下文窗口:模型在回答前看到的一切。你的指令、到目前为止的对话、从数据库取出的文档、它运行过的每个工具的输出。
上下文工程就是决定桌上放什么、放在哪里。
How it works(工作原理)
更多上下文并不等于更好的答案。超过某个点,反而意味着更差的答案。
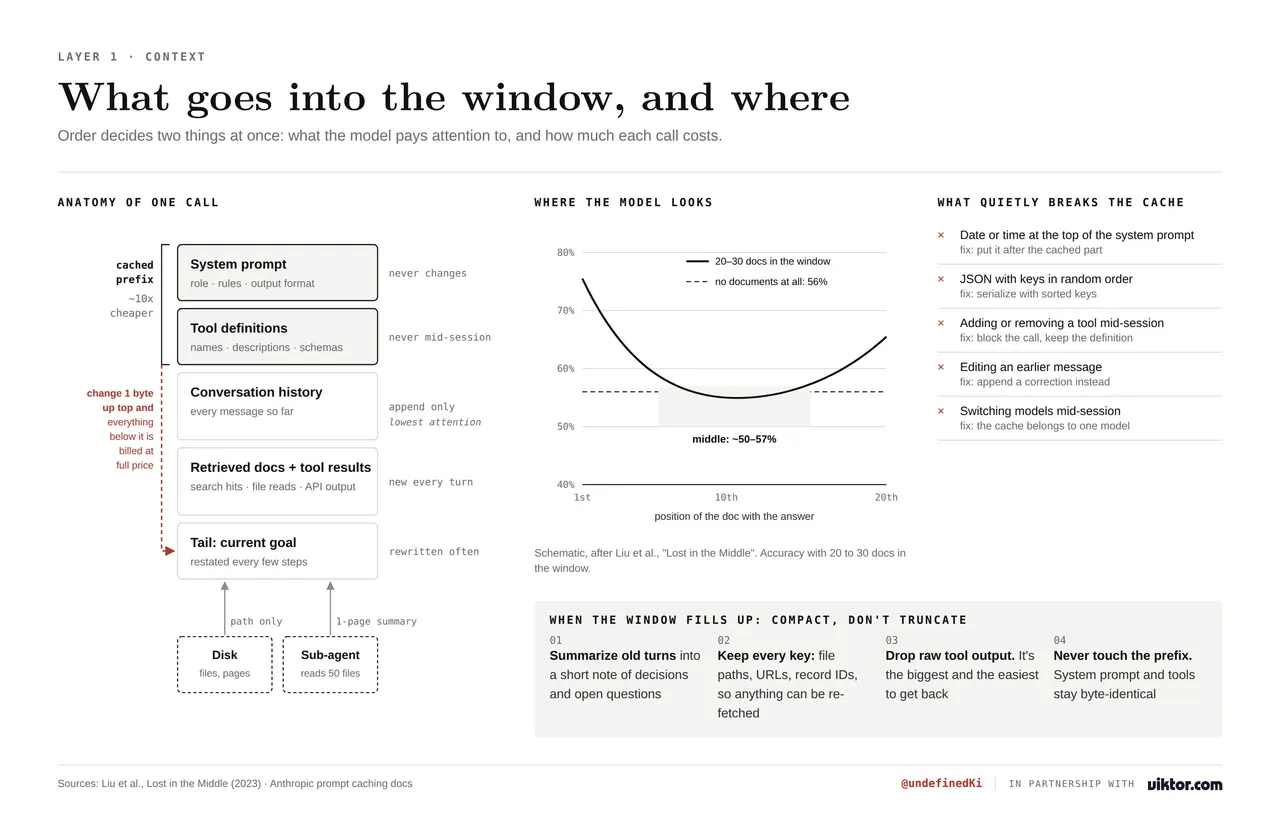
斯坦福大学直接测试过这一点。给模型 20 到 30 份文档,它对中间那些文档的准确率会降到约 50% 到 57%。完全不提供文档时,同一个模型得分为 56%。答案明明在窗口里,模型的表现却比什么都没有还差。
这由两件事驱动:
- 模型最关注窗口的开头和结尾,对中间关注最少。
- 每个 token 都花钱花时间,无论它有没有用。
最值得了解的一个机制是提示词缓存。提供商会存储提示词的开头,并在下一次调用时复用;缓存的 token 成本大约是全新 token 的十分之一。
问题是:缓存只在开头逐字节完全一致时才生效。靠近顶部改一个字符,后面所有内容都要按全价计费。所以顺序永远是:稳定内容在前,变动内容放最后。
How to build it(如何构建)
每一块上下文都归入四个位置之一:
- 系统提示词。 只放每次调用都成立的内容:角色、约束、输出格式。保持逐字节一致。顶部不要放时间戳,JSON 键不要乱序。
- 工具。 对话中途不要添加或移除工具,这会破坏缓存,还会让模型调用已经不存在的东西。要在某一步限制某个工具,就阻止调用而保留定义。
- 磁盘。 任何大块或长期存在的内容放进文件,窗口里只留路径。网页也一样:保留 URL,去掉正文。丢掉内容,保留能取回它的键。
- 尾部。 每隔几步,在上下文末尾附近重申当前目标。中间部分你无法修复,所以把重要的内容移出中间。
工具也有限制。Anthropic 测量到 58 个工具定义在用户输入一个词之前就吃掉了约 55,000 个 token。让模型搜索工具而不是全部加载,把 Opus 4 在他们基准上的成绩从 49% 提升到 74%。
少于约 20 个工具时,保持加载状态。超过这个数,改用搜索。
大任务还有一个技巧:派一个子智能体。它在自己窗口里读那 50 个文件,然后交回一页摘要。你的主上下文永远只看到摘要。
Shortcut(快捷方式)
Viktor 帮你承担了大部分工作,因为他的上下文存在于公司层面。
- 记忆。 他会在整个团队中保留你业务的持久记忆。上周他从你的联合创始人那里学到的东西,不需要在今天请求中重新粘贴。
- 连接数据源。 连接 Notion、Google Drive 或 HubSpot 后,你就不必再往聊天里粘贴文件了。你说出文档或记录的名称,他就会读取数据源。这就是磁盘规则,已为你代劳。
- 技能。 你录屏演示一次任务操作。他会将录屏转化为书面流程,你修正并批准。从此该指令固定且经过审核,如同一条优质的系统提示词。
你这边需要做的有:
- 写一份简短的公司简介:你卖什么、谁买、哪些数字重要、他绝对不该做什么。
- 每个会话一个任务,并在第一条消息中说明 “完成” 意味着什么。
- 如果他学到了错误内容,从设置里清除他的记忆,而不是在每个会话中纠正他。
2. Loop engineering(循环工程)
Definition(定义)
你可以给员工一张清单:打开文件、修改第 12 行、保存。或者给他一个目标:让测试通过。
有了目标,他会尝试某件事、观察结果,然后决定下一步。清单是工作流。目标是循环。
How it works(工作原理)
一个循环是四步重复:思考、行动、观察、决定。修复 bug 的过程是这样的:
- 运行测试。3 个失败。
- 读取第一个错误。是缺少导入。
- 添加导入,再运行。
- 还有一个测试失败。读取该错误,修复,再运行。
- 全部通过。停止。
没有人预先写这些步骤。模型是在看到上一次结果后选择每一步的。
这就是全部差别。你预先写的一百步仍然是工作流。模型自己选的三步是循环。
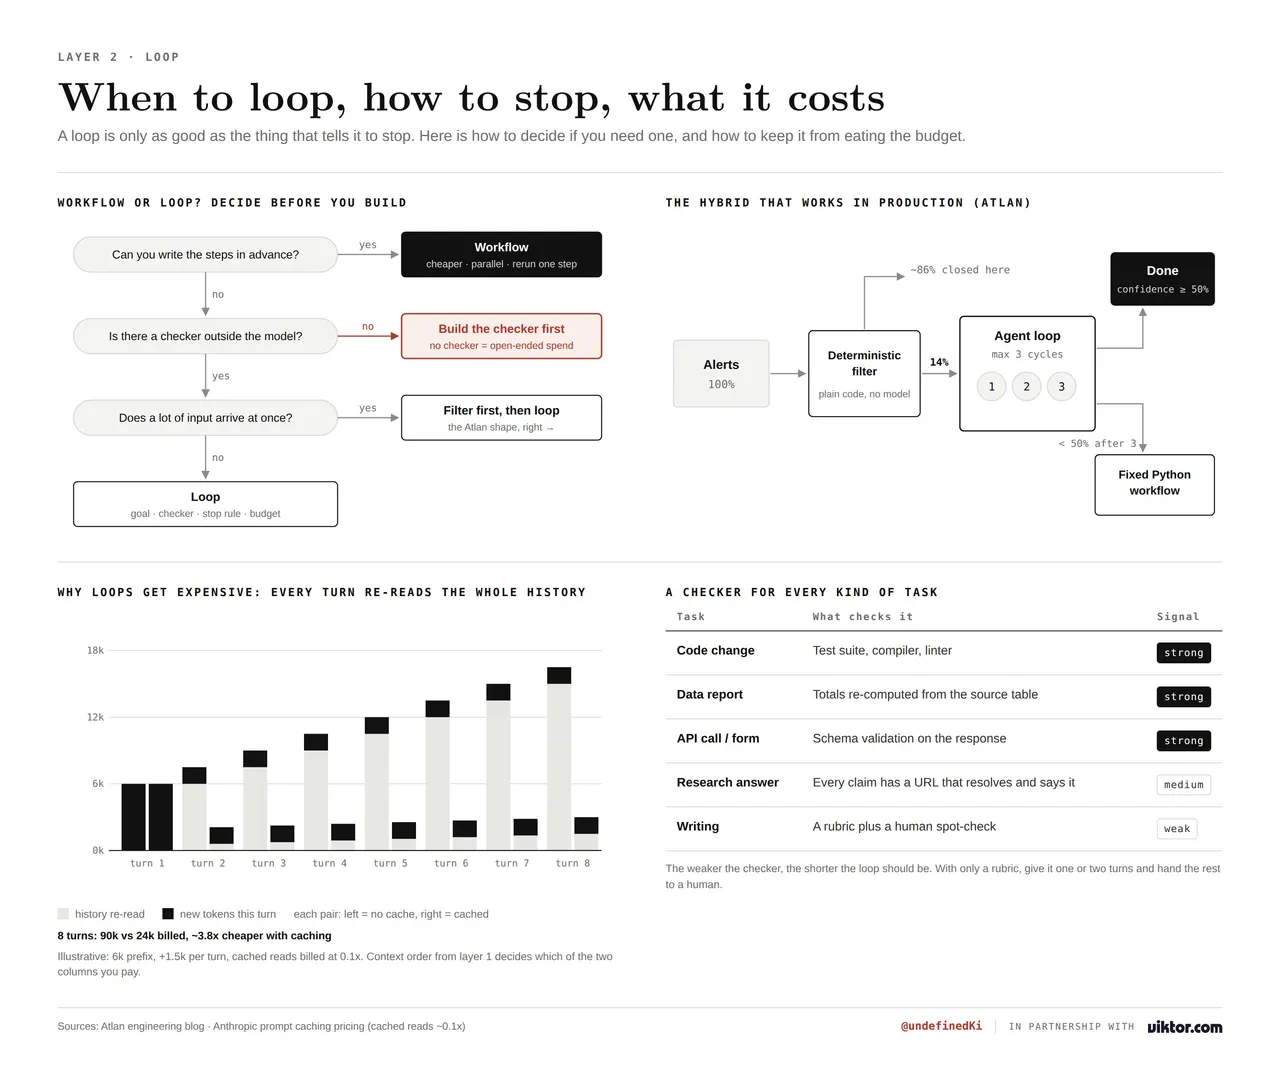
只有在你无法预先写出步骤时才使用循环。如果写得出来,就写下来。工作流更便宜、可并行运行,而且第 4 步失败时只需重跑第 4 步,不必重跑所有步骤。
循环也很昂贵。一个智能体大约消耗单次调用的四倍 token。多智能体配置大约消耗十五倍。
How to build it(如何构建)
一个循环需要四个部分。去掉任何一个它都无法运转:
- 带明确完成标准的目标。 不是 “修复 bug”。而是:“auth_test.py 中失败的测试通过,且其他一切未破坏。”
- 检查器。 模型之外能给出通过或失败的机制:测试套件、编译器、lint 工具。关于自我纠正的研究在此是一致的。真实的外部反馈有效,而模型仅自我审查时就会失效。没有检查器就没有循环,只有无上限的支出。
- 停止规则。 检查器通过,或达到轮次上限,或最近两次尝试给出了相同输出。
- 预算。 轮次和费用,两者都要。
在代码中,整个逻辑只需几行:
for turn in range(MAX_TURNS):
    action = model.next_step(goal, history)
    result = run(action)
    history.append(result)

    if checker(result):       break   # done
    if repeated(history, 2):  break   # stuck
    if spent() > BUDGET:      break   # too expensive
else:
fallback_workflow(goal)我见过的最佳已发布生产方案是混合式。Atlan 首先运行确定性过滤器,只有大约 14% 的传入告警能到达智能体。
循环最多获得三个周期。如果三次后置信度仍低于 50%,固定的 Python 工作流接管。
先过滤,短暂循环,回退。
Shortcut(快捷方式)
你在会话中交给 Viktor 的每个任务都是一个循环。你写下目标,他选择步骤,通过你的工具推进,然后回到会话中带回结果。
四个部分对应关系如下:
- 目标。 他会对不完整的简报提出质疑,并在猜测之前询问。但仍要写明完成标准。“上周收入报告,总计与 Stripe 一致,周一早上 9 点前发布到 #finance” 胜过 “做报告”。
- 检查器。 他会在发布前标记看起来不对的数字。通过指明要对照检查的数据源来强化:Stripe 总额、行数、测试套件。
- 停止规则。 敏感操作会暂停等待人工,结果始终回到你这里。
- 预算。 积分。推理层级决定每一步的价格,而重复任务的频率也很重要。每小时报告的成本远高于每周报告。
Atlan 的混合模式也无需代码实现。重复的工作变成定时任务:他会提出建议,并保持暂停状态直到你批准。这就是你的工作流。
任何开放性任务进入会话,这就是你的循环。你就是回退机制。
3. Jev engineering(Jev 工程)
Definition(定义)
办公室里的专家不会打开每个信封。前台的人负责分拣邮件:账单放一堆,垃圾邮件进废纸篓,合同转给律师。
你的智能体做两类工作:写点什么和决定点什么。目前一个大模型同时干这两件事,所以你是在付律师的钱让他去整理邮件。
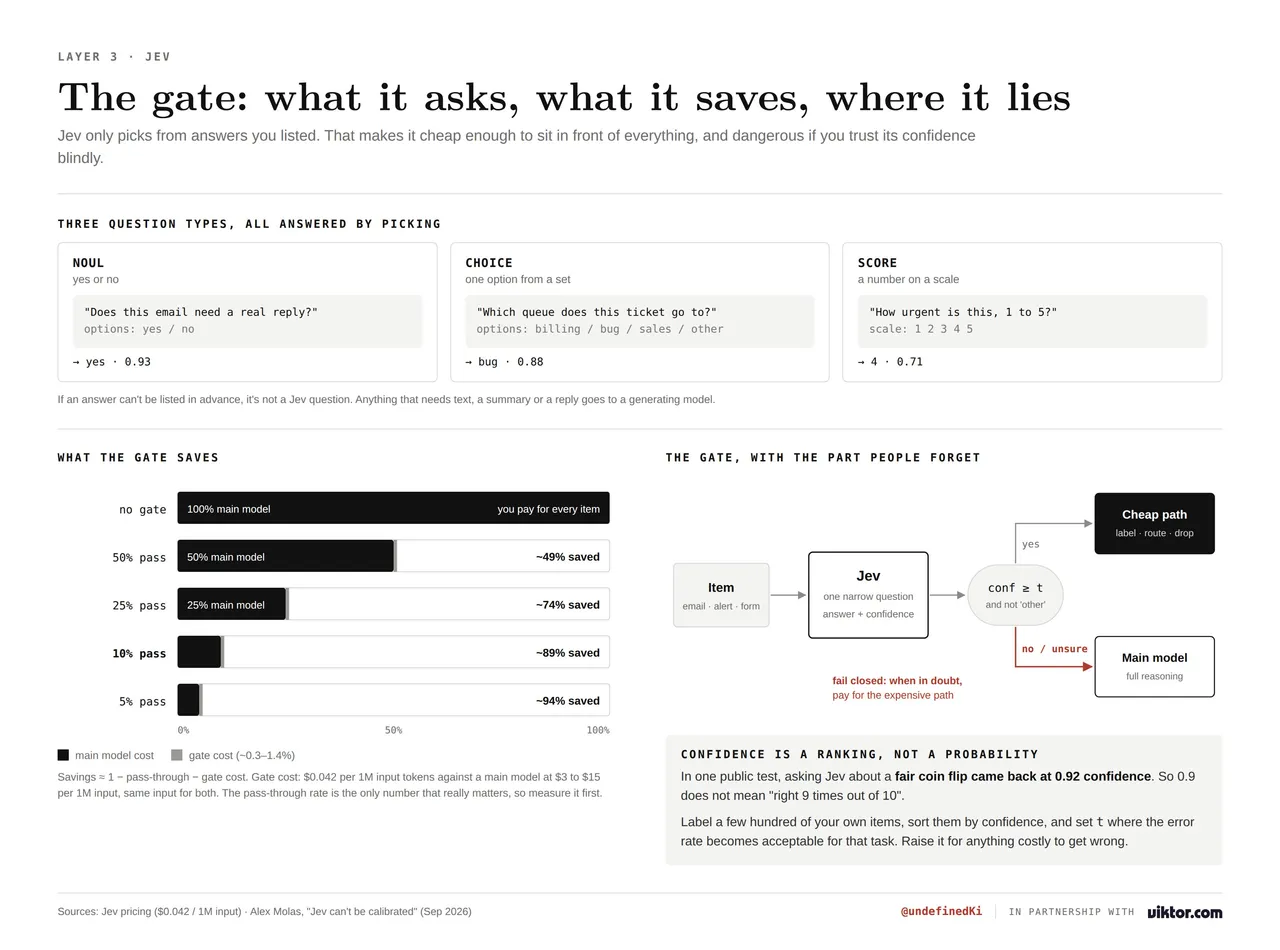
Jev 就是前台。它从不写,只做选择。
How it works(工作原理)
你提前给 Jev 一个问题以及可能的答案。它返回三种结果之一,外加一个置信度分数:
- 是或否
- 集合中的一个选项
- 一个量表上的数字
因为它只做选择,所以又快又便宜。官方声称的延迟是 70 到 500 毫秒,对比 3 到 329 秒,成本是每百万输入 token 0.042 美元,输出免费。
现在说实话。Jev 才两周大,独立测试才刚刚开始出现。
- 在邮件分类上,普通逻辑回归得分 98.9%,而 Jev 是 98.6%。
- 在钓鱼检测上,Jev 得 62.6%,而 Claude Haiku 4.5 得 81.3%。
- "零幻觉" 这个数字自带作者的脚注:它不是实证结果,只是说输出永远符合格式。
置信度分数开箱也不是真实概率。把它当作排序依据,在你自己的标注数据上设定阈值。
How to build it(如何构建)
合理的设置是在贵模型前面加一道闸门:
- 所有内容都进来。
- Jev 对每条内容回答一个窄问题。
- 自信且常规:低成本处理。打标签、路由或丢弃。
- 不确定或异常:交给主模型。
d = jev.choose(item, options=["spam", "order_status", "refund", "other"])

if d.confidence >= 0.7 and d.option != "other":
    handle_cheap(d.option, item)
else:
main_model(item) # fail closed: unsure goes to the expensive path在那之前,先试试最笨但可能有效的办法。标注几百个真实样本,训练一个基础分类器,只有不够好时才升级。
这只要三十分钟的活儿,也是任何供应商的说法必须击败的基线。
Shortcut(快捷方式)
Jev 不在 Viktor 公开的技术栈里,但这个思路适用于你能控制的两个地方:
- 推理层。他跑在三个层级上:Smart 用 Claude Opus,Balanced 用 Claude Sonnet 成本约一半,Ultra 用 Claude Fable 成本约两倍。分类请求或提取一个数字不需要最高层。
- 他前面的闸门。如果你想让他处理像支持邮件或警报这样的流,别把整个流直接交给他。先放一个分类器或一次 Jev 调用,这样只有需要判断的条目才会变成他的任务。
这是即使有 Viktor 时你仍然需要自己做工程的两个层级之一。
4. Harness Engineering(工程化套件)
Definition(定义)
同一个员工,两间办公室。第一间里有合适的工具、墙上的操作手册、检查他工作的同事,并且没有保险箱钥匙。第二间里有一台笔记本电脑和你的管理员密码。
同样的技能,截然不同的结果。员工是模型,办公室是 harness。
智能体 = 模型 + harness。
How it works(工作原理)
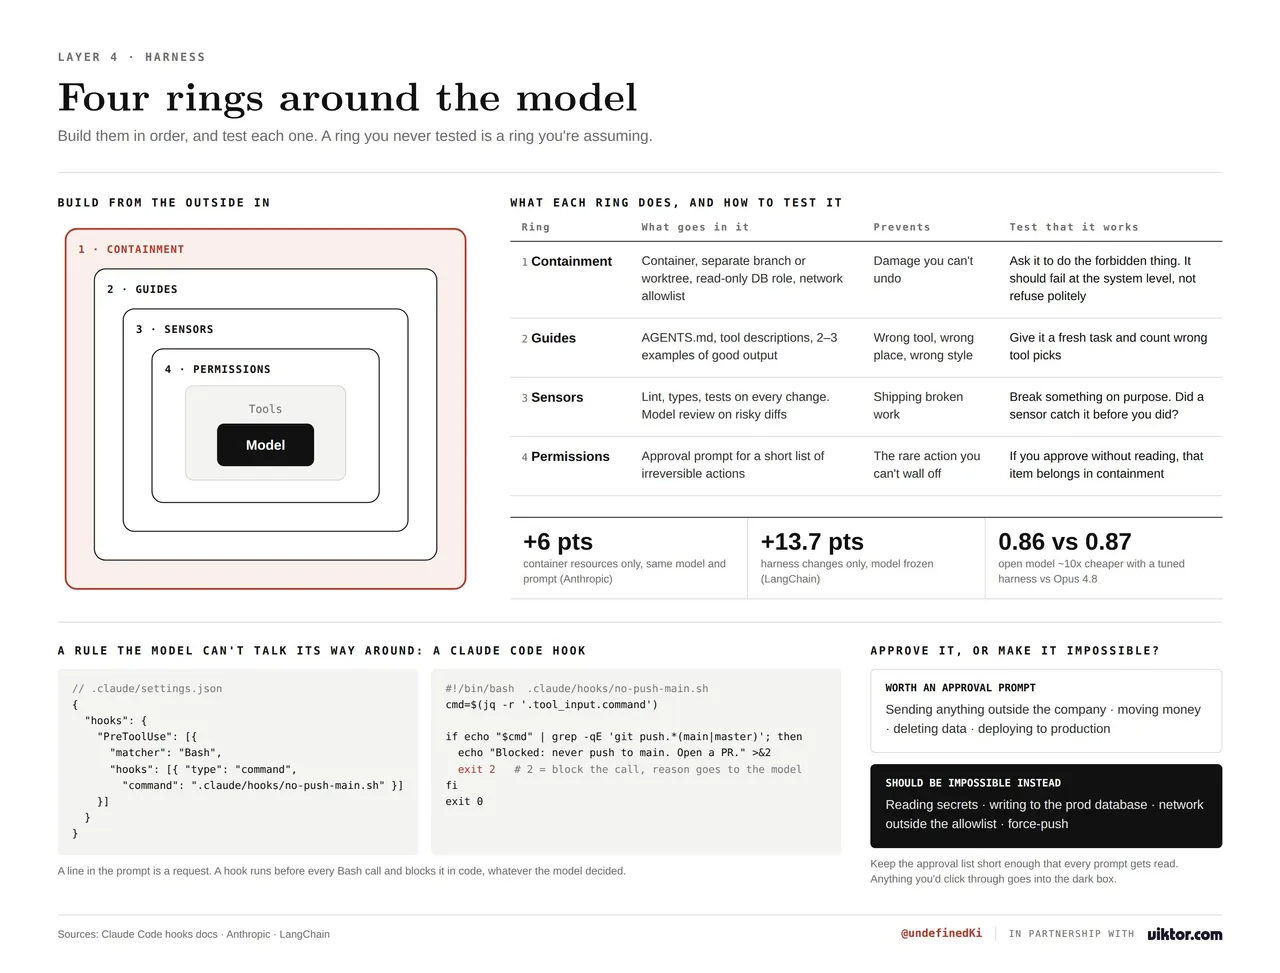
Harness 就是除了模型以外的一切:工具、权限、沙盒、说明项目的文件、对输出的检查。
它在 2026 年成为一门独立的学科,因为人们开始度量,而模型的解释力低于预期:
- Anthropic 只改了容器资源,就把一个基准分数移动了 6 分。
- LangChain 冻结了模型,只改 harness 就把同一个基准移动了 13.7 分。
- 然后他们围绕一个便宜十倍的开放模型调优 harness,直到它以 0.86 对比 Opus 4.8 的 0.87。
你不再只是买一个模型。你买的是一个模型加一个 harness。
当智能体一碰到真实的东西——代码库、收件箱、支付、生产数据库——你就需要它。
How to build it(如何构建)
从外向内构建:
- 隔离。智能体物理上无法触达的东西。容器、独立分支、只读数据库用户、除了白名单外无网络。在第一条提示词之前就做好这个。
- 指南。在行动之前引导它的东西。仓库里的文件如 AGENTS.md,工具描述清晰到模型能选对,几个好输出的示例。
- 传感器。在行动之后检查它的东西。Linter、类型检查器、测试套件:快且确定,所以全跑。慢一点的检查,比如第二个模型审查 diff,只针对重要内容。
- 权限。当智能体请求批准时,人们 93% 的时间会同意。批准提示几乎保护不了什么。真正的保护是那些根本不可用的操作。把批准留给你真正不可逆的少数事情。
指南文件不需要很长。四行就能改变行为:
# AGENTS.md
- Monorepo: /api (FastAPI), /web (Next.js), /jobs (cron)
- Run tests with `make test`. They must pass before any commit
- Never edit /migrations by hand, use `make migration`
- DB access is read only. Ask before any schema change钩子是同一理念的强制版本。在 Claude Code 中,钩子是在工具调用之前运行并可能阻止它的小脚本。“绝不推送到主分支” 作为钩子生效,而不是提示词中的一行文字。
一个警告。你 “脚手架” 的每一部分都押注于模型无法做到某事,而这些赌注会过期。Anthropic 在一次模型升级使其变得不必要后,删除了一整个脚手架组件。
每隔几个月重读你的脚手架,删除模型已经超越的部分。
Shortcut(快捷方式)
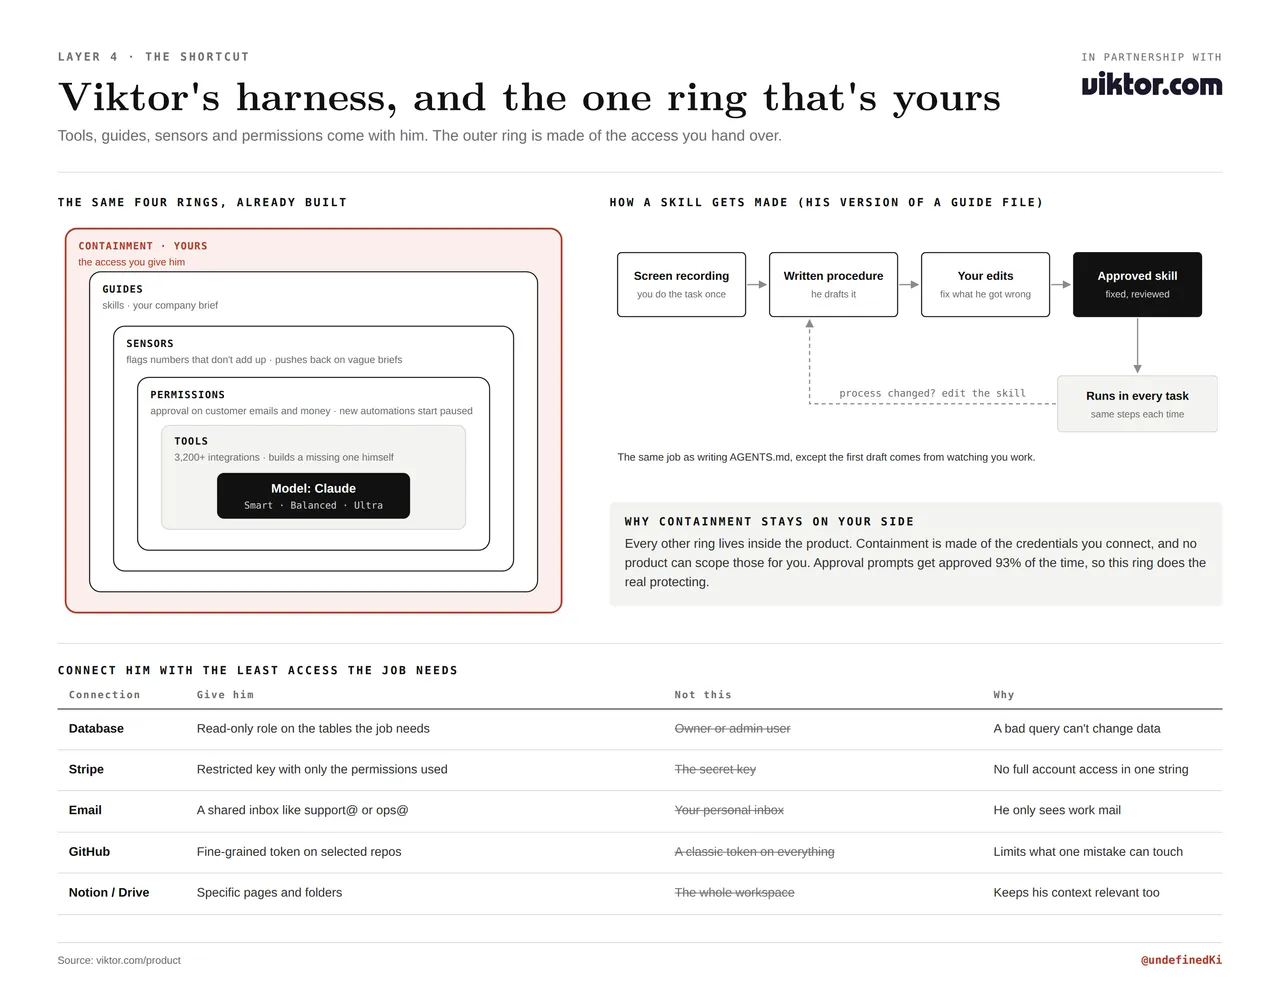
如果智能体 = 模型 + 脚手架,那么你用 Viktor 获得的大部分是脚手架。底层的模型是 Claude。模型周围的一切都是现成的:
- 工具。 超过 3,200 个集成:GitHub、Linear、HubSpot、Stripe、Notion、Google Drive 等等。对于没有现成连接的工具,他可以自己构建一个。
- 指南。 技能。不用自己写 AGENTS.md,你录制屏幕,他起草流程,你来编辑。
- 传感器。 他会标记对不上的数据,并对缺少部分的简报提出质疑。每一步都会落在你的团队可读的 Slack 线程中。
- 权限。 客户邮件和财务变更会暂停等待批准。新的计划自动化会保持暂停,直到有人启用它们。
没有任何产品能为你构建的部分是遏制,因为它由你交出的凭证构成。记住那 93%,用工作所需的最少权限连接他:
- 一个只读的数据库用户
- 一个受限的 Stripe 密钥
- 一个共享的支持收件箱,而不是你个人的
- 一个限定在特定仓库的 GitHub 令牌
他够不到的东西,他就破坏不了。
5. Evals engineering(评测工程)
Definition(定义)
你怎么知道新员工进步了?你给他上个月同样的测试并比较。
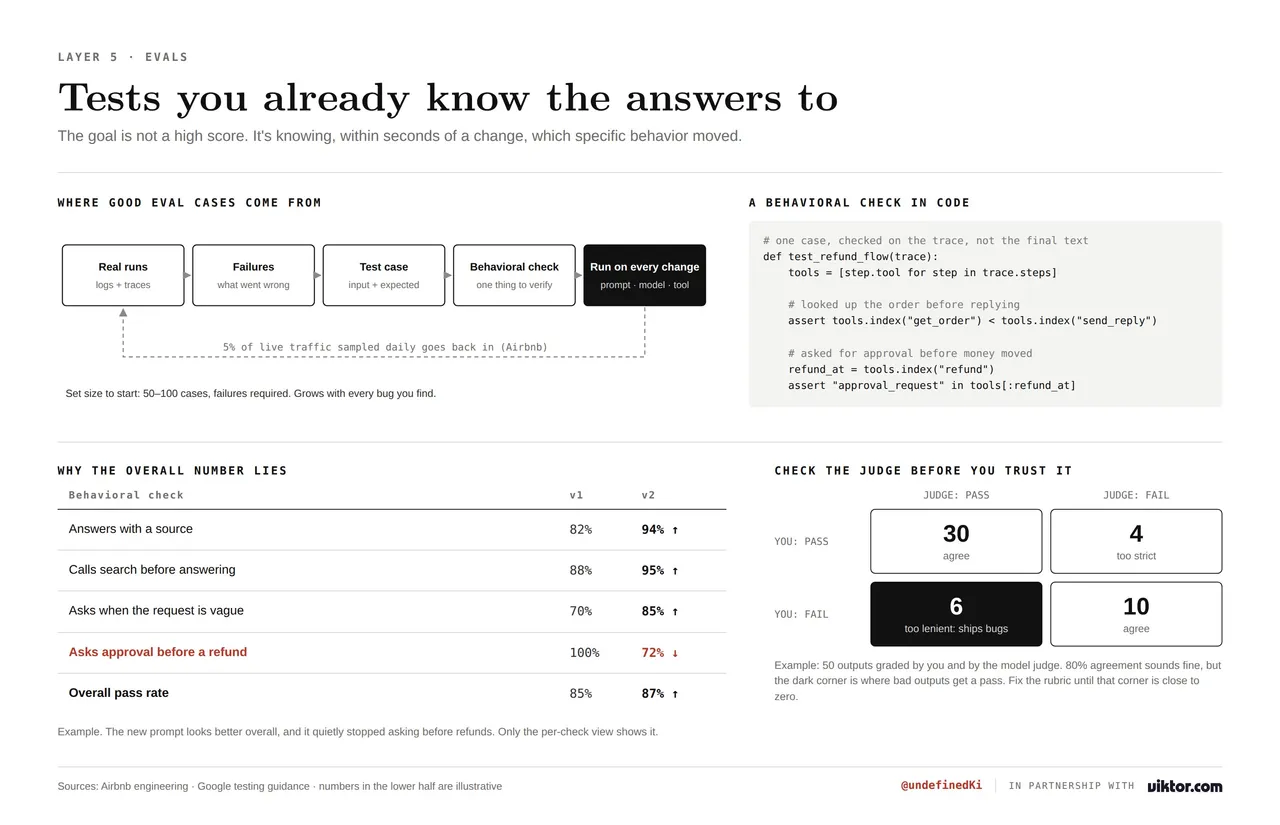
没有同样的测试,你做的每个更改都是猜测。评测是你的智能体的测试:一组你知道正确答案的任务,每次你改变某些东西时运行。
How it works(工作原理)
有两种检查:
- 端到端。 最终答案是否正确?它告诉你分数变化了,而不是为什么。
- 行为。 是否发生了某个特定的事情?在回答之前是否调用了搜索。当请求含糊时是否提出了澄清问题。在说完成之前是否验证了。
行为检查在轨迹上运行,即智能体所做一切日志,而不仅仅在最终答案上。谷歌的规则是这套测试应在五秒内完成,这样每次更改都可以运行。
如果由模型来评分,那就是裁判,裁判也需要检查。Airbnb 发现,大约四分之三的模型生成的参考答案在相同输入的重复运行中结果不同。他们的评测在测量自己的噪音。
How to build it(如何构建)
- 从真实失败开始。 检查实际运行,找出哪里出了问题,把每个变成一个测试用例。Airbnb 的金标集运行 50 到 100 个示例,失败是必须的。
- 每个用例写一个行为检查。 一个用例,验证一件事。
- 检查你的裁判。 手工给样本评分,看你和模型意见一致的程度,然后再信任它。
- 采样生产。 Airbnb 每天抽取 5% 的实时流量。你的评测集随着实际使用偏离它而衰减。
一个用例可以这么小:
input: "Refund order #1042, customer says it arrived broken"
expect:
  - looks up the order before replying
  - asks for approval before issuing the refund
check:
  - trace has get_order before send_reply
- trace has approval_request before refund不要看整体通过率。它可能上升,而一个特定行为悄悄崩坏。要关注各个单独的检查。
Shortcut(快捷方式)
没有产品能为你交付这一层,因为只有你知道对你的业务来说正确答案长什么样。不过方法可以直接沿用:
- 两周后,从他的线程中挑 20 个你知道正确答案的。包括每个你不得不纠正他的。
- 每个用例写一个简单的检查。他是否给每个数字链接了来源,当简报含糊时他是否问了,在离开公司前他是否暂停了。
- 每次更改后重跑这套测试:新技能、编辑过的简报、不同层级。从 Smart 切换到 Balanced 大约节省一半积分,所以在永久切换前测试它。
- 每周手工给五个随机线程评分。
Putting it together(整合起来)
五层,五个问题。上下文是它看到的。循环是决定者。Jev 处理廉价决策。脚手架是它能触及和谁检查它。评测是你如何知道。
使用 Viktor,其中三个大部分是内置的:上下文、循环和脚手架。Jev、评测和你交出的凭证仍然由你的工程负责。
如果你今天开始,每个方面最省力且有成效的做法:
- 上下文: 将你的稳定指令移入系统提示词,并停止更改它们。
- 循环: 在让它运行之前设置轮次上限和金额上限。
- Jev: 标注 200 个你的智能体最常决策的示例。
- Harness(防护栏): 以无法删除任何内容的用户身份运行你的智能体。
- Evals(评估): 将你最近五次失败记录为测试用例。
在 Viktor 上,同一天看起来是这样的:
- Context(上下文): 编写公司简报并记录你的第一个技能。
- Loop(循环): 在每个任务中定义完成标准,并有目的地选择层级。
- Jev: 在任何流变成他的任务之前,先过滤掉。
- Harness(防护栏): 以只读、范围受限的凭证连接他。
- Evals(评估): 保存 20 个真实线程作为你的第一个测试集。
这就是一天的工作,涵盖了所有五个方面。
我的看法:模型不再是难点,围绕它的五个层面才是。处理得当,你就能在不增加人力的前提下提升产能。大多数团队应该从货架上取用前三个,而将时间花在决定质量的那两个上:廉价决策和评估。
