
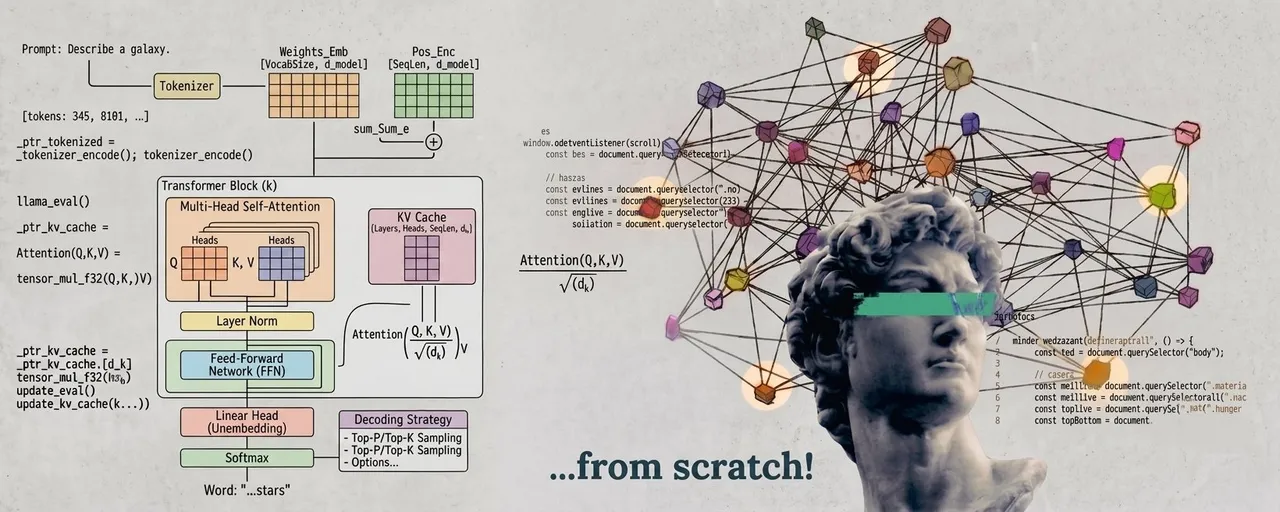
在本文中,我将分解 AI 推理工程所需的核心数学知识。我还会分享帮助过我的具体路线图和资源。我们直接开始吧。
1. Numbers and Precision(数字与精度)
硬件如何存储数字,以及当它无法存储时会发生什么
我一开始跳过了这部分,因为它看起来像是琐事。然后我花了两天时间调试一个量化模型,它输出的内容毫无意义,原因就在这里。早点学习它吧。
1.1 How a float is built(浮点数是如何构建的)
浮点数存储为三个部分:一个符号位、一些指数位和一些尾数位。指数位控制你能表示的数字的大小范围。尾数位控制你保留的有效数字位数。
每种格式只是在这两个任务之间对可用位进行不同分配,所以一旦你理解了这种权衡,你就能预测任何格式的行为。
1.2 The formats you'll run into(你会遇到的格式)
- FP32 有 8 个指数位和 23 个尾数位。它是可靠的默认选项,但速度慢且占用内存。
- FP16 将内存减半,但只有 5 个指数位,因此它能表示的数值范围很小。数值可能比你预期的更容易溢出到无穷大或缩小到零。
- BF16 保留了 FP32 的 8 个指数位,而牺牲了尾数位。你获得与 FP32 相同的范围,但精度更低。大多数现代工作默认使用它,因为失去精度只会增加一些噪声,而失去范围会带来无穷大,这些无穷大会传播到所有后续计算中。
- FP8 有两种变体,E4M3 和 E5M2。名字告诉你分配方式,所以 E4M3 有 4 个指数位和 3 个尾数位。
- INT8 和 INT4 是整数,因此可表示值之间的间距是固定的,而不是相对的。它们需要一个单独的缩放因子来表示除小整数以外的任何值。
1.3 Rounding and its consequences(舍入及其后果)
每次算术运算都会将结果舍入到最近的可表示值,这会引入一个小误差。
在一长串操作中,这些误差会累积,这就是为什么在 FP16 中对长向量求和会偏离正确答案,也是为什么快速的内核通常将累加总和保持在 FP32 中,即使输入是较低精度。
你还需要正确理解上溢和下溢。在 FP16 中,一个异常大的激活值就可能超过最大值并变成无穷大,然后所有下游计算都会被破坏。
1.4 Epsilon and cancellation(机器精度与抵消)
机器精度是 1.0 附近两个可表示数字之间的最小差异。它告诉你两个浮点数需要有多接近,以至于比较它们不再有意义。
灾难性抵消发生在你减去两个几乎相等的数字时。前导数字相互抵消,剩下的主要是舍入误差。
这出现在归一化层和方差计算中,教科书公式会减去两个大而相似的量,而数值稳定的版本会重新排列算术以避免这种情况。
1.5 Stable softmax(稳定的 Softmax)
Softmax 涉及计算每个输入的指数。如果某个输入大约为 90,其指数会完全溢出 FP32。
标准修复方法是在取指数之前从所有输入中减去最大值,这在数学上给出相同的答案,因为 Softmax 对常数平移所有输入是不变的。
这种技术的一般版本是 log-sum-exp,值得认真学习,而不仅仅是记住 Softmax 的修复方法。它是稳定计算对数概率的基础,FlashAttention 内部使用的在线 Softmax 也是同一思想的变体。
2. Quantization Math(量化数学)
用更少的位存储权重
量化是大部分内存和带宽节省的来源。核心数学是线性映射,所以它比论文标题所暗示的更容易理解。
2.1 The mapping(映射)
你正在将一个浮点数值范围映射到一个小整数集上。两个数字定义了这个映射。
缩放因子表示每个整数步代表多少实际值,零点表示哪个整数对应实际的零。要进行量化,你除以缩放因子,加上零点,然后舍入。要反量化,你反转这个过程。
几乎每种量化方法都是选择这两个数字的不同策略。
2.2 Symmetric and asymmetric(对称与非对称)
对称量化将零点固定在零,并将范围以其为中心。算术更便宜,并且对权重效果很好,因为权重往往大致居中。
非对称量化允许零点移动,这能更好地处理偏斜的分布。ReLU 后的激活值从不为负,因此对称范围会将其一半的整数浪费在永远不会出现的值上。
2.3 Granularity(粒度)
你可以对整个张量、每个通道或每个固定大小的值组(例如 64 或 128)使用一个缩放因子。
更细的粒度带来更好的精度,因为张量某一部分的少数极端值不再决定所有其他值的缩放。代价是你需要存储和处理更多的缩放因子。INT4 方法通常需要组级缩放才能保持足够的精度来使用。
2.4 Choosing the range(选择范围)
在开始量化之前,你必须决定从哪个浮点范围进行映射。最简单的选择是观测到的最小值和最大值,但一个极值会拉长范围,导致你所关心的数值分辨率极低。
百分位裁剪故意截断尾部。更谨慎的方法是在候选范围内搜索,并保留误差最低的那个,误差可用平方误差或相对于原始分布的 KL 散度来衡量。
权重的范围可以直接精确测量,因为权重是固定的。激活范围则取决于输入,因此需要将一小部分校准数据输入模型并记录观测到的结果。
2.5 Outliers(异常值)
在 Transformer 中,少数激活通道的值比其他通道大数倍。如果你明白了为什么一个大值会破坏张量其余部分的有效分辨率,那么各种异常值处理方法的动机就显而易见了。
它们要么隔离异常通道并保持较高精度,要么在权重和激活之间转移难点,要么重新缩放通道以使范围更均匀。
2.6 Curvature methods, briefly(曲率方法简述)
更强的权重量化方法利用输出对哪些权重最敏感的信息,用 Hessian 矩阵近似。模型几乎不依赖的权重可以随意舍入,而依赖度高的权重会得到补偿。
你不必推导更新规则就能使用这些方法,但了解 Hessian 被用作敏感性估计,可以解释为何它们远超普通舍入方法的性能。
3. Linear Algebra for Compute(面向计算的线性代数)
同样的运算,以成本而非解释来衡量
如果你做过训练规划,你已经知道矩阵乘法是什么。对于推理,你需要知道它的成本是多少。
3.1 Counting the cost of a matmul(计算矩阵乘法的成本)
将一个 m×k 矩阵与 k×n 矩阵相乘大约需要 2×m×n×k 次浮点运算,因为每个输出元素是长度为 k 的点积,每一步都包含一次乘法和一次加法。此外,你还需要从内存中读取两个输入矩阵,并写回输出。
熟练地为你的模型中的各种形状手工估算这两种成本。在剖析之前就能说出 “这一层大约需要这么长时间”,是整个领域中最有用的习惯。
3.2 Matrix times matrix versus matrix times vector(矩阵乘矩阵与矩阵乘向量对比)
矩阵乘矩阵在每加载一个字节的数据时会执行大量算术运算,因为每个加载的值会被多个输出元素重用。矩阵乘向量在每字节上执行的算术运算很少,因为每个权重被加载一次、使用一次然后丢弃。
单请求一次生成一个 token 本质上就是第二种情况,这一事实很大程度上解释了为什么为语言模型提供服务如此困难。
3.3 Arithmetic intensity(算术强度)
算术强度是操作数除以移动的字节数。这是你首先检查的数值。
如果强度高,芯片的计算速率会成为瓶颈。如果强度低,内存带宽成为瓶颈,计算单元空转等待数据。大多数推理工作负载属于第二种情况,这也是为什么大量优化工作集中在减少字节移动而非减少算术运算上。
3.4 How tensors sit in memory(张量在内存中的存储方式)
你需要理解行主序和列主序布局、步长以及张量连续的含义。你还需了解为什么转置矩阵虽然在数学上不变,但实际耗时;以及为什么形状要填充到特定的倍数,以便硬件矩阵单元能够使用。
3.5 Tiling(分块)
分块是指将大型矩阵乘法分解为适合快速片上内存的小块,然后在驱逐前尽可能多地重用每个块。涉及的数学是计算能装入缓存多少以及每块被重用多少次,这是你读到的每个快速内核的核心思想。
3.6 Low rank structure and sparsity(低秩结构与稀疏性)
矩阵的秩告诉你它实际包含多少独立信息。奇异值分解允许你用低秩版本近似矩阵,占用更少内存,这是低秩压缩和低秩适配器的基础。
适配器是加到基础权重上的低秩更新,因此理解秩能告诉你为什么将其合并到基础模型是精确的,以及为什么同时服务多个适配器需要不同的方法。
对于稀疏性,实际要知道的是,像每四个中两个非零这样的结构化模式有硬件支持并带来真正的加速,而非结构化稀疏往往尽管算术运算减少但运行更慢,因为索引开销超过了节省。
4. Performance Modeling(性能建模)
在测量之前估算运行时间
这一节与机器学习关系最少,却是我最常用到的部分。
4.1 The roofline model(Roofline 模型)
如果绘制可实现的性能与算术强度的关系图,你会得到两个极限。
有一条表示内存带宽的斜线,当强度低时限制你;一条表示峰值计算能力的水平线,当强度高时限制你。你运行的每个内核都位于这两个上限之一的下方。
学会将工作负载放在该图上,立刻就能告诉你该优化内存访问还是算术运算,从而避免浪费一周时间去优化从来不是瓶颈的东西。
4.2 Bandwidth bound estimates(带宽受限估算)
当受内存限制时,运行时间约等于必须移动的字节数除以设备的内存带宽。
这里有一个此类估算的例子。一个 70 亿参数模型以 FP16 存储大约需要 14 GB。要生成一个输出 token,你需要读取每个权重一次,因此将 14 GB 除以 GPU 的内存带宽,就可以得出在不考虑其他因素情况下每 token 的时间下限。
如果用 4 位权重重新做这个除法,下限会大约降低四倍,这就是为什么量化能加快单请求生成,即使算术运算不变。
4.3 Latency and throughput(延迟与吞吐量)
延迟是一个请求所需的时间。吞吐量是每秒完成的请求数。增大批处理规模会提高吞吐量,但会恶化每个请求的延迟,因此你是在曲线上选择一个点,而不是找到一个在两方面都最优的设置。
4.4 Little's Law(利特尔法则)
利特尔法则指出,系统中的平均请求数等于到达率乘以每个请求在系统中停留的平均时间。
这是一个单行公式,它回答了一个非常实际的问题:要达到给定的吞吐量,同时需要有多少请求在飞行中。一旦知道了这个数字,你就知道需要预留多少 KV 缓存内存。
4.5 Queueing behavior(排队行为)
你不需要太多正式的排队论知识,但确实需要内化一个结果。当利用率接近满容量时,等待时间是无界增长而非线性增长的。
将服务器的利用率从 90% 提高到 95%,会使排队延迟变得远比那五个百分点的差距所暗示的严重得多,这正是容量规划总要留有余量的原因。
4.6 Amdahl's Law(阿姆达尔定律)
优化流水线中一个阶段所能获得的加速比,受限于该阶段在总时间中所占的比例。在开始优化一个只占运行时间百分之三的工作之前,先算一下这个比例是很有用的。
4.7 Splitting across devices(跨设备拆分)
当一个模型被拆分到多个 GPU 上时,设备之间必须交换中间结果。你需要对 all-reduce 和 all-gather 等集合操作的成本有一个粗略的概念,以及这些成本如何随设备数量和消息大小而增长。
值得理解的失败情形是拆分模型后结果反而变慢,这发生在你为了减少本就不是瓶颈的计算而增加了通信时。
5. Transformer Inference Arithmetic(Transformer 推理算术)
将上述内容应用于实际工作负载
5.1 Two phases with opposite behavior(两个行为相反的阶段)
处理输入提示词是一次性完成的,每个 token 都并行计算。每加载一个字节都有大量的算术运算,因此这个阶段通常是计算密集型的,每个 token 的成本较低。
生成输出是逐 token 进行的,每一步都要读取整套权重来生成一个 token。每字节的算术运算量很少,因此这个阶段是内存密集型的,每个 token 的成本要高得多。
几乎所有的服务优化之所以存在,都是因为这两个阶段对硬件的要求不同。
5.2 Sizing the KV cache(KV 缓存规模估算)
这个计算决定了你同时能服务多少用户,所以值得能凭记忆做出来。
总大小取决于层数、键和值头的数量、每个头的维度、每个存储元素的字节数、序列长度和批处理规模。将这些相乘,并计入一个因子 2,因为你同时存储键和值。
算完之后有两件事值得注意。大小随序列长度和批处理规模线性增长,而且在对权重进行量化时它并不会缩小。对于长上下文服务来说,KV 缓存比权重是更大的问题。
5.3 Where attention starts to dominate(注意力开始占据主导的位置)
注意力分数的计算随序列长度的平方增长,而前馈层随其线性增长。在短序列长度下,二次项小到可以忽略,前馈层主导成本。
存在一个交叉长度,超过之后注意力成为主要开销,值得大致了解这个点在你所处理的模型形状中落在哪里。
5.4 Reducing the number of key and value heads(减少键和值头的数量)
分组查询注意力和多查询注意力保持完整的查询头数量,但在组间共享键和值头。如果你用更少的键和值头重新做一遍 5.2 中的 KV 缓存计算,内存节省就直接从算术中体现出来了。
5.5 Paging and fragmentation(分页与碎片化)
与其为每个请求按最大可能的序列长度预留一块连续的内存,你可以随着序列的增长以小而固定的块来分配 KV 缓存。
相关的量是:每个序列最后一个部分填充的块中浪费了多少空间,你预留的内存中有多少比例存的是真实数据,以及两个共享提示词前缀的请求之间能共享多少内存。
5.6 Batching over time(随时间批处理)
静态批处理会收集一组请求,一起运行,并等待它们全部完成。当请求生成不同数量的 token 时,短的会提前完成,而最长的继续运行期间,它们的槽位就闲置着。
连续批处理会在旧请求完成时将新请求加入空闲槽位。这里的数学问题是你的槽位随时间保持多满,以及你能回收多少闲置容量。
6. Probability for Decoding(解码的概率)
采样设置对输出分布的影响
6.1 Softmax and temperature(Softmax 与温度)
Softmax 将原始分数转换为概率分布。温度在应用 softmax 之前对分数进行除法。低于 1 的温度会拉大最高选择与其余选项之间的差距,将概率集中在更少的 token 上。
高于 1 则会将分布摊平。当温度趋近于零时,你会收敛到总是选择得分最高的 token。
把它看作是对分布的重新塑形,而不是一个通用的创造力设置,会更容易推理为什么输出质量发生了变化。
6.2 Cutting off the tail(截断尾部)
Top-k 保留概率最高的 k 个 token。Top-p,又称核采样,保留概率之和达到 p 的最小 token 组。Min-p 保留概率高于最高 token 概率一定比例的 token。
这三种方法都会丢弃部分分布,然后重新归一化剩余部分,使其总和再次为 1。它们的区别在于决定在哪里截断,以及截断是否根据模型在该步骤的置信度进行自适应。
6.3 Entropy and perplexity(熵与困惑度)
熵衡量给定步骤中分布的分散程度,这使其成为模型不确定性的合理信号,也是自适应解码策略的有用输入。
困惑度是数据集上平均负对数概率的指数。这是人们在检查量化或优化改动是否损害模型时报告的标准数字。
6.4 KL divergence(KL 散度)
KL 散度衡量一个概率分布与另一个概率分布的差异程度。在实践中,你用它来比较优化模型的输出分布与原始模型在相同输入上的分布。较小的散度意味着你的加速是免费的。
较大的散度意味着你改变了模型的行为,即使基准分数碰巧看起来相似。
6.5 Speculative decoding(投机解码)
一个小而快的模型提前提出多个 token,大模型在一次遍历中验证所有这些 token。验证步骤使用拒绝采样,确保你最终接受的 token 严格遵循大模型自己会产生的分布。这一保证是有趣的部分,值得阅读推导过程。
预期的加速是一个计算而非猜测。它取决于草稿 token 被接受的概率、每一步提出的数量以及两个模型之间的成本比。如果不做这个计算,你很容易构建出比最初更慢的东西。
6.6 Reproducibility(可复现性)
浮点加法不满足结合律,因此以不同顺序相加同一组数字会得到略有不同的结果。改变批量大小会改变内核中值相加的顺序,从而改变 logits 的最后几位,偶尔会改变采样到的 token。
因此,相同的提示词和相同的种子在不同批量大小下可能产生不同的输出,这是由算术本身决定的,而非服务代码中的错误。
7. Statistics for Benchmarking(基准测试统计)
测量速度而不自欺
你看到的大多数已发布的推理基准都会犯以下错误之一:
7.1 Percentiles rather than averages(百分位数而非平均值)
报告中位数、第 95 百分位和第 99 百分位。平均值掩盖了表现不佳的请求,而用户感受到的是慢尾部而非均值。
请记住,估计第 99 百分位需要大量样本。如果你只运行了五十次请求,p99 只有一两个数据点,不应作为测量结果引用。
7.2 Report the phases separately(分别报告各阶段)
首 token 时间衡量用户在内容出现之前的等待时间,主要由提示词处理和排队时间决定。每个输出 token 的时间衡量之后的流式速度,主要由内存带宽决定。你还需要端到端延迟和整体吞吐量。
由于提示词处理和生成有不同的瓶颈,单一的每秒 token 数可能掩盖几乎所有内容,因此这些指标需要分别报告。
7.3 Noise(噪声)
你需要足够的基本统计量来区分改进与运行间波动。这意味着测量值的标准差和某种置信区间,这样当相同运行之间的噪声为百分之五时,百分之二的提升就不应被宣布为胜利。
另外,丢弃最初的几次运行。初始调用包含编译、内存分配和冷缓存,把它们混入平均值会让一切看起来更糟、噪声更大。
7.4 Load generation(负载生成)
无论先前请求是否完成,以固定速率发送请求,可以展示系统在跟不上时如何表现,包括队列如何堆积。
保持固定数量的工作线程,每个线程等待响应后再发送下一个,会掩盖这一点,因为慢响应会自动减慢发送速率。
需要特别阅读的陷阱是协调遗漏。如果你的负载生成器在等待慢响应时阻塞,那么在系统挣扎的确切时期它就不会发送请求,因此最差的延迟根本不会被记录。这会悄悄使许多已发布的数字失效。
8. Discrete Math and Bit Level Work(离散数学与位级操作)
阅读真实实现时遇到的小问题
8.1 Bit manipulation(位操作)
将两个 4 位值打包成一个字节,然后通过掩码和移位取回。写过一次就很简单,之前则令人困惑,所以写一次吧。
8.2 Powers of two and alignment(二的幂与对齐)
块大小为 16、64 或 128,原因与内存事务大小和矩阵单元形状相关。你需要向上取整除法、填充到倍数,以及对对齐要求的理解。算术很简单,性能影响却不简单。
8.3 Hashing and cache hit rates(哈希与缓存命中率)
检测两个请求是否共享提示词前缀通常涉及对 token 块进行哈希。你需要能够推理命中率以及给定命中率对有效吞吐量的影响,并基本理解用于存储共享前缀的树结构。
8.4 Complexity notation(复杂度记号)
足以让你注意到调度器或驱逐策略在做随活跃请求数二次方增长的工作。你不需要写证明,只需检查在千级并发请求下是否仍然没问题。
How I Learned This(我是如何学会这些的)
我并不是按照上面这个顺序学会这些东西的,你可能也不会。以下是如果现在开始,我会建议的路径。
1. 先建立框架
Horace He 的帖子《从第一性原理让深度学习跑得更快》把所有事情分为计算受限、内存受限和开销受限三类。先读这篇,因为你会用这个分类来组织其余的知识。
然后打开计算器,通读 kipply 的《Transformer 推理运算分析》。里面有实际公式和实际数字,亲自动手算一遍,才能从 “认得” 变成 “真正知道”。
2. 了解硬件在做什么
Kirk 和 Hwu 合著的《大规模并行处理器编程》是标准的 GPU 编程教材。即使你从不编写生产级内核,关于内存层次结构和分块(tiling)的章节也会改变你对成本的思考方式。
GPU MODE 系列讲座(原称 CUDA MODE)是免费的,展示了人们如何推理真实内核,这是书本上难以学到的东西。
对于 Hennessy 和 Patterson 的《计算机体系结构:量化研究方法》,不要试图通读。关于内存层次结构和性能测量的章节是 roofline 推理和 Amdahl 定律的来源,这些才是你需要的。
3. 浮点运算
David Goldberg 的《每个计算机科学家都应该了解的浮点运算知识》虽然年代久远,但仍是该主题最好的文章。内容比较密集,建议读两遍,而不是试图一遍吸收。
然后故意去搞坏一些东西。写一些会让 FP16 溢出的短脚本,展示长求和中的误差累积,让朴素 softmax 产生无穷大。十五分钟的动手实践比阅读教给我的更多。
4. 量化
先读一篇关于高效推理量化的综述论文以掌握术语,然后去读你实际使用的方法背后的论文。一旦 scale 和 zero point 的概念稳固了,这些论文大多可以一次读完。
我推荐的练习是在单个权重矩阵上自己实现量化和反量化,测量重建误差,然后从每个张量一个 scale 切换到每个通道一个 scale,观察误差下降。那个下午的收获比读论文还大。
5. 服务系统
读 FlashAttention 论文,重点在于分块和在线 softmax 的思想,而不是 CUDA 细节。它做的大部分事情是减少内存流量。
关于 PagedAttention 的 vLLM 论文最清楚地解释了为什么 KV 缓存内存管理,而不是原始计算,才是限制你能服务多少用户的瓶颈。
投机解码的论文值得一读,因为其中的拒绝采样论证是概率论中一个确实漂亮的片段。
6. 测量
Brendan Gregg 的《系统性能》与机器学习无关,这正是它有用的原因。它教你诚实地测量、认真对待尾延迟,并避免标准的基准测试错误。
另外,去查一下协调遗漏(coordinated omission)并阅读能找到的相关内容。这改变了我之后阅读所有延迟数据的方式。
The loop that made it stick(让知识扎根的循环)
阅读让我走了一段路,然后就停步不前了。真正有效的是这样的循环:
- 选择一个模型,手算出它的权重内存、每个 token 的 KV 缓存,以及在你的硬件上每个输出 token 的理论最小时间。
- 运行它,并测量同样的量。
- 搞清楚你的预测为什么错了。
第三步才是真正学习发生的地方。我的估计和测量之间的每一个差距都来自某个我还不知道的东西,而追查那个东西教给我的比最初的计算本身更多。
What You Can Leave Out(哪些内容可以跳过)
超出基础的优化理论是不需要的。收敛性保证、凸性和鞍点分析对训练很重要,而对于推理,模型的权重已经是固定的了。
同样,你可以跳过大部分贝叶斯统计,以及除 Little 定律和 4.5 节中的利用率警告之外的所有形式排队论。推导反向传播是很好的背景知识,但你在这里用不上。
那些看起来无聊但不可省略的内容是:浮点行为、算术强度和 roofline 推理、KV 缓存大小估算,以及使用百分位数的诚实测量。这四样会经常出现。清单上其余的内容是深度,你可以等到某个具体问题迫使你时再去补。
还有最后一件我花了一段时间才接受的事。训练路线图大多是微积分和概率,而这个路线图大多是数字节和估算时间。
如果你原本期待的是前一种数学,却感觉自己误入了一门系统课程,那这个感觉是对的,这个领域确实就是这样的。
