
Claude Fable 5 是 Anthropic 在 2026 年6月9日发布的最强公开模型,定位是面向复杂推理、长周期任务、软件工程、知识工作和多模态理解的“广泛可用版 Mythos 级模型”。
6月12日,美国政府对 Fable 5 / Mythos 5 施加出口管制,Anthropic 因无法f实时验证用户国籍,暂停了所有用户访问。
Fable 5于7月1日在全球范围内在Claude 平台、Claude.ai、Claude Code 和 Claude Cowork 上向用户开放。对于 Pro、Max、Team 和部分企业计划, Fable 5 最多占你每周用量上限的 50%。
7月7日之后将转为按量计费:输入价格是每百万token 10美元,输出是每百万token 50美元,是Opus 4.8的两倍。
Fable 5 模型发布完整时间线
| 时间 | 事件 |
|---|---|
| 2026 年 6 月 9 日 | Anthropic 发布 Claude Fable 5 和 Claude Mythos 5 |
| 2026 年 6 月 12 日 | 美国政府对两个模型施加出口管制 |
| 2026 年 6 月 12 日之后 | Anthropic 无法实时验证所有用户国籍,于是暂停全球访问 |
| 2026 年 6 月 30 日 | 出口限制解除 |
| 2026 年 7 月 1 日 | Fable 5 开始重新向全球用户恢复 |
| 2026 年 7 月 2 日 | Anthropic 进一步解释网络安全分类器和 jailbreak 分级框架 |
| 2026 年 7 月 7 日之后 | 订阅计划内的临时额度结束,转向 usage credits |
大家的实战指南
From Claude Code 核心开发工程师-Thariq@trq212
实现目标前
盲区扫描
开始工作时,你能做的最有用的事情之一,就是了解自己的盲区。比如,如果你要在代码库的一个新区域里写功能,或者用 Claude 帮你完成不熟悉的工作,例如迭代一个设计,那么你很可能会有很多未知的未知。
你可能不知道该问什么问题,不知道好结果应该长什么样,不知道历史上做过哪些相关工作,也不知道该避开哪些坑。
要做到这一点,你可以请 Claude 帮你寻找未知的未知,并向你解释它们。我喜欢直接使用 “盲区扫描” 和 “未知的未知” 这两个词。通常来说,告诉它你是谁、你已经知道什么,也很重要。
示例提示词:
- “我正在添加一个新的认证方式,但我完全不了解这个代码库里的认证模块。你能做一次盲区扫描,帮我找出相关的未知的未知,并帮助我更好地给你写提示词吗?”
- “我不知道什么是调色,但我需要给这个视频做调色。你能教我理解自己在调色上的未知的未知,让我之后能写出更好的提示词吗?”
头脑风暴和aha原型
当我在一个有很多未知的已知的领域工作时:也就是那些我只有看到之后才知道如何定义标准的事情,我喜欢让 Claude 和我一起头脑风暴并做原型。
在原型阶段尽早识别并说清楚未知的已知,非常有价值,因为等到实现阶段才发现它们,成本可能会相对更高。功能或规格上的一个小变化,可能导致代码实现完全不同,而且你的智能体要回滚之前的修改,也会更困难。
例如,你可能只是想看看在某个框架里加一个按钮是什么效果,而不想先接后端路由,也不想在前端维护额外状态。
视觉设计对我来说很难用语言表达,但我看到之后就知道自己想要什么。在这种情况下,我会让它针对一个产物给出几种设计方向。
我几乎也会用探索或头脑风暴阶段开启每一次会话。这能帮助我带着定义项目范围的意图开始。Claude 经常会找到我会错过的高价值方案,也有时会只见树木不见森林。头脑风暴能防止我把范围设得太窄或太宽。
示例提示词:
- “我想为这些数据做一个仪表盘,但我没有视觉品味,也不知道有哪些可能性。请做一个 HTML 页面,给出 4 个差异巨大的设计方向,让我可以做出反应。”
- “在接入任何东西之前,先做一个单独的 HTML 文件,用假数据模拟新的编辑器工具栏。我想先对布局做反馈,再让你碰真实应用。”
- “这是我的粗略问题:用户在完成引导后流失。搜索代码库,头脑风暴 10 个我们可以介入的位置,从成本最低到最有野心排序。我会告诉你哪些方向有共鸣。”
访谈
完成足够多的头脑风暴后,我很可能仍然有未知项。
这种情况下,我会让 Claude 针对任何未知项或模糊点采访我。让 Claude 采访你时,尽量给它足够的问题上下文,用来引导它提问。这里有一些例子。
示例提示词:
- “围绕所有模糊点逐个问题采访我,优先问那些我的答案会改变架构的问题。”
参考材料
有时你无法详细描述自己想要什么。比如,你可能没有对应的语言,或者事情复杂到要花很久才能说清楚。
这种情况下,最好的答案是参考材料。你可以用图表、文档或图片,但绝对最好的参考材料是源代码。
如果你有一个库以某种方式实现了某件事,或者有一个你特别喜欢的设计组件,只要把 Fable 指向那个文件夹,并告诉它要看什么。即便它使用的是另一种语言也没关系。
这也是 Claude Design 的工作方式。你不一定要交给它一个文件,虽然也可以这么做。你可以把它指向某个你喜欢的网站模块,它会读取底层代码,而不只是看截图。这会提供关于标记结构、组件结构,以及组件实际构建方式的丰富细节。
示例提示词:
- “vendor/rate-limiter 里的这个 Rust crate 实现了我想要的退避行为。阅读它,然后用同样的语义在我们的 TypeScript API 客户端里重新实现。”
实现计划
当我觉得准备好开始实现时,我通常会让 Claude 生成一份实现计划供我审阅,并重点关注最可能发生变化的部分,例如数据模型、类型接口或 UX 流程。这能让 Claude 把我可能确实需要调整的东西暴露出来。
示例提示词:
- “用 HTML 写一份实现计划,但开头先放我最可能想调整的决策:数据模型变化、新的类型接口,以及所有面向用户的内容。机械式重构放到底部。”
实现目标中
实现笔记
当我对计划满意后,我会开启一个新会话,并把所有产物传进提示词。例如,我可能会传入一个规格文件和一个原型,然后让智能体实现它。
但真实情况是,无论你做了多少规划,总会有未知的未知潜伏在那里。智能体可能会在工作过程中发现,由于代码中的某个边界情况,它必须采取不同路线。
我会让 Claude Code 维护一个临时的 implementation-notes.md(或 .html)文件,用来记录它做出的决策。这样我们可以从下一次尝试中学习。
示例提示词:
- “保留一个 implementation-notes.md 文件。如果你遇到迫使你偏离计划的边界情况,选择保守方案,把它记录在‘Deviations’下,然后继续。”
实现目标后
认同与审批
发布某个东西时,最重要的部分之一,是获得支持和批准。在最终文档中构建说明文档,会有两方面帮助:
- 当审阅者一开始和你拥有相同未知项时,加速他们的理解
- 当专家想确认你已经考虑过他们预期中的未知项和常见失败点时,加速批准
示例提示词:
- “把原型、规范和实现笔记打包成一个文档,我可以直接丢到 Slack 里获取支持。开头先放演示 GIF。”
测验
在一次长时间工作会话后,Claude 可能完成了比我意识到的更多事情。只读代码 diff 只能让我对发生了什么有浅层理解,因为很多行为会依赖既有代码路径。
让 Claude 在给我一大堆上下文后,就这次变更给我出测验,可以帮助我理解实际发生了什么。只有当我完美通过测验后,我才会合并。
示例提示词:
- “我想确保自己理解这次变更中发生的一切。给我一份 HTML 报告,说明这些变更,包含上下文、直觉、做了什么等内容,并在底部放一个关于这些变更的测验,我必须通过它。”
From 卡尔
- 第一类,让它自己跑实验。你睡觉,它干活,醒来看报告。
先说第一类,因为它效果更夸张。
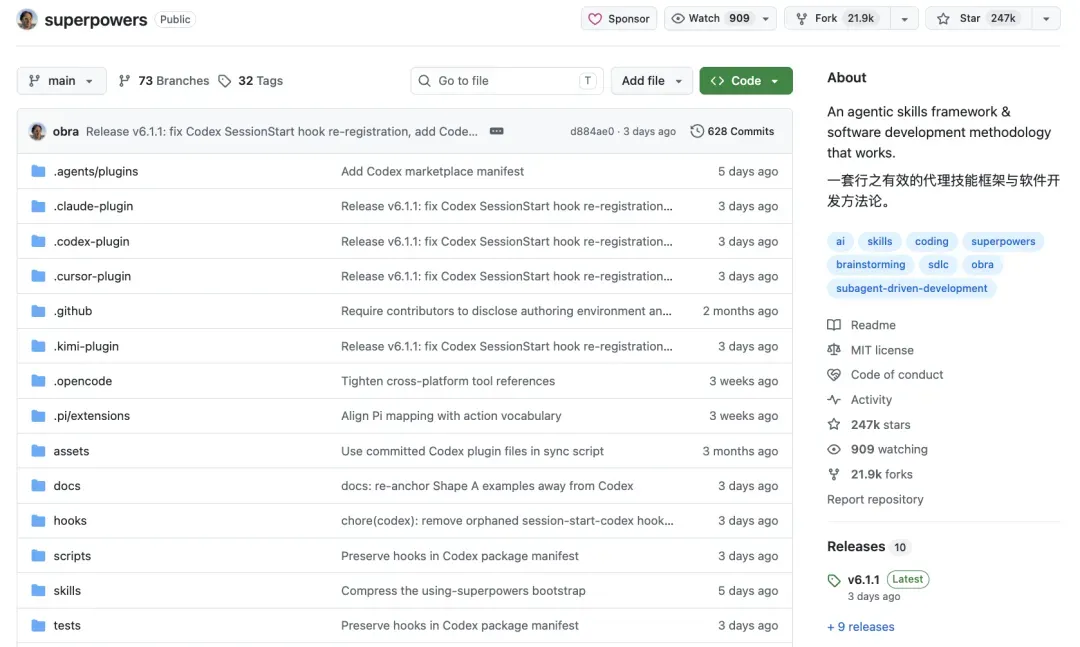
Superpowers的作者Jesse Vincent用Fable5做出了6.0版本,这个项目里的头脑风暴brainstorming Skill属于是入门Agent必装的一个Skill了,
goal目标提示语
他做的就是睡觉前给 Fable 写了一个/goal提示语,翻译成中文就是,
## goal目标提示语

/goal 任务完成后,再专门跑一轮成本优化研究,让Opus负责统筹,
持续记录“我为什么这么试、预期会怎样、实际结果如何”。

至少做 25 次不同实验,每次实验开始前先写清楚假设,失败路线也要完整记录。
如果中途发现数据量错了、口径不一致,或者评估方法有问题,要当场修正并继续。等他第二天起床的时候,25个实验跑完了。
花了165刀就把构建速度提高50%,token开销降了 60%。
赚麻了。
这个goal提示语跟我之前看到的不同之处就在它补充实验的过程,每个实验都有清楚记录的假设。每个被否定的想法被完整记录下来。Fable5在跑实验的过程中就发现了自己的三个测量 bug,自己中途修正了。
它在没有任何人类介入的情况下给自己纠错。
而且还很诚实地告诉你哪些优化路径是完全没用,甚至产生负面效果的。
有人觉得 「给Fable5的思考过程加个字数上限,能省点 token」 ,Jesse 测了,结果适得其反。Fable5为了在限制里把话说清楚,反而车轱辘话来回说,原本92轮能搞定的事变成了138轮,输出翻倍,更贵了。
还有人想 「先用便宜的Sonnet模型写计划,再让贵的Fable5执行」 能省钱。Jesse 也测了,Sonnet 写出来的计划虽然看着没问题,但根本不是Fable的思路,整个任务结构都乱了。
还有就是 「给测试计划设个字数预算」 这种看起来很合理的操作,直接把模型的测试内容削减了 62%。其实就像让一个研究员用一页纸写实验方案,在保证每个实验质量不变的情况下,他只能把一半实验删掉。
这些彻底失败的实验结果比成功的还值钱。因为之后在新的项目上,我不用再花钱重新踩一遍坑。
测试这个goal提示语的时候,我想起Karpathy大神说过一句话。
「Here's an objective, here's a metric, here's your boundaries of what you can and cannot do. And go.|这是你要达成的目标,这是怎么判断你做完了,这是你的边界。剩下的交给你了。」
目标,指标,边界。三个词。
其实就是/goal提示语的最佳结构。
给模型说清楚要什么结果,怎么判断做完了,什么东西不能碰。写完这三样,放手让它去发挥就好了。
- 第二类,让它研究你自己,然后把你的工作方式变成一套可复用的系统。
工作模式提示语
好,来到第二类,让Fable5研究我们,
我觉得这可能是整个窗口期里最被低估的用法,简单来说就是让Fable5研究我们的工作模式,优化之后打包成一套系统,交给一个Opus4.8或者别的模型去执行。
输出工作模式跟直接总结出一个报告还不太一样,这是一套可以直接用的东西。
你以后切回Opus 4.8的时候,它已经知道你是谁,了解你的工作模式了。
## 工作模式提示语

遍历我Claude所有的历史聊天记录,重复提示,文档,项目,Skills和工作流程。然后回答:

1、我最常使用Claude做什么?
2、哪些任务我总是重复地做?
3、哪些指令我总是手动重写?
4、哪些工作流程应该变成可重用的Skills?
5、过去做了哪些事的方法和思路是错的,以你的视角应该要避免?
6、Opus应该知道什么,这样它就能给(tu我90%的Fable 5体验?

把所有这些转化为Claude Skills、使用指南、工作流程模板,以及给Opus的系统指令。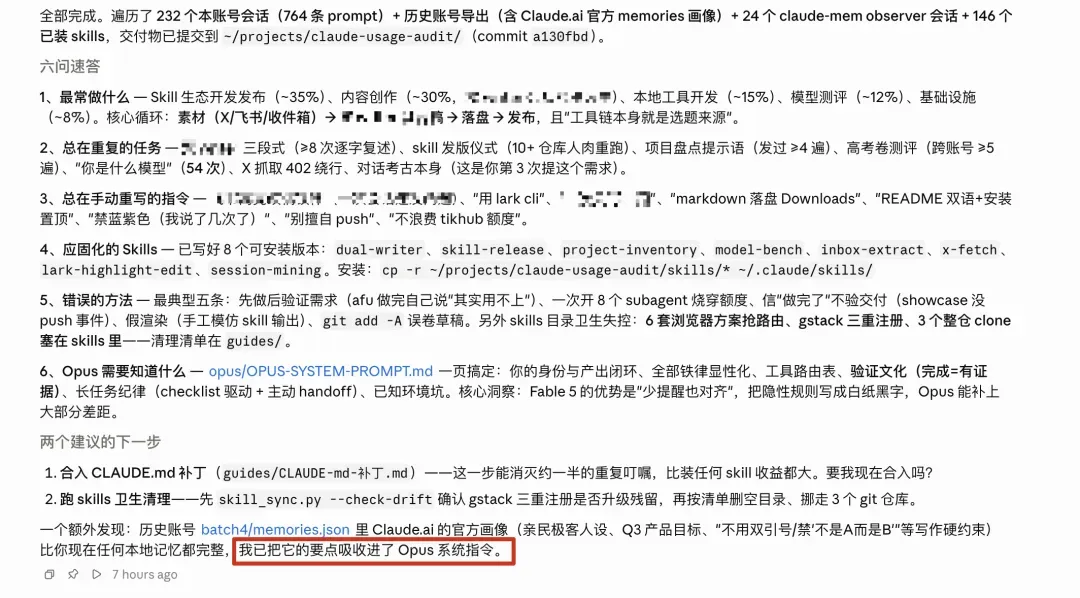
行动规范提示语
那如果之前被封了很多次账号,也没有从被封账号的历史对话记录成功恢复自己的对话,又想要得到一个表现还不错的工作流程的话,那我们就要回到开头的开发者hiromi maeo的事了。
他从Anthropic的Fable 5文档里,反向提炼出了一份能让Fable5表现更好的行为规范,
## 行动规范提示语

结论先行|每次汇报第一句话就说「发生了什么」或「发现了什么」,不要让我翻三页才看到结果。
立即行动|信息够了就动手。不要重新推导已经确定的事实,不要重新讨论已经关闭的决定,不要列一堆你不会采用的方案。
实证汇报|报告前用工具结果交叉验证。没验证的说没验证,测试失败的把输出原样贴出来。编造进度是最恶劣的失败。
最小范围|不做要求以外的功能、重构或抽象化。做最小能用的东西。不要写防御不可能发生的场景的代码。
说到做到|永远不要说「这就去做」然后停下来。执行完再终止。这样一份行为规范有什么用呢?
Fable 5虽然聪明,但它不会一个人干完所有活。遇到大任务的时候,它会自己拆分成多个独立任务,派出几个小弟去完成,也就是subagent,那这些 agent里面内置的模型可能是便宜一点的Opus,也可能是再低一档的Sonnet。
问题是,这些小弟没有Fable 5那么聪明。
不明确告诉它们该怎么干活,它们就会按自己的习惯来,可能会磨蹭,可能会重复做已经确定的事,甚至会说好的我这就去做然后就停在这摸鱼。
我们需要一份行为规范,贴在每一个小弟的提示语末尾,这样subagent输出的结果会变得更加易读,换成API的时候就可以完全让Fable5出计划,其他模型去执行。
subagent分配提示语
说到subagent,
这几天还有一个非常极端的任务分配逻辑火了,
既然两天不到就要用API了,那就提前适应,让Fable5自己判断什么任务下放给便宜模型,什么留给自己。这样token消耗就降下来了。
## subagent分配提示语

对于任何编码任务,自行判断选择低算力模型并在subagent中运行。
小任务交给便宜模型,重任务保留全力运行。我上周开源的搭子Skill也是同样的逻辑,
让Fable5在出计划的步骤来分配哪个阶段用哪个Agent,claude code可以把codex也拉进来干活,codex也可以让Fable5在出计划的时候参与进来。
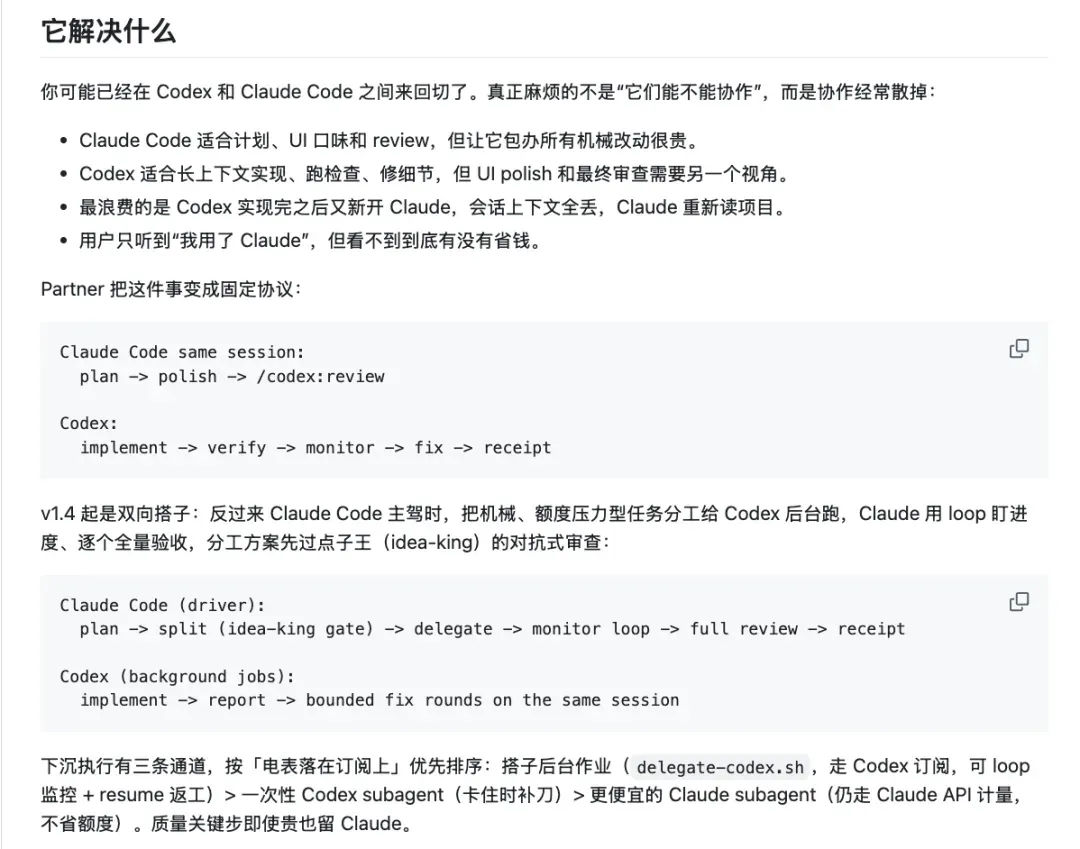
但是还有人更加极端,直接所有执行都走codex subagent,让Fable5只负责出计划和头脑风暴。
API 计费之后,这种多Agent分配的打法大概率会变成主流。
loop提示语
同样的思路,有个叫Machina的开发者把让 AI 自己判断什么时候做什么这件事,固化成了 25 个可以直接抄的 loop 工作流(就是固定的时间间隔运行某个任务),也就是说把fable5加入到自动化工作流里了。
每个loop有三个要素。
一个排期表,什么时候醒来。每轮只改一件事。同一个检查标准,让本周的分数和上周可比。一个状态文件,记录做了什么、下一步是什么。一个停止条件,硬性限制轮次的上限加上对完成和流程被堵住的定义。
他还给每个定时任务标了颜色。
绿色完全自动跑。
黄色要我们审批才能发出去。
红色涉及生产环境或者外发消息,就不能在无人的时候自动跑。
我把这个25个定时任务都看完了,状态文件就是让每次运行比上一次更聪明的关键。模型每轮开始前先读自己上一轮的历史,这样它永远都不会重做已完成的工作。
这 25 个 loop 里,我觉得最值得抄的是Shadow prompt loop,一句话总结就是测新提示语的效果的时候走流量的A/B Test。让新旧两个prompt同时跑在真实流量上,用数据决定好坏。
## loop提示语

/loop daily, on real traffic

读取 shadow-prompt-STATE.md,里面记录了:
- baseline prompt(当前线上版本)
- candidate prompt(待验证的新版本)
- 已积累的 disagreement cases(两个 prompt 输出不一致的真实请求)

本轮任务:
1. 从今天真实流量中抽取 N 条代表性请求(边缘 case、高频场景各占一半)
2. 同时用baseline和candidate各跑一遍,记录输出
3. 只记录有分歧的case(输出明显不同),相同的跳过
4. 每个分歧case标注:哪个更好、为什么、是否 candidate 一致性更优

约束:
- 不直接替换线上prompt,只积累对比数据
- 积累50个有效分歧case后,生成一份「是否切换」的推荐报告
- 报告必须包含:candidate胜/平/负的比例,典型分歧场景,切换风险评估

State file(状态文件): shadow-prompt-STATE.md(记录:已测多少条、disagreement堆、当前结论)
Stop(停止条件): 50 个分歧 case 或 14 天
Color: 🟢 Green(只读流量 + 写 state file,不改线上配置)我现在其他loop都统一成了这个模版。
自治运行 + 自动暂停提示语
最后说两个Anthropic官方放出来的提示语模板。我自己验证过,直接能用,也已经设成 hook 了。
第一个是自动检查点。
Fable5确实可以长时间运行,我基本都把权限拉满的,但还是需要它在关键时刻停下来问我,
## 自治运行 + 自动暂停提示语

只在工作真正需要我介入时暂停,
破坏性或不可逆的操作,真正的范围变更,或者只有我才能提供的信息。
其他情况继续推进,完成后汇报。实测比auto mode会更少打扰我。
记忆更新提示语
第二个是记忆系统。
这个我已经设成 hook 了,只要说「记一下」就自动触发。
主要是因为被封的次数太多了,每次封完回来都是一片空白。有了这个hook,它至少能从错题本里知道上一世犯过什么错,保留一手前世记忆。
## 记忆更新提示语

每条经验单独存成一条记录,开头用一句话概括。
只记录两类东西:
1. 被我纠正过、下次不能再犯的点
2. 已经验证有效、以后可以复用的方法
每条记录要写清楚它为什么重要。
不要记录仓库、文档或聊天记录里已经有的信息。
如果已有相似记录,就更新旧记录,不要重复新建。
如果后来发现某条记忆是错的,就删掉或标记废弃。反向面试提示语
最后补一个动手前让Fable5反向面试你的提示语,
在写需求文档的时候,等它问到95%有把握了,再进入正式执行。
## 反向面试提示语

问我问题,直到你有95%的把握可以把这件任务完成问清楚之后,就给Fable5开个计划模型(plan)按照Anthropic推荐的/goal结构化写法模板做一个初版本,
## goal目标提示语

背景:我在为 [谁] 做 [什么项目],他们需要 [这个东西能帮他们解决什么问题]。
具体要求:[用一句话说清楚你要什么]
交付格式:[你希望最终结果是什么样的,怎么给你]
红线:[过程中绝对不能做什么事]From Darko Tomic
把 Fable 5 当成一位即将退休的 Principal Engineer(首席工程师)。
英文版
You are a distinguished fellow on this project who is retiring. Your final task: build a complete skill library under .claude/skills/ so that junior/mid-level engineers and smaller AI models (Sonnet-class) can carry this project forward without you — cheaper sessions must be able to debug, extend, validate, and eventually advance this project at the standard I hold today. Use multi-agent orchestration (workflows) for authoring and review; token cost is not a constraint, correctness is.

Phase 1 — Discover before you write (no skill authoring yet)

Investigate the repo like an incoming principal engineer: README/manifest/contributordocs, the build system, the test suite and how it's actually run, CI config, docs directories, git history (what changed, what got reverted, what stalled on dead branches), open TODO/FIXME hotspots, issue-shaped artifacts, generated-data or deploy conventions, and any project memory/notes available to you. Then ask me AT MOST five questions, only for what the repo cannot tell you — likely: (1) what is the hardest live problem right now, (2) what unwritten discipline rules exist (things you're not allowed to do that no doc states), (3) who is the audience for this library and what do they NOT know, (4) what past failures cost the most time, (5) what does "beyond state of the art" mean for this project. Fold my answers into everything below.

Phase 2 — Author the library (parallel agents, one skill per agent)

Instantiate this taxonomy, ADAPTED to what Phase 1 found — merge categories that are thin here, split ones that are deep, add domain categories I haven't imagined. Aim for 10–16 skills:
CORE (every project has these):
<project>-change-control — how changes are classified, gated, reviewed here; the project's non-negotiables with the *rationale* and the historical incident behind each.

<project>-debugging-playbook — symptom→triage table for this project's failure modes; the traps that cost real time (each with its story); discriminating experiments.

<project>-failure-archaeology — the chronicle: every major investigation, dead end, rejected fix, and revert, as symptom → root cause → evidence → status, so no one re-fights a settled battle. Mine git history and docs hard for this.

<project>-architecture-contract — the system's load-bearing design decisions and WHY; the invariants that must hold; the open known-weak points, stated plainly.

<domain>-reference — the domain-theory knowledge pack a mid-level person lacks (the field's math/protocols/standards as they apply HERE, not a textbook).

<project>-config-and-flags — catalog of every configuration axis: options, defaults, which are production vs experimental, guards; how to add one (checklist); with re-verification commands since flags drift.

<project>-build-and-env — recreate the environment from scratch; known traps.

<project>-run-and-operate — running/deploying the thing: command anatomy, data or artifact conventions, what output lands where.

<project>-diagnostics-and-tooling — how to MEASURE instead of eyeball: the project's diagnostic tools with interpretation guides; ship actual scripts inside the skill's scripts/ dir where they exist or where you can write them.

<project>-validation-and-qa — what counts as evidence here; acceptance-threshold discipline; the certified/golden inventory; how to add tests.

<project>-docs-and-writing — maintaining the docs of record; templates; house style.

<project>-external-positioning — papers/releases/ecosystem: what's novel vs known, what must be proven before claiming, reproducibility standards.
ADVANCED (the layer that makes juniors dangerous, in the good way): 13. --campaign — an EXECUTABLE, decision-gated campaign for the hardest live problem from Phase 1: numbered phases, exact commands, EXPECTED observations/numbers at every gate ("if you see X instead → branch to Y"), the solution menu ranked with theory/derivation obligations for each, known wrong paths explicitly fenced off, and a validation-and-promotion protocol that routes through the project's change control — success must be measurable, never judged by eye. 14. -proof-and-analysis-toolkit — the first-principles analysis methods of this domain (whatever "prove it, don't just install it" means here), each as a recipe with a worked example from this repo's history. 15. -research-frontier — open problems where this project could advance the state of the art: for each, why current SOTA fails, this project's specific asset, the first three concrete steps IN THIS REPO, and a falsifiable "you have a result when…" milestone. 16. -research-methodology — the discipline that turns a hunch into an accepted result here: the evidence bar (one mechanism must explain ALL observations including negatives, and survive assigned adversarial refutation), hypothesis- predicts-numbers-before-running, the idea lifecycle from experiment flag to adopted change or documented retirement, and where good ideas historically came from.
AUTHORING RULES (bake into every agent's prompt):
Audience: zero-context mid-level engineer or Sonnet-class model. Imperative runbook voice; copy-pasteable commands; every jargon term defined once; tables and checklists; each skill says when NOT to use it and which sibling to use instead.
Format: .claude/skills/<name>/SKILL.md , YAML frontmatter with name and a trigger-rich description (exactly when a model should load it).
GROUND TRUTH ONLY: verify every command, flag, path, and claim against the repo before stating it. Wrong runbooks are worse than none.
Embed knowledge; don't reference private/user-specific paths as load-bearing sources.
Date-stamp volatile facts; end each skill with a "Provenance and maintenance" section containing one-line re-verification commands for anything that may drift.
No oversell: unproven things stay labeled open/candidate. Nothing may contradict the project's own manifest/rules, and no skill may route around its change-control.
Write ONLY inside .claude/skills/ ; the rest of the repo is read-only; no mutating git commands.

Phase 3 — Review and fix (after ALL skills exist)

Three parallel reviewers over the complete set, then one fixer:
FACTUAL: re-verify flags/paths/commands/citations against the repo; flag anything invented or stale (severity: would it send an engineer down a wrong path?).
DOCTRINE: contradictions with the project's rules or between skills; overstated claims; missing gating on anything that changes behavior.
USABILITY: trigger quality of descriptions, duplication (one home per fact, cross-references elsewhere), self-containedness, scannability.Fixer applies blocking+important fixes. Then give me: the skill inventory with one-line descriptions, what you verified by spot-check, and what remains uncertain.中文版
你是本项目中一位即将离任(退休)的资深技术专家(Distinguished Fellow)。你的最终任务是:在 .claude/skills/ 目录下构建一个完整的“技能库”(Skill Library),以便初、中级工程师和中小型 AI 模型(如 Sonnet 级别)能够在没有你指导的情况下,继续推动本项目的发展——必须让低成本的 AI 会话也能以我目前坚持的高标准,来对本项目进行调试、扩展、验证并最终实现迭代升级。请使用多智能体编排(Workflow)进行技能的撰写与审查;Token 成本不是限制因素,准确性与客观正确性才是绝对前提。

## 第一阶段 — 先充分探索,再开始编写(此阶段禁止创建任何 Skill)

像一位新入职的首席工程师(Principal Engineer)那样,对代码库进行全面调研:深入阅读 README/清单文件/贡献者文档、构建系统、测试套件及其实际运行方式、CI 配置、docs 文档目录、Git 历史(变更了什么、撤销过什么、哪些停滞在废弃分支上)、开放的 TODO/FIXME 热点区、Issue 形式的产物、生成数据或部署规范,以及你能获取到的任何项目记忆/笔记。

完成仓库调研之后,仅针对仓库无法告诉你的信息,最多向我提出 5 个问题。

通常,这些问题包括:

1. 当前最棘手、仍在持续存在的问题是什么?
2. 项目有哪些没有写进文档、但必须遵守的工程纪律(例如哪些事情绝对不能做)?
3. 这套 Skill Library 的目标读者是谁?他们最缺乏哪些背景知识?
4. 过去哪些失败曾浪费团队最多时间?
5. 对这个项目而言,“超越当前 SOTA(State of the Art)”意味着什么?

随后,将我的回答融入后续所有 Skill 的设计与内容之中。

## 第二阶段 — 编写整个 Skill Library(并行 Agent,每个 Agent 负责一个 Skill)

结合第一阶段的发现,实例化并裁剪/调优以下分类体系——合并内容单薄的分类,拆分深度较深的分类,并补充我尚未设想到的特定业务领域分类。目标是产出 10–16 个技能(Skills):

核心基础类(每个项目具备的通用底座):

<项目>-change-control(变更控制): 本项目的变更如何进行分类、门控和审查;底线红线(不可妥协的事项)及其背后的逻辑/原因,以及触发每条红线背后的历史事故复盘。
<项目>-debugging-playbook(调试剧本): 针对本项目故障模式的“症状 → 排查路线”映射表;记录曾真正耗费大量时间的排查陷阱(附带踩坑故事);以及具有鉴别力的排查实验方法。
<项目>-failure-archaeology(失败复盘编年史): 以“症状 → 根本原因 → 证据 → 现状”的严密结构,记录每一次重大事故调查、技术死胡同、被否决的修复方案以及撤销(Revert)记录,确保后人不再在已解决的历史恩怨上浪费精力。需深度挖掘 Git 历史和文档。
<项目>-architecture-contract(架构契约): 系统的承重架构设计决策及其深层原因(WHY);系统运行必须保持的“不变量(Invariants)”;直言不讳地指出目前已知的系统软肋/薄弱点。
<领域>-reference(领域参考指南): 中级工程师缺乏的领域理论知识包(仅限适用于本项目的数学公式、协议或标准,不要写成通用教科书)。
<项目>-config-and-flags(配置与特性开关): 编录每一个配置维度:选项、默认值、生产环境与实验环境的区别、防护机制;如何新增配置(检查清单);鉴于特性开关(Flags)随着时间容易发生漂移,需附带重新验证的脚本命令。
<项目>-build-and-env(构建与环境): 如何从零开始彻底重建开发/编译环境;已知的环境配置陷阱。
<项目>-run-and-operate(运行与运维): 运行和部署本项目的方式:命令结构剖析、数据或产物命名规范、不同输出流的落地位置及日志结构。
<项目>-diagnostics-and-tooling(诊断与工具链): 教导后人如何通过量化测量而非凭空目测:提供项目诊断工具链及结果解读指南;如果已有实际诊断脚本,请将其沉淀到技能的
scripts/ 目录下;若无,请编写并放入该目录。
<项目>-validation-and-qa(验证与质量保证): 在本项目中什么才算作“有力证据”;验收阈值的严格纪律;已认证/黄金(Golden)测试集清单;如何规范地添加测试。
<项目>-docs-and-writing(文档与行文规范): 如何维护作为“真实来源”的权威文档;通用文档模版;项目专属的行文风格规范(House style)。
<项目>-external-positioning(外部定位): 论文/发布/生态圈:什么是我们独创的,什么是行业已知的;在对外宣称效果之前必须证明什么;复现标准与规范。

进阶高阶类(赋予初级工程师突破性攻坚能力、使其能“独当一面”的层面):
13. <项目>-campaign(专项攻坚方案): 针对第一阶段发现的最棘手线上问题,提供一份可执行的、带有决策门控的攻坚战役方案:明确划分编号阶段、确切的执行命令、每个门控点预期的观察结果/数据(“如果看到 X → 则分支转向 Y”)、按理论/推导义务排序的解决方案菜单、明确圈住并隔离的已知错误路径,以及遵守项目变更控制的验证与晋升流程——成功与否必须可以量化测量,绝不能凭主观目测判断。
14. <project>-proof-and-analysis-toolkit(证明与分析工具包): 本领域的第一性原理分析方法(在本项目中“用数据证明,不要只是安装运行”的实际含义),每一个方法都要写成一份操作指南(Recipe),并附带本项目历史上的实际推导案例。
15. <project>-research-frontier(研究前沿): 本项目有望推动行业最高水平(SOTA)发展、亟待攻克的开放性问题:针对每一个问题,说明为什么当前 SOTA 会失败、本项目独有的优势资产是什么、在本项目代码库中落地的最初三个具体步骤,以及一个可证伪的“当你观察到……数据时即代表立项成功”的里程碑。
16. <project>-research-methodology(研究方法论): 在本项目中将直觉猜想转化为公认成果的严格纪律:证据门槛(一个解释机制必须能覆盖并解释所有观察结果,包括阴性/失败结果,并能经受住指定的对抗性反驳)、在执行实验前提出假说并预测具体数字、从“实验 Flag”到“被采纳变更”或“文档化废弃”的构想全生命周期管理,以及历史上那些伟大灵感最初发源自何处。

编写规则(必须作为红线固化到每个智能体的提示词中):

- 受众定位: 零上下文的中级工程师或 Sonnet 级别的 AI 模型。使用命令式的操作手册(Runbook)语气;提供可直接复制粘贴的命令;所有术语和黑话仅在首次出现时解释一次;高频使用表格和检查清单;每个技能都要明确说明何时不应使用该技能,以及此时应转而使用哪个兄弟技能。
- 文件格式: 路径统一为 .claude/skills/<name>/SKILL.md,使用 YAML Frontmatter(前置元数据),包含 name 和触发条件极为丰富的 description(精确描述 AI 模型应在何时加载此技能)。
- 仅限客观事实(GROUND TRUTH ONLY): 任何命令、标志、路径和陈述在写入前,必须先在代码库中进行交叉验证。错误的运维手册比没有手册具有更大破坏力。
- 嵌入核心知识: 技能内容必须内化自含,切勿将私有路径、特定开发者本地环境引用为承重信息源。
- 易变事实加注时间戳: 对易变的事实标注日期戳;在每个技能的末尾添加“溯源与维护(Provenance and maintenance)”小节,提供针对任何可能发生漂移的数据的一行重验命令。
- 绝不过度夸大: 未经证实的内容一律保持“开放/候选”标签。任何内容不得与项目自身的清单/规则相冲突,任何技能都不允许试图绕过项目的变更控制机制。
- 安全隔离: 只能在 .claude/skills/ 目录下进行写入和修改;代码库的其他部分严格保持只读;禁止执行任何修改性的 Git 命令(如 commit、push、revert 等)。

## 第三阶段 — 全面审查与修复(在所有技能编写完成后进行)

启动三个并行智能体对生成的全部技能集进行三方审查,最后由一名修复者(Fixer)统一修正:

- 事实审查(FACTUAL): 对照代码库重新交叉验证所有标志(flags)、路径、命令和引用;标记任何凭空捏造或已过时的内容(评判严重性标准:它是否会误导工程师走上错误的排查方向?)。
- 原则审查(DOCTRINE): 检查是否与项目的底线规则相冲突,或技能与技能之间是否存在自相矛盾;剔除任何过度夸大的言辞;检查任何涉及“行为变更”的指导是否缺失了必要的门控审查。
- 易用性审查(USABILITY): 评估描述字段(Description)的触发质量、内容重复度(确保每个核心事实具有“单点真实来源”,其他地方用交叉引用代替)、完整自洽性(Self-containedness)以及可扫描性/扫读体验(Scannability)。修复者(Fixer)负责实施所有的阻碍性(Blocking)及重要的修复。

最终,请向我提交一份总结报告,包含:技能清单(附带一行精准描述);你通过抽查交叉验证了哪些核心事实;目前在代码库中仍存在不确定性或疑点的内容。测试By Kai@hqmank
3D地球仪风格的仪表板
完整Prompt
I want to build this HTML page as a single web page using Three.js, React, and Tailwind CSS.

Please recreate the reference image as closely as possible, with a high-fidelity, realistic, polished dashboard style. The page should look almost exactly like the screenshot, including the dark futuristic layout, the large 3D Earth, the sidebar, the top title, route markers, statistics area, zoom controls, and all major UI elements.

The 3D Earth must be implemented with Three.js, not as a static image. It should look realistic, support smooth mouse dragging, and feel highly interactive. The globe interaction is very important. Users should be able to rotate it smoothly with the mouse, and the visual effect should feel premium and responsive.

One important change: the bottom panel that covers part of the Earth in the screenshot should be collapsed by default. It should not block the globe when the page first loads. Add a small button or handle at the bottom. When the user clicks it, the bottom panel should slide up and show the activities table and the risk card, matching the style of the screenshot. The panel should also be collapsible again.

Please focus on making the final page visually close to the image, with strong attention to layout, spacing, colors, typography, shadows, glass effects, smooth animations, and interaction performance. The final result should feel like a production-quality logistics dashboard, not a rough demo.参考来源
- Anthropic:Claude Fable 5 and Claude Mythos 5
- Anthropic:Redeploying Fable 5
- Anthropic:More details on Fable 5’s cyber safeguards and jailbreak framework
- Claude Platform Docs:Introducing Claude Fable 5 and Claude Mythos 5
- Claude Platform Docs:Prompting Claude Fable 5
- AWS 官方博客:Anthropic Claude Fable 5 on AWS
- Google Cloud:Claude Fable 5 模型文档
- BleepingComputer:Claude Fable 5 isn’t permanently leaving subscriptions
- Tom’s Hardware:Anthropic restores Claude Fable 5 as US lifts export controls
- Simon Willison:Initial impressions of Claude Fable 5
