
ATLAS CLOUD · 实操教程
看到一个爆款玩法,只能自己从头抽卡
热门视频,任意复刻
万物皆可替换的白模模板
GPT-6 白模 · Seedance 2.5 R2V · GPT Image 2.5 素材
怎么用起来
两种上手方式
白模负责「在哪、什么时候」,模型负责「长什么样、怎么演」
这种「意外碰撞+升格慢放」的玩法,最近超级火🔥。
我也想做。但真上手写提示词才发现,这玩意儿纯靠文字是控不住的。人往哪边偏、东西往哪个方向飞、镜头先追谁后追谁,每抽一次都不一样。你想要的那一下撞击,可能得抽十几次才碰上。
所以我换了个做法:先用 GPT-6 做一段白模,把「怎么撞」这件事从提示词里搬出来,交给一段视频。
做完这一次,人物、手里拿的东西、脸上戴的、整个场景,后面全都可以换。这篇就是这条链路的完整拆解。
01
PART
为什么这个玩法得先有白模
WHY · 外观好控,调度不好控
先说清楚白模解决的是什么。
视频模型现在对「外观」的控制力已经挺好了,你给一张参考图,人脸、衣服、材质都能还原得挺准。但对调度的控制力是另一回事。
调度指的是这些:摄影机从哪儿起、怎么运、停在哪儿;人站在画面的哪一侧、朝哪个方向走;碰撞发生在第几秒;三样东西脱手的先后顺序;升格的时候镜头先跟谁、再跟谁。
这些你用文字写,模型只能「大概理解」。写「路人从右侧撞过来」,它可能给你一个从左后方蹭过去的影子。写「物体先后飞出」,它可能三样同时炸开。
白模的作用,是把这一整套调度变成一段能被逐帧参考的视频。文字负责长什么样,白模负责在哪、什么时候、往哪去。两件事分开,各管各的,成片才稳得住。
这也是为什么这条链路要走 Seedance 2.5 reference-to-video,而不是普通的文生视频或图生视频。它能同时吃一段参考视频和多张参考图,正好对上「调度归视频、外观归图片」这个分工。
02
PART
白模长什么样
SETUP · 只剩胶囊和色块
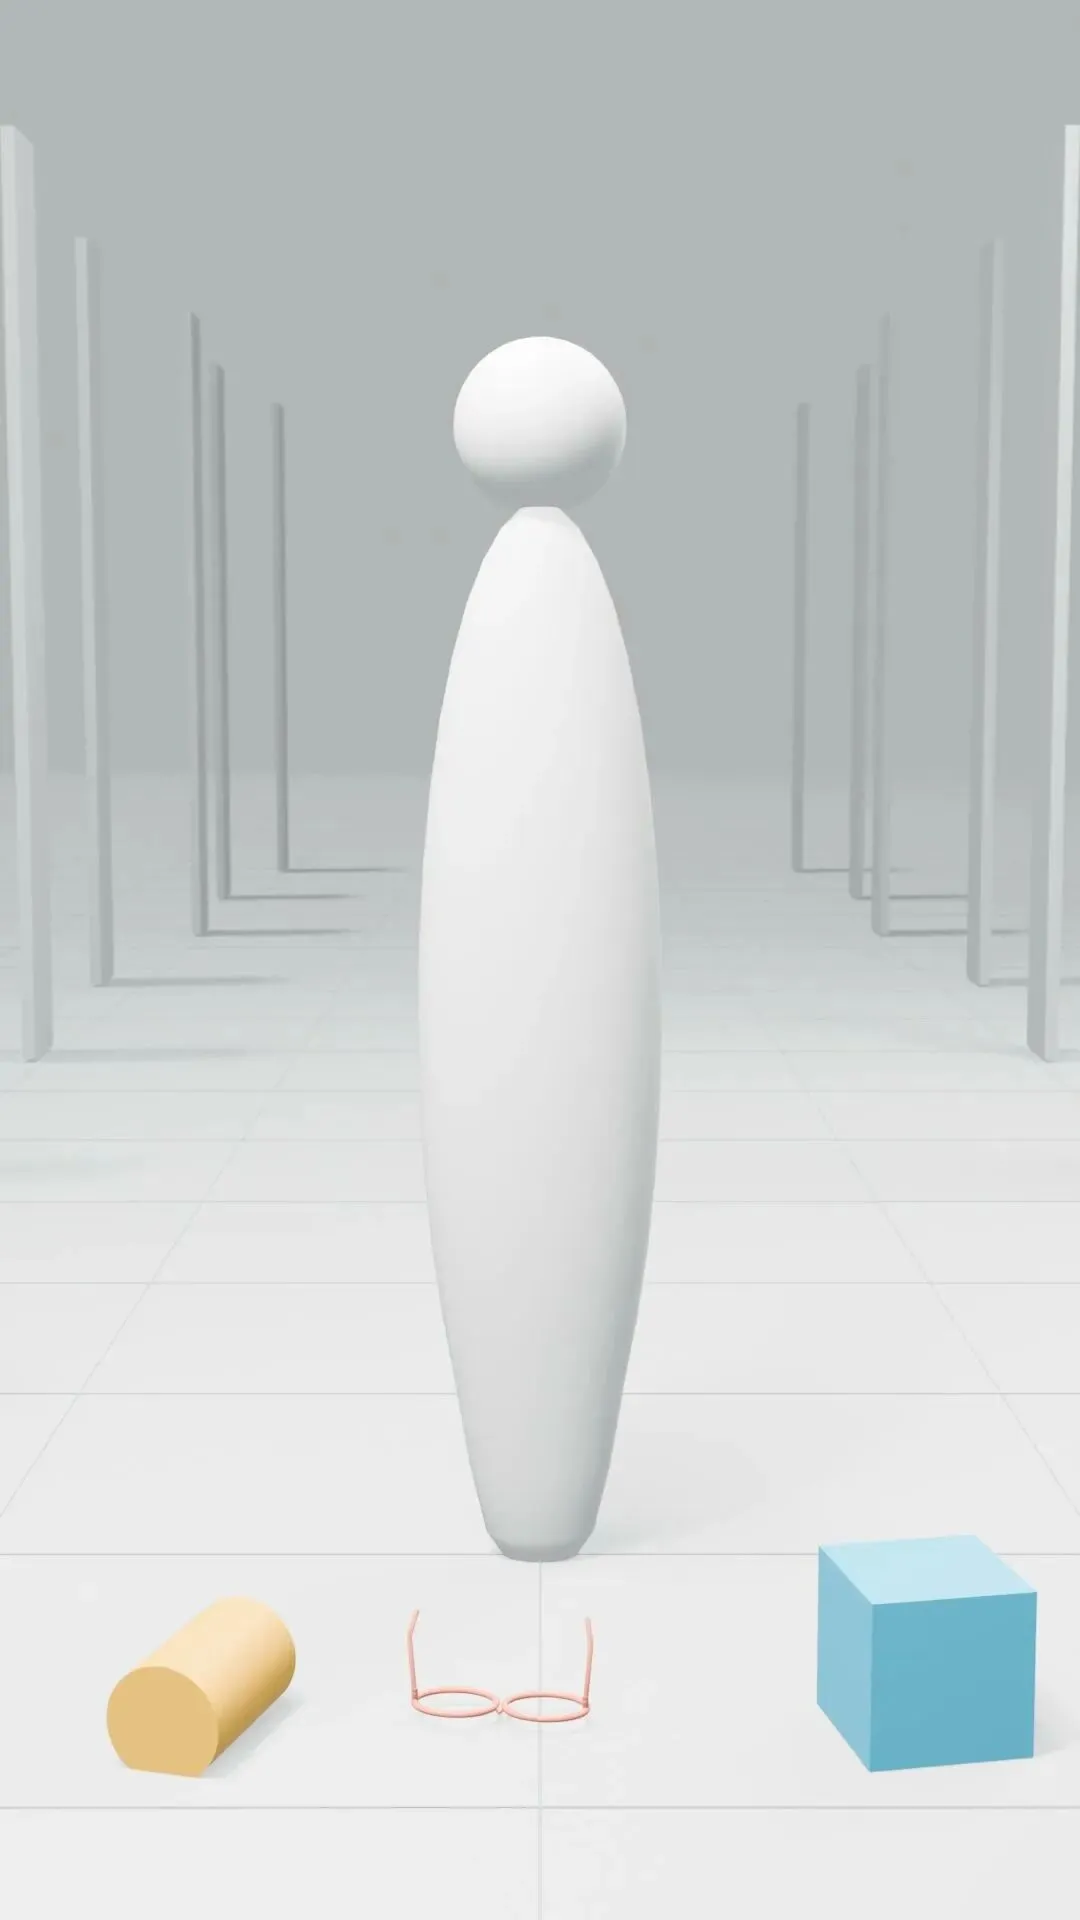
— 白模里只有胶囊、三个纯色几何体和灰色场景
我们这条白模,画面上只有这些东西:
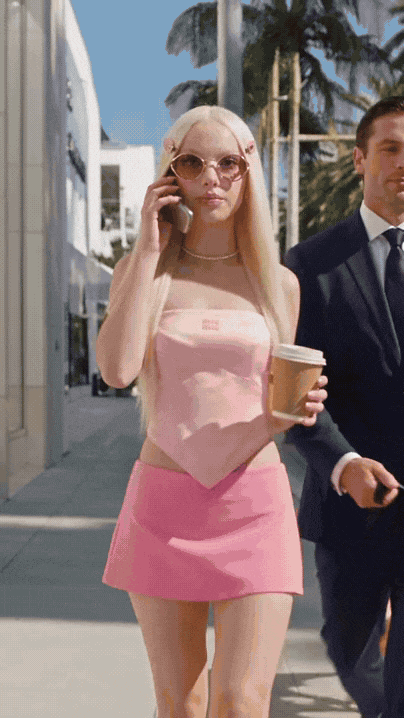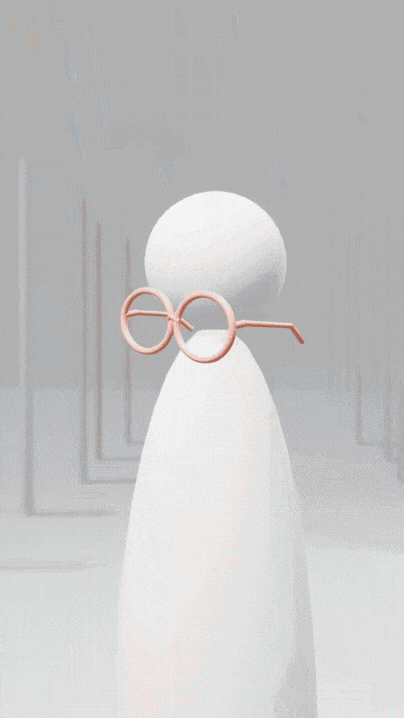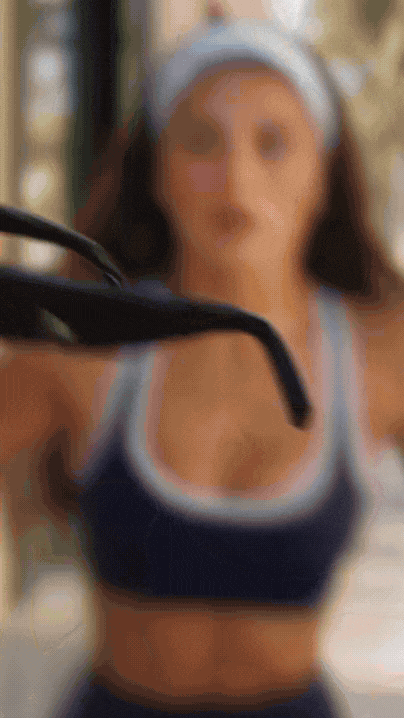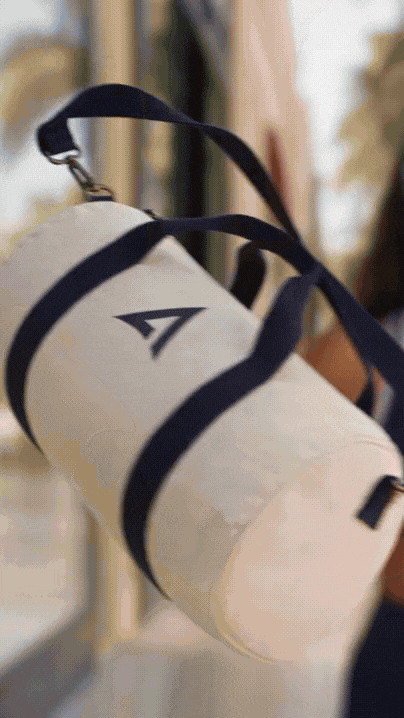
一个没有四肢的白色胶囊,代表人站的位置和高度;身体两侧各悬着一个纯色几何体(黄色圆柱、蓝色立方体),代表两只手里的东西在哪儿;头部一个红色圆环,代表脸上的配饰;一个灰色路人,按固定路线从右侧走来撞上去;灰色街道,两侧拿灰色柱体当建筑。
就这些。没有脸、没有头发、没有衣服、没有手指。
整条白模只锁四样:机位路线、人物站位、碰撞时点、物体脱手顺序。剩下的全放开。
03
PART
白模别做太细
PITFALL · 越细越僵
这里有一点挺反直觉的,也是这篇我最想让你带走的一条。
我们第一版白模,是做了步态的。
当时想法很朴素:既然是参考视频,那给得越完整,模型不是还原得越好吗。于是人物有腿、有迈步、有重心转移,逐帧 K 得像模像样。
结果渲出来是这样:
人是对的、衣服是对的、光也是对的,但他走路的样子完全不像人在走路。肩不摆、胯不转,像个被推着往前平移的模型。
原因很直接。你给模型的东西越具体,它越容易把那个东西当成必须照做的清单,而不是可以参考的骨架。你 K 了步态,它就照着那个步态复现一遍,哪怕那个步态本来只是你为了占位随手拉的。
改法也很直接:把人退化成一个没有四肢的胶囊。没有腿,就没有步态可抄。模型拿不到任何关于「怎么走」的信息,只好自己生成。
(可以保存下方纯净版白模视频哦 ↓↓↓)
道具也是同一个逻辑。白模里那根黄色圆柱不是奖杯的形状,蓝色立方体也不是戒指的形状,它们只代表位置和体积。真正长什么样,交给参考图。
所以这一节的判据能收成一句:
白模里多出来的每一条信息,都是在替模型做决定
白模负责在哪、什么时候;模型负责长什么样、怎么演
04
PART
素材:先用 GPT Image 2.5 把要替换的东西做出来
ASSETS · 四张参考图
白模是骨架,接下来把血肉准备好。一条片子要四张参考图:
| 槽位 | 内容 | 对应白模里的 |
|---|---|---|
| 图 1 | 人物参考图 | 胶囊 |
| 图 2 | 左手那件物体 | 黄色圆柱 |
| 图 3 | 右手那件物体 | 蓝色立方体 |
| 图 4 | 脸上的配饰 | 红色圆环 |
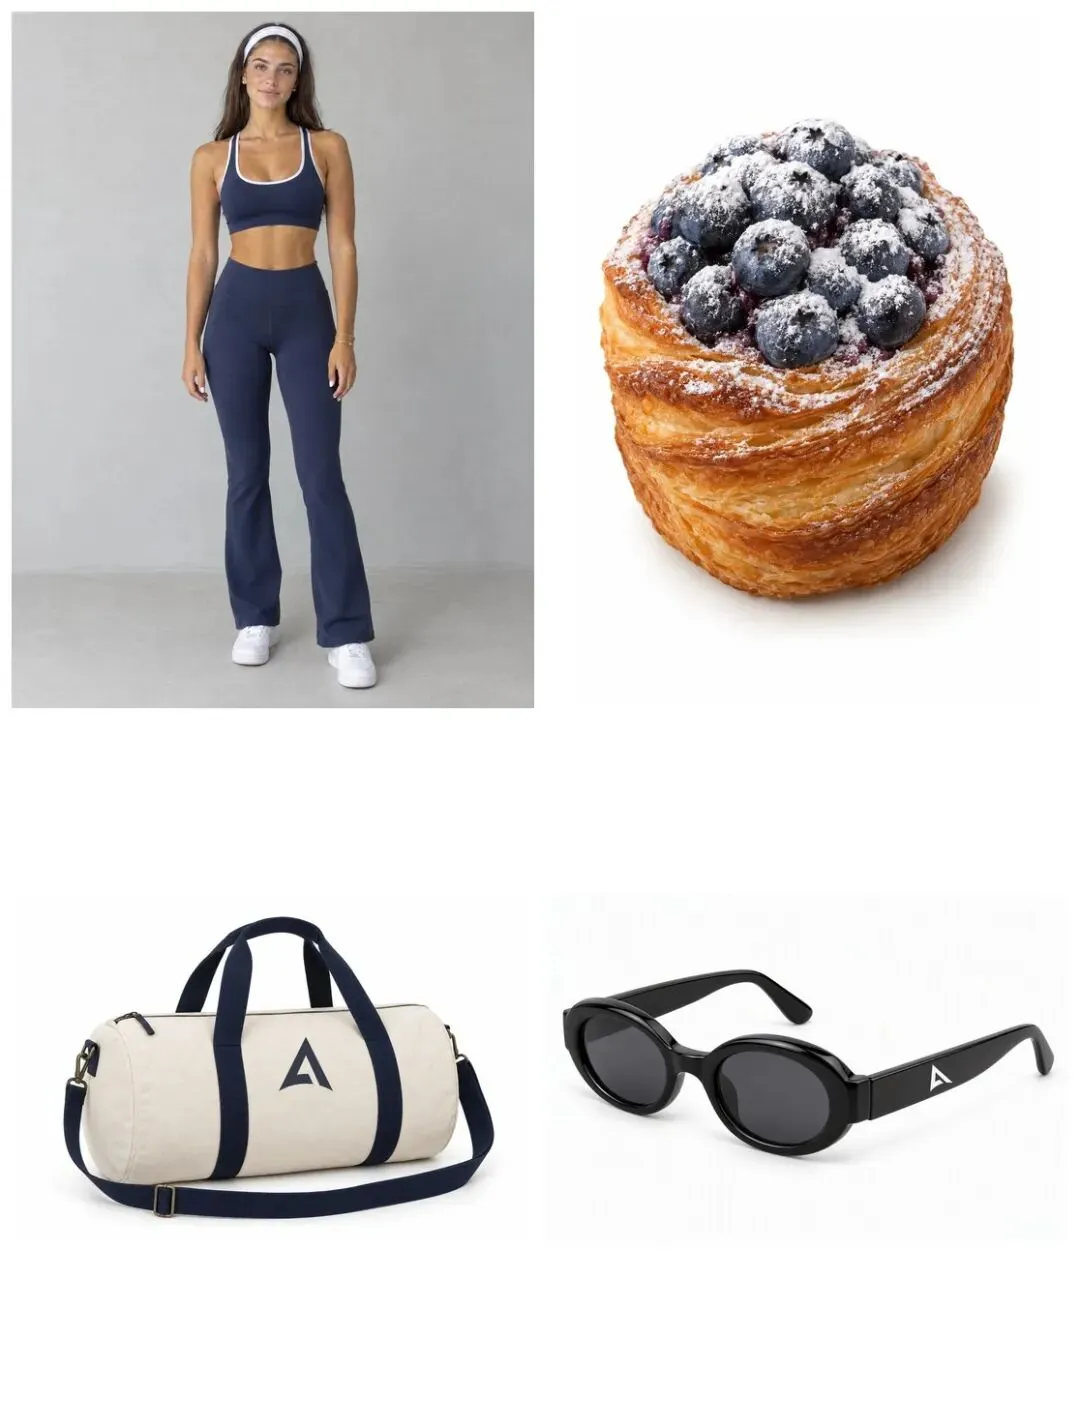
这四张我全部用 GPT Image 2.5 原地生成,没去素材站找。好处不只是省事:自己生成,每一张都能对着白模的几何形状去调。
GPT Image 2.5 模型页www.atlascloud.ai/models/gpt-image-2.5
— 红毯版的四张参考图:人物、金奖杯、巨钻戒指、墨镜
人物参考图要双手空着、不戴配饰
人物图上如果已经拿着东西、戴着眼镜,它会和白模规定的持有方式打架。模型不知道该听图的还是听白模的,出来就是手里多一件、脸上多一副。
三样东西的运动方式尽量互不相同
升格那几秒好不好看,取决于三样东西飞起来的表现有没有区别。全是刚体,就是三条差不多的抛物线,看着像同一个东西飞了三遍。
可以在液体飞溅、内容物从开口散出、柔性部件摆动这三类里各挑一类。都是刚体也有解,让变化发生在光上(镜面反射、金属高光、钻石色散),但那样就得在提示词里把光源写足。
✦ 顺带一提
logo 可以直接印在物体的参考图上,让它跟着物体一起飞、一起翻转,比后期贴上去自然。
05
PART
跑:Seedance 2.5 的 reference-to-video
RUN · 七段提示词模板
素材齐了,进正题。
Seedance 2.5 模型页www.atlascloud.ai/models/seedance-2.5
打开 Atlas Cloud,找到 Seedance 2.5,选 reference-to-video。参考视频那一栏传白模,参考图那几栏按顺序传四张素材,粘贴下面这段提示词,设好时长、分辨率、画幅,生成。
提示词模板(可直接拿走填空)
模板分七段。别跳过第一段和最后一段,第一段管分工,最后一段管落地,这两段最容易漏,漏了也最容易废片。
...prompt
【分工】@video1 只作为运镜与调度的骨架,只提供摄影机路径、景别变化、

人物所在的位置和朝向、碰撞时点、物体脱手的先后顺序。不保留它的外观、材质和场景。

@video1 里的人是一个没有四肢的白色胶囊,它只代表这个人所站的位置和高度。

实际人物有完整的身体、手臂和双手,站姿、步态、手势和表情全部自然生成,

不要参考胶囊的形状和比例。

@video1 里悬浮在身体两侧的几何体只代表物体所在的位置和大小,不代表它的形状,

也不代表它真的浮在空中。实际画面里没有任何东西是悬浮的:

画面左侧、与头部同高的黄色圆柱 = @image2 的 {物体一},{怎么被拿着};

画面右侧、腰胯高度的蓝色立方体 = @image3 的 {物体二},{怎么被拿着};

头部的红色圆环 = @image4 的 {配饰},戴在鼻梁上。

【任务】参考 @video1 的摄影机路径、景别变化、人物站位、碰撞时点和特写顺序,

生成一段 {风格} 的短片。主角用 @image1 替换,{要保持一致的外观特征逐条列出}。

{物体一} 始终在画面左侧、{物体二} 始终在画面右侧,

与 @video1 里黄色圆柱和蓝色立方体各自所在的那一侧保持一致。

【环境】{场景、光源、前景遮挡、镜头焦段}。

【开场】镜头从腿部近景平稳后退并上升至面部。人物自然前行,落脚承重、肩胯轻摆,

两手自然持物,头发和衣摆随步伐摆动。

【碰撞】路人按 @video1 的路线擦撞主角。先给到肩部接触的那一瞬,

随后躯干偏转、头部滞后、出现惊讶表情;人物本能调整脚步、伸手维持平衡,

三样东西先后脱手、不同时飞出,离手之后不再回到他身上。

【升格】画面转为升格。镜头按 @video1 的特写顺序依次跟随。

{逐件描述它在空中的表现:翻转方式、反光、内容物如何散出}。

以远近变化强化空间感,轨迹保持连续,中途不跳变。

【结尾】镜头拉回全身,恢复常速。人物补步站稳,低头看向地面,双手空着。

升格里飞出去的那几样东西这时从空中落到地上,它们是从画面上方落下来的,

不是从他身上掉下来的。各物体按自己的形状与重量触地、侧倒、弹动或滚落,

避免悬浮、瞬移和突然复位。每一段在管什么
| 段落 | 管什么 | 漏了会怎样 |
|---|---|---|
| 分工 | 告诉模型白模里每个色块代表谁 | 胶囊被当成人的造型,几何体被当成真实物体,成片里出现悬浮的方块 |
| 任务 | 身份和外观的一致性,加上左右绑定 | 人脸漂移,物体左右乱串 |
| 环境 | 场景、光、前景 | 升格没有可看的细节 |
| 开场 | 走路的质感 | 平移感 |
| 碰撞 | 撞击的层次和脱手节奏 | 三样同时炸开 |
| 升格 | 每件东西在空中的表现 | 三条一样的抛物线 |
| 结尾 | 落地的物理 | 物体悬浮、瞬移,或者又回到人身上 |
06
PART
然后就可以随便换了
SWAP · 一条白模,两套成片
白模做好一次,后面所有的替换都只是换四张参考图,再改几句描述。
红毯版:男明星举着金奖杯走红毯被围拍,手上戴着巨钻戒指,脸上一副墨镜。三样都是刚体,所以升格的变化全靠光,镜面反射、金属高光、钻石色散。
运动版:女生练完健身,一手拎着帆布健身包,一手拿着撒满糖粉的 cruffin。这组的变化来自材质,糖粉先散成雾、蓝莓后弹跳、包带在空中甩鞭子。
一暗一亮、一硬一软,白模是同一条。
///
LAST
怎么用起来
GET STARTED · 两种上手方式
整条链路复盘下来其实就两件事:白模只锁调度别锁细节,人做成胶囊、道具做成色块;参考图各管各的外观,人物图双手空着、物体形状对上色块。
白模做一次能用很久。换个人、换个场景、换三样东西,同一套流程再跑一遍就行。
✦ 方法一:平台直用
登录 Atlas Cloud 官网,在模型页选 Seedance 2.5 的 reference-to-video,上传白模和参考图就能跑。素材那一步用 GPT Image 2.5 在同一个平台上生成,不用来回倒腾文件。
Atlas Cloud 官网www.atlascloud.ai
方法二:走 API,三步接进自己的流程
STEP 01
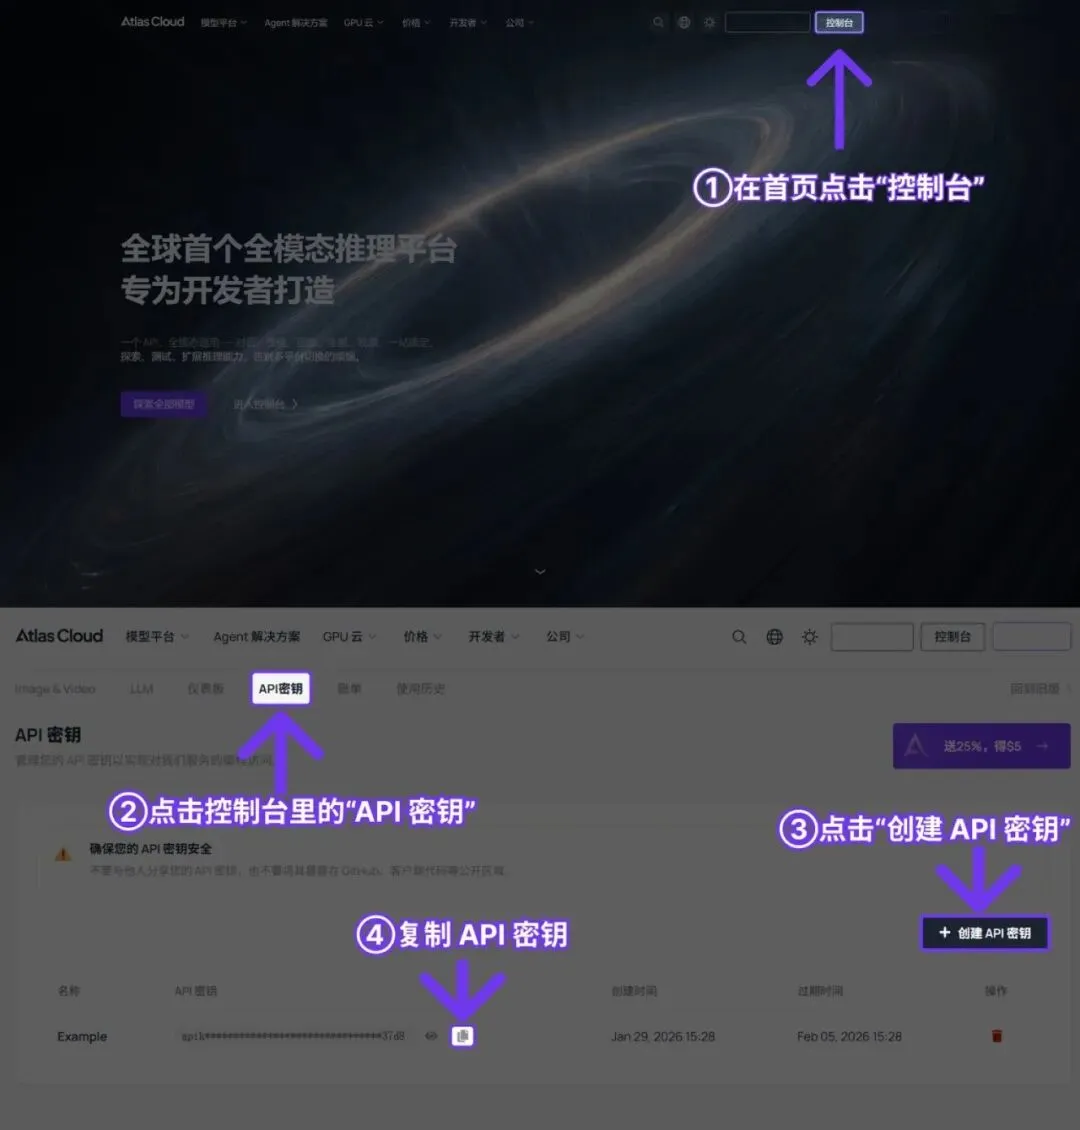
获取你的 API Key
在 Atlas Cloud 控制台创建一个 API Key,整条链路(出图 + 出片)共用这一个。
STEP 02
查阅 API 文档
模型页上有 reference-to-video 的完整参数说明,参考视频和参考图分别对应 reference\_videos 和 reference\_images 两个字段,提示词里用 @video1 / @image1 引用它们。
STEP 03
发起你的首次请求
通过 Atlas Cloud 的 One API,一个接口、一套调用方式,即可调度平台上的全部模型。出参考图和出片是两个模型,但只需要换一下模型名,其余调用方式不变。
本文用到的链接
出片模型 Seedance 2.5 www.atlascloud.ai/models/seedance-2.5
出图模型 GPT Image 2.5 www.atlascloud.ai/models/gpt-image-2.5
平台首页 Atlas Cloud www.atlascloud.ai
最后
这个玩法我是在小红书 @Renee学不停 那儿看到的,白模和提示词模板的骨架来自她的拆解,我在这基础上重做了精简版白模、补了实测。
原视频来自ins博主 @elena\_pro\_design\_
Seedance 2.5 的参数、时长档位和 API 示例都在模型页,点文末「阅读原文」可以直接过去。
🚀 登录 Atlas Cloud,即刻体验
Atlas Cloud 一站式多模态生成 / 增强平台,覆盖全球主流 LLM、视频、图像、语音、3D 模型,帮助企业客户加速 AI 模型 + 业务落地最后一公里。
