
Introduction(引言)
如果你曾经打开过一篇系统设计文章并立刻感到迷茫,你并不孤单。大多数资源直接跳到充满负载均衡器、消息队列和数据库的复杂图表中,却从未解释这些为什么重要,或者从哪里开始。
本指南正是为这种情况而写。它假设你对系统设计没有任何先验知识。读完之后,你将理解高层设计(HLD)和低层设计(LLD)的真正含义、它们的区别、每部分需要学习哪些概念,以及如何在不感到不知所措的情况下开始练习。
这并非一夜之间成为系统设计专家的捷径。它是一张地图,告诉你从哪里开始、下一步学什么,以及每个部分为什么重要。
What System Design Actually Is(系统设计到底是什么)
系统设计的核心,是决定软件系统应如何构建,使其能正确运行、应对预期负载,并能随时间扩展而不至于崩溃。
想想 Instagram 这样的应用。每秒都有数百万人上传照片、浏览信息流、发送消息。这一切都不是偶然发生的。有人必须做出深思熟虑的决策,决定数据如何在系统中流动、存储在哪里、如何快速检索,以及当系统某部分出现故障时会发生什么。
系统设计分为两大类别,尽早理解这一划分将为你省去很多困惑。
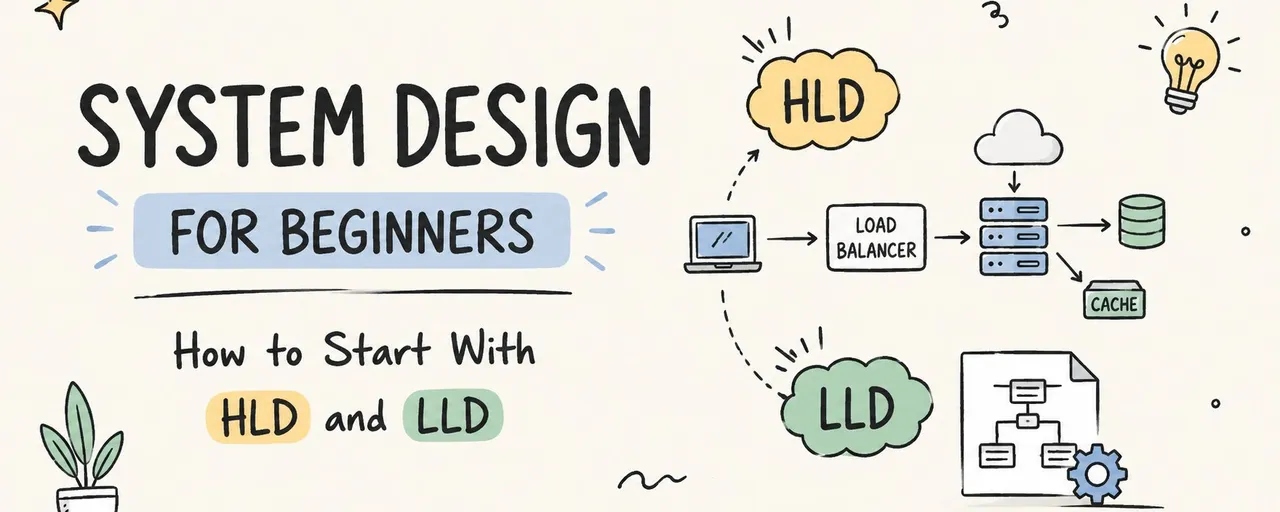
高层设计(HLD)
HLD 是系统的宏观视角。它回答如下问题:
- 该系统的主要组件有哪些
- 这些组件如何相互通信
- 数据存储在哪里,以及为什么做此选择
- 系统如何应对数百万用户,而不只是少数用户
- 当某部分出故障时会发生什么
如果有人让你在高层面上设计 Twitter,你会思考推文如何存储、数百万用户的信息流如何生成,以及系统如何在重负载下保持快速。你不会去想类结构或具体函数,那一步在后面。
低层设计(LLD)
LLD 是系统的详细、代码级视角。在了解了宏观蓝图之后,LLD 回答如下问题:
- 应该存在哪些类和对象
- 这些类之间应该如何交互
- 哪些设计模式能让代码灵活且易于维护
- 如何组织代码,使其日后易于扩展而不破坏一切
如果 HLD 是一栋建筑的蓝图,LLD 就是每个房间如何布线、布管和装修的详细方案。两者都不可或缺。蓝图出色但内部布线糟糕的建筑仍然会出问题,架构强大但代码杂乱、难以维护的系统也是如此。
Why Beginners Should Learn Both(为什么初学者应该两者都学)
初学者常犯的一个错误是只选其一而忽略另一个。有些人完全专注于 HLD,因为它感觉更刺激,充满了 Kafka、Redis 和 Cassandra 这样的流行词。另一些人完全专注于 LLD,因为它感觉更接近实际编码。
事实是,真正的系统两者都需要。架构设计良好但代码结构糟糕的系统会变得难以维护。架构有缺陷但代码干净的系统也无法扩展。本指南将 HLD 和 LLD 视为同一技能的两半,因为事实正是如此。
HLD Fundamentals, Fully Expanded(HLD 基础知识,全面展开)
请求究竟如何到达服务器
在深入负载均衡器和数据库之前,先理解当你在浏览器中输入一个网址时物理上发生了什么会很有帮助,因为几乎每一个 HLD 概念都建立在这个流程之上。
服务器只是一台机器,物理的或虚拟的,运行你的应用代码并等待请求。当你在浏览器中输入像 www.example.com 这样的地址时,你的计算机并不知道那台服务器实际位于何处。它首先会访问 DNS 服务器,DNS 是 Domain Name System 的缩写,它就像互联网的电话簿。DNS 将人类可读的名称(example.com)翻译成服务器实际的 IP 地址,如 142.250.196.14。
一旦浏览器获得了 IP 地址,它就直接向该地址发送请求。服务器上可能同时运行着许多程序,因此请求还会指定一个端口号,告诉服务器由哪个具体应用来处理它。端口 443 是安全网络流量的标准端口,端口 80 是普通网络流量的标准端口。服务器在该端口接收请求、处理,并以同样的方式发回响应。
从浏览器发送请求到收到响应的这整个往返过程,是系统设计中其他一切努力优化的基础。你在这之后学到的每个概念——缓存、负载均衡、CDN——都是为了这个循环更快、更可靠,或能承受更多流量。
真实案例:当你在 Google 上搜索时,你的浏览器首先通过 DNS 将 google.com 解析为 IP 地址,然后通过端口 443 向该 IP 发送请求。Google 的服务器接收请求,在其搜索基础设施中处理你的查询,并返回响应,由你的浏览器渲染为你看到的搜索结果页面。
延迟与吞吐量
这两个词经常被提到,初学者也常常混淆,因此有必要将它们清晰地区分开。
延迟是单个请求完成所需的时间,通常以毫秒为单位。如果你点击一个按钮,页面在 200 毫秒内更新,这就是该操作的延迟。延迟越低,意味着体验越快、越灵敏。
吞吐量是系统在给定时间内能处理的请求数量,通常以每秒请求数来衡量。一台服务器可能在开始吃力之前每秒能处理 5000 个请求。这个数字就是它的吞吐量。
这里有一个区分它们的方法。想象一条高速公路。延迟是一辆特定的车从一端到另一端所需的时间。吞吐量是一小时内能通过这条公路的车辆数量。一条高速公路对单辆车可能有低延迟,但如果只有一条车道,它的吞吐量仍然可能很低。在系统设计中,理想情况下两者都要——单个请求要快,同时要能处理大量并发请求。
真实案例:股票交易平台极其在意延迟,因为执行一笔交易哪怕延迟 50 毫秒也可能让公司损失资金。相比之下,批量邮件服务更关心吞吐量,因为它需要在几小时内发送数百万封邮件,单封邮件稍慢一点并不重要。
扩展及其类型
随着你的应用获得更多用户,在某个时点,你现有的设置将无法跟上需求,系统需要扩展。有两种基本方式可以实现这一点。
垂直扩展意味着让你的现有服务器变得更强大。你为同一台机器增加更多的 CPU、更多的内存或更快的存储。这很简单,因为你的应用逻辑完全不需要改变,你只是在更强的硬件上运行它。问题在于垂直扩展存在上限。单台机器能有多强大存在物理和财务上的极限,最终你将无法继续垂直扩展。
水平扩展意味着增加更多服务器,而不是让一台服务器更强,并将传入的流量分散到所有服务器上。这种方式的扩展能力远超垂直扩展,但它引入了复杂性,因为现在你有多个服务器,需要一种方法来分担负载,这正是负载均衡器发挥作用的地方。
一般来说,大多数初学者在设计大型系统时,应该默认从水平扩展的角度思考,因为你每天使用的几乎所有主要平台,从 Instagram 到 Amazon,都运行在水平扩展的服务器集群上,而不是一台巨型机器上。
现实世界示例:一个只有几百用户的小型 SaaS 初创公司,可能可以在单台配置合理的强大服务器上轻松运行,根据需要垂直扩展。一旦同样的初创公司增长到数百万用户,就像 Slack 或 Notion 那样,单台服务器在物理上就无法继续扩展了,这就迫使转向在多台服务器上进行水平扩展。
自动扩展
大多数应用的流量并不是恒定不变的。外卖应用在午餐和晚餐时段的流量远高于凌晨四点。如果你配置了足够的服务器来处理绝对峰值流量,并让它们全天候运行,那么在低谷时段你就要为大量闲置容量付费。
自动扩展通过根据实时需求自动添加或移除服务器来解决这个问题。如果你的服务器 CPU 使用率超过某个阈值,比如 80%,系统会自动启动额外的服务器并开始将流量路由到它们。当流量回落后,这些额外的服务器会自动关闭以节省成本。
这就是为什么像 AWS、GCP 和 Azure 这样的云平台被如此广泛使用的原因。你可以一次性配置好这些规则,然后基础设施就会自动处理扩展和收缩,无需任何人凌晨 2 点盯着仪表盘。
现实世界示例:像 BookMyShow 或 Ticketmaster 这样的票务预订平台,在热门音乐会门票开售的那一刻会经历巨大的流量峰值,随后几乎归于沉寂。自动扩展让它们只在那个售票窗口期间启动额外的服务器,之后再缩减回去,而不是全年都为峰值容量付费。
粗略估算(Back of the Envelope Estimation)
在设计系统之前,尤其是在面试场景中,粗略估算你正在设计的规模是很有帮助的。这不需要精确,目标只是了解你面对的是哪个数量级。
假设你正在设计一个拥有 5000 万日活跃用户的照片分享应用,每个用户平均每天上传 2 张照片。这大约就是每天 1 亿次照片上传。如果每张照片平均 3 兆字节,那么每天就需要大约 300 TB 的新存储。突然之间,像 “我们应该用普通数据库存储照片吗” 这样的决定就明显是错误的了,它会自然地引导你转向使用专用的对象存储。
这种快速计算不需要完美。它的全部目的就是迫使你尽早面对问题的实际规模,让你的设计决策基于现实而非猜测。
让我们使用同一个照片分享应用的例子,把数字完整地算一遍,而不是仅仅在脑子里估算。
已知条件:
- 5000 万日活跃用户
- 每个用户每天上传 2 张照片
- 每个用户每天查看 100 张照片
- 平均照片大小为 3 MB
- 10% 的照片还会收到一条评论
第 1 步,计算每日写入量
每日照片上传总数 = 50,000,000 用户 x 2 张照片
= 每天 100,000,000 次上传
第 2 步,计算每日读取量
每日照片查看总数 = 50,000,000 用户 x 100 次查看
= 每天 5,000,000,000 次查看
仅此一点就告诉你一些重要信息:读取量是写入量的 50 倍。这是一个强烈的信号,表明在这里,缓存和只读副本的重要性将远远超过对写入的优化。
第 3 步,计算每日所需存储量
每日存储量 = 100,000,000 次上传 x 3 MB
= 300,000,000 MB
= 每天 300 TB
第 4 步,计算每年所需存储量
每年存储量 = 300 TB x 365
= 约 109,500 TB
= 每年约 109.5 PB
第 5 步,计算每秒请求数
每秒上传数 = 100,000,000 / 一天的 86,400 秒
= 约每秒 1,157 次上传
每秒查看数 = 5,000,000,000 / 86,400
= 约每秒 57,870 次查看
这告诉我们什么:
面对这样的数字,单台数据库服务器立即被排除,无论是从存储还是请求量角度。读写量之间的巨大差距告诉我们,要大力投资照片的缓存和 CDN 分发,而存储量则告诉我们,照片本身应该放在 S3 这样的专用对象存储中,而不是传统的数据库里。这就是粗略估算的全部意义:它将模糊的规模转化为具体的架构决策。
深入理解负载均衡器
一旦你有了多个服务器,就需要有东西来决定每个传入请求由哪个服务器处理。这就是负载均衡器的工作,它位于你的服务器集群正前方。
负载均衡器可以使用几种常见的策略。
轮询(Round robin)按循环顺序将请求依次发送给服务器,服务器一,然后是服务器二,再是服务器三,然后回到服务器一。它很简单,并且在所有服务器容量相近时效果很好。
servers = [server1, server2, server3]
currentIndex = 0

function getNextServer():
    server = servers[currentIndex]
    currentIndex = (currentIndex + 1) % length(servers)
return server最少连接(Least connections)将每个新请求发送给当前活动连接数最少的服务器。当某些请求比其他请求需要更长的处理时间时,这比轮询效果更好,因为它避免了把更多工作堆积到一台已经在处理长时间运行请求的服务器上。
servers = [server1, server2, server3]
activeConnections = { server1: 4, server2: 1, server3: 7 }

function getNextServer():
    return server with minimum value in activeConnections

    // after routing a request to that server:
    activeConnections[chosenServer] += 1

    // once that request finishes:
activeConnections[chosenServer] -= 1IP 哈希根据客户端 IP 地址生成一个值,并将该客户端每次一致地发送到同一台服务器。这对于服务器暂时持有特定用户会话信息的情况很重要,你需要他们的请求始终落在同一台机器上。
一个具体的例子,如果外卖平台因大型促销活动突然遭遇巨大流量峰值,负载均衡器能防止该流量峰值压垮任何一台服务器。负载均衡器不会让一台服务器尝试处理所有事情而崩溃,而是将涌入的流量分散到数十台并行运行的服务器上,让应用对所有人保持响应。
真实世界例子:亚马逊的 Elastic Load Balancer 在黑色星期五等活动期间位于数千台后端服务器之前,分配传入的购物流量,确保没有一台处理结账请求的服务器被压垮,而其他服务器却闲置。
数据库,SQL 与 NoSQL
选择正确的数据库类型是系统设计中最重大的决策之一,通常归结为两大类。
关系型数据库(如 PostgreSQL 和 MySQL)将数据组织为具有预定义列和表之间严格关系的结构化表。它们强制执行所谓的 ACID 属性,保证事务即使在中间失败也能可靠处理。这使得它们非常适合正确性比原始写入速度更重要的场景,例如存储用户的银行余额或电商订单历史,在这些场景中绝对无法承受数据不一致或丢失。
NoSQL 数据库(如 MongoDB、Cassandra 或 DynamoDB)牺牲了部分严格的结构和一致性,以换取灵活性和巨大的写入吞吐量。它们不需要固定模式,这意味着你可以存储具有不同字段的记录,而无需每次都重新定义表结构。这使得它们非常适合高容量、结构化程度较低的数据,如社交媒体信息流、聊天消息或来自数百万台设备的传感器数据。
何时使用哪种数据库
知道 SQL 和 NoSQL 的存在还不够。真正的技能是知道哪一种适合特定情况,这个决定通常归结为你应该对数据提出的一些具体问题。
问:我的数据有复杂关系吗?
如果你的数据自然涉及多个需要连接的相关实体,例如电商系统中的用户、订单、产品和支付,关系型数据库通常是更好的选择。SQL 数据库专门为高效处理连接而构建,并通过外键和约束保持相关数据的一致性。
如果你的数据大多是自包含的,比如代表用户配置文件的单个文档,不需要经常与其他表连接,像 MongoDB 这样的 NoSQL 文档数据库往往更自然。
问:我需要强一致性,还是可以容忍最终一致性?
如果错误或过期的数据可能造成实际损害,比如显示错误的账户余额或向客户重复收费,你需要强一致性,这指向具有 ACID 保证的关系型数据库。
如果稍微过期的数据无害,比如帖子上的点赞数短暂落后,或粉丝数一时偏差几个,NoSQL 更宽松的一致性模型可以换来更好的性能和可扩展性,是可接受的权衡。
问:我的读写模式是什么样的?
如果你的系统是读密集型的,相同的数据被以复杂方式反复查询,例如生成财务报告,具有强大索引和查询优化的 SQL 数据库往往表现非常好。
如果你的系统是写密集型的,大量数据被持续插入,例如每几秒跟踪数百万条配送司机的定位信号,像 Cassandra 这样的 NoSQL 数据库专门为吸收这种写入负载而构建,远优于传统关系型数据库。
问:我的模式会随时间变化多少?
如果你事先清楚知道数据结构且不太可能大幅变化,比如银行系统的账户和交易表,SQL 数据库中的固定模式给你安全性和可预测性。
如果你的数据结构仍在演进,或不同记录自然具有不同字段,比如产品目录中有些产品有五个属性,另一些有二十个,灵活模式的 NoSQL 数据库可以避免每次结构需要变化时的痛苦迁移。
问:这需要扩展到多大?
如果你的系统实际保持在单个配置良好的服务器容量内,即使有一些垂直扩展,SQL 仍然是优秀且更简单的选择。
如果你正在构建的数据规模在单台机器上物理上无法容纳或高效处理,例如拥有数十亿帖子的社交媒体平台,NoSQL 数据库通常从设计之初就为跨多台机器的水平扩展而构建,在这种规模下更自然契合。
快速参考表(场景 vs 更优选择)
银行交易、账户余额 - SQL
电商订单和支付 - SQL
具有灵活字段的用户配置文件 - NoSQL
社交媒体帖子、点赞、评论 - NoSQL
实时位置跟踪 - NoSQL
涉及多次连接的复杂报表 - SQL
属性各异的产品目录 - NoSQL
需要严格准确性的库存管理 - SQL
大规模聊天消息 - NoSQL
财务审计日志 - SQL
常见现实模式:同时使用两者
值得知道的是,大多数大型系统不会只选一种。它们并排使用 SQL 和 NoSQL,各自用于系统中最适合的部分。
网约车应用就是一个好例子。用户账户、司机验证和支付记录,这些正确性真正重要的数据,通常存储在关系型数据库中。与此同时,实时司机位置更新,这些数据持续到达且不需要严格的关系结构,通常由 NoSQL 存储或专为高写入吞吐量构建的内存系统处理。平台上的搜索功能甚至可能使用像 Elasticsearch 这样独立的专用系统,因为 SQL 和典型 NoSQL 数据库都不是为快速、灵活的文本搜索而优化的。
对初学者来说,这里的教训是选择数据库不是对整个人系统的一次性决定。这是你为系统每个部分分别做出的决定,基于那一部分数据的具体需求。
扩展数据库
单个数据库服务器只能处理这么多,之后就会成为瓶颈。随着负载增加,用于扩展数据库的技术有一个自然演进顺序。
索引通常是第一步也是最简单的一步。没有索引,数据库必须扫描每一行来找到你要找的内容,一旦表有数百万行,这会很慢。索引是在特定列上构建的独立排序结构,让数据库几乎直接跳转到匹配的行,而不是扫描所有内容。权衡是索引占用额外存储空间并略微减慢写入速度,因为数据变化时索引也需要更新。
分区意味着将一个大表拆分为多个较小的表,但保留在同一数据库服务器上。如果你有一个 5 亿行的用户表,你可能根据用户 ID 范围将其拆分为多个较小的表。这使每个单独的表及其索引更小、搜索更快。
主从复制,也称为领导者 - 跟随者复制,在单个服务器无法再处理读取流量时发挥作用。在这种设置中,一台服务器(主服务器)处理所有写操作。该数据被复制到一个或多个其他服务器(称为从服务器或副本),这些服务器处理读操作。由于大多数应用收到的读请求远多于写请求,这让你可以通过简单添加更多副本服务器来扩展读容量。
多主设置更进一步,允许多台服务器接受写入。这在为不同地区用户提供服务的系统中很常见,例如,一个主服务器处理来自亚洲用户的写入,另一个处理来自欧洲用户的写入,两者定期同步。这里棘手的部分是处理冲突,决定如果同一记录在两个主服务器同步之前被以不同方式更新时该怎么办。
分片是最复杂的扩展技术,通常应作为最后手段。分片将数据分散到完全不同的数据库服务器(称为分片),而不仅仅是同一服务器上的不同表。拥有数十亿用户的社交媒体平台可能按用户 ID 分片其用户数据,因此 ID 在一个范围内的用户完全驻留在一台物理数据库服务器上,而 ID 在另一个范围内的用户驻留在完全不同的服务器上。这让你几乎无限扩展,因为不再受单台机器容量限制,但使跨分片连接数据等操作变得昂贵且复杂,因为数据现在位于物理分离的机器上。
真实世界例子:Instagram 早期对 PostgreSQL 数据库进行了著名的分片,以应对爆炸性用户增长,根据用户 ID 将用户数据分散到多台数据库服务器上,而不是试图垂直扩展单个大型服务器。
深入理解缓存
缓存将频繁请求的数据存储在快速访问的地方,通常使用 Redis 或 Memcached 等工具存储在内存中,以便重复请求不必每次都访问数据库。
想想新闻网站的主页。每分钟可能有成千上万人加载这个主页,但页面上的内容并不会每秒钟都变。与其为每一位访客都去查询数据库、从头重建主页,不如把渲染好的主页缓存起来,接下来几千名访客几乎瞬间就能拿到缓存版本。
缓存发生在好几个不同的层级。客户端缓存把数据直接存在用户的设备上,比如浏览器缓存网站的图片,这样每次访问就不用重新下载。服务端缓存把数据存在像 Redis 这样的快速共享层里,所有应用服务器都能读取。CDN 缓存(我们接下来会讲)把内容副本存得离用户更近,从地理上缩短距离。
缓存最难的部分不是存数据,而是知道什么时候该更新或删除——这个问题叫做缓存失效。如果电商网站上某件商品的价格变了,但旧价格还在缓存里,用户就可能看到过时的信息。一种常见做法是给缓存数据设置一个生存时间(TTL),意思是它过一段时间(比如 10 分钟)自动过期并刷新。另一种做法是底层数据一变就立刻更新缓存,这样两者从一开始就不会不同步。
现实例子:当你在 App 里查板球比分或体育赛事实时比分时,同一时刻有数百万人在读这个比分,但它只是偶尔更新。把比分在 Redis 里缓存几秒钟,相比每一次刷新都去查数据库,能极大减轻数据库负载。
下面是一个简化示例,展示服务器如何先用 Node.js 查 Redis、再决定是否访问数据库。
const express = require('express');
const redis = require('redis');
const app = express();
const client = redis.createClient();

app.get('/photo/:id', async (req, res) => {
    const photoId = req.params.id;
    const cacheKey = `photo:${photoId}`;

    // Step 1: check the cache first
    const cachedPhoto = await client.get(cacheKey);
    if (cachedPhoto) {
        console.log('Cache hit');
        return res.json(JSON.parse(cachedPhoto));
    }

    // Step 2: cache miss, fetch from database
    console.log('Cache miss, querying database');
    const photo = await database.getPhotoById(photoId);

    // Step 3: store in cache for next time, expire after 1 hour
    await client.set(cacheKey, JSON.stringify(photo), { EX: 3600 });

    return res.json(photo);
});内容分发网络(CDN)
如果你的主服务器都在一个区域,离那个区域远的用户会明显感觉加载变慢,原因很简单:他们的请求在物理上要传得更远。CDN 通过把静态内容(图片、视频、样式表)的副本存到分布在世界各地的服务器(叫边缘服务器)上来解决这个问题。
当用户请求某份内容时,请求会先到离他最近的边缘服务器,而不是一路传回你的主服务器。如果那台边缘服务器已经缓存了这份内容,就直接返回;如果没有,它就从主服务器取一次,缓存下来,然后为这个用户以及此后这个地区的所有用户提供服务。
这就是为什么无论你在世界哪个角落,视频流媒体都能流畅播放。你按下播放键时,你几乎肯定是从物理上离你很近的服务器在拉流,而不是从平台位于另一个大洲的主数据中心。
现实例子:当你从 Steam 下载一个大游戏更新时,你几乎肯定是从离你所在城市很近的 CDN 边缘服务器下载,而不是从 Steam 的主服务器,所以无论你住哪里,下载速度通常都很快。
消息队列与异步处理
系统执行的任务并不都需要在用户等待的同时立刻完成。有些任务更适合放到后台处理,这就是消息队列的用武之地。
设想一个视频分享平台。你上传视频时,平台不会让你等着它把视频转成多种分辨率、生成缩略图。相反,它几乎立刻确认上传完成,真正的处理工作则作为一条消息放进队列里。另一组独立的 worker 服务器从队列里取任务,按自己的节奏独立处理。
这种解耦有实实在在的好处。如果 worker 一时忙不过来,任务就在队列里等着,而不会让整个系统崩溃。如果某个 worker 在处理任务时挂了,任务还可以重试,而不是彻底丢失。RabbitMQ 和 Apache Kafka 这类工具常被用来做这件事。Kafka 尤其擅长处理海量消息,所以它经常被用来做像同时跟踪数千名配送司机的实时位置更新这种事——如果每一条更新都实时直接写进数据库,数据库会被压垮。
现实例子:当你在 Amazon 下单时,结账几乎瞬间确认,但在幕后,更新库存数量、通知卖家、触发发货流程这些任务都是通过队列异步处理的,所以结账页面根本不需要等所有这些都完成。
CAP 定理
一旦你的数据从单台服务器变成分布在多台服务器上,你就撞上一个绕不开的取舍,它被 CAP 定理正式描述了出来。
CAP 代表一致性(Consistency)、可用性(Availability)和分区容错性(Partition Tolerance)。一致性意味着每台服务器都返回完全相同、最新的数据。可用性意味着系统始终能响应请求,即使某些服务器出了问题。分区容错性意味着即使某些服务器暂时无法互相通信,系统也继续工作——这在任何分布式系统里都难免偶尔发生。
这个定理说的是,这三者你最多只能同时完全保证两个。既然网络问题在任何真实的分布式系统里都不可避免,分区容错性基本上没得选,所以真正的决定通常落在:发生分区时,到底选一致性还是可用性。
一个实际例子:当你在社交媒体上发一条内容,全世界所有粉丝可能要过一会儿才看得到,因为更新需要时间在服务器之间传播。平台选择了可用性(保持响应),而不是严格一致性(让所有人立刻看到绝对最新的数据),因为帖子稍微延迟一点,远比每次两台服务器短暂失联就让整个平台宕机要好得多。
作为一般准则:处理钱或关键交易的系统(比如银行)倾向于优先保证一致性。像社交信息流或商品目录这类系统,稍微旧一点的数据无伤大雅,就倾向于优先保证可用性。
现实例子:支撑 Amazon 购物车系统的数据库 DynamoDB,就是出了名地优先保证可用性而不是严格一致性。因为 Amazon 认为,购物车始终能访问(哪怕偶尔显示稍微旧一点的数据),远比网络一抖购物车就完全不可用要好。
代理:正向代理与反向代理
代理就是一个夹在客户端和另一台服务器之间的服务器,其中有两种值得了解。
正向代理站在客户端前面,替客户端发请求。VPN 是常见的现实例子——目标服务器只能看到 VPN 的身份,看不到真正的用户。它被用来访问地区限制的内容,或者让组织过滤员工能访问哪些网站。
反向代理站在一台服务器(或一组服务器)前面,替它们处理进来的请求。客户端只跟反向代理说话,从不直接接触真正的后端服务器。负载均衡器就是反向代理的常见例子。反向代理还被用来做 SSL 终止(也就是替真正的应用服务器承担加密和解密安全流量的工作),以及让后端服务器不直接暴露在互联网上。
现实例子:Cloudflare 通常作为数百万网站前面的反向代理运作,吸收流量、过滤恶意请求、把合法请求转发给真正的源服务器,同时源服务器的真实 IP 地址对公网保持隐藏。
How to Approach an HLD Problem, Step by Step(如何一步步应对高层面设计问题)
知道这些积木块只是成功了一半。另一半是:当别人给你一个系统设计问题时(不管是面试还是自己练习),你该怎么下手。下面这个框架对初学者很适用。
第一步:厘清需求
在画任何一个方框之前,先搞清楚系统到底要做什么。如果有人让你设计一个图片分享应用之类的东西,不要假设任何事。问清楚核心功能是什么、系统要支持多少用户、要不要同时支持上传和浏览、最重要的是什么——速度、一致性还是成本。
跳过这一步是初学者最容易犯的错。还没理解问题就直接跳进方案,通常会导致设计出来一个解决错了问题的东西。
第二步:估算规模
知道需求之后,想想大概的数字。会有多少用户用这个系统?这大概换算成每秒多少次请求?随着时间推移会存多少数据?
不需要精确数字。目标是大概理解你是在为多大规模做设计,因为为一千个用户设计的系统,跟为一亿用户设计的系统,长得完全不一样。
第三步:确定核心组件
现在开始识别你的系统需要哪些主要部件。通常包括:数据存在哪里、需不需要缓存、需不需要队列处理后台任务、需不需要 CDN 来分发媒体。
在这个阶段,忍住过度设计的冲动。初学者常常想把听说过的每个高级工具都塞进去,哪怕问题根本用不着。从简单开始,只有在有明确理由时才增加复杂度。
第四步:设计数据流
把用户和系统交互时一步步会发生什么走一遍。如果用户上传一张照片,追踪它的路径:请求打到负载均衡器,被路由到某台服务器,服务器把图片存到某处,把元数据写进数据库,可能再触发一个后台任务去生成缩略图。
把流程画出来,哪怕只是粗略的,也能帮助你在问题真正发生之前发现设计中的漏洞。
第 5 步:识别瓶颈和故障点
问问自己:如果服务器宕机会怎样,流量突然飙升会怎样,随着使用增长,系统哪部分最可能成为瓶颈。这就是缓存、水平扩展和冗余等概念发挥作用的地方。
尽早思考故障,而不是假设一切永远完美运行,这是区分强系统设计思维与弱系统设计思维的习惯。
第 6 步:讨论权衡取舍
系统设计中的几乎每一个决策都伴随着权衡。选择关系数据库而非 NoSQL 数据库可能带来更强的一致性,但在大规模下写入性能较弱。选择激进地缓存数据可能会提升速度,但也会引入服务略微过时信息的风险。
能够解释你为什么做出某个选择,以及你因此放弃了什么,比选择理论上完美的答案更重要。系统设计中往往没有唯一正确的答案,只有基于清晰思考的合理方案。
LLD Fundamentals, With Java Examples(LLD 基础,附 Java 示例)
1. 面向对象编程,LLD 的基石
几乎所有 LLD 都建立在面向对象编程之上,所以在接触设计模式之前,你需要牢固掌握其四大核心原则。
封装
封装意味着将数据与操作这些数据的方法捆绑在一起,同时保持内部状态私有,仅通过方法提供受控的访问。
public class BankAccount {
    private double balance; // private, hidden from outside

    public BankAccount(double initialBalance) {
        this.balance = initialBalance;
    }

    public void deposit(double amount) {
        if (amount > 0) {
            balance += amount;
        }
    }

    public void withdraw(double amount) {
        if (amount > 0 && amount <= balance) {
            balance -= amount;
        }
    }

    public double getBalance() {
        return balance;
    }
}外部类无法直接改变余额。每一次更改都通过 deposit 或 withdraw 进行,这些方法强制执行不允许负余额等规则。
抽象
抽象意味着暴露一个简单的接口,同时隐藏其背后的复杂性。
public abstract class PaymentProcessor {
    public abstract void processPayment(double amount);
}

public class CreditCardProcessor extends PaymentProcessor {
    @Override
    public void processPayment(double amount) {
        // complex logic: contacting bank, verifying card, fraud check
        System.out.println("Processing credit card payment of " + amount);
    }
}使用 PaymentProcessor 的类只需调用 processPayment (amount)。它完全不知道底层进行的银行验证或欺诈检查。
继承
继承让一个类可以复用父类的属性和行为。
public class Vehicle {
    protected String licensePlate;
    protected int capacity;

    public Vehicle(String licensePlate, int capacity) {
        this.licensePlate = licensePlate;
        this.capacity = capacity;
    }

    public void displayInfo() {
        System.out.println("Vehicle: " + licensePlate + ", Capacity: " + capacity);
    }
}

public class Car extends Vehicle {
    public Car(String licensePlate) {
        super(licensePlate, 4);
    }
}

public class Bike extends Vehicle {
    public Bike(String licensePlate) {
        super(licensePlate, 1);
    }
}Car 和 Bike 都从 Vehicle 复用 licensePlate、capacity 和 displayInfo,而无需重复这些代码。
多态
多态意味着相同的方法调用根据对象的不同而表现出不同的行为。
public class Car extends Vehicle {
    public Car(String licensePlate) {
        super(licensePlate, 4);
    }

    public double calculateFare(double distance, double time) {
        return distance * 10 + time * 2;
    }
}

public class Bike extends Vehicle {
    public Bike(String licensePlate) {
        super(licensePlate, 1);
    }

    public double calculateFare(double distance, double time) {
        return distance * 5;
    }
}Vehicle v1 = new Car("KA01AB1234");
Vehicle v2 = new Bike("KA01XY5678");在每个对象上调用 calculateFare 会根据它实际是 Car 还是 Bike 运行不同的逻辑,即使调用代码无需知道它正在处理的是哪一个。
2. SOLID 原则,附代码
单一职责原则
一个类应该只有一个改变的理由,这意味着它应该只做一件事并且做好。想象一个名为 Invoice 的类,它既计算总价又处理将发票打印为 PDF。如果打印逻辑需要更改,你就在改动一个同时负责价格计算的类,这增加了意外破坏无关内容的风险。解决办法是将其拆分为两个类,一个用于计算发票,另一个专门用于打印。
不好,一个类承担两项工作:
public class Invoice {
    public double calculateTotal(List items) {
        double total = 0;
        for (Item item : items) {
            total += item.getPrice();
        }
        return total;
    }

    public void printInvoice(List items) {
        // logic to print invoice as PDF
        System.out.println("Printing invoice...");
    }
}修正,拆分为两个职责:
public class InvoiceCalculator {
    public double calculateTotal(List items) {
        double total = 0;
        for (Item item : items) {
            total += item.getPrice();
        }
        return total;
    }
}

public class InvoicePrinter {
    public void printInvoice(List items) {
        System.out.println("Printing invoice...");
    }
}开闭原则
一个类应该对扩展开放,对修改关闭。这意味着你应该能够在不更改已经测试过的现有代码的情况下添加新功能。回到车辆示例,如果你想添加新的车辆类型如 Truck,你应该能够创建一个适合现有结构的新的 Truck 类,而不是在每次添加新类型时打开现有的 Vehicle 类并修改其核心逻辑。
不好,修改现有代码来添加新类型:
public class DiscountCalculator {
    public double calculateDiscount(String customerType, double amount) {
        if (customerType.equals("regular")) {
            return amount * 0.05;
        } else if (customerType.equals("premium")) {
            return amount * 0.10;
        }
        return 0;
    }
}修正,无需触碰现有代码即可扩展:
public interface DiscountStrategy {
    double calculate(double amount);
}

public class RegularCustomerDiscount implements DiscountStrategy {
    public double calculate(double amount) {
        return amount * 0.05;
    }
}

public class PremiumCustomerDiscount implements DiscountStrategy {
    public double calculate(double amount) {
        return amount * 0.10;
    }
}现在添加新的客户类型意味着添加一个新类,而不是编辑现有逻辑。
里氏替换原则
子类的对象应该能够替换父类的对象而不会破坏程序。如果你有一个名为 Bird 的基类,带有一个名为 fly 的方法,你创建了一个名为 Penguin 的子类继承自 Bird,那么就有问题,因为企鹅实际上不会飞。如果你的代码假设任何 Bird 对象都能飞,那么替换为 Penguin 对象就会打破这个假设。这一原则提醒你要仔细设计类层次结构,基于实际共享的行为,而不仅仅是表面上的相似性。
不好,破坏了替换规则:
public class Bird {
    public void fly() {
        System.out.println("Flying");
    }
}

public class Penguin extends Bird {
    @Override
    public void fly() {
        throw new UnsupportedOperationException("Penguins can't fly");
    }
}修正,重新构建层次结构以反映实际行为:
public abstract class Bird {
    public abstract void move();
}

public class Sparrow extends Bird {
    public void move() {
        System.out.println("Flying");
    }
}

public class Penguin extends Bird {
    public void move() {
        System.out.println("Swimming");
    }
}接口隔离原则
一个类不应该被迫实现它不用的方法。想象一个名为 Worker 的接口,带有 work 和 eat 方法。现在想象你创建一个实现 Worker 的 Robot 类。机器人可以工作,但它不吃饭,然而它却被强制实现一个没有实际意义的 eat 方法。解决办法是将接口拆分为更小的、更具体的接口,比如 Workable 和 Eatable,这样类只需实现实际适用于它们的方法。
不好,强制类实现它不需要的方法:
public interface Worker {
    void work();
    void eat();
}

public class RobotWorker implements Worker {
    public void work() {
        System.out.println("Robot working");
    }

    public void eat() {
        // makes no sense for a robot
        throw new UnsupportedOperationException();
    }
}修正,拆分为更小的接口:
public interface Workable {
    void work();
}

public interface Eatable {
    void eat();
}

public class RobotWorker implements Workable {
    public void work() {
        System.out.println("Robot working");
    }
}

public class HumanWorker implements Workable, Eatable {
    public void work() {
        System.out.println("Human working");
    }

    public void eat() {
        System.out.println("Human eating lunch");
    }
}依赖倒置原则
高层模块不应直接依赖低层模块。两者都应依赖抽象。想象一个名为 NotificationService 的类,它直接创建并依赖 EmailSender 类。如果以后想通过短信发送通知,就得回头直接修改 NotificationService。相反,如果 NotificationService 依赖一个名为 MessageSender 的通用接口,而 EmailSender 和新的 SmsSender 都实现该接口,那么就可以在不改动 NotificationService 的情况下切换新的通知方式。
不好的写法:与特定实现紧密耦合:
public class EmailSender {
    public void send(String message) {
        System.out.println("Sending email: " + message);
    }
}

public class NotificationService {
    private EmailSender emailSender = new EmailSender();

    public void notifyUser(String message) {
        emailSender.send(message);
    }
}修正后的写法:改为依赖抽象:
public interface MessageSender {
    void send(String message);
}

public class EmailSender implements MessageSender {
    public void send(String message) {
        System.out.println("Sending email: " + message);
    }
}

public class SmsSender implements MessageSender {
    public void send(String message) {
        System.out.println("Sending SMS: " + message);
    }
}

public class NotificationService {
    private MessageSender messageSender;

    public NotificationService(MessageSender messageSender) {
        this.messageSender = messageSender;
    }

    public void notifyUser(String message) {
        messageSender.send(message);
    }
}现在 NotificationService 可以与任何 MessageSender 协作,从邮件切换到短信时,NotificationService 本身无需任何改动。
这五项原则共同构成了几乎所有设计模式背后的哲学,你遇到的大多数结构良好的代码库也都严格遵循这些原则,即便最初的开发者从未明确给它们贴上 SOLID 的标签。
- Design Patterns(设计模式),附代码
设计模式是针对软件设计中反复出现的问题而提出的成熟、可复用的解决方案。它们不是你必须盲目遵循的规则,更像是一种开发者之间的共同语言,一种用经过时间检验和打磨的方法来解决常见问题的方式。
当你听到开发人员说 “这里直接用一个工厂” 时,他们并不是在发明什么新东西。他们指的是一个针对特定类型问题的、广为人知且被充分理解的解决方案,这能节省每个人的时间,并让代码库保持与其他开发者已熟悉的模式一致。
对于初学者,最值得入手的设计模式是单例(Singleton)、工厂(Factory)、观察者(Observer)、策略(Strategy)、装饰器(Decorator)和建造者(Builder)。让我们通过具体示例逐一了解。
单例模式
该模式确保整个应用中只存在某个类的一个实例,并提供一个全局的访问点。一个常见的例子是 Logger 类。你不会希望应用中散布着多个独立的 logger 实例,每个实例可能以略有不同的方式或写入不同的位置。一个共享的 Logger 实例能确保应用的每个部分都以一致的方式记录到同一位置。
public class Logger {
    private static Logger instance;

    private Logger() {}

    public static Logger getInstance() {
        if (instance == null) {
            instance = new Logger();
        }
        return instance;
    }

    public void log(String message) {
        System.out.println("LOG: " + message);
    }
}Logger.getInstance().log("Application started");每次调用 getInstance () 都返回同一个共享对象。
工厂模式
当你需要创建对象,但又不想让调用代码知道具体实例化的是哪个类时,可以使用该模式。想象一个可以通过邮件、短信或推送通知发送通知的系统。与其让主代码每次都决定创建哪个具体类,不如让 NotificationFactory 接收一个类型(如 “email” 或 “sms”)并返回正确的对象。这意味着如果以后添加新的通知类型,只需更新工厂,而无需更新代码中所有创建通知的地方。
public interface Notification {
    void notifyUser();
}

public class EmailNotification implements Notification {
    public void notifyUser() {
        System.out.println("Sending Email Notification");
    }
}

public class SmsNotification implements Notification {
    public void notifyUser() {
        System.out.println("Sending SMS Notification");
    }
}

public class NotificationFactory {
    public static Notification createNotification(String type) {
        if (type.equalsIgnoreCase("email")) {
            return new EmailNotification();
        } else if (type.equalsIgnoreCase("sms")) {
            return new SmsNotification();
        }
        throw new IllegalArgumentException("Unknown type: " + type);
    }
}Notification notification = NotificationFactory.createNotification("email");
notification.notifyUser();调用代码从不直接实例化 EmailNotification 或 SmsNotification,它只是向工厂请求所需内容。
观察者模式
该模式定义了一种一对多的关系:当一个对象的状态改变时,其所有依赖者都会自动收到通知。YouTube 订阅就是一个绝佳的现实例子。当你订阅的频道上传新视频时,你会收到通知,无需自己去不断检查。你只需订阅一次,系统便会在有更新时自动通知你。在代码中,频道是 “主题”,每个订阅者都是等待变更通知的 “观察者”。
public interface Observer {
    void update(String videoTitle);
}

public class Subscriber implements Observer {
    private String name;

    public Subscriber(String name) {
        this.name = name;
    }

    public void update(String videoTitle) {
        System.out.println(name + " notified: New video - " + videoTitle);
    }
}

public class Channel {
    private List subscribers = new ArrayList<>();

    public void subscribe(Observer observer) {
        subscribers.add(observer);
    }

    public void uploadVideo(String title) {
        for (Observer observer : subscribers) {
            observer.update(title);
        }
    }
}Channel channel = new Channel();
channel.subscribe(new Subscriber("Harry"));
channel.subscribe(new Subscriber("Alex"));
channel.uploadVideo("System Design Basics");当频道上传新视频时,每个已订阅的观察者都会自动收到通知。
策略模式
该模式允许你定义一组算法,将每个算法封装在独立类中,并让它们在运行时可以互换。想想一个支持多种支付方式(信用卡、UPI、钱包)的购物应用。与其编写一长串 if-else 语句来决定执行哪种支付逻辑,不如让每种支付方式成为实现通用接口的独立策略类。结账流程只需调用所选策略的支付方法,而无需关心每个策略内部的工作原理。
public interface PaymentStrategy {
    void pay(double amount);
}

public class CreditCardPayment implements PaymentStrategy {
    public void pay(double amount) {
        System.out.println("Paid " + amount + " using Credit Card");
    }
}

public class UpiPayment implements PaymentStrategy {
    public void pay(double amount) {
        System.out.println("Paid " + amount + " using UPI");
    }
}

public class Checkout {
    private PaymentStrategy paymentStrategy;

    public Checkout(PaymentStrategy paymentStrategy) {
        this.paymentStrategy = paymentStrategy;
    }

    public void completePayment(double amount) {
        paymentStrategy.pay(amount);
    }
}Checkout checkout = new Checkout(new UpiPayment());
checkout.completePayment(500);切换支付方式只需传入不同的策略,无需 if-else 链。
装饰器模式
该模式允许你动态地为对象添加新行为,而不改变其原有结构。一个著名的例子是咖啡点单系统。你从一个基础的 Coffee 对象开始,然后可以用 Milk、Sugar 或 WhippedCream 等装饰器将其包裹,每个装饰器都会增加成本和描述,而无需修改原始的 Coffee 类。这比为咖啡与配料的每一种可能组合都单独创建一个类要灵活得多。
public interface Coffee {
    double getCost();
    String getDescription();
}

public class BasicCoffee implements Coffee {
    public double getCost() {
        return 50;
    }

    public String getDescription() {
        return "Coffee";
    }
}

public abstract class CoffeeDecorator implements Coffee {
    protected Coffee decoratedCoffee;

    public CoffeeDecorator(Coffee coffee) {
        this.decoratedCoffee = coffee;
    }
}

public class MilkDecorator extends CoffeeDecorator {
    public MilkDecorator(Coffee coffee) {
        super(coffee);
    }

    public double getCost() {
        return decoratedCoffee.getCost() + 10;
    }

    public String getDescription() {
        return decoratedCoffee.getDescription() + " with Milk";
    }
}Coffee order = new MilkDecorator(new BasicCoffee());
System.out.println(order.getDescription() + " costs " + order.getCost());每个装饰器包裹基础对象,增加成本和描述,而不改动原始的 BasicCoffee 类。
建造者模式
当对象需要许多可选参数时,该模式很有用。通过一个带十几个参数的构造函数来创建对象会变得混乱且容易出错。想象构建一台定制电脑,可选择 CPU、RAM、存储和 GPU,其中许多是可选的。建造者让你可以逐步构建对象,只设置你关心的参数,最后调用 build 方法得到成品,这使对象创建过程保持可读和灵活。
public class Computer {
    private String cpu;
    private int ram;
    private int storage;
    private String gpu;

    private Computer(Builder builder) {
        this.cpu = builder.cpu;
        this.ram = builder.ram;
        this.storage = builder.storage;
        this.gpu = builder.gpu;
    }

    public static class Builder {
        private String cpu;
        private int ram;
        private int storage;
        private String gpu;

        public Builder setCpu(String cpu) {
            this.cpu = cpu;
            return this;
        }

        public Builder setRam(int ram) {
            this.ram = ram;
            return this;
        }

        public Builder setStorage(int storage) {
            this.storage = storage;
            return this;
        }

        public Builder setGpu(String gpu) {
            this.gpu = gpu;
            return this;
        }

        public Computer build() {
            return new Computer(this);
        }
    }
}Computer myComputer = new Computer.Builder()
.setCpu("Intel i7")
.setRam(16)
.setGpu("RTX 4060")
.build();你只设置关心的字段,最终的 build () 调用即可干净地组装对象,而不是使用参数冗长的构造函数。
UML and Class Diagrams(UML 与类图)
在 LLD 问题中写一行代码之前,经验丰富的工程师会先用图形方式勾画出他们的设计。使用的标准视觉语言是 UML,即统一建模语言。UML 不是代码,也不是编程语言。它是一套标准化的符号和图类型,让你可以在纸上或白板上表示系统的结构和行为,任何熟悉 UML 的人都可以看到你的图并立即理解类是如何组织的,无需阅读一行代码。
作为初学者,你无需掌握所有 UML 图类型。对 LLD 真正重要的是深入理解类图,因为无论是在面试还是实际项目中,你都会经常使用这种图。
为什么 UML 很重要,即使它感觉像额外的工作
跳过画图直接写代码很诱人,尤其是当你脑中已有大致想法时。但一旦问题涉及超过三四个类,这几乎总会适得其反。类图迫使你在深入实现细节之前就结构和关系做出决策,而这正是错误修正成本最低的时候。在白板上发现一个破碎的关系只需十秒。而在写了二百行代码后才发现同样的错误,可能意味着要重写项目中的一大块内容。
还有一个沟通上的好处。在真正的工程团队中,类图往往是让所有人就设计达成一致的最快方式,早于任何人打开 IDE。它成为共享参考点,避免了纯粹用文字描述类结构的歧义。
类图的基本组成
类图将每个类表示为一个矩形,分为上下堆叠的三个部分。
顶部区域包含类名。
中间区域列出类的属性,即字段或属性,以及它们的数据类型。
底部区域列出类的方法,即函数,以及它们的参数和返回类型。
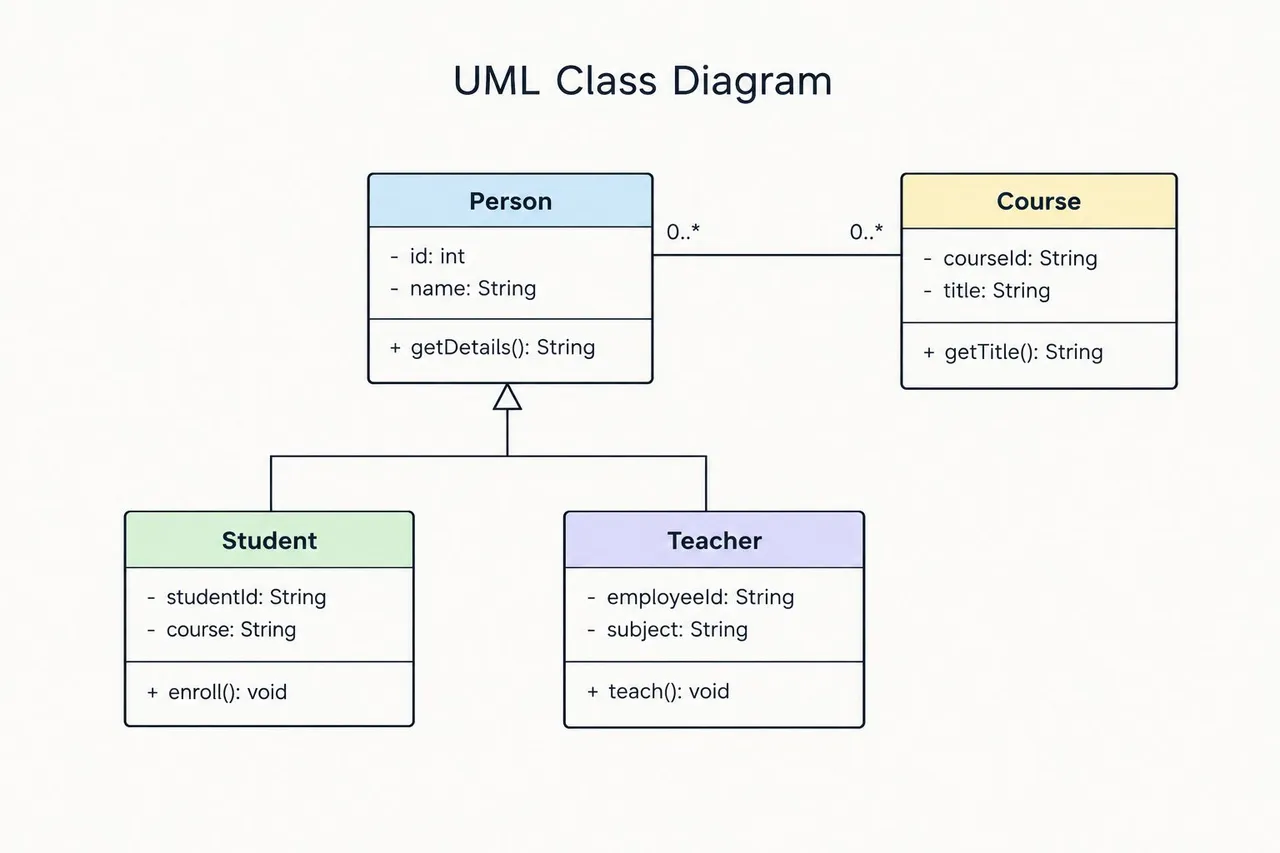
注意每个属性和方法前的小符号。这些是可见性标记,它们很重要,因为它们告诉你每个成员在类外部有多大的可访问性。
减号(-)表示成员是私有的,只能在类内部访问。
加号(+)表示成员是公共的,可以从任何地方访问。
井号(#)表示成员是受保护的,可以在类及其子类中访问。
波浪号(\~)表示成员具有包或默认可见性,只能在同一个包内访问。
一旦你熟悉了这些符号,你就可以查看任何类图,并立即理解类的哪些部分应该被外部使用,哪些部分应该保持隐藏,这直接反映了前面提到的封装原则。
类之间的关系
类图的真正价值在于展示类之间如何关联,而不仅仅是每个类各自包含什么。有几种不同类型的关系,初学者常常将它们混为一谈,因此值得逐一清楚地理解每种关系。
关联
关联是最一般的关系,表示一个类以某种方式使用或连接到另一个类。它被绘制为两个类框之间的简单直线。例如,如果 Teacher 类可以链接到 Student 类,那么 Teacher 类和 Student 类之间可能存在关联,但两者都不拥有或控制对方的生命周期。如果 Teacher 对象被销毁,Student 对象仍然独立存在。
聚合
聚合是一种特殊的、较弱的关联形式,表示 “拥有” 关系,其中一个类包含另一个类,但被包含的对象可以独立存在。它被绘制为在包含类的一侧带有空心菱形(未填充)的线。一个很好的例子是 Department 类包含多个 Professor 对象。如果 Department 解散,Professor 对象不会消失,它们可以转到另一个部门。这种独立性使其成为聚合,而不是下一种关系。
组合
组合是 “拥有” 关系的更强形式,被包含对象的生命周期完全依赖于容器。它被绘制为在包含类的一侧带有实心菱形(填充)的线。一个典型的例子是 House 类包含 Room 对象。Room 在它所属的 House 之外没有意义。如果 House 对象被销毁,它的 Room 对象也会随之销毁。聚合和组合之间的这种区别经常让初学者感到困惑,但测试很简单:问一下,如果容器消失,被包含对象是否仍能独立存在。如果能,就是聚合;如果不能,就是组合。
继承(泛化)
继承表示 “是一个” 的关系,其中一个类是另一个类的特殊化版本。它被绘制为一条带空心三角形的箭头线,指向父类。回到之前的例子,如果 Car 和 Bike 都继承自 Vehicle,你会从 Car 到 Vehicle 绘制一条线,再从 Bike 到 Vehicle 绘制另一条线,每条线都有指向 Vehicle 的空心三角形,表示 Car 和 Bike 都是 Vehicle 的特殊类型。
实现
实现表示一个类与其实现的接口之间的关系。它被绘制为一条带空心三角形箭头的虚线,指向接口。如果一个名为 EmailSender 的类实现了名为 MessageSender 的接口,你会绘制从 EmailSender 到 MessageSender 的虚线,空心三角形指向 MessageSender。虚线专门表示这是接口实现,而不是对具体类的直接继承。
依赖
依赖是最弱且最短暂的关系,表示一个类仅短暂地使用另一个类,通常只是作为方法中的参数,而不持有对其的长期引用。它被绘制为带简单开放箭头的虚线。例如,如果 OrderService 类有一个方法,接受 Logger 对象作为参数,仅在该方法调用期间记录日志,而不将 Logger 永久存储为字段,那就是依赖,而不是关联。
多重性:描述数量
类图还通过放置在关系线两端附近的数字或符号来描述一个类的实例与另一个类的实例之间有多少对应关系。这称为多重性。
1 表示恰好涉及一个实例。
0..1 表示零个或一个实例,意味着关系是可选的。
\ 或 0..\ 表示零个或多个实例。
1..\* 表示至少一个,但可能多个。
例如,如果 ParkingLot 包含多个 ParkingSpot 对象,你会在它们之间绘制关联,在 ParkingLot 一侧放置 1,在 ParkingSpot 一侧放置 1..\*,表示一个停车场可以有多个停车位,但每个停车位只属于一个停车场。
一个完整示例
让我们用前面的停车场示例来整合所有这些概念。一个简化的类图描述如下所示。
ParkingLot 与 ParkingSpot 有组合关系,因为停车位如果不属于特定停车场就没有意义,而且这种关系是一个 ParkingLot 对应多个 ParkingSpot 对象。
Car、Bike 和 Truck 都与基类 Vehicle 有继承关系,用指向 Vehicle 的空心三角形箭头表示。
ParkingSpot 与 Vehicle 有关联,因为一个车位可以被车辆占用,但车辆可以独立于任何特定车位存在,例如当它仍在道路上时。
Ticket 与 Vehicle 和 ParkingSpot 都有关联,因为一张票据引用了哪辆车停在哪一个车位,但不拥有它们中的任何一个。
ParkingLot 依赖于 PaymentStrategy 接口,因为它短暂使用所选支付策略来计算费用,而不永久持有某个具体实现。
在编写任何 Java 代码之前可视化地绘制这个结构,会使整个结构立刻清晰起来,而且发现错误也容易得多,比如意识到 Ticket 缺少对 ParkingSpot 的引用,这是在看框和箭头时就能发现的,而不是等到代码已经写了一半。
UML 初学者的常见错误
初学者开始使用类图时,一些错误会反复出现。
混淆聚合和组合非常常见。不确定时,始终回退到前面描述的独立存在测试。
过度使用继承是另一个常见错误。初学者有时会在两个类共享几个相似字段时就用继承,即使没有真正的 “是一个” 关系。如果关系在逻辑上不成立,比如之前的 Penguin 和 Bird 例子,关联或组合通常是更好的选择。
试图同时绘制系统中的所有内容也是一个常见的陷阱。在实践中,尤其是在面试中,你只需要绘制与当前问题相关的核心类,而不是一开始就列出所有可能的类和边缘情况。
绘制 UML 图的工具
你不需要特殊软件就能从 UML 思维中获益。白板、一张纸或简单的绘图工具就完全够用,尤其是在面试环境中,你被期望快速草图而非制作精美图表。对于个人练习或文档,draw.io、Lucidchart 等工具,甚至像 PlantUML 这样的纯文本工具,都能让你创建更清晰且易于随设计演进更新的图表。
具体工具远不如习惯本身重要。区分强 LLD 思维与弱 LLD 思维的,并非是否熟记每个 UML 符号,而是在编写代码前始终停顿下来描绘关系,并利用草图在结构问题尚易修复时将其捕获。
How to Approach an LLD Problem, Step by Step(如何逐步处理 LLD 问题)
了解 OOP 原则、SOLID 和设计模式是理论部分。对大多数初学者而言,更难的部分是在面对新问题时应用这些理论,比如 "设计停车场" 或 "设计自动售货机"。这里有一个行之有效的框架,并配有一个实例,让你看到每一步在实际中如何展开。
我们以常见的初学者 LLD 问题——设计一个停车场系统——作为贯穿始终的实例。
第一步:厘清需求
与 HLD 一样,LLD 始于理解问题,而非直接跳入类设计。对于停车场系统,你需要澄清诸如:停车场是否有针对摩托车、汽车和卡车的不同车位大小,系统是否需要计算停车费,是否需要跟踪可用车位数量,以及是否需要支持多个入口和出口点。
跳过此步骤往往会导致为并非实际所问的问题设计类。一个具有统一收费结构的停车场在代码中看起来与按时间、按车型定价的停车场截然不同。
Step 2: Identify the Core Objects, or Entities(第二步:识别核心对象或实体)
一旦需求明确,就开始列出问题中涉及的现实世界事物。对于停车场,这很可能包括车辆(Vehicle)、停车位(ParkingSpot)、停车场(ParkingLot)、票据(Ticket)和支付(Payment)。
这里一个有用的技巧是,将这些视为问题描述中的名词。每当你能指出系统中具有自身数据和行为的独特 "事物" 时,它很可能成为类的候选。
Step 3: Define Relationships Between Objects(第三步:定义对象间的关系)
现在弄清楚这些对象如何相互关联。停车场是否包含多个停车位对象?车辆是否在某一时刻被分配到一个停车位?车辆进入时是否生成票据,离开时是否关闭?
这是做出组合和继承决策的地方。例如,你可能决定汽车、自行车和卡车都继承自一个基础车辆类,因为它们共享车牌号和车辆类型等共同属性,但在具体行为上有所不同,比如它们能占用的车位大小。
Step 4: Identify Behaviors and Assign Responsibilities(第四步:识别行为并分配职责)
为每个类定义它实际需要做什么。停车场可能需要一个方法来查找可用车位并将其分配给进入的车辆。停车位可能需要一个方法将其自身标记为已占用或空闲。票据可能需要一个方法根据车辆停放时间计算最终费用。
这也是单一职责原则变得重要的地方。将所有逻辑塞进一个巨大的停车场类是很诱人的,但设计良好的系统会将职责分散到各个类中,使每个类都有清晰、专注的任务。
Step 5: Apply Relevant Design Patterns(第五步:应用相关设计模式)
基本结构就位后,寻找设计模式自然契合的地方。在停车场示例中,如果有多种计算费用的方式,比如按小时费率与固定费率,策略模式非常契合,允许你更换费用计算逻辑而无需改动核心的停车场类。
如果系统只需要一个管理整个停车场状态的单一共享实例,单例模式可能适用于停车场类本身。
不要在不自然契合的地方强行套用模式。一个常见的初学者错误是试图使用尽可能多的模式来显得印象深刻,而更简单、无模式的解决方案实际上会更清晰。模式应解决设计中的实际问题,而非为了使用而添加。
Step 6: Sketch It Out Before Coding(第六步:编码前先画草图)
在编写任何实际代码之前,绘制粗略的类图。列出每个类、其主要属性和主要方法。这不必是正式的 UML 图,甚至纸上简单的方框和箭头草图也可以。
这一步能及早捕获结构性问题。当你看着快速草图时,发现票据类缺少对其所属车辆的引用,远比在围绕有缺陷结构编写了五十行代码后更容易。
Step 7: Write Clean, Incremental Code(第七步:编写整洁、增量的代码)
最后,将设计转化为代码,一次一个类,从最简单、最基础的类开始,如车辆(Vehicle),然后转向依赖它们的类,如停车位(ParkingSpot),再到停车场(ParkingLot)。
编写过程中,不断对照 SOLID 原则检查代码。问自己某个类是否职责过多,是否在硬编码本应灵活的内容,以及以后添加新功能(如新车型或新定价模型)时,是需要重写现有代码还是仅需在旁边添加新代码。
Step 8: Handle Edge Cases(第八步:处理边缘情况)
一旦核心设计正常运作,思考边缘情况。如果停车场完全满且新车辆到达会怎样?如果票据丢失会怎样?如果由于时序问题两辆车被分配到同一车位会怎样?
即使是简要地思考这些场景,也显示出你设计思维的成熟度,这超越了仅仅让主路径正常工作。
A Beginner's Practice Roadmap(初学者的练习路线图)
了解概念是一回事。知道按什么顺序学习它们,以及如何实际练习,才是将理论转化为可用技能的关键。这里有一个路线图,避免了试图一次性学习所有内容的常见陷阱。
Stage 1: Build the Vocabulary First(第一阶段:先建立词汇量)
在尝试任何设计问题之前,花时间纯粹理解构建模块。服务器、负载均衡器、数据库、缓存、CDN、消息队列。暂时不要设计任何东西。只需确保当有人说 "我们在边缘缓存了" 或 "写入进入主节点" 时,你无需停顿思考就确切知道其含义。
这里一个测试自己的好方法是,用通俗语言大声解释每个概念,就像你在教一个对此一无所知的朋友。如果你难以简单解释某事,这表明你记住了术语却没有真正理解它。
Stage 2: Study Simple, Well Known Systems(第二阶段:研究简单、知名的系统)
一旦词汇量感觉舒适,开始阅读真实系统在高层次上是如何设计的。查看 URL 缩短器、速率限制器、基本聊天应用等如何工作的简化分解。这些在范围上故意比设计整个 Instagram 要小,这使它们成为更好的起点。
在此阶段,你尚未自己设计任何东西,你是在进行模式匹配。你注意到相同的构建模块——缓存、负载均衡、队列——如何根据问题以不同组合反复出现。
Stage 3: Attempt Your Own Designs, Badly at First(第三阶段:尝试自己的设计,起初可能很糟糕)
现在开始尝试自己设计简单系统,然后再看解决方案。选择像 URL 缩短器或基本通知系统这样的东西,并按照框架走一遍:澄清需求、估算规模、定义组件、设计数据流,然后再检查他人是如何解决的。
你的前几次尝试可能会很粗糙,这是预料之中的。价值不在于立即做对,而在于强迫自己做决定并加以论证,这正是真实面试或实际工作中发生的情况。
阶段四:并行推进 LLD
不要等到 HLD 感觉熟练了才开始 LLD。在练习 HLD 的同时开始练习 LLD 问题,因为这两种技能相互促进。从经典的入门级 LLD 问题开始,比如停车场系统、自动售货机、图书馆管理系统,并且要实际编写代码,而不只是画图。
重点关注应用 SOLID 原则,并且只在设计确实需要时才选择设计模式,而不是为了应付了事。编写代码,即使一开始代码很混乱,也能培养直觉,这是单纯阅读模式描述无法做到的。
阶段五:深入研究更具体的系统
一旦两方面的基础都感觉扎实了,就可以转向更复杂、更知名的系统。尝试设计类似 Twitter、Netflix 或拼车应用这样的系统。这些问题迫使你同时组合多个概念,数据库分片、缓存、消息队列,这才是真正的系统设计思维开始形成的地方。
阶段六:练习讲解设计,而不仅仅是构建
只存在于脑海中的设计是不完整的。练习大声讲解你的设计,包括你做的权衡以及原因。如果你为某个组件选择了 NoSQL 而不是 SQL,要准备好准确解释原因,以及你因为这一选择放弃了什么。这在面试中与在团队的真实工程讨论中同样重要,因为你需要不断向他人证明你的决策。
关于节奏的说明
不要试图在一周内仓促完成这些阶段。系统设计是一项通过长期反复接触才能建立的技能,而不是一个周末阅读就能掌握的。隔几周带着更多上下文重新审视相同的概念,往往比第一次仔细阅读一遍学到更多。
Ending Notes(结尾说明)
当你刚开始时,系统设计可能感觉像一个难以企及的庞大领域,主要是因为大多数资源会让你直接跳入深水区,而不先打好基础。希望这份指南恰恰相反。
你现在明白了 HLD 和 LLD 之间的区别,以及为什么两者都重要。在 HLD 方面,你已经真正掌握了构建模块,服务器、负载均衡器、数据库、缓存、CDN、消息队列、扩展性,以及随之而来的各种权衡。在 LLD 方面,你理解了面向对象原则、SOLID 原则,以及那些让代码在增长过程中保持整洁和可维护性的常见设计模式。
这些都不会让你一夜之间成为系统设计专家,这也从来不是目标。它给你的是一张地图,让你清楚从哪里开始、下一步学什么、各部分如何组合在一起。从这里开始,唯一的出路就是实践。选择一个简单的系统,尝试设计得糟糕一点,从它出错的地方学习,然后重试。这个反复的循环,远比阅读任何单篇文章更能长期建立起这项技能。
如果你觉得这篇文章有用,最好的下一步就是停止阅读,开始设计一些东西,哪怕是很小的东西。那才是真正学习的开始。
就这些了,各位,干杯!!
