
你好,这是大刘的第 77 篇原创干货~
使用体感上 Token 节约 50% !
GPT-6 Astra,效果炸裂,但是纯纯“Token 收割机”。
相信大家已经被各种无敌离谱的case刷屏了,我也在周末开始把 Astra 接入了我的工作中。
体感是:聪明很多,但是token消耗速度有 5.6 sol 两倍以上。
我在蹬完第一张后感受到了深深的肉疼。所以,找了各种方法来减少token消耗。
省Token效果拔群!
这篇文章,我就把自己综合各路大神,自用的一些用前配置梳理给大家。
当然,使用技巧也在持续的更新,我没总结到的技巧会持续更新到评论区置顶。
点赞收藏,跟住更新。
希望你也爽爽蹬,再也不愁token。
话不多说,开始。
一. 关于档位的取舍技巧
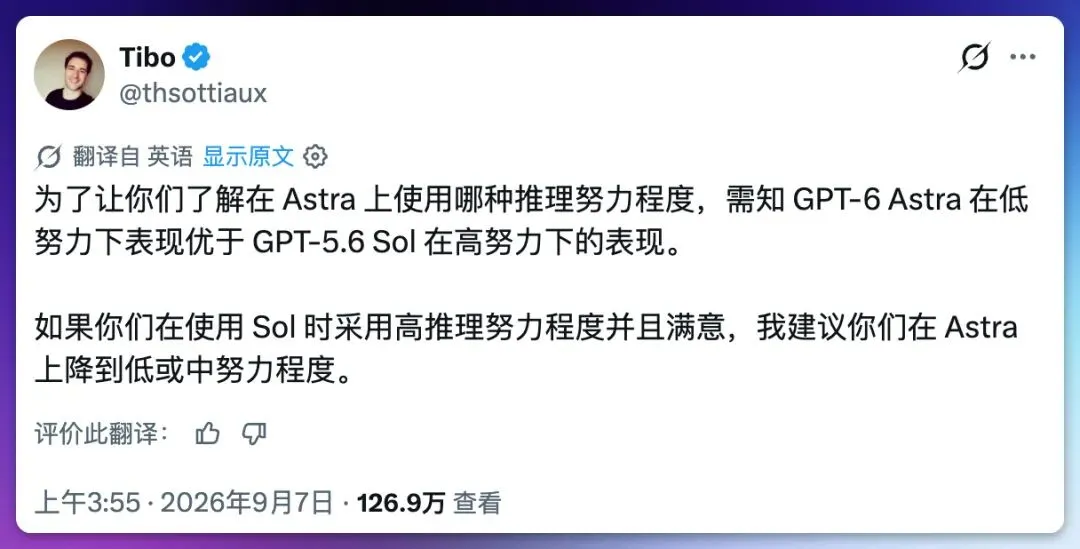
这个来自于重置的神:Tibo。
Tibo 原话的意思就这两句。GPT-6 Astra 开 low,已经超过 GPT-5.6 Sol 开 high。
这里我也给大家整理下,我用 Astra 做不同任务时候的档位选择习惯:
low,抽取、分类、短改写、小脚本、小 bug。
medium,常规编码、多步工具、文档,社区很多人把它当甜点档。
high,仓库级改动、复杂规划的执行。
xhigh ,用于一些架构级调整的复杂任务规划。
ultra,不好意思,至今没敢用过。。。。
再给大家放一张图,看看 max 和 high那一行,可以关注的是:
1. 损失1%-3%的准确率,能带来成本(Token)的减半。
2. 效果上:6 Astra-low > 5.6 Sol high
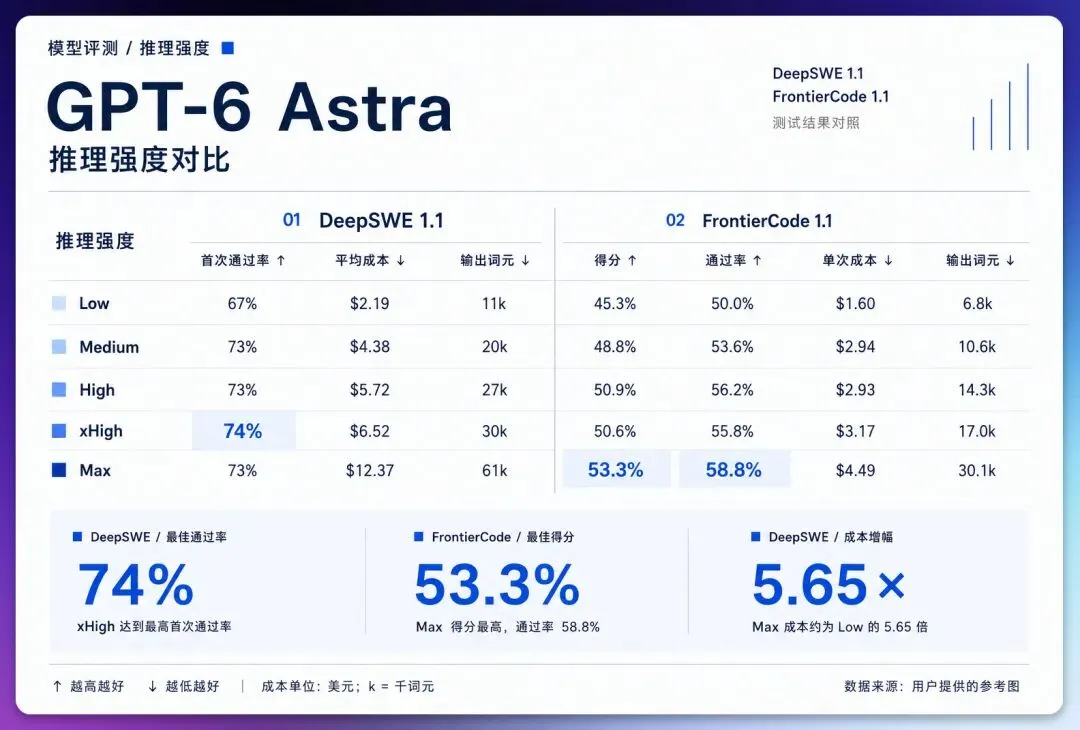
我现在是,大部分任务都用 high 和 medium。
省token的同时,效果也好。
二. 上下文管理技巧
GPT-6 Astra 强大之处在于,它能更精确的考虑更多重要内容,做更细致的思考,给出更准确的计划和执行。
但是!问题就出在这里。
我们原有使用 Chatgpt/Codex 的方法里,上下文的处理方法基本上都是,尽可能多的加入相关的资料,然后模型解决。超出上下文就进行压缩。
但是用在 GPT-6 Astra 上就会出现,加入的上下文很多冗余或者无用信息,会有两个后果。
1.无法释放 GPT-6 Astra 最大潜力。
2.Token浪费很多。
还好,这里有解决方案。
如果你用 GPT 6 Astra,一定要开启这个。
打开 \~/.codex/config.toml。在设置里找,然后打开。
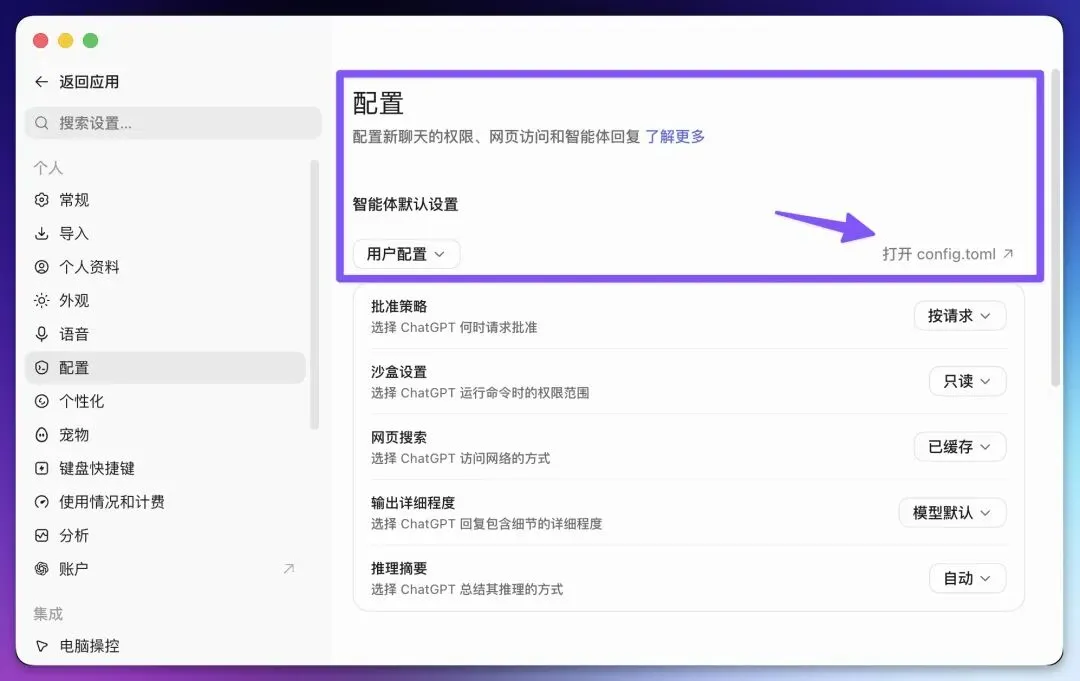
打开之后,在这个文档下面添加:
[features.context_management]
experimental_mode = true
保存。Over。
Token消耗估计又降低三分之一(体感估计)。
这里再多讲下这个是什么意思,有什么作用:
原理上来说就是:它是一种通过笔记 + 窗口的方法来管理上下文的方法,开启后,它会跨上下文窗口保留笔记,并支持搜索同一任务中更早的消息和工具结果,替代传统压缩总结。细节丢得更少,更省token,表现也更好。
注意!这个模式是 GPT-6 Astra 在 Codex 里的实验功能。官方会在几周内更新。
但是现在用上是很有必要的,毕竟节约token,从现在做起。
三. AGENTS.md
这个也是大家讨论最多最广泛的。
我用了几天 Astra,它的特性会有这些,会更爱提问,更爱写很长的列表,有时候停在计划上不往下做,对 Skills、AGENTS.md 本身的要求也更遵循,更敏感。
什么叫更遵循和更敏感。
就是说,如果说在过程中,有些思考或者要求和 Skills、AGENTS.md 本身的要求有冲突,可能会导致:
1.不遵循你的要求,而是遵循Skills、AGENTS.md 本身的要求。
2.直接断掉,或者停留在计划阶段。
所以,解决方案就是,在Agents.md中,根据他的调性调一下。
AGENTS.MD。
GOAL
最终可验收结果是什么,交给我时必须满足什么。

AUTONOMY
常规缺口自行假设并继续。
只有缺失信息会实质改变结果时才提问。
提问时同时推进不依赖该答案的部分。

PRIORITY
我的显式指令 > 当前对话补充 > skills / AGENTS.md 的一般指导。
冲突时指出文件路径和原句。

STYLE
先结论,短段落,少列表,禁套话。

DONE
做工作本身,不只给计划。
持续到请求的结果真正完成。

APPROVAL
只读 / 可逆:直接做。
不可逆外部动作:先交出可审阅结果,再问最后一步。

VERIFY
测试与改动成比例。必要检查通过即停。

SUBAGENTS
独立子任务可并行就并行。你负责整合与裁决。具体的位置,在设置 -> 个性化里面。
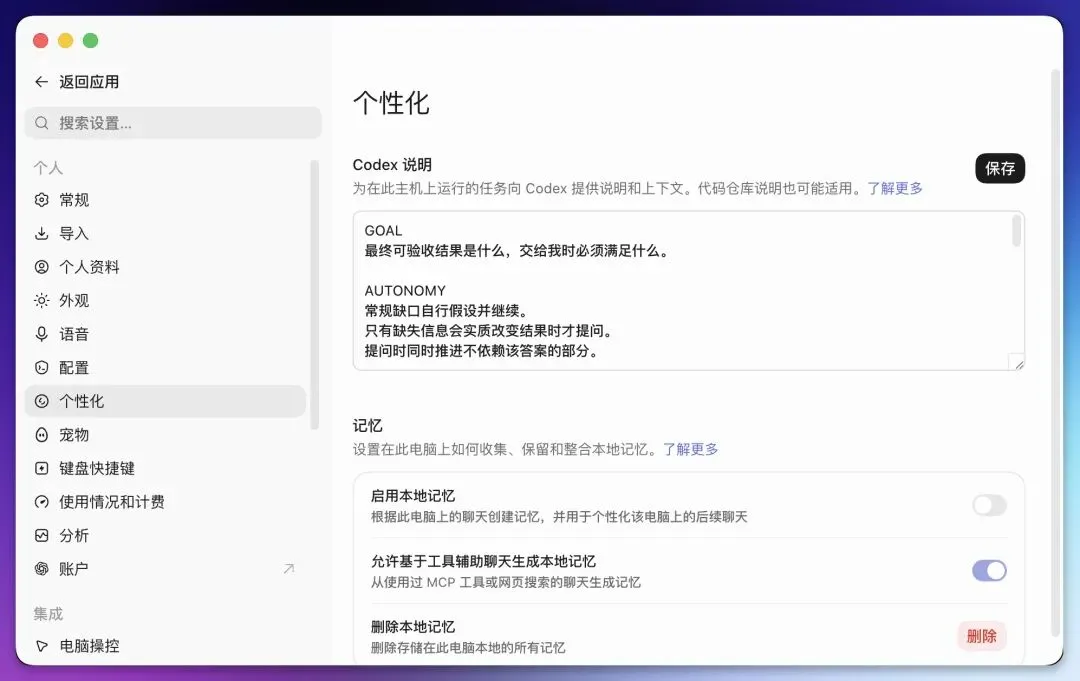
Token消耗估计又降低不少。
四. Skills
9月5日,OpenAI Codex 团队的 Eric Provencher 在文章里给到了在 Astra 下,对 Skills 的重新思考。
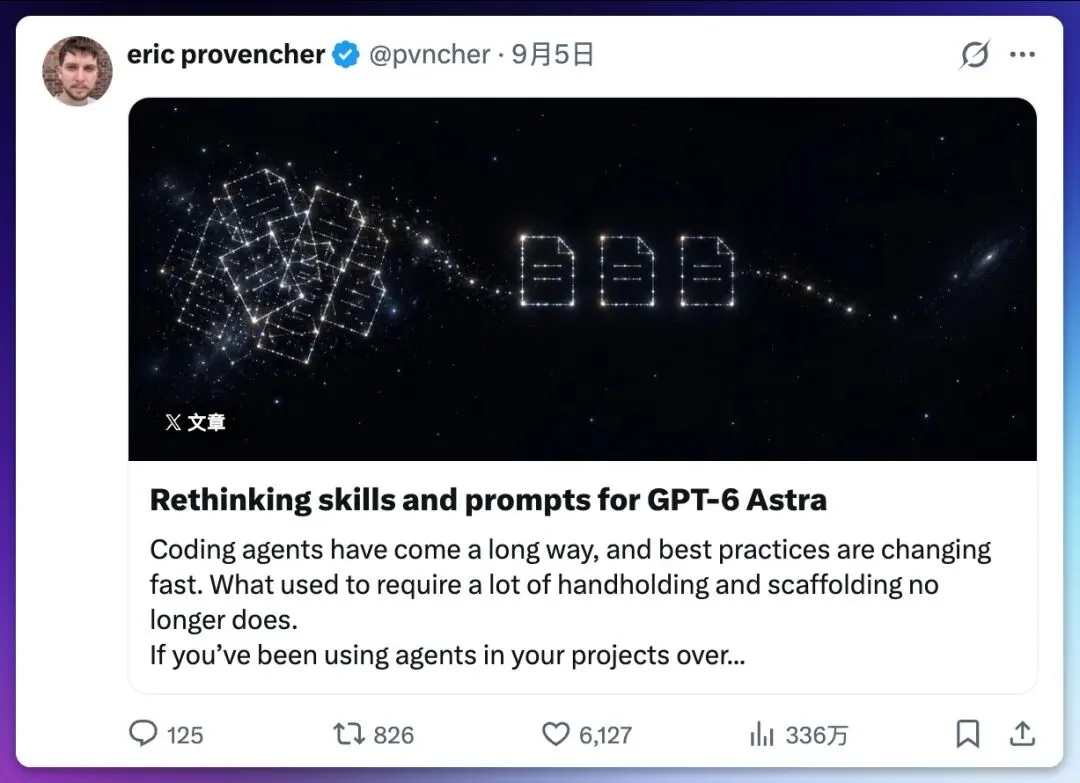
OpenAI 的模型指南页也写了同样的建议。
最核心的理解是:
过去一年我们为了管住弱模型写的那些指令、Skills,Astra 读了反而阻碍效果。
在过去,这些问题不会造成什么影响。但是Astra下,这些问题会导致无法发挥Astra的顶级能力。
我觉得其中的两个问题比较重要。
第一,有用的 skill 的一个关键标志是渐进披露。
读一份 skill 会占用上下文,让你更接近压缩,并引入当前任务可能并不适用的指引。
正确的处理方法是:对于包含多种工作流的 skill,把根文档做成一个最小路由器,指向配套文档和脚本。给模型足够的指引,让它知道去哪里找,而不强迫它读此刻无关的内容。
举个简单的例子:
不对的Skill描述是:编辑前必须读完 architecture.md、database.md、deployment.md。
正确的Skill描述是:处理服务边界时看 architecture.md,改 DB 结构时看 database.md,准备部署时看 deployment.md。
也就是说,现在Skill,可以更有明确的披露(需要什么才读什么)。
第二,许多 skill 被写成了详尽的行程单或菜谱。
很好理解,Astra模型在理解细微差别和模糊的地方上已经好得多,因此过于具体的指引现在可能约束过度,反而妨碍结果的完整性。
所以,解决方案在这里。
可以在 Codex 中,在你 Skill 存在的项目中(对Agents.md同样适用),发送这个指令:
请逐一审查本项目内的所有技能文件(包括 SKILL.md 及相关指令文件)和 AGENTS.md 文件,参照 OpenAI Codex DX 团队在评审 GPT-6 Astra 最佳实践时总结的以下六类问题,检查其中的指令是否仍然必要、准确且有效。

本轮只做审查并提交报告,不修改任何文件。

一、技能描述过长或过于宽泛

标记冗长、含糊,或适用范围过大的技能描述。

加载大量技能时,过长的描述可能被截断;描述不够明确,则可能导致模型在不适合的任务中误用该技能。检查描述是否简洁、准确,能否清楚说明技能的用途和触发条件。

二、缺少按需加载的分层结构

标记将多个工作流程全部堆进同一份长篇技能文件的情况。

合理的组织方式应当是:主文件提供简短的说明和导航,将不同工作流程的详细内容拆分到独立的配套文档中,仅在任务需要时加载。

三、操作步骤过于僵化

标记将技能写成繁琐、过度具体的固定操作脚本的情况,例如要求模型无论面对什么任务,都必须依次执行一长串预设步骤。

检查这些步骤是否确有必要,还是仅仅限制了模型根据实际情况选择处理方式的能力。对于可以交由模型判断的执行细节,不应强制规定唯一的操作路径。

四、每次修改前都强制读取完整上下文

标记 AGENTS.md 中要求模型在每次修改前,都必须通读整个代码仓库或大量文档的指令,尤其是连微小改动也必须如此的要求。

判断所要求的阅读范围是否与当前任务有关、是否与改动规模相称,以及是否存在不必要的重复阅读。

五、已经过时的测试或验证要求

标记那些仅为弥补旧模型能力不足而设置、如今模型已经能够主动完成的测试提醒或重复核查要求。

区分真正必要的项目验证规则与已经失去作用的额外督促。不要仅因某条指令涉及测试或验证,就将其判定为冗余。

六、过度谨慎的请示与审批措辞

标记过于宽泛或强硬的“执行某项操作前必须先询问用户”之类的要求。

重点检查这些要求是否导致模型过早停下,或对本可安全继续、且已在授权范围内的操作反复请求批准。

审查报告要求

对于每一项需要调整的指令,请使用以下格式:

【需调整】所属类别:六类问题中的哪一类
原文与位置:引用相关指令,并注明所在文件;可定位时附上行号。
原有目的:这条指令原本试图解决旧模型的什么问题。
标记理由:为什么它如今已经过时、造成冗余,或妨碍有效执行。
处理建议:删除、精简、拆分为导航主文件与按需加载的配套文档,或改写。说明建议方向,本轮不要实际修改。

对于应当保留的指令,请使用以下格式:

【应保留】
原文与位置:引用相关指令,并注明所在文件。
保留理由:说明它描述了什么真实、持续有效的项目事实、约束或要求。

判定原则

不要仅仅因为一条指令写得具体,就将其标记为问题。如果它描述的是本项目真实且长期有效的事实、安全边界或团队规范,就应当保留。

只标记那些纯粹为了弥补旧模型局限而存在、如今已无必要的指令。不要将项目本身的要求误判为模型能力不足的补丁;没有充分依据时,也不要臆断某条指令已经过时。

最后用一行给出粗略占比:以本次审查的指令条目为基数,分别列出六类问题各自所占的比例,以及应当保留的比例。若同一条指令涉及多个问题,按主要问题归类,避免重复计算。复制之后,发送。
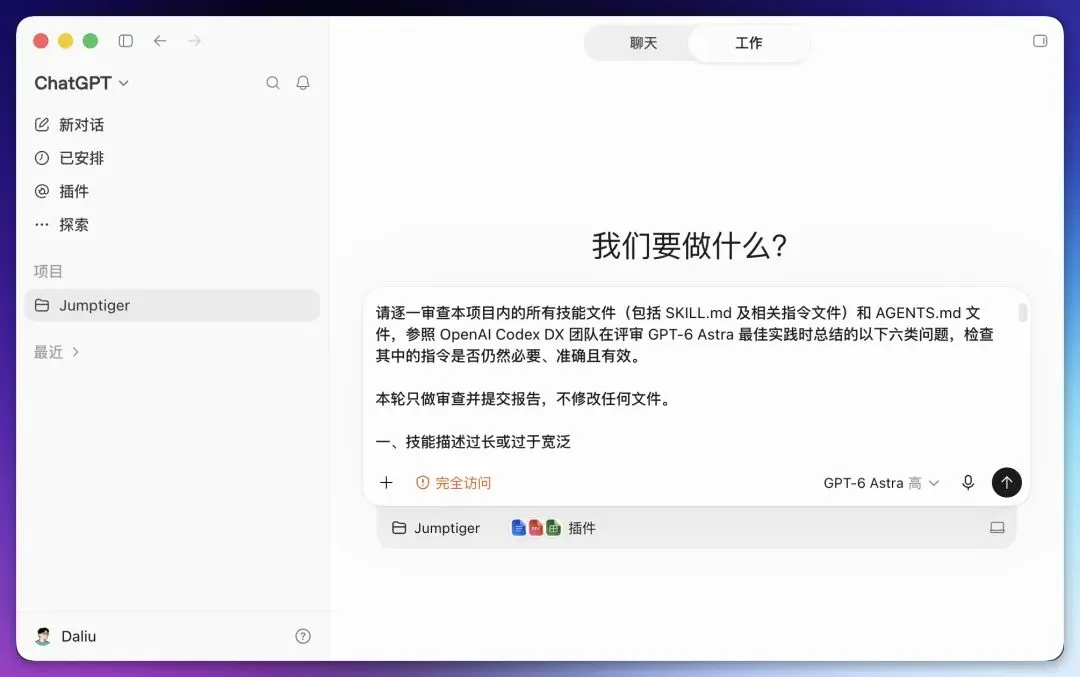
后续再跟着指引,进行Skill的优化即可。
你会发现,优化后,Skills的使用相比之前,快了,也好了不少。
写在最后
目前我的用下来很好的配置就这些。后续有新的会持续更新在评论区置顶。
如果你按照上面的几步都做了,然后跑几个任务。
你会发现。
Astra 这次,真的很强。
强到什么程度呢。那些我们已经熟练的范式(系统提示词、Skills)都开始需要变了。
变得更简洁,更轻松,更有效。
所以。
希望以上的这些小技巧可以帮你省下一些token,提升一些效果。
去实现更多我们天马行空的想法。
一起探索这个AI时代,尽力不被这个时代落下。
*与君共勉。*
PS:
以上配置技巧来自社区大神,包括:@Tibo、@にく、@Eric Provencher等,再结合我自己的理解构成。
以上,既然看到这里了,
如果觉得不错,随手点个赞、在看、转发三连吧,
如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章
你的关注是我持续更新的动力~
我是谁
我是 AI大刘,北大毕业,大模型研究方向,腾讯犀牛鸟,先后在腾讯、百度的大模型研发部门。现在斜杠青年:给多家国企做AI顾问 \ OPC \ 研究员 \ 产品独立开发者 \ Vibe Coder
