
如果你正在学习 RAG,不要再去构建另一个基础的 “与你的 PDF 聊天” 应用了。
一个基础的 RAG 流水线对理解基本原理很有用:
Documents → Chunking → Embeddings → Vector Search → LLM但那仅仅是开始。现实世界中的 RAG 系统很快会遇到更难的问题:
• 如果语义搜索漏掉了确切的关键词怎么办?
• 如果用户想要特定日期或类别的文档怎么办?
• 如果检索到的顶部块实际上不是最有用的那些怎么办?
• 如果答案既需要结构化数据库数据又需要非结构化文档怎么办?
• 如果检索本身失败了怎么办?
• 当你的系统需要处理表格、图像或多个知识源时会发生什么?
这就是事情变得有趣的地方。
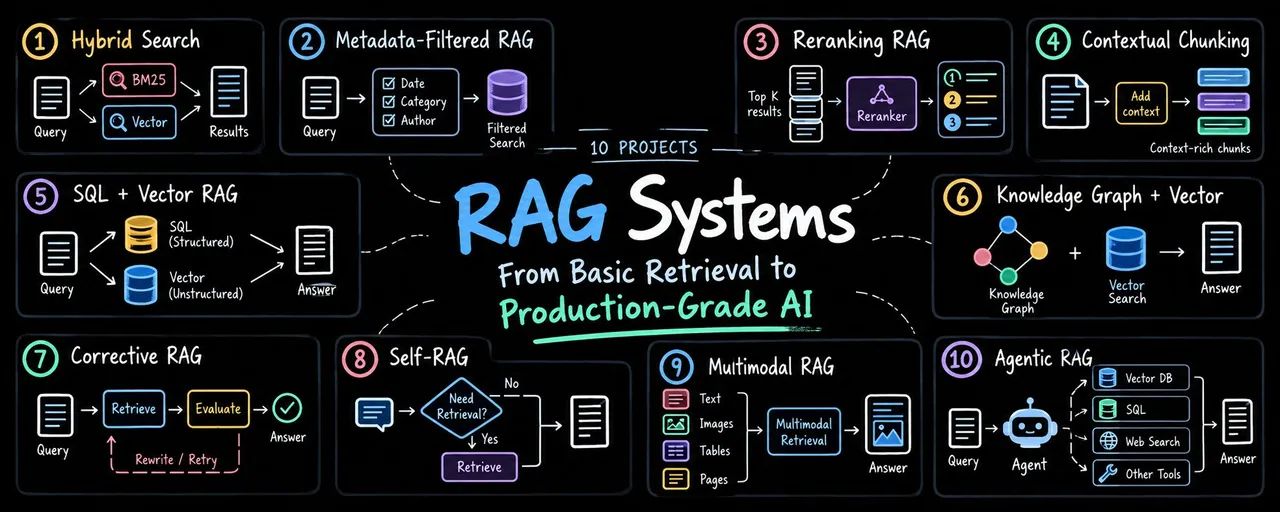
这里有 10 个项目,如果你想从基础 RAG 迈向生产级 AI 系统,我推荐你构建这些项目。
1. Hybrid Search RAG(混合搜索 RAG)
问题:
向量搜索擅长理解语义相似性。但有时确切的词语很重要。搜索特定错误代码、产品 ID、API 名称或技术术语时,关键词搜索可能比纯语义检索效果更好。
你将构建的内容
将 BM25 关键词搜索 与 稠密向量检索 结合起来。
系统使用这两种方法检索文档,并合并结果以产生更好的候选集。
例如:
User Query
    |
    +----> BM25 Search --------+
    |                          |
    +----> Vector Search ------+----> Combined Results
                                      |
                                      v
LLM技术栈
Python · BM25 · Elasticsearch/FAISS · Sentence Transformers
你将学到什么
词汇检索和语义检索如何互补,以及为什么生产搜索系统通常需要不止一种检索策略。
2. Metadata-Filtered RAG(元数据过滤 RAG)
问题
仅靠语义相似性并不总是足够的。
假设用户问:
“2026 年认证服务发生了什么变化?”
你不想搜索知识库中的每个文档。
你希望首先将检索限制到相关的元数据。
你将构建的内容
将语义搜索与以下过滤器结合:
- 日期
- 类别
- 作者
- 部门
- 位置
- 文档类型
User Query
    |
    v
Metadata Filter
    |
    v
Vector Search
    |
    v
Relevant Context
    |
    v
LLM技术栈
Python · PostgreSQL · pgvector · Pydantic · OpenAI
你将学到什么
结构化过滤和语义检索如何协同工作。
3. Reranking RAG(重排序 RAG)
问题
你的向量数据库可能返回 20 个看似相关的块。但相关性不是二元的。有些块比其他块好得多。
你将构建的内容
首先检索一个更大的候选集,然后使用重排序器对这些候选进行评分,只将最强结果发送给 LLM。
Query
  |
  v
Retrieve 50 chunks
  |
  v
Reranker
  |
  v
Top 5 chunks
  |
  v
LLM技术栈
Python · FAISS/pgvector · CrossEncoder/Cohere Rerank · OpenAI
你将学到什么
检索 和 排序 之间的区别,以及为什么提高检索质量并不总是关于更改你的嵌入模型。
4. Contextual Chunking RAG(上下文分块 RAG)
问题
传统的分块会破坏上下文。想象一个文档包含:
认证服务
所有者:平台团队
区域:印度
版本:3.2
而你检索到仅包含以下内容的块:
"版本:3.2"
嵌入几乎没有上下文可供使用。
你将构建的内容
在嵌入之前,将相关的文档级上下文添加到各个块中。
Document
    |
    v
Context Extraction
    |
    v
Context + Chunk
    |
    v
Embedding
    |
    v
Vector Database技术栈
Python · Docling · OpenAI/Claude · pgvector
你将学到什么
为什么分块是检索问题,而非简单的文本处理问题。
5. SQL + Vector RAG(SQL + 向量 RAG)
问题
并非每个问题都适合放入向量数据库。
考虑:
"上个月有多少客户升级到了专业版,这些客户最常见的投诉是什么?"
第一部分需要结构化数据。
第二部分可能需要对支持对话进行语义搜索。
你将构建的内容
结合 SQL 查询与向量检索。
                  User Query
                       |
              +--------+--------+
              |                 |
              v                 v
           SQL Query       Vector Search
              |                 |
              +--------+--------+
                       |
                       v
                    Context
                       |
                       v
LLM技术栈
Python · PostgreSQL · pgvector · SQLAlchemy · LangGraph
你将学到什么
如何决定一个问题应通过结构化查询、语义检索或两者结合来回答。
6. Knowledge Graph + Vector RAG(知识图谱 + 向量 RAG)
问题所在
向量搜索擅长找到相似信息,但相似性不等于关系。
考虑:
"如果支付服务宕机,哪些服务会受到影响?"
答案可能依赖于服务之间的显式关系。
你将构建的内容
将向量搜索与知识图谱结合。
          Vector Search
                  |
                  v
Question ----> Relevant Entities
                  |
                  v
             Knowledge Graph
                  |
                  v
             Relationships
                  |
                  v
LLM技术栈
Python · Neo4j · pgvector · OpenAI · LangGraph
你将学到什么
何时语义相似性足够,以及实体间的显式关系何时提供额外价值。
7. Corrective RAG(修正 RAG)
问题
大多数基础 RAG 管道假设检索有效。它们检索一些文档,并立即将其传递给 LLM。但如果检索到的上下文不相关呢?生产系统需要识别检索失败。
你将构建的内容
在生成最终答案之前评估检索到的上下文。
如果结果不佳,系统可以:
- 重写查询
- 重新检索
- 搜索另一个来源
- 完善上下文
- 或拒绝回答
Query
  |
  v
Retrieve
  |
  v
Evaluate Context
  |
  +---- Good ----> Generate Answer
  |
+---- Poor ----> Rewrite / Retry技术栈
Python · LangGraph · OpenAI · pgvector · Tavily
你将学到什么
如何构建围绕检索的反馈循环,而不是将检索视为保证操作。
8. Self-RAG(自反思 RAG)
问题
LLM 是否应该对每个问题都进行检索?可能不需要。
如果有人问:
"什么是 Python?"
可能没有理由去搜索你的知识库。
但如果他们问:
“我们公司最新的应急响应政策是什么?”
那么检索就变得至关重要。
你将构建的内容
一个能够决定何时需要检索、评估检索到的证据,并验证其答案是否得到充分支持的系统。
       User Query
                     |
                     v
              Need Retrieval?
               /          \
             No            Yes
             |              |
             v              v
          Generate       Retrieve
                           |
                           v
                        Evaluate Evidence
                                |
                                v
Generate Answer技术栈
Python · LangGraph · OpenAI · pgvector
你将学到什么
检索如何成为推理过程中的动态部分,而非强制性的第一步。
9. Multimodal RAG(多模态 RAG)
问题
现实世界中的文档不仅仅是文本。
它们包含:
- 表格
- 图片
- 图表
- 截图
- 示意图
- 扫描页面
将所有内容扁平化为纯文本可能会丢失宝贵的信息。
你将构建的内容
一个能够跨多种模态进行检索和推理的 RAG 系统。
Documents
   |
   +---- Text
   +---- Tables
   +---- Images
   +---- Pages
          |
          v
      Retrieval
          |
          v
   Multimodal LLM
          |
          v
Answer技术栈
Python · Docling · 多模态LLM · 向量数据库 · OpenAI
你将学到什么
当检索流程必须保留的不只是文本时,文档理解将如何变化。
10. Agentic RAG(智能体 RAG)
问题所在
有时一次检索操作是不够的。
一个问题可能需要来自多个来源的信息。
例如:
“将我们当前的架构与两年前使用的架构进行比较,并找出发生变化的服务。”
这可能需要搜索文档、查询结构化数据,并跟踪多个实体之间的关系。
你将构建的内容
一个能够决定以下内容的智能体:
- 查询哪个来源
- 使用哪个工具
- 是否需要另一次检索步骤
- 何时拥有足够的信息
- 如何组合结果
                User Query
                      |
                      v
                    Agent
                 /    |    \
                /     |     \
           Vector    SQL    Search
             |       |        |
             +-------+--------+
                     |
                     v
                  Evidence
                     |
                     v
                   Agent
                     |
                     v
Answer技术栈
Python · LangGraph · OpenAI · 向量数据库 · 搜索API
你将学到什么
RAG 如何从固定流程演变为能够动态选择其检索策略的系统。
The Bigger Picture(更广阔的图景)
这些并非 10 个完全独立的架构。这实际上是最重要的理解点。
你可以将它们组合使用。
生产环境的 RAG 系统最终可能看起来像这样:
                         User Query
                             |
                             v
                      Query Processing
                             |
                             v
                    Metadata Filtering
                             |
                  +----------+----------+
                  |                     |
                  v                     v
             Keyword Search       Vector Search
                  |                     |
                  +----------+----------+
                             |
                             v
                         Reranking
                             |
                             v
                     Contextual Chunks
                             |
                             v
                    Context Evaluation
                             |
                       +-----+-----+
                       |           |
                     Good         Poor
                       |           |
                       v           v
                      LLM     Query Rewrite
                                   |
                                   v
Retrieve根据具体问题,你可能会添加 SQL、知识图谱、多模态检索、外部搜索或智能体编排。
你并不会从:
“我构建了一个 RAG 聊天机器人。”
到
“我构建了生产级 RAG。”
只需简单地换一个向量数据库。你通过学会如何让检索变得:来达到这个水平。
• 准确。
• 上下文相关。
• 过滤。
• 排序。
• 可验证。
• 自适应。
如果你认真对待构建 AI 应用,这些是我会放在我的 RAG 学习路线图中的项目类型。
