
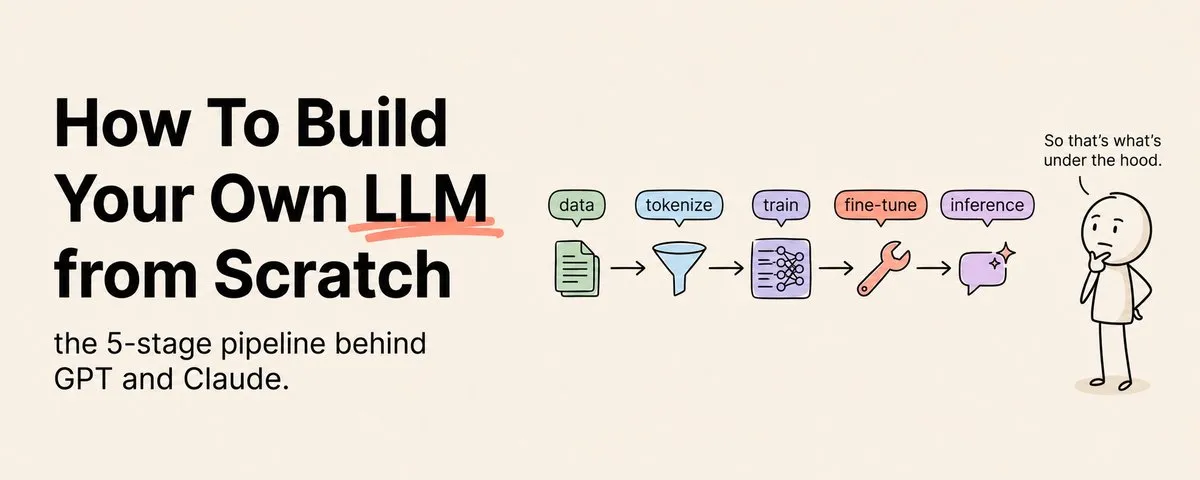
大多数人每天都在使用 ChatGPT 和 Claude,却完全不知道它们究竟是怎么构建出来的。
先收藏这篇 :)
只有一小部分人理解那个精确的流程:它如何把原始互联网文本变成一个能够写作、推理和编程的模型。一旦理解这个流程,你使用这些工具的方式会永久改变,因为你终于能看见底层发生了什么,而不是把它当成魔法。
这两类人的差别,不在于有没有数学学位。
而在于有没有一个清晰的心智模型。
这里有一个几乎没人用简单方式讲清楚的事实:每一个前沿模型,GPT、Claude,所有这些模型,都是通过同一套五阶段流水线构建出来的。不同公司的差异在于规模、数据和无数工程细节,但流程的形状到处都一样。学会这个形状,你就理解了它们都是如何被做出来的。
开始之前,我先诚实地设定预期。你不可能在笔记本电脑上从零训练出一个能和 GPT 或 Claude 媲美的模型。这些模型需要数千万美元级别的算力,也需要庞大的工程团队。但这不是这里的目标。目标是让你足够深入地理解这条流水线,以至于你可以自己构建一个能工作的迷你版本,也能推理大型模型为什么会表现成那样,并且不再对它们感到神秘。这个理解比大多数人意识到的更有价值,而且完全在你触手可及的范围内。
下面就是这五个阶段,按真实发生的顺序排列。
阶段 1:数据,一切构建的基础
在模型出现之前,先有文本。海量文本。
第一阶段是收集并准备模型要学习的数据。对于前沿模型来说,这意味着惊人的文本规模:公共互联网的大量内容、书籍、代码仓库,以及更多来源。但原始文本非常混乱,所以这一阶段的大部分工作并不是收集,而是清洗。
数据会被过滤掉垃圾内容,重复内容会被剔除。同一个段落出现一千次,会扭曲模型学到的东西。低质量或有害材料也会被过滤。这种清洗比很多人以为的更重要。老原则依然成立:垃圾进,垃圾出。一个用更干净、更高质量数据训练的模型,会比一个用更多但更混乱数据训练的模型学得更好。数据质量是整个领域里最重要、也最不耀眼的杠杆之一。
然后是一个会让初学者意外的步骤:分词(tokenization)。模型不能直接读取文本。文本会被切分成 token,也就是大致相当于词的一部分的片段。比如 “tokenization” 这个词可能会变成三四个 token。每一份训练数据都会被转换成这些 token。从那一刻开始,模型看到的永远只是代表 token 的数字,而不是字母。这就是为什么模型有时会数错一个单词里有多少个字母:它从来没有看到过字母,只看到了 token。
这一阶段的产物,是一个巨大、干净、完成分词的数据集。模型还没有学到任何东西。你只是准备好了原材料。
如何学习这个阶段
- 通过把文本输入分词器(tokenizer),并观察它如何切成 token,理解分词器到底做了什么
- 找一个小文本数据集练习清洗:去重、过滤垃圾内容、统一格式
- 通过比较小模型从干净数据和混乱数据中学到的东西,理解为什么数据质量胜过数据数量
- 阅读主要实验室如何描述它们的数据过滤流程,并留意其中投入了多少工作量
阶段 2:预训练,模型真正学习语言的地方
这是会花掉数百万美元的阶段,也是模型学到几乎所有知识的地方。
预训练有一个非常优雅而简单的目标:预测下一个 token。模型会看到一串 token,然后被要求猜下一个 token。它做出猜测,猜测会和真实的下一个 token 对比,模型内部的数字,也就是参数,常常有数十亿个,会被轻微调整,以便下次猜得更好。然后再来一次。再来一次。在数万亿个 token 上反复进行。
这就是完整的训练目标。在巨大的规模上,一遍又一遍地预测下一个 token。而从这个看似荒谬简单的目标里,会涌现出一些非凡能力。为了在人类所有文本上更好地预测下一个 token,模型被迫学习语法、事实、推理模式、代码语法和论证结构,因为所有这些都有助于它预测得更准。没有人显式教它语法。它学会语法,是因为语法能帮助它猜下一个词。
预训练得到的结果叫作基础模型。它是一个强大的语言引擎,但仍然很原始。基础模型不知道自己应该成为一个有帮助的助手。你问它一个问题,它可能只是继续补全你的句子,或者生成一串类似问题,因为它学会的只是以看起来合理的方式续写文本。它拥有大量知识,却没有任何礼貌。它是一件极其强大的工具,但还不知道自己的工作是什么。
理解这一阶段,是整篇文章里最大的解锁点。一旦你理解这些模型的核心是在巨大规模上预测下一个 token,它们的流畅表达和幻觉都会变得合理。它们被构建出来,是为了合理地续写,而不是为了说真话。真相,需要后续阶段和你自己的工程来补上。
如何学习这个阶段
- 把“预测下一个 token”这个目标内化到你能用一句话解释给朋友听
- 在一个小数据集上训练一个迷你语言模型,可以找一些知名的入门教程,亲手感受这个循环
- 理解参数、数据和算力之间的关系,以及为什么同时扩展这三者会改善模型
- 观察这一阶段如何同时解释模型为什么流畅,以及为什么它们会自信地编造内容
阶段 3:监督微调,教模型变得有用
现在,你拿到那个聪明但没有规矩的基础模型,然后教它自己的工作是什么。
基础模型懂语言,但不知道自己应该有帮助地回答问题。监督微调,通常缩写为 SFT,就是用来修复这一点的。你向模型展示成千上万个你想要的行为示例:一个问题配一个好答案,一条指令配一个正确回应,一个问题配一个清晰解法。
模型在这些示例上的训练方式和预训练一样,仍然是预测 token。但这一次,数据是经过整理的示范,明确展示一个有帮助的助手应该如何回应。它学习的是“有用”的格式:当看到一个问题时,生成一个有帮助的答案,而不是继续补全文本或漫无边际地展开。
这些示例的质量极其重要,而且它们通常由人类编写,或经过人类精心整理。这里的数据量远少于预训练,有时是几千或几万条示例,而不是数万亿 token,但它们质量高、有意识设计,并且目标明确。一小批优秀的示范数据,就能把原始基础模型转变成一个表现得像助手的模型。
SFT 之后,你就拥有了一个真正有用的模型。它会遵循指令、回答问题,并保持在任务上。对很多用途来说,这已经是一个可以工作的助手。但它还没有达到你实际使用的模型那种有帮助、无害且精致的程度,而这正是最后两个阶段要解决的问题。
如何学习这个阶段
- 通过阅读基础模型和微调模型的回应示例,理解二者之间的差异
- 构建或研究一个小型指令数据集:用问答对展示你希望模型具备的行为
- 尝试在一个聚焦任务上微调一个小型开放模型,并观察它的行为如何改变
- 留意示范样本的质量相对于数量有多么重要
阶段 4:奖励建模,教模型理解“好”是什么样
这是大多数解释都会跳过的阶段,却是现代模型变得如此精致的巧妙核心。
实验室当时面对的问题是:SFT 之后,模型能给出不错的答案,但“好”很难仅靠示例来定义。对大多数问题来说,并不存在唯一正确答案;只有更好的答案和更差的答案。如果你写不出规则,要怎么教模型偏好更好的答案?
解决方案很优雅。你让模型针对同一个提示词生成几个不同答案。然后让人类查看这些答案并排序:这个比那个更好。你收集大量这种人类偏好比较数据。接着,你不是直接使用这些比较,而是训练第二个模型,叫作奖励模型。它的全部工作,就是查看任意答案,并预测人类会如何评价它。
想想这件事达成了什么。你不可能让人类评价主模型未来生成的每一个答案,这根本无法扩展。但你可以用一批人类判断样本训练一个奖励模型。现在,你就拥有了一个可以自动代表人类偏好的替身,用来给数百万个答案打分。奖励模型连接了“人类喜欢什么”和“计算机可以优化什么”。
奖励模型永远不会直接和用户对话。它是幕后裁判。但它是打开最后阶段的钥匙,因为它提供了一种方法,可以在没有人类团队能匹配的规模上,把主模型推向人类真正偏好的答案。
如何学习这个阶段
- 理解为什么给答案排序,也就是判断“这个比那个更好”,比写出完美答案更容易,也更可扩展
- 抓住核心思想:奖励模型学习模仿人类判断,从而自动给答案评分
- 阅读偏好数据如何通过人类比较收集
- 看清这一阶段如何把人类品味的混乱性,连接到训练流程可以使用的信号上
阶段 5:强化学习,把模型打磨成你实际使用的样子
最后一个阶段会接过前面构建的一切,把模型精炼成你实际交互时看到的那个有帮助、谨慎的助手。
这一阶段通常叫 RLHF,也就是从人类反馈中进行强化学习。各部分是这样拼在一起的:你拿到第 3 阶段的微调模型,以及第 4 阶段的奖励模型。微调模型生成答案。奖励模型给答案打分。然后微调模型通过强化学习被轻微调整,以便生成更高分的答案。这是一个循环:生成、打分、改进、重复。
因为奖励模型可以不断打分,主模型就能练习和改进,远远超出直接人类示例所能提供的范围。经过很多轮之后,它会学得更有帮助、更连贯,更擅长遵循细微要求,也更擅长拒绝不该做的事情。这一阶段给了模型打磨感、良好判断力,以及大量安全行为。
还有一个值得了解的现代变体:一部分人类反馈可以被按照一套书面原则生成的反馈替代或补充,这种方法有时叫 RLAIF 或宪法式方法。精神是一样的:不是完全依赖人类来评价所有内容,而是在清晰陈述的价值观指导下,扩展塑造模型行为的反馈规模。
这一阶段之后,你就有了成品。一个通过预训练获得流畅性、通过微调获得实用性、通过强化学习获得精致感和对齐能力的模型。当你打开 ChatGPT 或 Claude 时,对话的就是这样的模型。五个阶段,每一阶段都建立在上一阶段之上。
如何学习这个阶段
- 理解这个循环:模型生成,奖励模型评分,模型朝着更高分方向改进
- 明白为什么这能让模型练习到远远超出直接人类示例上限的程度
- 阅读从人类反馈中学习和从原则指导的 AI 反馈中学习之间的差异
- 看清最后这一阶段如何产生你作为用户所体验到的帮助性、判断力和安全行为
整条流水线一口气讲清楚
我把它们连起来讲一遍,让它真正固定在脑子里。
你收集并清洗一座山一样的文本,然后把它变成 token。你训练一个模型在所有这些文本上预测下一个 token,而从这个简单目标中,会出现一个理解语言但没有礼貌的基础模型。你用经过整理的示例对它进行微调,让它学会像一个有帮助的助手那样行动。你收集人类对它答案的排序,并训练一个奖励模型来模仿人类判断。最后,你用这个奖励模型通过强化学习来精炼助手,直到它变得精致、有帮助,并且完成对齐。
数据、预训练、微调、奖励建模、强化学习。五个阶段。每一个前沿模型都是这样构建出来的。
关于构建自己的 LLM,真实情况是什么
你不可能在卧室里做出超过前沿实验室的东西,而这也从来不是重点。
重点是理解。一旦这条流水线在你脑子里变得清晰,你就不再只是这些工具的被动用户,而会开始成为一个能推理它们的人。你理解它们为什么会幻觉,因为核心是预测下一个 token。你理解提示词为什么有效,因为你在塑造接下来会被预测的东西。你理解为什么有些模型比其他模型更有对齐感,因为第 4 和第 5 阶段的质量不同。你理解为什么你自己的数据,在你自己的微调实验中如此重要。这种理解,是最有能力的 AI 构建者共同站立的基础。
真正让人有力量的地方在于:为了学习,你可以在小规模上亲手构建每一个阶段的迷你可工作版本。人们一直在训练微型模型、微调小型开放模型,并实验偏好数据。你不会做出 Claude。但你可以做出某个东西,让你准确理解 Claude 是如何被构建出来的,而这种知识会在你这个领域余下的职业生涯中持续复利。
大多数人会使用这些模型很多年,却从来不会理解它们是怎么做出来的。
你刚刚读完了整条流水线。你已经领先了几乎所有每天在这些工具里输入内容的人。
唯一的问题是:你会不会亲手构建一个小版本,把理解变成你真正能做的东西。
五个阶段就在上面。选择第一阶段,然后开始。
如果你觉得这篇有用,欢迎关注我 @eng_khairallah1 ,获取更多类似的 AI 内容。我每周都会发布拆解、课程和工具。
希望这对你有用,Khairallah ❤️
📎 原文信息
原帖链接:https://x.com/eng_khairallah1/status/2073334640123769289
