
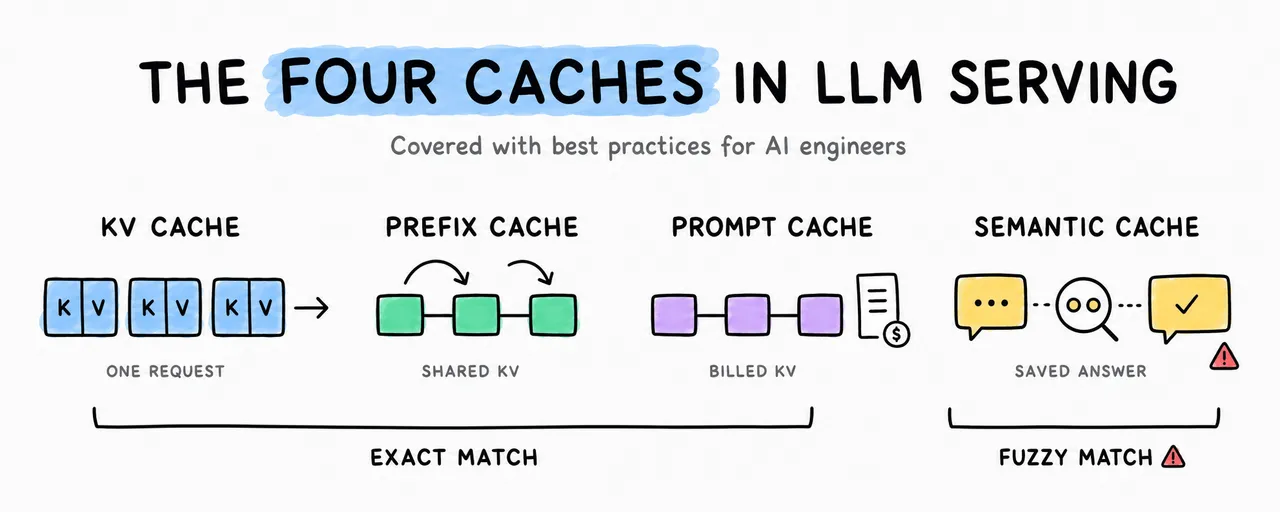
你需要了解的是你的输入 token 在哪里被重新计算,以及如何应对。本文从基本原理出发,覆盖四层缓存及其权衡、它们交互时会发生什么,以及阻碍缓存复用的五个最常见问题。
在 LLM 技术栈中,有四样东西存储着四种不同的对象,而它们都被称为缓存。
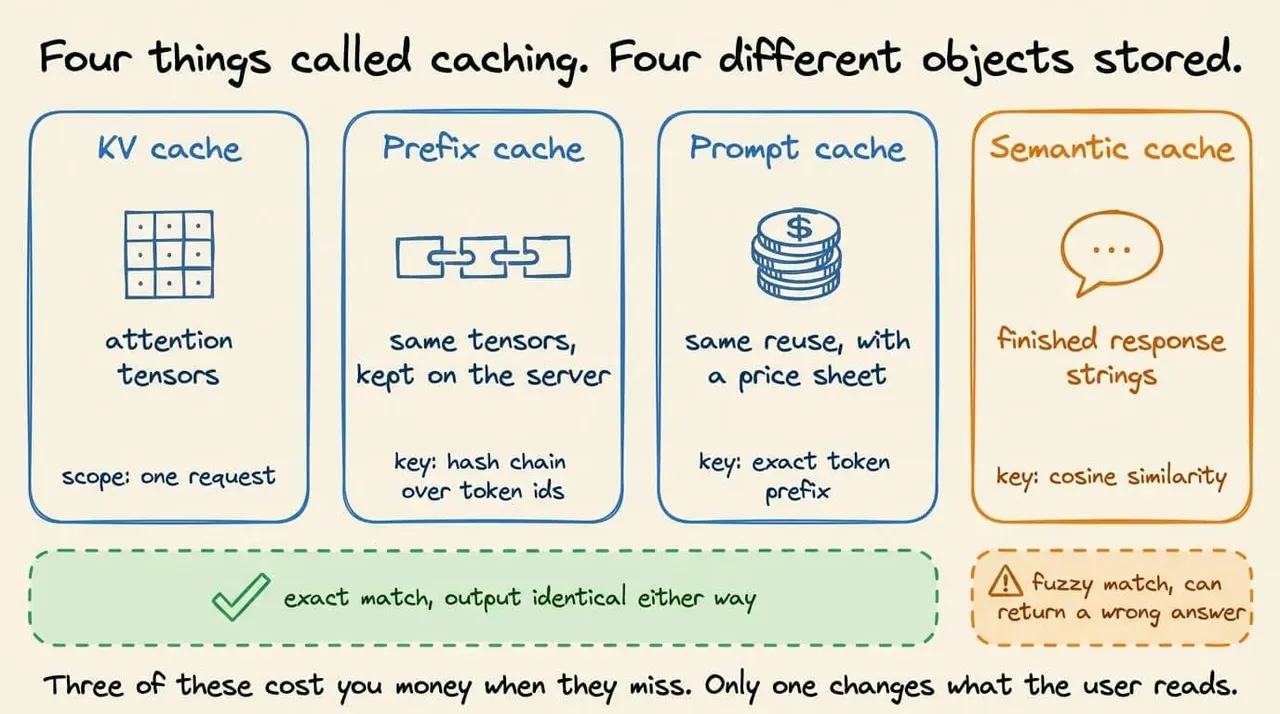
- KV 缓存存储单个请求的注意力张量。
- 前缀缓存将同样的张量存储在服务器端,以 token ID 的哈希链为键。
- 提示词缓存是服务商对该查找的计费版本,读取时按基础输入价格的 0.1 倍计费,而写入时则需支付 1.25 倍的溢价。
- 语义缓存存储完整的响应字符串,以嵌入的余弦相似度为键。
前三者是精确匹配且不影响正确性,因此未命中会带来成本和延迟。第四者是模糊匹配,它可能会返回一个错误答案,并附带 200 状态码。
所以,今天让我们逐一分析这四种缓存,各自存储什么,以及是什么在悄无声息地破坏它们。
这里的一切都在一台机器上运行,包括 CPU,使用 360M 参数的模型。还有一个 Anthropic API 示例和一个小型语义缓存,基于 sentence-transformers 构建。如果某个机制只存在于服务引擎内部,我们将用伪代码解释其逻辑,而不是假装它可以在笔记本上复现。
另外,缓存 API 在 transformers v5 中发生了变化,因此以下代码片段假设你使用的是 v5 或更高版本。在 v4 中,等价的做法是使用不带 config 参数的 DynamicCache (),以及使用 torch_dtype= 而非 dtype=。
pip install "transformers>=5.0" torch

# only for the quantized cache example
pip install optimum-quanto

# only for the semantic cache example
pip install sentence-transformers

# only for the prompt caching example
pip install anthropic1) KV 缓存
在预填充阶段,模型为每个提示词 token 在每个层计算键和值向量,并存储它们。
解码过程随后基于这些存储的向量进行注意力计算,并为每个生成的 token 附加一个新的键值对,而无需在每一步重新计算整个序列。
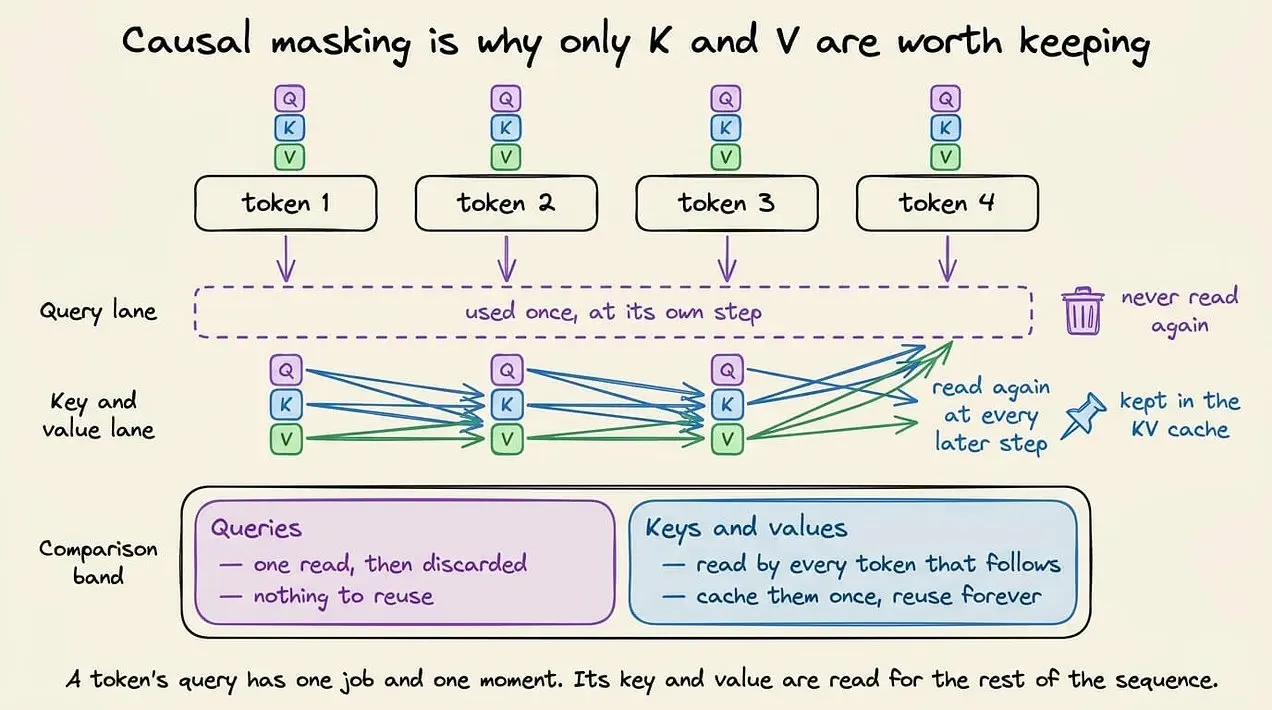
查询向量不会被缓存,原因是因果掩码。一个 token 的查询向量只在该 token 被处理的步骤中使用一次,之后不会再被读取。它的键和值会被其后所有 token 读取,因此这两个向量是最值得保存的。
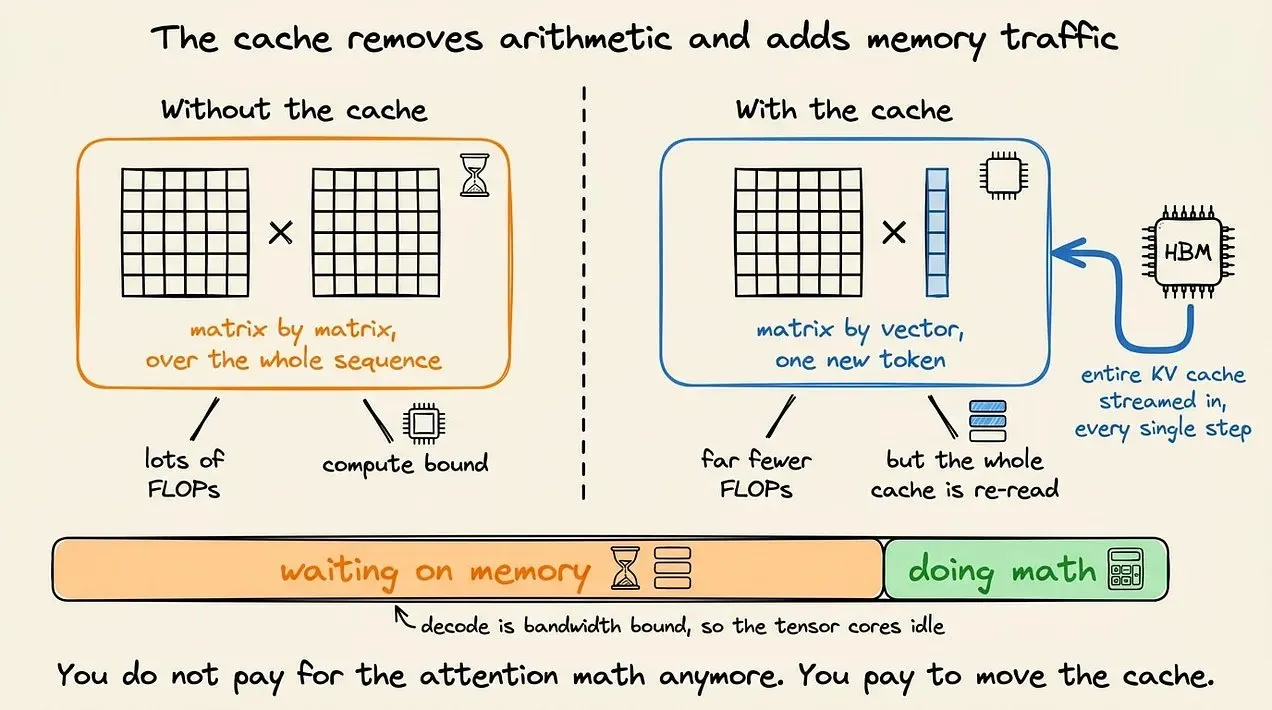
- 如果不存储它们,每个解码步骤都需要对迄今生成的整个序列执行矩阵 - 矩阵乘法。
- 有了缓存,该步骤就变成了对一个新 token 的矩阵 - 向量乘法,这大大减少了 FLOPs(浮点运算次数)。
下面的视频展示了有无 KV 缓存时的 LLM 推理过程:
虽然这减少了每个 token 的计算量,但你必须每一步都从 HBM 中加载整个缓存,因此解码不再是计算密集型,而是变为内存带宽密集型。
注意力内核完成计算的速度比缓存流入的速度还快,GPU 在大部分解码步骤中都在等待内存。
每个 token 带来的 KV 缓存增长
\transformers\ 库将缓存作为一个一级对象暴露出来,因此你可以持有它、检查它,并将其传回。
这里是一个最小化的代码演示:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, DynamicCache

model_id = "HuggingFaceTB/SmolLM2-360M-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id, dtype=torch.bfloat16, device_map="auto"
)

inputs = tokenizer("The capital of France is", return_tensors="pt")
inputs = inputs.to(model.device)

past_key_values = DynamicCache(config=model.config)

out = model.generate(
    **inputs,
    do_sample=False,
    max_new_tokens=20,
    past_key_values=past_key_values,
)

>>> print(tokenizer.decode(out[0], skip_special_tokens=True))
"""The capital of France is Paris. It is the largest city in
France and the second-largest city in the European Union."""

>>> print("prompt tokens: ", inputs["input_ids"].shape[1])
"prompt tokens: 5"

>>> print("total tokens: ", out.shape[1])
"total tokens:  25"

>>> print("cache length: ", past_key_values.get_seq_length())
"cache length: 24"通常,你调用 \generate\ 方法,缓存会在内部创建并销毁,对你不可见。在这里,我们自行构造一个 DynamicCache 并传入,这意味着在生成完成后我们仍然持有对它的引用。
随后,\get_seq_length()\ 报告缓存包含的 token 位置数。当你运行此代码时,输出包含提示词长度加上生成的 token 数,再减去一。
最后一个 token 的键和值会被计算,但不会被任何后续 token 参与注意力计算。
这段代码表明,缓存为每个已见的 token 保存一个条目,并且每个解码步骤恰好增加一个条目。
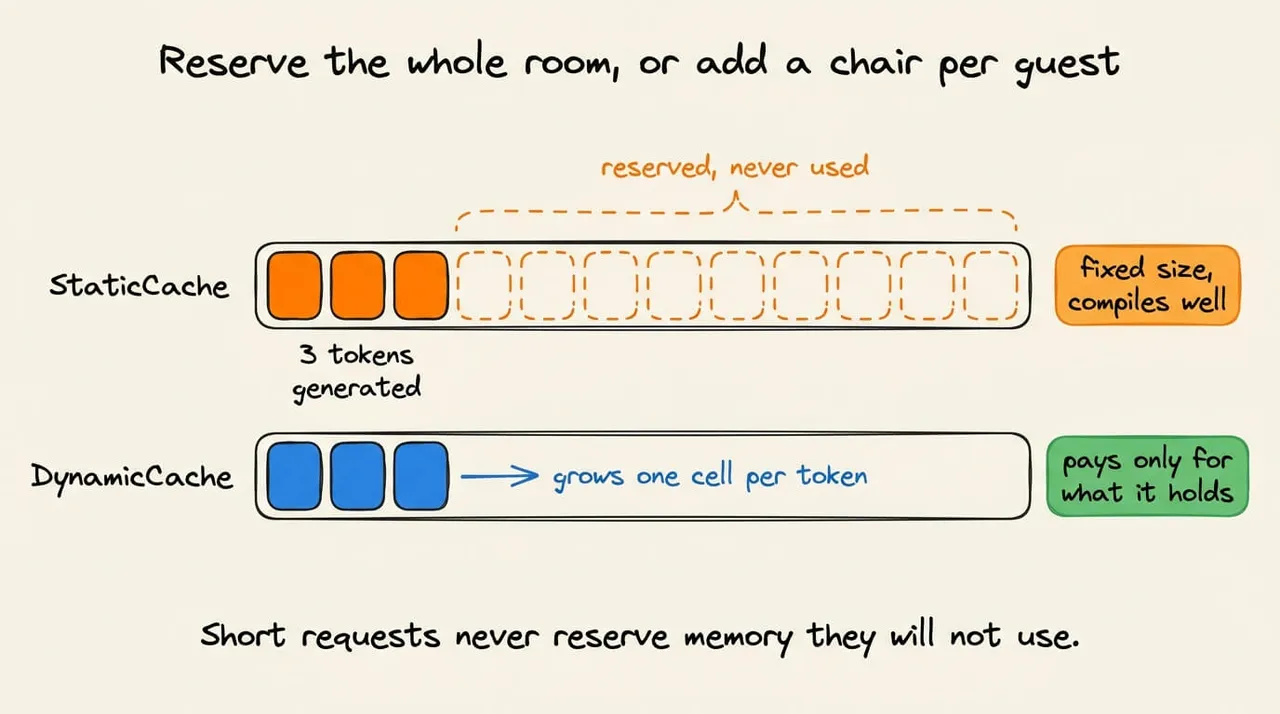
DynamicCache 之所以是默认选择,是因为它会随生成过程增长,而不是预先分配,因此短请求不会预留它们永远不会用到的内存。
缓存决定了 GPU 上能容纳多少个请求。其大小由模型结构决定,并随 token 数量线性增长,因为每层都为每个 KV 头保存一个键和一个值张量。
对于 BF16 精度的 70B 模型,一个 128K 的上下文约需 40 GB 缓存,这几乎相当于整个模型在 4-bit 权重下的大小。
以下是一些缩减方法。例如,分组查询注意力在一组查询头之间共享一个键和值头,从而缩小缓存并提高每字节加载数据的 FLOPs。
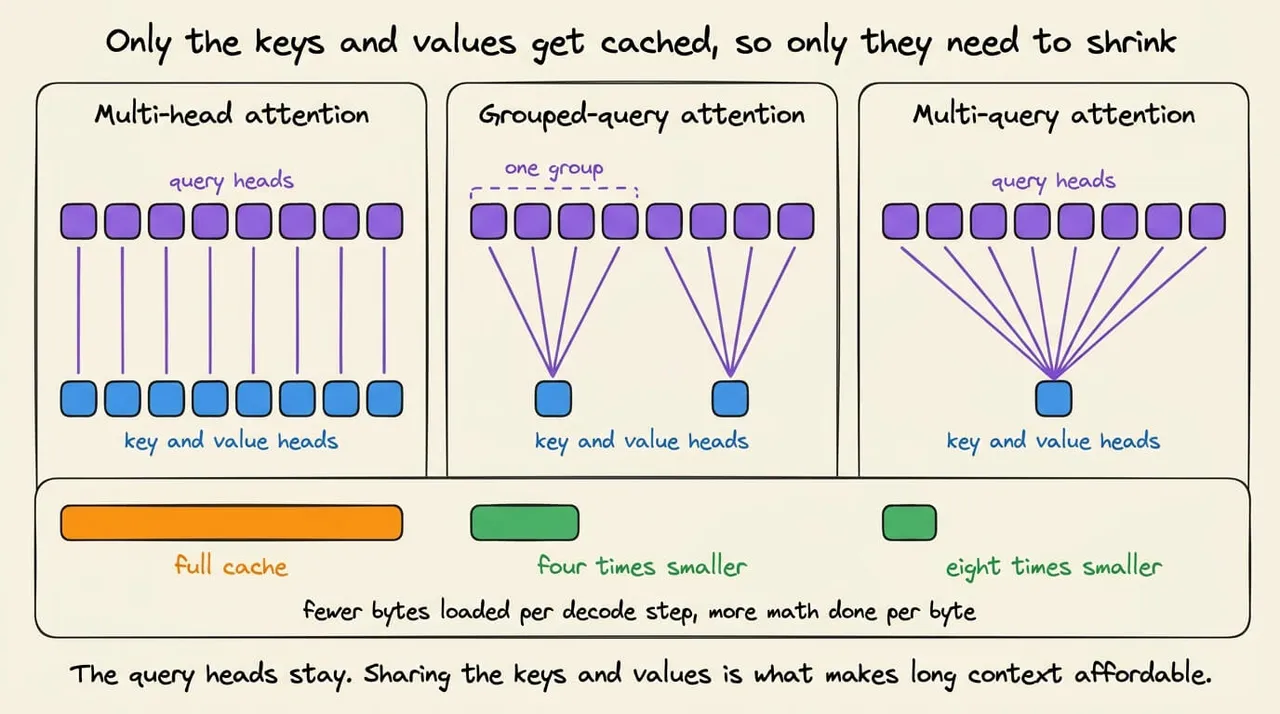
DeepSeek 系列中的多头潜在注意力将整个缓存压缩成一个潜在向量。
缓存量化以牺牲少量数值精度来换取约双倍的容量,transformers 已实现此功能:
# requires: pip install optimum-quanto
out = model.generate(
    **inputs,
    do_sample=False,
    max_new_tokens=20,
    cache_implementation="quantized",
    cache_config={"nbits": 4, "backend": "quanto"},
)
print(tokenizer.decode(out[0], skip_special_tokens=True))两个参数即可将默认缓存替换为量化版本。
KV 值以降低的精度存储,这减少了内存使用,但代价是每次访问都需要进行量化和反量化。
后端还要求组大小能整除模型的头维度,因此不常见的架构可能会直接拒绝该配置。
在短上下文中,这种开销可能会使速度变慢而非变快,因此最好在内存紧张时使用。
缓存随请求结束而释放
上述所有过程都发生在一个调用内。引擎在请求结束时释放这些块,因此一个 20 轮对话在第 20 轮会再次对第 1 轮到第 19 轮进行预填充,并产生全部成本。
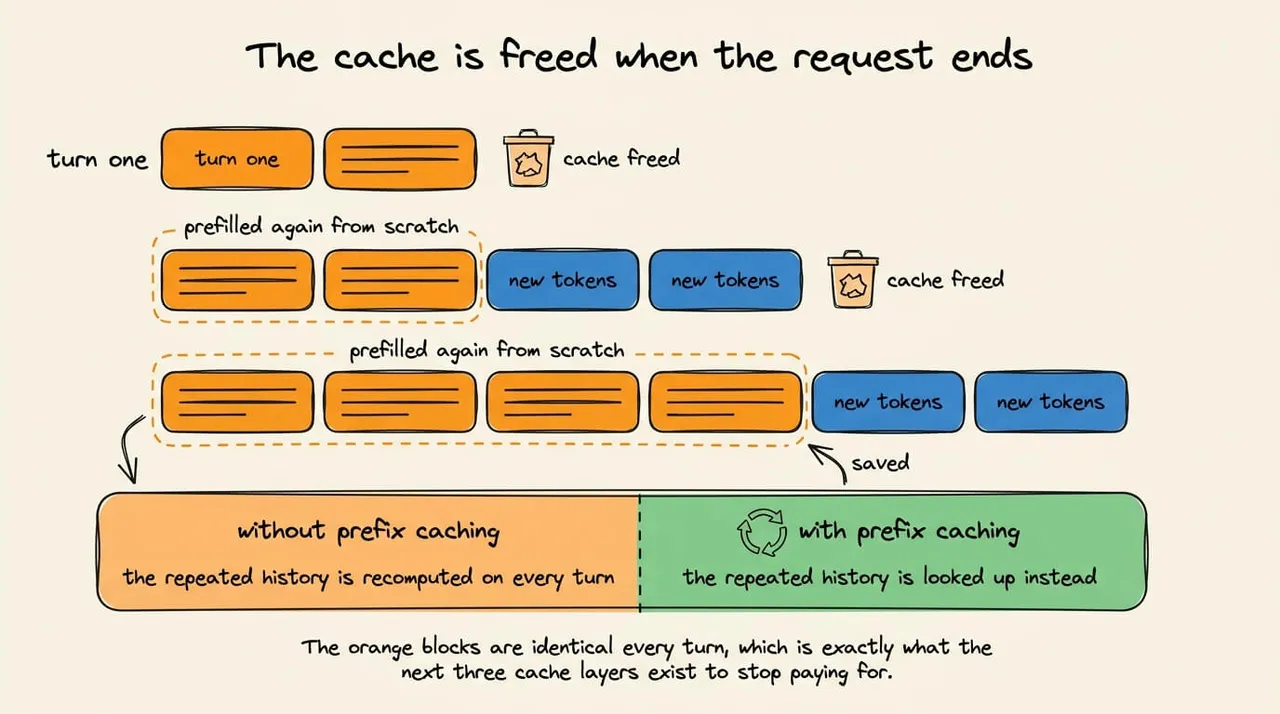
另一种方法是自行在各轮之间保持缓存存活,你可以看到这种替代方案。
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, DynamicCache

model_id = "HuggingFaceTB/SmolLM2-360M-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id, dtype=torch.bfloat16, device_map="auto"
)

past_key_values = DynamicCache(config=model.config)
messages = []

questions = ["What is the capital of France?", "And its population?"]

for prompt in questions:
    # Add to the history
    messages.append({"role": "user", "content": prompt})

   # Tokenize
    inputs = tokenizer.apply_chat_template(
        messages,
        add_generation_prompt=True,
        return_tensors="pt", return_dict=True
    ).to(model.device)

    # Generate
    input_length = inputs["input_ids"].shape[1]
    outputs = model.generate(
         **inputs, do_sample=False,
         max_new_tokens=64,
         past_key_values=past_key_values
    )

    # decode
    completion = tokenizer.decode(outputs[0, input_length:], skip_special_tokens=True)

    # Append to message history
    messages.append({"role": "assistant", "content": completion})
    print(f"turn tokens in: {input_length} | cache now: {past_key_values.get_seq_length()}")

# Output:
"turn tokens in: 42 | cache now: 55"
"turn tokens in: 71 | cache now: 92"- \
past_key_values\对象在循环外创建一次,并在每次生成调用中传入。这样,缓存不会在第一轮结束时被释放,并且在第二轮开始时仍然填充完整。 - 每轮我们重建完整的消息列表,并通过 apply_chat_template 重新渲染。第二轮发送的提示词包含第一轮的所有内容加上新问题。
- 由于缓存已持有第一轮的 token,模型只对新后缀进行预填充。打印的 input_length 每轮增长,而实际的预填充工作并不会增长。
- 完成部分从生成的 ID 中切片,并追加回消息中。这就是使下一轮的提示词成为上一轮严格扩展的原因。
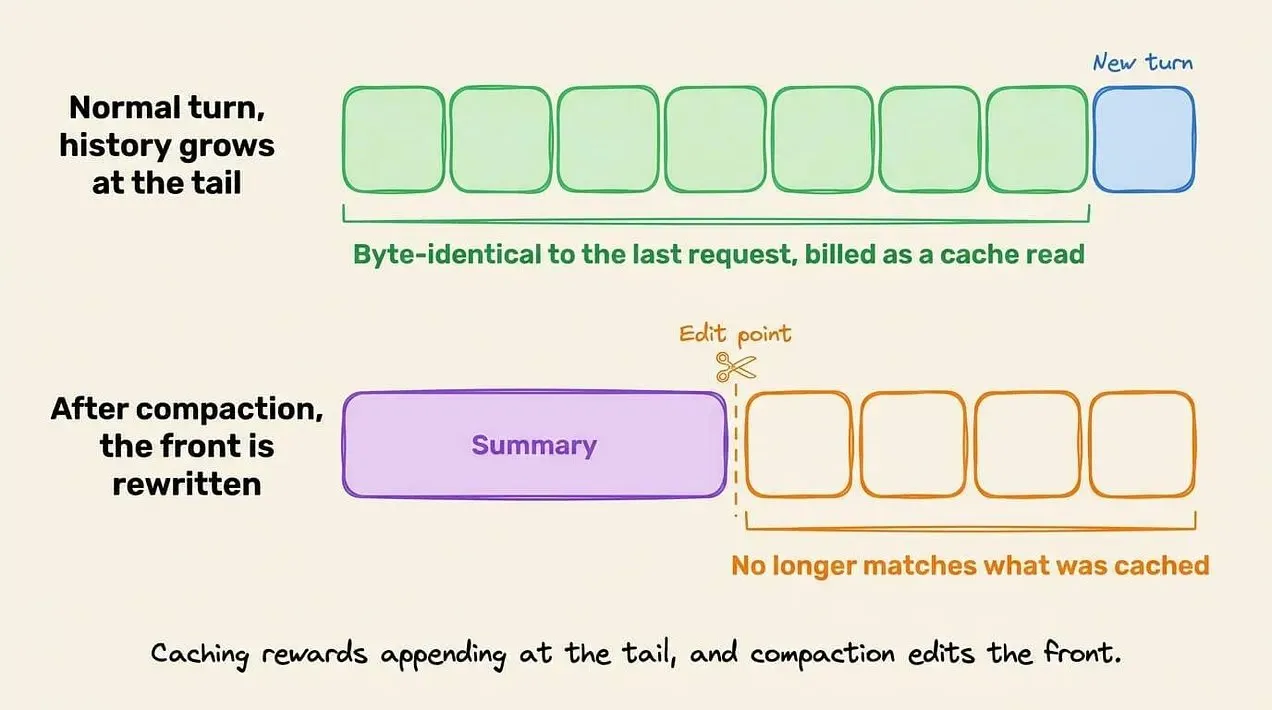
复用之所以有效,是因为第二轮的 token 序列以第一轮的 token 序列开头,完全一致,逐位相同。如果你编辑历史中任何更早的内容,缓存就会失效。
在这个代码演示中,缓存属于一个进程中的一个 Python 变量。在服务引擎中,它属于一个共享池,数千个请求都会查询它。接下来让我们了解这一点。
2) 前缀缓存(Prefix caching)
上述共享池来源于行为上的一个变化。
当请求完成时,引擎将 KV 块保留在内存中而不是释放它们,并保持索引以便后续请求能够找到它们。这就是前缀缓存。
索引必须强制执行与聊天循环中相同的规则,即仅当早期 token 相同时复用才有效。
vLLM 默认存储 16 个 token 的缓存,并通过父块哈希加上块内 token ID 的哈希来识别每个块,从而做到这一点。
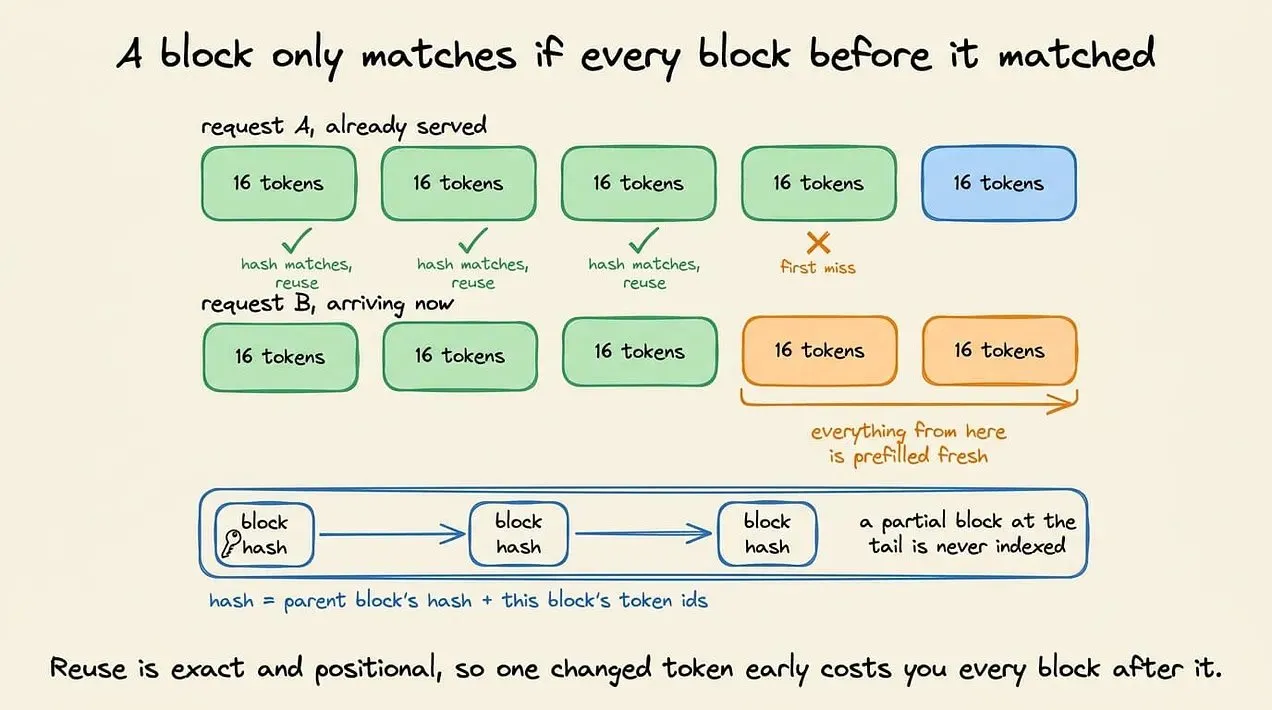
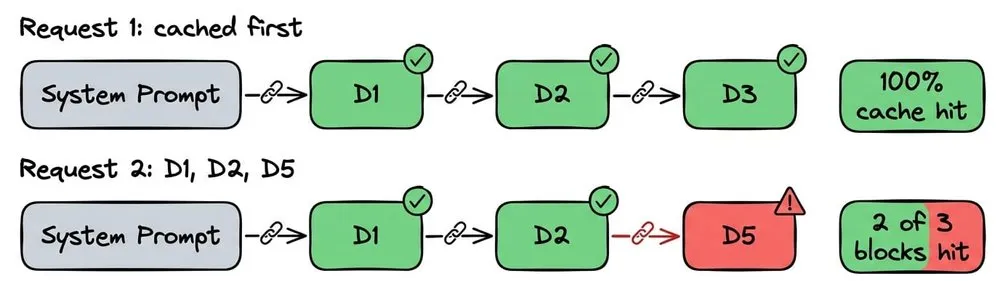
将父哈希链接到子块中,使块查找变成前缀查找,因为只有当块之前的所有内容也匹配时,块才会匹配。
调度器按顺序遍历传入的块,并在第一次未命中时停止。命中会递增该块的引用计数,同时也会在请求使用期间将其固定,防止被驱逐。
从未命中点之后的所有内容都获得新的分配和全新的预填充。
查找代码(The lookup code)
vLLM 在调度器内部运行此过程,并包装在实际张量所属的内存管理中。
下面的代码只保留决定复用的两个部分,即将 token 序列转换为块键的函数,以及遍历这些键以计算可以跳过多少前缀预填充的函数。
BLOCK_SIZE = 16

def block_hashes(token_ids, salt=None):
    """Chain-hash a token sequence into per-block keys."""

    hashes, parent = [], hash(salt)

    # Only complete blocks are hashed. A partial tail block is skipped.
    for start in range(0, len(token_ids) - BLOCK_SIZE + 1, BLOCK_SIZE):
        block = tuple(token_ids[start : start + BLOCK_SIZE])
        parent = hash((parent, block))
        hashes.append(parent)

    return hashes

def schedule(token_ids, cache):

    """Return how many tokens are reusable, and allocate the rest."""

    matched_blocks = 0

    for h in block_hashes(token_ids):
        if h not in cache:
            break                      # first miss ends all reuse
        cache[h].ref_count += 1        # pin it against eviction
        matched_blocks += 1

    reused_tokens = matched_blocks * BLOCK_SIZE
    to_prefill = token_ids[reused_tokens:]

return reused_tokens, to_prefill- \
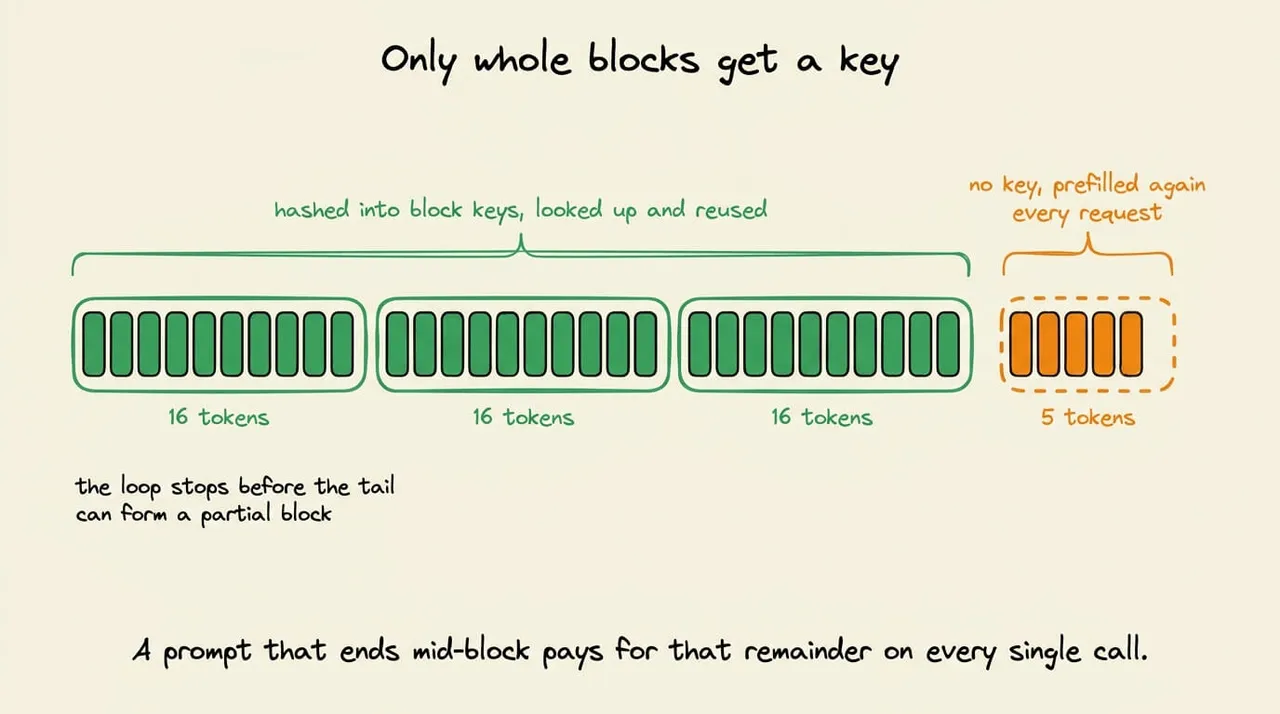
block_hashes\方法将 token 序列切分为固定的 16-token 块。每个块的键通过 hash ((parent, block)) 折叠前一个块的键,因此第五个键编码了第一到第五块,而不仅仅是第五块本身。 - range 在 len (token_ids) - BLOCK_SIZE + 1 处停止,这会丢弃尾部的任何部分块。这些 token 永远不会被索引,并且每次在该位置结束的请求都会重新计算它们。
- \
schedule\方法按顺序遍历键,并在第一个缺失的键处停止。不会尝试在序列后面恢复匹配,因为后面块的键已经依赖于失败的早期块。 - ref_count += 1 将块标记为使用中。驱逐只影响计数为零的块,这可以防止正在运行的请求的缓存被从它下面移除。
- 所有匹配的部分成为 reused_tokens,其后的所有内容都被全新预填充。
在我们刚刚讨论的代码中还有一个重要的事情:
BLOCK_SIZE = 16

def block_hashes(token_ids, salt=None):
    """Chain-hash a token sequence into per-block keys."""

    hashes, parent = [], hash(salt)

    # Only complete blocks are hashed. A partial tail block is skipped.
    for start in range(0, len(token_ids) - BLOCK_SIZE + 1, BLOCK_SIZE):
        block = tuple(token_ids[start : start + BLOCK_SIZE])
        parent = hash((parent, block))
        hashes.append(parent)

return hashes注意上面函数中的 \salt\ 参数。
当两个请求发送相同文本时,它们会产生相同的块键,因此它们最终会指向 GPU 内存中相同的物理 KV 块。这些张量只有一份副本,两个请求都会读取它。
当两个请求来自同一个应用时,这就是你期望的行为。
但当它们来自不同客户时,可能需要做决定。因此,将每个租户的值作为 salt 传递会改变第一个父哈希,这样相同的文本现在为每个租户产生不同的键,它们的请求永远不会落在相同的块上。
这样,每个租户都有自己的一份副本,这消耗内存和命中率,但提供了隔离。
在 transformers 中的实现(Implementation in transformers)
transformers 允许你预填充一个提示词一次,并在多个不同的续写中重用生成的缓存。
import copy
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, StaticCache

model_id = "HuggingFaceTB/SmolLM2-360M-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id, dtype=torch.bfloat16, device_map="auto"
)

SHARED_PREFIX = """You are a careful assistant.
                   Answer in one short sentence."""

prompt_cache = StaticCache(config=model.config, max_cache_len=1024)

prefix_inputs = tokenizer(SHARED_PREFIX, return_tensors="pt")
prefix_inputs = prefix_inputs.to(model.device)

# Prefill the shared prefix exactly once. No token is sampled here.
with torch.no_grad():
    prompt_cache = model(**prefix_inputs, past_key_values=prompt_cache)
    prompt_cache = prompt_cache.past_key_values

questions = ["What is the capital of France?", "Name one ocean."]

for question in questions:
    inputs = tokenizer(SHARED_PREFIX + question, return_tensors="pt")
    inputs = inputs.to(model.device)

    # each request gets its own copy
    past_key_values = copy.deepcopy(prompt_cache)

    outputs = model.generate(
        **inputs, past_key_values=past_key_values, do_sample=False
    )
print(tokenizer.decode(outputs[0], skip_special_tokens=True))- 使用 \
StaticCache\而不是 \DynamicCache\,因为我们需要一个可以复制传递的固定分配。 - model (...) 调用是预填充。这里不采样任何 token。我们纯粹是为了填充缓存而将共享前缀通过模型运行,然后保留返回的 past_key_values。
- 在循环内部,每个问题都连接到相同的前缀上。整个字符串被分词,因此前缀部分的 token ID 每次都相同,这正是引擎哈希链检查的条件。
- copy.deepcopy 为每个请求提供预填充缓存的单独副本。生成会通过追加在缓存内部进行修改,因此如果没有副本,第一个问题会破坏第二个问题的前缀。生产引擎不会复制张量。相反,它共享物理块并跟踪引用计数,这就是使复用几乎免费,而不是与前缀长度成比例的原因。
驱逐对命中率的影响(The impact of eviction on hit rate)
如上所述,只有完整的块才会被索引,因此尾部的部分块每次都会被重新计算。
这意味着块大小应该适当调整
- 更大的块意味着更少的表查找和更好的内存局部性
- 更小的块意味着更细粒度的共享和尾部更少的浪费。
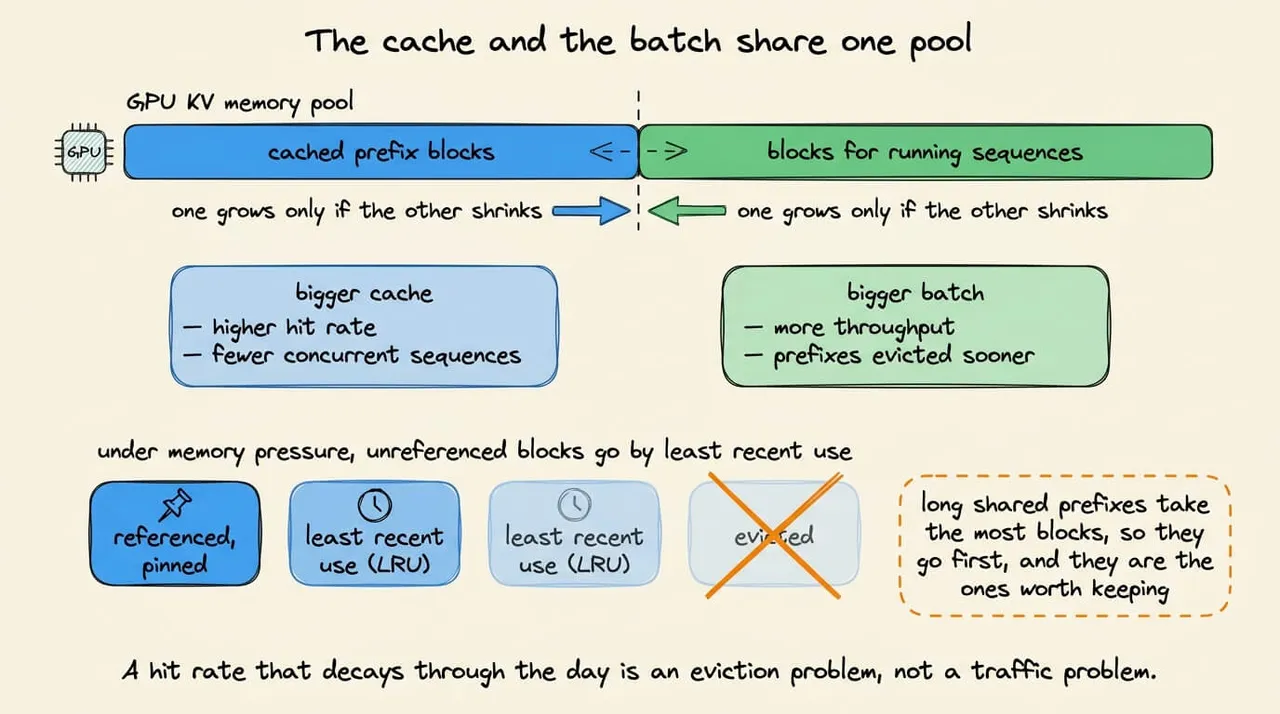
驱逐会降低命中率,这是预期的。
缓存和运行中的批次共享同一 GPU 内存池,因此更大的缓存会导致并发序列减少,而在压力下,vLLM 会按最近最少使用原则丢弃未被引用的块。
混合流量会使这个问题更严重,因为长的共享前缀占用了最多的块,而丢失这些块的影响恰恰最大。
在启用此功能之前,你应该了解两件事
- 它只节省了预填充阶段,因此解码时间不变,将整个加速都归功于缓存会夸大其效果。
- 而且哈希计算本身也有开销,因此在提示词完全不同的流量上,基准测试测得的往往是吞吐量下降而非提升。
还有第三个问题,它与工作负载相关,对 RAG 的影响最大。
RAG 提示词包含系统指令,然后是检索到的分块,最后是查询,而分块会随每次请求变化,并且在请求之间改变顺序。两个检索到相同文档但顺序不同的请求,在链式哈希下完全不共享任何内容。
单独预填充每个分块并将缓存拼接在一起是行不通的。
拼接后的张量带有错误的位置编码。没有任何分块曾关注过其他分块。而且每个分块都在模型认为是位置零的位置贡献了自己的注意力汇聚点。要使其正常工作,需要在边界处进行部分重计算,而不是简单的拼接。
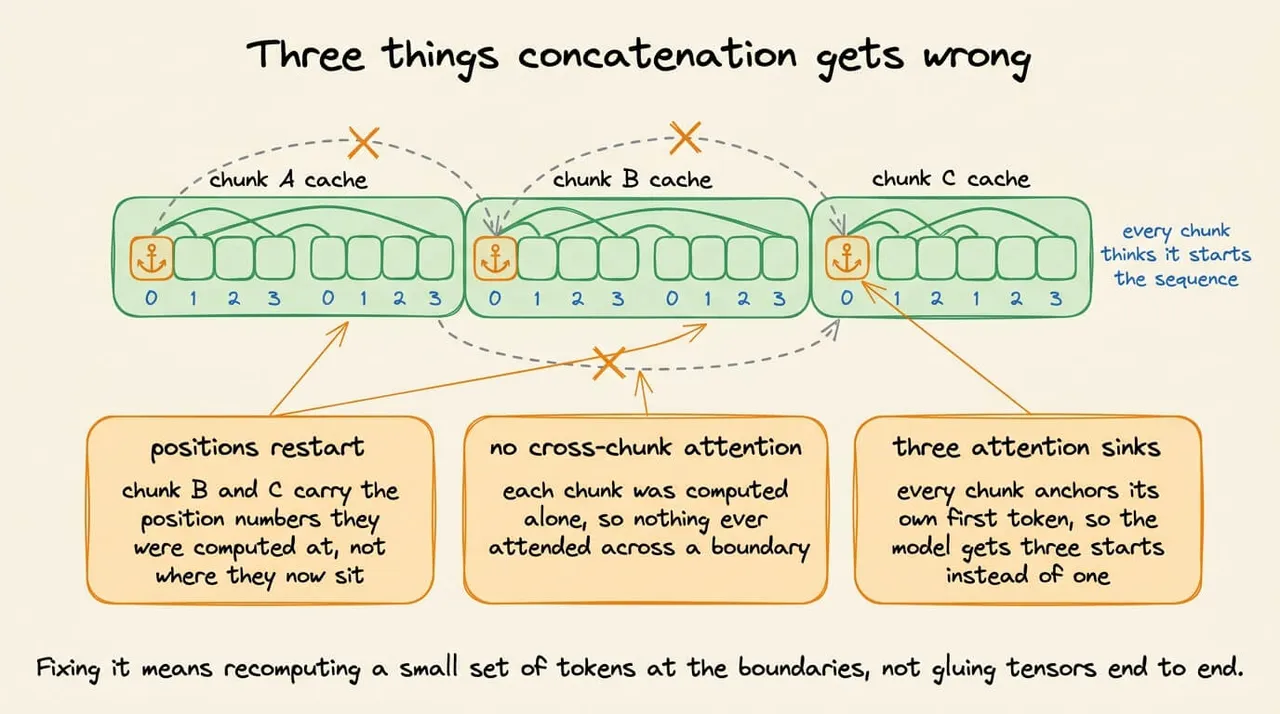
顺便说一句,解决方案已经存在于开源社区中。
LMCache(开源)实现了 CacheBlend,它不是将分块缓存首尾相接,而是在任意位置复用它们,并且只重计算一小部分 token,选择依据是预计算值与完整注意力本应产生的值偏差最大的位置。
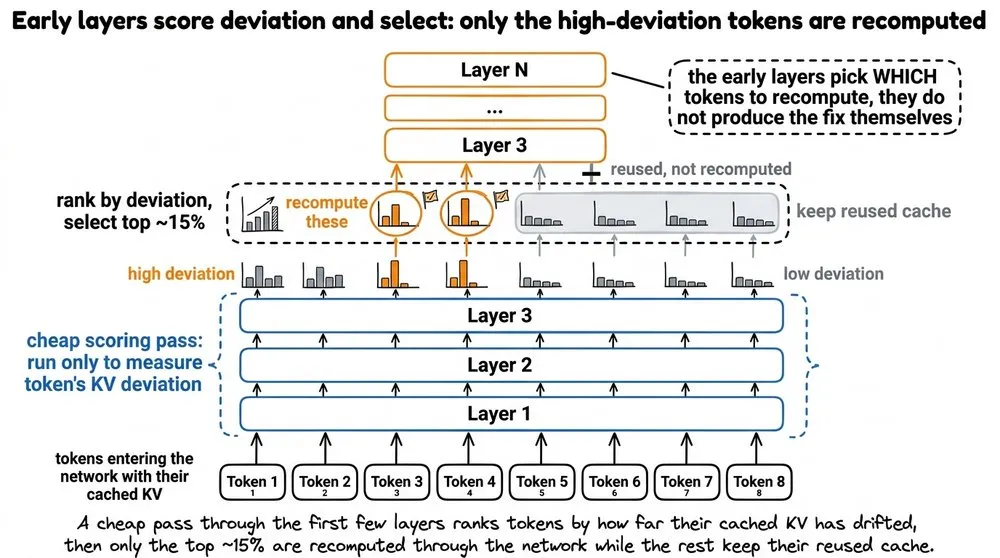
那一小部分恢复了跨分块注意力并修正了位置编码,因此输出保持了全预填充质量。
与重新计算所有内容相比,这使首 token 时间大约缩短了两到三倍,并且重计算成本与从较慢存储中获取缓存分块的操作进行了流水线化。
它可以集成到 vLLM 中,并从你的提示词中读取分块边界,因此即使每次检索到的文档顺序不同,检索流量也能被复用。
仓库地址:https://github.com/LMCache/LMCache
3) Prompt caching(提示词缓存)
在托管模型上,你无法获得块表或驱逐策略。相反,你得到的是基于提供商自身前缀复用的价格表,外加两个控制旋钮。
缓存的对象仍然是 KV 张量,而不是你的提示词文本,并且它仍然要求完全渲染的上下文进行精确前缀匹配。
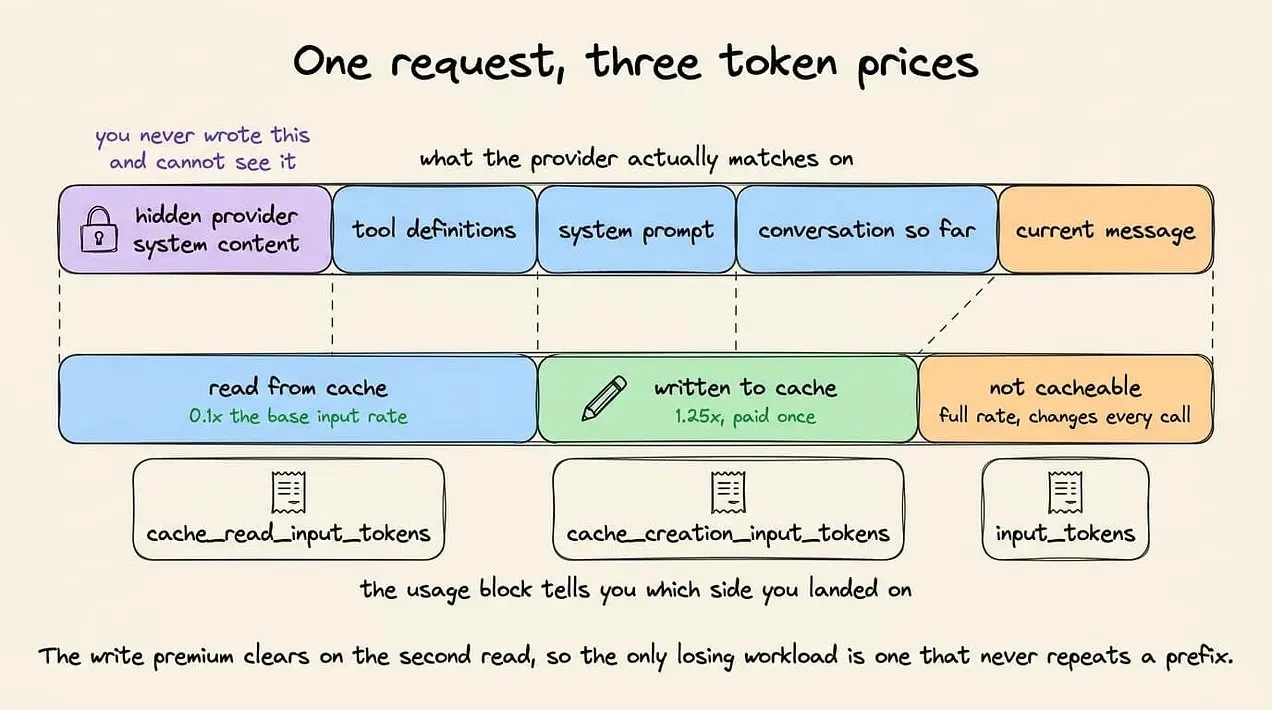
渲染后的上下文包含你从未编写的提供商端系统内容,这也是外部看来最小长度和失效规则显得随意的原因之一。
下面是一个用代码演示的提示词缓存版本:
import anthropic

client = anthropic.Anthropic()   # reads ANTHROPIC_API_KEY from the environment

# Must clear the model's minimum cacheable length or nothing is cached at all.
LONG_INSTRUCTIONS = "You are a precise technical editor. " * 400

def ask(question: str):
    return client.messages.create(
        model="claude-sonnet-4-6",
        max_tokens=512,
        system=[
            {
                "type": "text",
                "text": LONG_INSTRUCTIONS,
                "cache_control": {"type": "ephemeral"},   # everything above is cacheable
            }
        ],
        messages=[{"role": "user", "content": question}],
    )

for question in ["Summarize section 3.", "Now rewrite it for a beginner."]:
    resp = ask(question)
    u = resp.usage
    print(
        f"write={u.cache_creation_input_tokens} "
        f"read={u.cache_read_input_tokens} "
        f"uncached={u.input_tokens}"
    )

# Output:
"write=2823  read=0     uncached=14"
"write=0 read=2823 uncached=17"那段代码中只有一行涉及缓存。
你指定 \cache_control\ 的位置决定了请求的哪一部分会被写入条目,而用量计数器会告诉你后续调用是否读回了该条目。
- 标记附加在你希望覆盖的最后一个块上,而不是一个范围。它会写入一个缓存条目,覆盖从请求开始到该块(含该块)的所有内容。
- 用户消息位于标记下方,因此它保持在缓存区域之外,因为它每次调用都会变化,所以不能位于缓存区域内。
- 用量计数器会告诉你内部发生了什么。第一次调用报告非零的 cache_creation_input_tokens 和零读取。第二次则相反,并且指令按输入费率的十分之一计费。
- 如果两个计数器都返回零,说明前缀低于模型的最小可缓存长度,请求在没有缓存的情况下处理。不会因此引发错误。
直观来说(正如上文讨论的),如果我们将 cache_control 下移到用户消息上,读取计数器将始终为零,因为被标记的块每次调用都会变化。
The economics of prompt caching(提示词缓存的经济性)
Anthropic 对写入条目收取基础输入费率 1.25 倍的费用,读取收取 0.1 倍,如果你希望条目保留更长时间,写入倍率会更高。OpenAI 在其当前模型上也采用相同的两个倍率。
溢价成本会在后续请求中收回,因为在 TTL 内被复用的任何内容都将避免重新计算。
读取只能找到先前某个请求写入的条目,而写入只会在你放置的断点处发生。
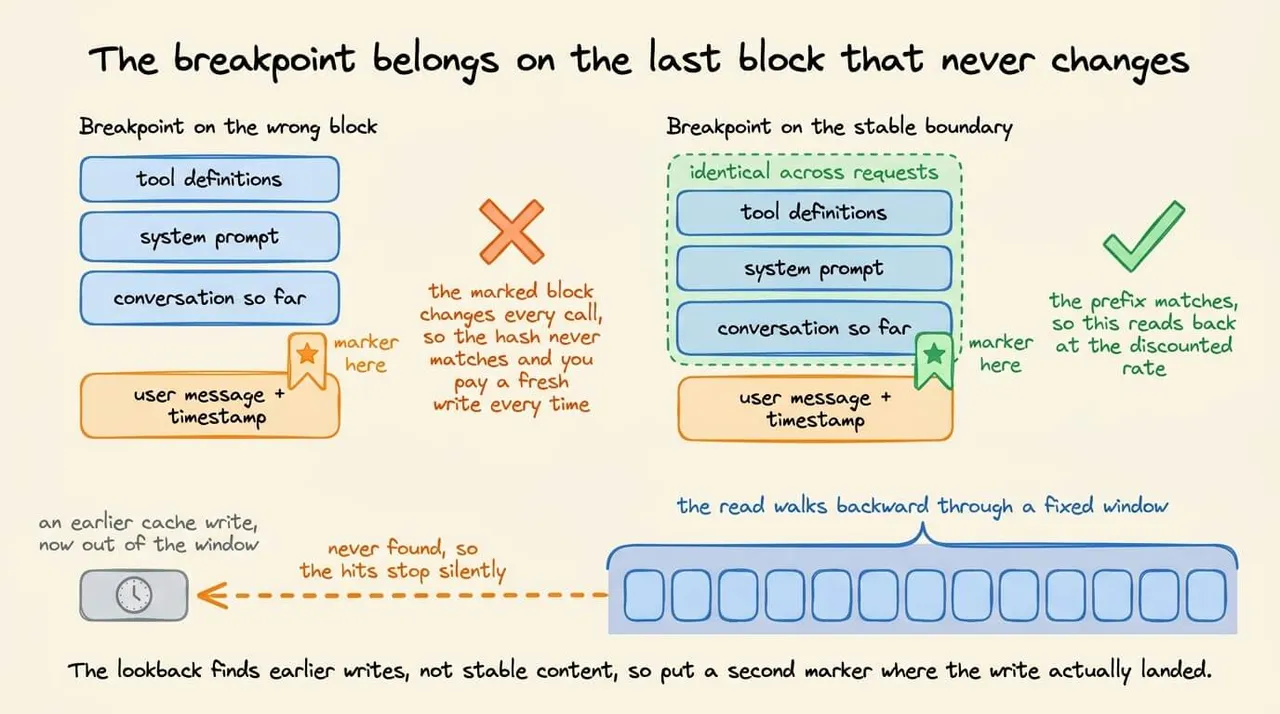
每次调用都会检查你的断点,如果未命中,它会向后遍历有限数量的块,寻找更早的写入。
Anthropic 将其限制为 20 个块,因此在两次调用之间增加超过 20 个块的对话会使最后一次写入超出范围,命中停止。
4) Semantic caching(语义缓存)
上述三种技术节省了预填充工作,但仍然运行模型。
语义缓存会嵌入传入的提示词,对存储的提示词执行最近邻搜索,当相似度超过阈值时直接返回存储的响应。
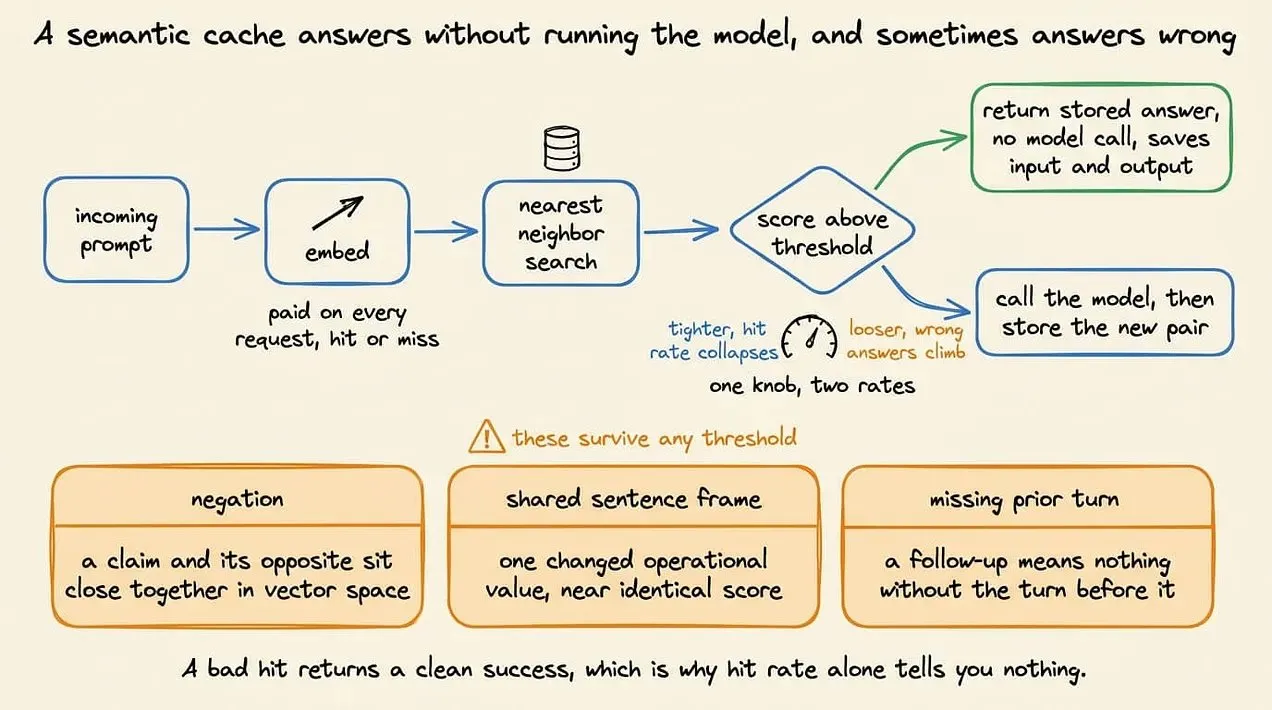
这就是它既节省输出 token 又节省输入 token 的原因。这也是为什么每次请求都必须进行嵌入往返,包括每次未命中。
这里是一个用几行代码实现的可运行语义缓存演示:
# requires: pip install sentence-transformers
import numpy as np
from sentence_transformers import SentenceTransformer

encoder = SentenceTransformer("all-MiniLM-L6-v2")

class SemanticCache:
    def __init__(self, threshold=0.95):
        self.threshold = threshold
        self.vectors = np.empty((0, encoder.get_sentence_embedding_dimension()))
        self.prompts, self.responses = [], []

    def _embed(self, text):
        return encoder.encode([text], normalize_embeddings=True)[0]

    def lookup(self, prompt):
        vec = self._embed(prompt)
        if len(self.prompts) == 0:
            return None, 0.0, vec
        scores = self.vectors @ vec           # cosine sim, vectors are unit length
        best = int(np.argmax(scores))
        if scores[best] >= self.threshold:
            return self.responses[best], float(scores[best]), vec
        return None, float(scores[best]), vec

    def store(self, prompt, response, vec):
        self.vectors = np.vstack([self.vectors, vec])
        self.prompts.append(prompt)
        self.responses.append(response)

cache = SemanticCache(threshold=0.95)

def answer(prompt, call_model):
    hit, score, vec = cache.lookup(prompt)
    if hit is not None:
        return hit, f"HIT  (score {score:.3f})"
    response = call_model(prompt)             # the expensive path
    cache.store(prompt, response, vec)
    return response, f"MISS (best {score:.3f})"

# Stand in for the model so this runs without an API key.
fake_model = lambda p: f""

for q in ["How do I reset my password?",
          "How can I reset my password?",
          "Is the API rate limited?"]:
    _, status = answer(q, fake_model)
    print(f"{status}  {q}")


# Output:
"MISS (best 0.000)  How do I reset my password?"
"HIT  (score 0.961)  How can I reset my password?"
"MISS (best 0.112) Is the API rate limited?"上述类中的每个方法都对应你在生产中必须做出的一个决策:
- normalize_embeddings=True 使每个向量为单位长度,这让 self.vectors @ vec 可以作为普通点积计算余弦相似度。如果跳过归一化,则无法在不同长度的提示词之间比较分数。
- 查找操作会在返回结果的同时返回嵌入向量,因此答案可以稍后存储它,无需重新嵌入。这一点很重要,因为嵌入在每次请求时都要付费,无论命中还是未命中,计算两次会使缓存本身的固定成本翻倍。
- 暴力 argmax 适合演示,但在规模化时是错误的。一旦超过几千个条目,这就变成了近似最近邻索引,这会在阈值之上引入其自身的召回率设置。
- store 仅在未命中路径上被调用,即模型回答之后。在答案成为每个未来高于阈值提示词的响应之前,没有任何验证。这凸显了该技术的最大风险。缓存不知道存储的响应是否正确,只知道新提示词是否与旧提示词相似。
下面的代码展示了最后一点:
pairs = [
    ("How do I reset my password?", "How can I reset my password?"),
    ("Is the API rate limited?",     "Is the API not rate limited?"),
    ("Refund policy for annual plans", "Refund policy for monthly plans"),
]

for a, b in pairs:
    va, vb = encoder.encode([a, b], normalize_embeddings=True)
print(f"{float(va @ vb):.3f} {a!r} vs {b!r}")这是我们得到的输出:
0.961   'How do I reset my password?'  vs  'How can I reset my password?'
0.952   'Is the API rate limited?'  vs  'Is the API not rate limited?'
0.887 'Refund policy for annual plans' vs 'Refund policy for monthly plans'- 第一对是真正的同义改写,应该共享一个答案。
- 第二对相差一个否定词,需要相反的答案。
- 第三对相差一个操作值,需要不同的答案。
尽管存在一些不匹配,这三对的分数非常接近。同义改写和否定句之间的差距不到百分之一分,这太薄了,无法在真实流量中保持稳定。
- 如果提高阈值,命中率会下降,而您仍需为每次调用的嵌入付费。
- 如果降低阈值,命中率会上升,同时自信地给出错误答案的比例也会上升。
- 公开的默认值根据来源不同从 0.75 到 0.97 不等,这告诉您这是您流量自身的属性,而不是可以照搬的值。
这本质上并非完全可靠的技术,因为某些失败(如上所示)可以绕过任何阈值,因为它们源于嵌入所表示的内容。
Recap of all four techniques(四种技术回顾)
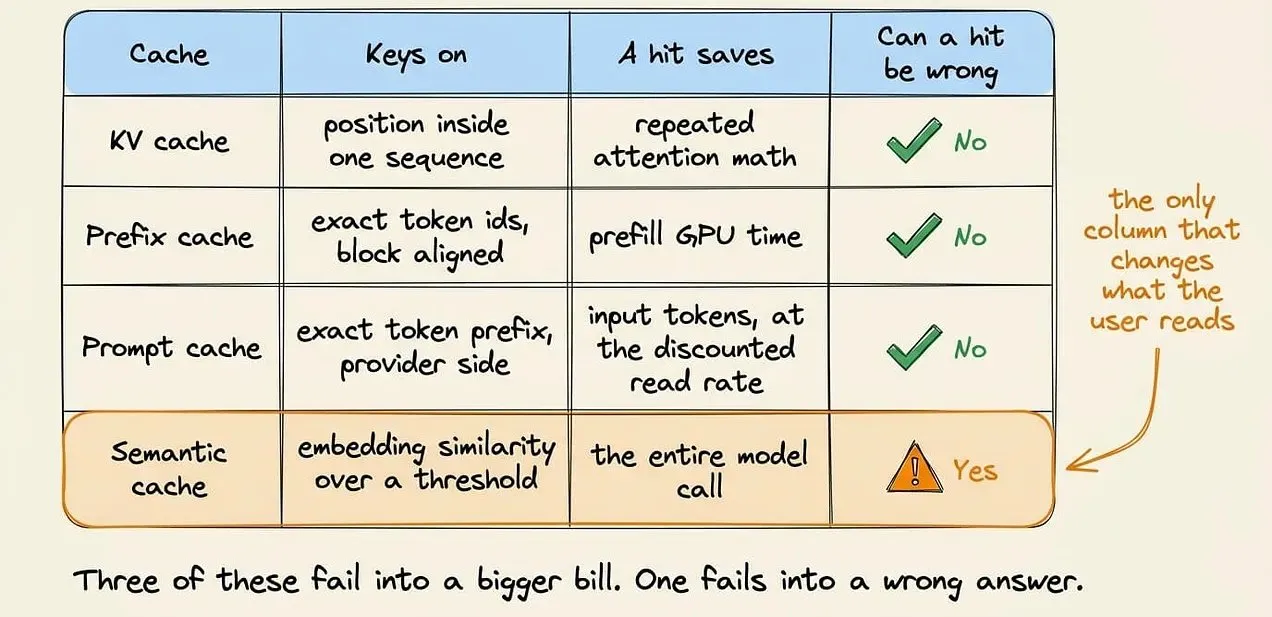
上述四种技术中有三种是对正确性中立的,因此它们的未命中只体现在成本和延迟上,而不会影响其他方面。
语义缓存的工作方式不同,因此在这里报告命中率并不是正确的指标。
还有第五层较少使用的层。它是精确匹配响应缓存,当请求字节完全相同时返回存储的答案。它像语义缓存一样节省输入和输出,并且没有误报风险,因为它完全不进行相似性匹配。您只需在考虑嵌入之前测量字节完全相同的重复率。当然,也存在一些问题,您可能现在已经能想到。请在回复中提出。
Takeaways for production(生产环境要点)
每种技术都有一些失败点,在生产中使用它们之前您应该注意:
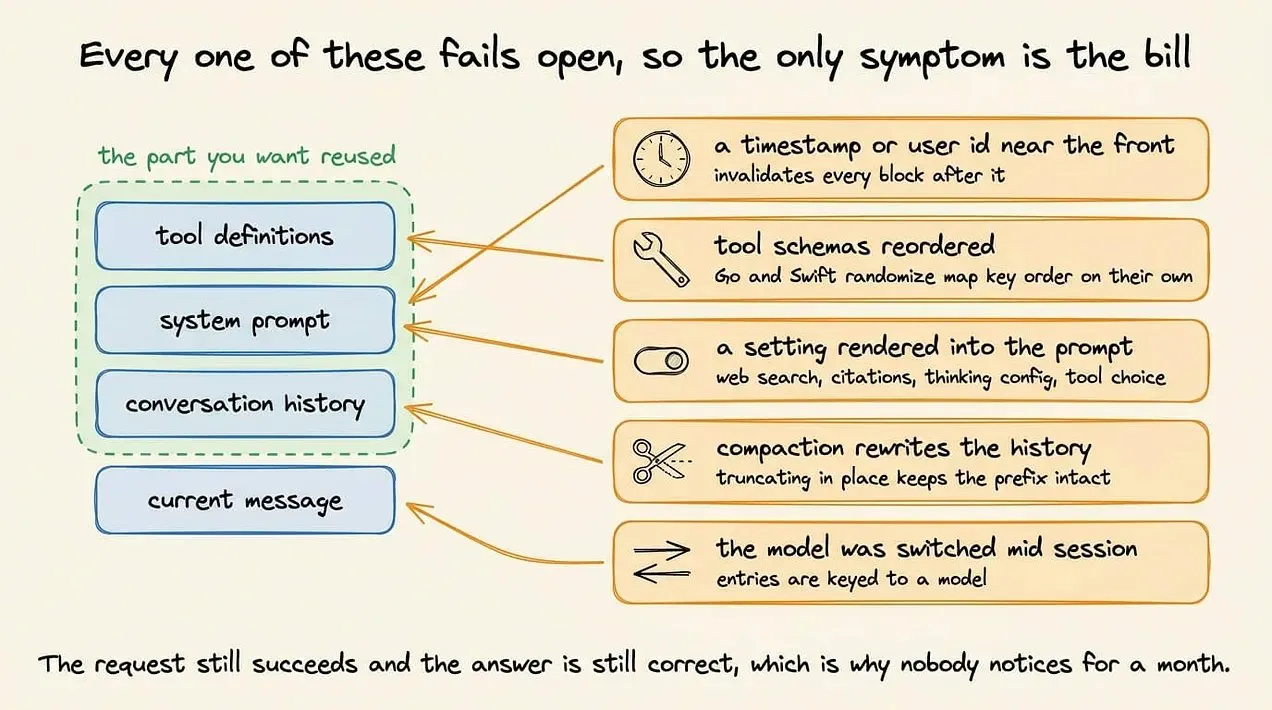
- 如果提示词开头有任何变量,比如系统提示词中的时间戳、请求 ID 或用户名,这会使它之后的所有块失效。始终将稳定内容放在前面,变量内容放在最后,并在边界处添加标记。
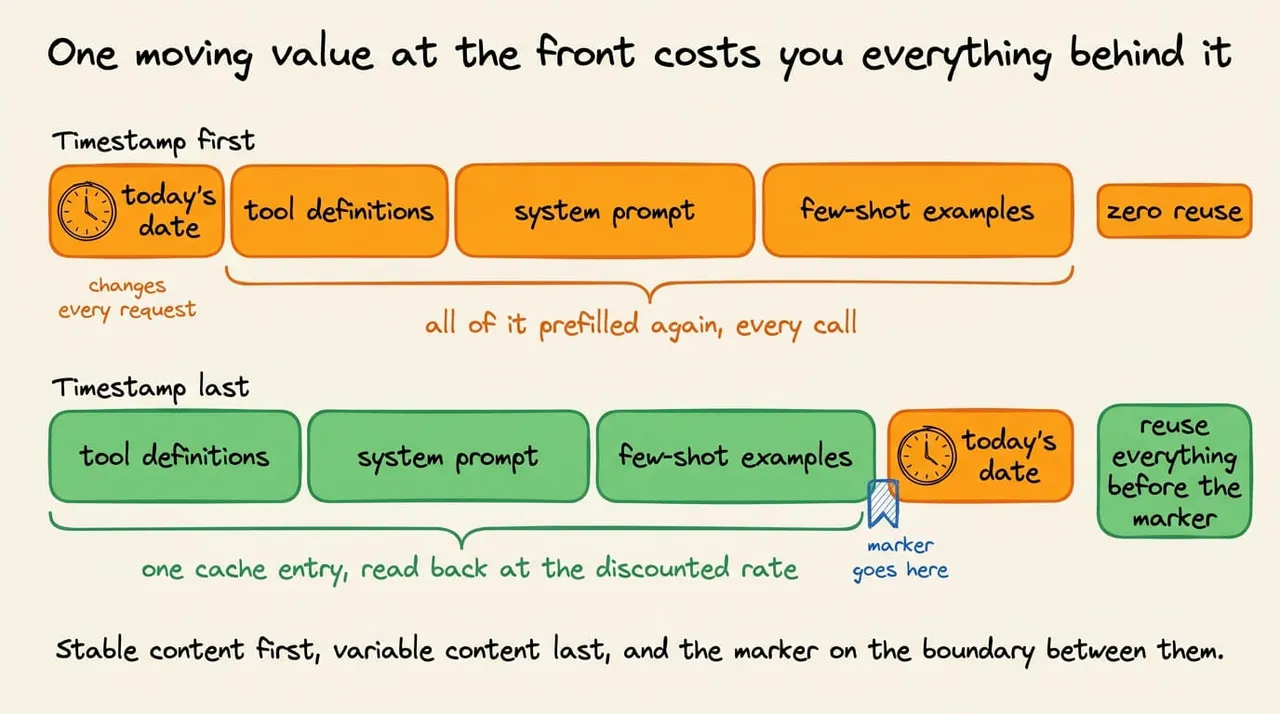
- 工具模式通常放在系统提示词之前,因此重新排序会使整个缓存失效。
- 检查渲染到提示词中的设置。在 Anthropic 上,切换网页搜索、引用、思考配置或 tool_choice 会重写提示词文本并使下游块失效。对两种推理力度进行 A/B 测试会将您的缓存一分为二。
- 总结历史会重写前缀,因此下一次调用将按冷 token 全价支付。就地截断工具输出可保持前缀字节相同,使缓存保持有效。
- 缓存条目与模型关联,因此路由到更便宜的模型仍会以冷费率预填充整个累积历史。
要准确确定两个提示词在哪里停止匹配,请直接比较它们的 token ID,而不是比较您记录的文本。以下是一个演示:
messages_turn_1 = [{"role": "user", "content": "What is the capital of France?"}]
messages_turn_2 = [{"role": "system", "content": "Today is Tuesday."},
                   {"role": "user", "content": "What is the capital of France?"}]

# tokenize=True is the default and returns a plain list of token ids
a = tokenizer.apply_chat_template(messages_turn_1)
b = tokenizer.apply_chat_template(messages_turn_2)

shared = 0
for x, y in zip(a, b):
    if x != y:
        break
    shared += 1

print(f"shared prefix: {shared} tokens of {len(a)} and {len(b)}")
print(f"first divergence at index {shared}: {a[shared:shared+8]} vs {b[shared:shared+8]}")

# Output:
"""
shared prefix: 3 tokens of 35 and 26
diverges at index 3
  turn 1: [2683, 418, 253, 11173, 9042, 14260] You are a helpful AI assistant
  turn 2: [11814, 314, 27758, 30, 2, 198] Today is Tuesday.<|im_end|>
"""在您的日志中看起来相同的两个提示词可能因序列开始(BOS)token、末尾换行符或重新序列化的工具模式而不同。
比较 token ID 而不是渲染文本,可以找到复用停止的精确索引,而解码两侧的几个 ID 通常可以找到确切的文本。
上面的运行展示了一个常见的情况。
Turn one 指定了无系统消息,因此聊天模板填充了模型的默认值,两个提示词在索引 3 处看起来不同,因此无法复用。
前三层覆盖一个想法,在三个范围内应用。
- KV 缓存仅在单个请求期间保持注意力状态。
- 前缀缓存在请求结束后保持该状态,以便后续请求可以查找它。
- 提示词缓存是提供商在自己的硬件上运行前缀缓存,并对您复用的部分收取单独费率。
语义缓存的工作方式不同。它存储以嵌入相似性为键的响应文本,因此如果命中,它会完全跳过模型,并节省输出 token 以及输入 token。命中也可能是错误的,并且在错误时会以正常的成功状态返回。
轮到您了:这四层中哪一层让您花费最多的调试时间?
