
每天挑选一期硅谷 AI 科技值得关注的播客,让你与前沿同频。如果你现在没空可以收藏进 ,在通勤、走路或做家务时一篇篇轻松听完
“拿到答案,不等于你真正懂了。”
“跳过一个 AI 工具没关系,放弃下一次练习不行。”
“AI 不能改变一个人,只有人能改变 AI。”
Tom Yeh 是科罗拉多大学博尔德分校计算机科学副教授,也是 AI by Hand 的发起人。他研究 AI,却坚持用纸笔拆解 Transformer、注意力机制和矩阵运算。这个看起来有些逆潮流的方法,来自他自己的一段弯路:读书时错过深度学习,成为教授后才从头补课,他真正把数学弄明白的时刻,往往发生在把公式一笔一画写到纸上之后。在他的演示里,每一步矩阵变换都有可见的输入和输出,手算的速度虽然慢,却让原本藏在代码和接口后面的假设逐一露出来。
当 AI 能立刻给出答案,我们还该怎样学习?Tom 并不反对使用工具,他只是把注意力放在更长的时间尺度上:工具更新越来越快,一个人究竟靠什么跟上下一轮变化。
答案来得太快,最容易骗过自己
AI 把“得到答案”的成本压得很低。复制一道题、生成一段代码、让模型解释一个概念,几秒钟就够了。问题在于,眼前出现一份正确结果,很容易让人误以为知识已经进入自己脑中;模型把解释写得越完整、越顺滑,我们也越容易把“我看懂了”错当成“我会用了”,真正碰到没有标准提示的新题,这层熟悉感很快就会散掉。Tom 把学习区分得很清楚:证书、学位和答案都属于外部凭证,真正的掌握发生在你能独立调用这个概念,换个场景仍然知道它为什么成立。
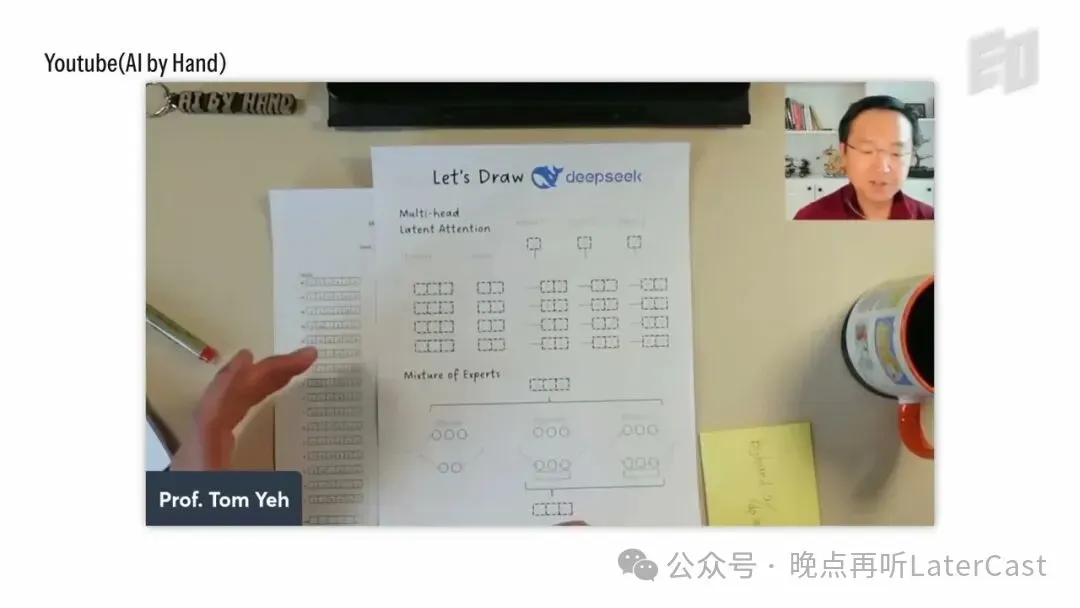
Tom 用纸笔拆解 DeepSeek 的多头潜在注意力与混合专家结构,把模型从黑箱变成可逐步检查的计算过程。
“AI 可以马上给我答案,但拿到答案并不表示我知道了。”
判断自己是否学会,不能看模型写得多漂亮,要看关掉模型之后还剩下什么。 如果你能把推理过程讲给别人听,也能发现答案里的漏洞,并在条件变化后重新做一遍,这个知识才算真正留下来;只要这些步骤仍然完全依赖 AI,得到的就只是一份暂时可用的答案。
一学期不用电脑,他看见了“慢”的价值
Tom 教 C++ 入门时,学生常说课程推进太快。他原本想在有限时间里多讲一点,幻灯片和现场编程却让知识不断从屏幕上滑过去。后来他做了一个很笨的决定:整整一学期不用现场编程,只在黑板上写代码。课堂速度立刻被手写速度锁住,他写到哪里,学生就跟到哪里,没有人能快进;讲者无法一键翻到下一页,学生也不必在上一行还没想明白时追赶新内容,两边终于回到同一条时间线上。
“我只能以人类写字的速度讲,学生也只能以人类能够跟上的速度学。”
手写还顺带解决了注意力问题:学生的手忙着抄笔记,也就很难同时在键盘上刷 Instagram。 这里的“慢”是一种物理限制,它迫使课堂给理解留出停顿。 当教学工具越来越擅长压缩时间,主动保留这点停顿,反而更容易看清自己究竟卡在哪里。
知识要变成自己的,得付出一点时间
Tom 用“所有权”来描述学习结果。一个概念经过搜索就能找到,和你能把它拆开、重组,再用来解决新问题,是两回事。前者属于信息访问,后者才是能力;就像拿到毕业证不代表所有课程都已成为自己的知识,AI 给出的正确答案也只是一次外部调用。纸笔的意义就在这里:每个符号都要经过手和脑,哪里没懂会直接暴露,无法靠顺滑的生成结果蒙混过去。
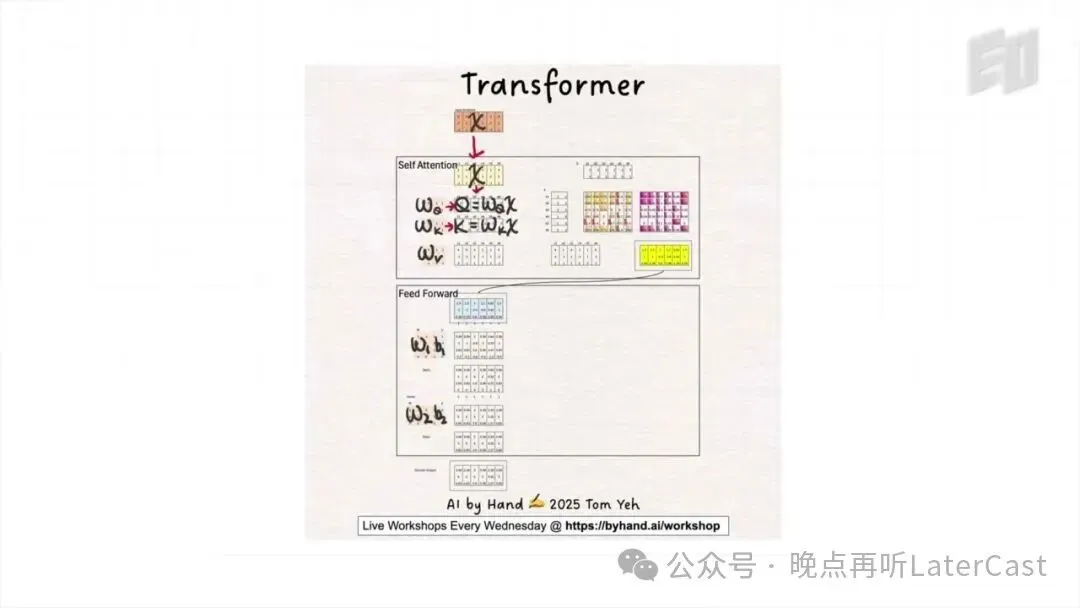
AI by Hand 的 Transformer 手绘图把自注意力、前馈网络与矩阵运算放在同一张图里,便于沿计算路径逐层验证。
“你有多珍惜一门知识,往往和你为得到它花了多少时间成正比。”
人的时间有限,没必要每件事都手算一遍,但最值得拥有的部分应该慢下来亲自走一遍。 日常资料整理可以交给 AI,决定你专业上限的概念却需要自己拆解和验证;少了这层所有权,工具一换,熟练感往往也会随之消失。
潮流一直换,矩阵乘法一直在
Tom 本科时学线性代数,只把矩阵乘法当作计算机专业的必修要求,并不知道它有什么用。后来《侏罗纪公园》带火 CGI,图形学需要矩阵;大数据兴起,数据处理仍然需要矩阵;机器学习和今天的生成式 AI 又绕回同一个底层。每一轮浪潮都带来新的术语、公司和工具,旧热点退潮后,矩阵乘法却继续留在课程、论文和代码里;哪怕下一轮讨论量子计算,矩阵运算依旧不会离场。
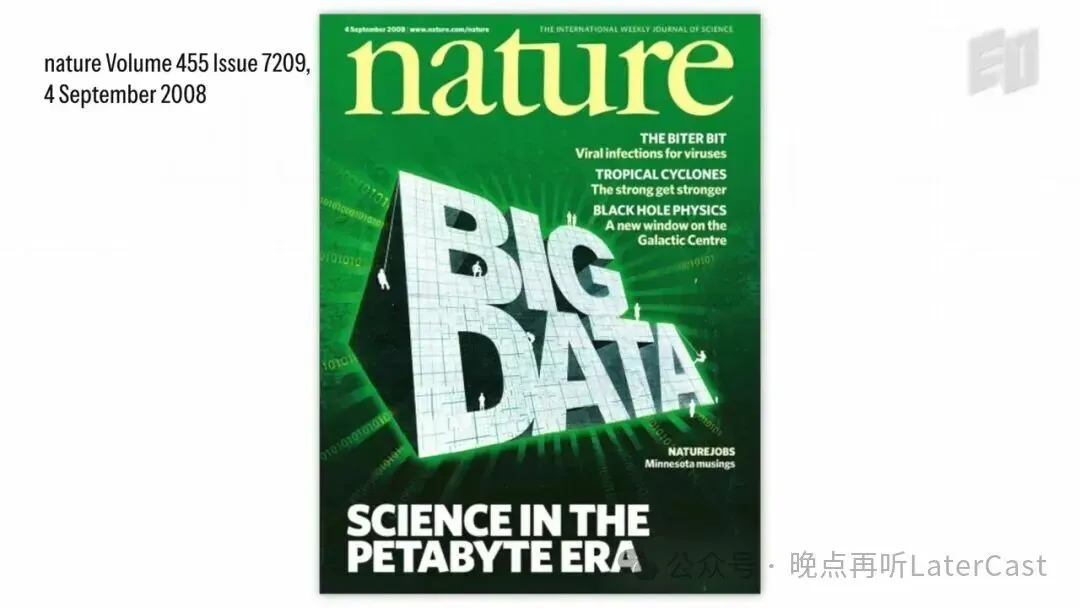
回顾 2008 年《Nature》的 Big Data 封面:热门技术不断改名,处理数据所依赖的数学基础却会跨周期复用。
“每隔两三年,热门的东西会变,但总有一些底层知识不会变。”
看清这种区别,才知道时间该花在哪里:某个模型两个月后还热不热很难预测,Transformer、概率和线性代数明年仍然有用,却相对容易判断。 追新工具可以让你暂时领先,底层知识决定你掉队后能不能追回来。 Tom 当年错过深度学习,后来能够补上,靠的正是拆难题、画图和耐心演算这些看起来很旧的办法。
工具会烧掉,地基能让你重建
几年前,Tom 去韩国参观景福宫。宫殿在十六世纪几乎被烧毁,留下来的部分是石头地基;到了十九世纪,人们沿用同一套地基把宫殿重新建起。建筑的样式、材料和使用方式都可以变化,承重的部分一旦保留下来,重建就不必从空地开始。他把这段历史看成技术学习的参照:模型、框架和界面会消失,只要底层理解还在,新东西来了仍能接着建。
“只要地基足够牢,你就能在上面重新搭起自己的能力。”
如果学习始终围着按钮和操作步骤打转,每次工具更新都像重新盖房。 先分清地基和装修,长期看反而更省时间。 对工程师而言,地基可能是数据结构、系统和数学;对产品经理而言,则可能是用户问题、现实约束和判断证据。地基不必贪多,但要经得起反复使用。
可以错过一个工具,别丢掉学习能力
Tom 建议每个人回想一项真正练过的技能,可能是钢琴、足球或国际象棋。具体技能和 AI 没有直接关系,练成它的过程却很有用:你知道困难可以被拆开,也体验过长时间没有明显进展,最后突然跨过门槛。这样的练习会进入一个人的身份认同,让“我以前学会过难东西,这次也能”不再只是安慰,而是一段有证据的个人经验。
“跳过眼前这个 AI 工具完全没问题,但放弃下一次钢琴或足球练习不行。”
一年后,你也许记不住 Transformer 的每条公式,却会记得自己曾在图书馆坐了几个小时,最后把一个黑箱慢慢打开。 记住所有知识并不现实,愿意走进难题的经验,才会影响下一次学习从哪里开始。 这也意味着,面对不断变长的工具清单,我们无需逐项追赶,可以把注意力留给一段完整的学习循环:提出问题、动手验证、发现错误,再重新解释。AI 可以缩短许多步骤,这份意愿仍得由人自己提供。
学生用 AI 作弊,问题可能不在 AI
Tom 教编程时,为了防止学生在 Chegg 上抄答案,每学期都要重做作业,还试过检查 IP、在网站里放追踪入口。他花了很多精力和平台斗智斗勇,一度希望 Chegg 彻底消失,觉得平台关掉,教育就会轻松一些。后来 AI 抢走了 Chegg 的生意,作弊却没有减少,他才意识到自己盯错了对象:学生寻找捷径的原因一直都在,只是承载捷径的工具换了名字。
ChatGPT 与 Google AI Overviews 在 39 个月内重创 Chegg;平台衰退了,作弊动机并未随之消失。
“Chegg 和 AI 都只是症状,真正的问题是学生为什么觉得自己必须作弊。”
当制度只奖励一份看起来正确的结果,学生自然会寻找成本最低的路径,封掉一种工具也只会让另一种工具补位。 教育真正该奖励的,是理解、投入和解决问题的过程。 这个判断同样适用于公司:只考核产出数量,员工就会用 AI 堆数量;考核问题是否解决,人们才会把工具用在恰当的位置。
招聘别迷信 AI-native,先看这个人靠不靠谱
到了招聘环节,Tom 关心的仍是那些老问题:这个人有没有职业伦理,能不能解决问题,是否愿意和别人合作。真正的问题解决者遇到 AI,通常会主动去学,因为工具确实能帮他更快完成任务;真正的团队成员也会自然寻找用 AI 协作的办法,不需要管理者天天催促“必须 AI-native”。反过来看,工具熟练度可以在入职后继续训练,遇到难题是否肯负责、与人合作时是否可信,却很难靠一次 AI 培训补出来。
“一个人如果不尊重同事,AI 不会突然把他变成团队成员。”
AI 会放大一个人原有的工作方式,却补不上公司选人时忽略的品质。 只顾自己利益的人拿到更强工具后,可能跑得更快,方向却依然没变。招聘时与其把“熟练使用某个模型”列为硬门槛,不如看看候选人过去如何学会新工具,以及他能不能用工具帮助整个团队。
写在最后
面对层出不穷的新模型,我们没必要每次都跟到筋疲力尽。不妨挑一个与你工作最相关的底层概念,暂时关掉 AI,用纸笔写一遍,再试着讲给别人听;讲得清楚,就把工具重新打开,讲不清楚,也正好知道下一步该补哪里。如果一时不知道从哪开始,就从最近一次“能用但说不清原理”的工作入手,把它拆成一个今晚可以验证的小问题。这样的慢,往往比多装一个新工具更接近真正的进步。
内容来源:“A CS Professor on Why Slow Learning Wins in the AI Era”丨 EO(嘉宾:Tom Yeh)
原视频:https://www.youtube.com/watch?v=BAgxGp2WEu4
