
上周五(9 月 11 日),Digital Production 刊发了一篇针对 Baselight 8 开发团队的深度访谈。北京华柯映彩创始人、电影调色师华成老师对该文完成了翻译,并附上了个人解读与观点总结,文中探讨的内容极具参考价值,也充分体现了一线调色师的深度思考,现将部分译文及点评转发分享,希望能为大家带来启发与裨益。
华成: 对于这篇访谈,我认为真正值得看的并不是“新版又多了多少功能”,而是一套非常清楚的 AI 哲学:Chromogen ML 把 LUT 反向拆成可编辑的调色结构,Groups View 用机器学习重新组织时间线;新的 Grain、Color Correlation 也都在做同一件事——把过去隐藏在黑箱里的关系,重新变成可观察、可修改的结构。
01 AI 会不会替掉调色师?Baselight 8 给了一个完全不同的答案
这两年,绝大多数“AI 调色”的展示都在回答同一个问题:能不能让模型直接给我一个结果?给它一张参考图,它生成一个 Look;给它一段素材,它自动匹配曝光、白平衡、色彩和风格。结果当然越来越像样,但这个方向有一个天然的问题:结果越聪明,创作者往往越不知道它为什么这么做。
FilmLight 在 Baselight 8 里走的路线几乎相反。它没有先把 AI 放在“替你做决定”的位置,而是让 AI 去做一件人最费时间、机器又很擅长的事:发现结构。也就是说,它不急着回答“应该调成什么样”,而是先回答“这个 Look 是由什么组成的”“这些镜头之间到底是什么关系”。
真正适合专业创作的 AI,也许不是替你做结果,而是把结果背后的结构摊开给你看。
02 Chromogen ML:不是再复制一个LUT,而是把LUT拆掉
一个 Show LUT 最麻烦的地方,往往不是它不好看。恰恰相反,很多摄影师会带着一个自己非常喜欢的 LUT 来到调色棚:颜色有性格,肤色也舒服,现场监看用了很久,大家都已经习惯它。真正的问题是——这个 Look 被“烤死”在里面了。
LUT 里可能同时混着 Log 到显示的映射、曝光偏移、Flare、对比度、饱和度、色彩交叉、某些高光偏色,甚至一些并不优雅的折线和 kink。SDR 看着很好,一到 HDR 或极端曝光,问题就可能暴露出来。过去调色师只能在 LUT 前后加节点去补;真正想把它重建成一套健康的可编辑结构,往往要花很长时间。
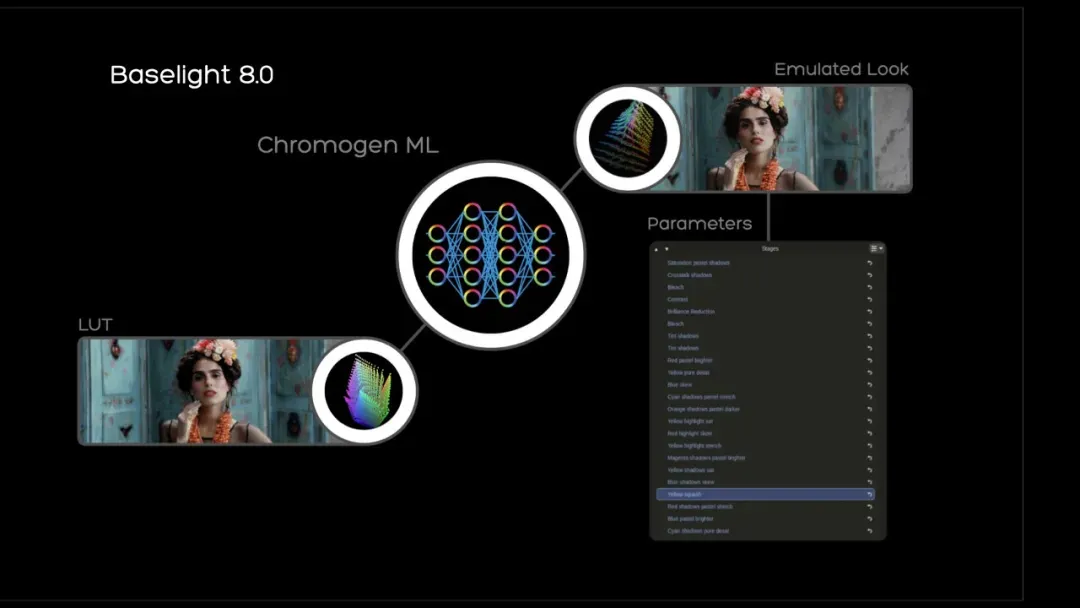
Chromogen ML 做的是反过来分析 LUT 或 grading stack,然后尝试用 Baselight 里的 Chromogen / Base Grade 操作把它重构出来。FilmLight 的演示里,模型甚至识别出了大约 -1.1 stop 的曝光变化,并依次建立 Flare、Saturation、Shadow、Crosstalk、Pure Color、Bleach、Pastel、Contrast、Brilliance、Highlight Tint 等阶段。
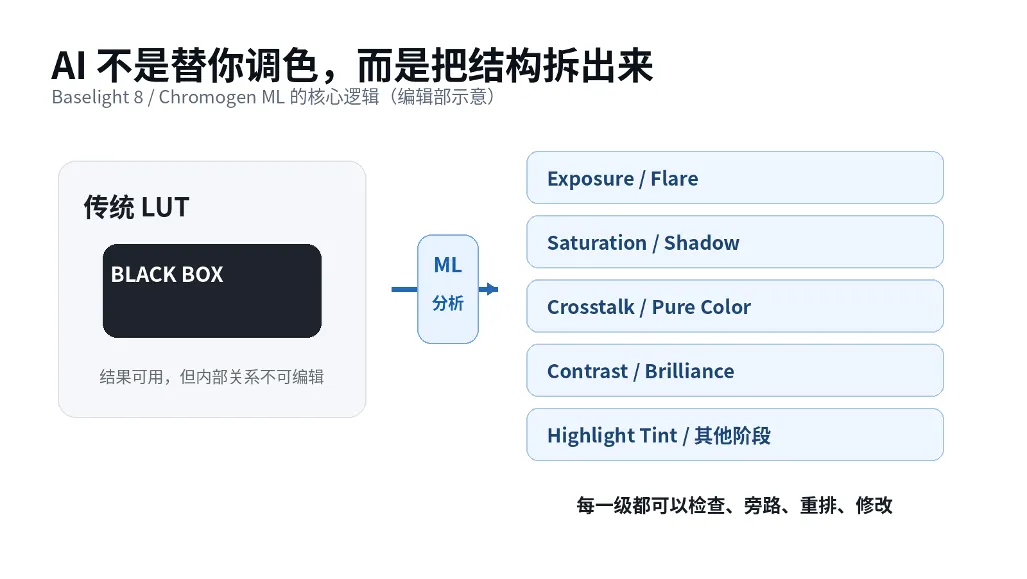
关键不是它能不能像素级复刻原 LUT。FilmLight 自己也明确说,任意 LUT 都可能包含很怪的局部形状,Chromogen ML 不保证把每一个坏 kink 都忠实保留下来。反而这可能是优势:它尽量保留真正有价值的色彩性格,同时把不合理的部分重新解释成更健康的程序化 Look。Martin Tlaskal甚至把它称作一种“LUT healer”。
更重要的是,新的模型可以直接在 Baselight 工作站本地运行。对高规格项目来说,这并不是小事——专有 LUT 和项目 Look 不需要上传云端,安全环境、离线机房也能用。
03 Groups View:AI 不调一帧颜色,却可能让整部长片更好调
Baselight 8 另一个我觉得非常重要的变化,是 Groups View。传统调色软件天然让我们按时间线理解项目:Shot 001、Shot 002、Shot 003……从头往后走。这种结构对剪辑是自然的,但对调色未必。调色师真正思考的往往是“这一场”“这个机位”“这个人物的近景”“这一批回忆戏”。
Groups View 先用视觉 embedding 加上粗略的色彩 / histogram 信息,去寻找镜头之间的相似性,然后把它们整理成 Narrative Scene、Angle Group、Global Angle Group 等层级。机器先完成一个大约 80% 的初始结构,人再用 split、join、拖拽、锁定等方式修正剩下的 20%。
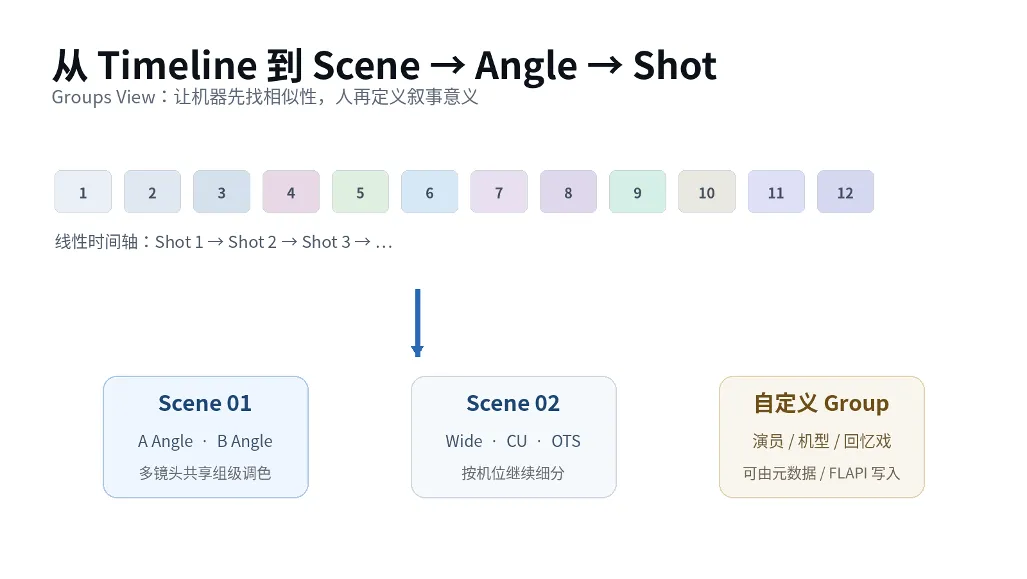
这里真正漂亮的一点,是 FilmLight 没把自己的 ML 变成唯一入口。Groups View 底层只是给 Shot 写入一些字段:Scene、Angle、Actor、Camera、Stock……这些值可以由 FilmLight 的模型生成,也可以来自剧本、剪辑系统、production tracking 数据库,甚至你自己写的 Python / FLAPI 分析工具。
也就是说,AI 不再只是一个“神奇按钮”,而是项目数据模型的一部分。一个动画团队可以按角色分组;广告项目可以找出所有出现某个产品的镜头;长片可以把所有回忆段落、某台摄影机、某种 Input Color Space 或某种 Grain 需求一次性组织起来。
04 新Grain:真正的颗粒不是“盖一层 Noise”
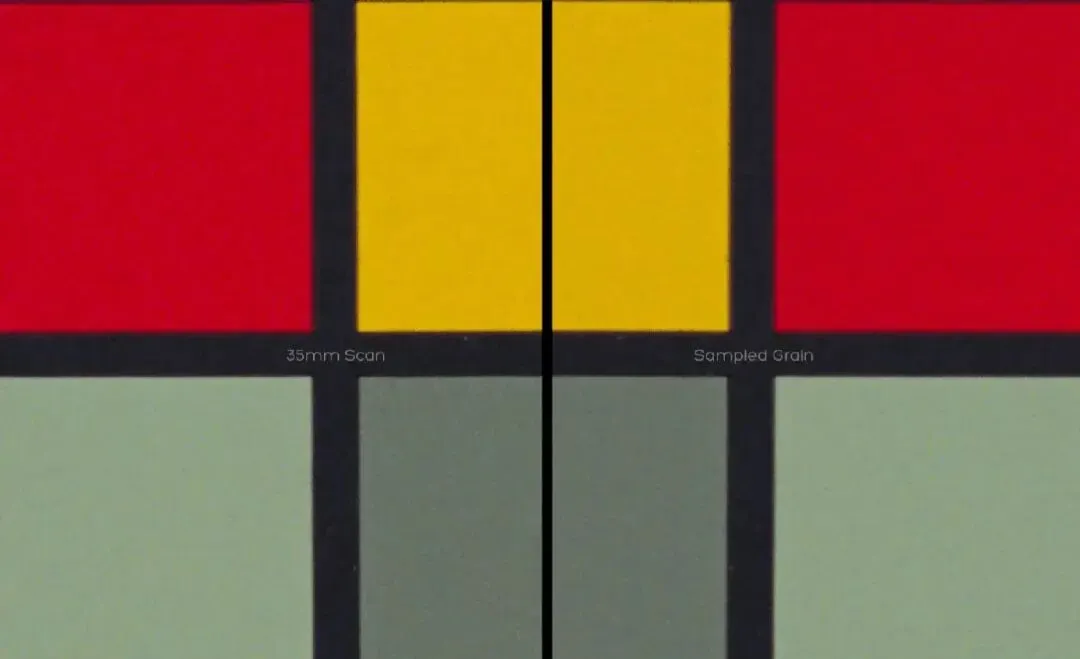
Baselight 8 的新 Grain 也在重复同一种设计哲学:不要把结果做成一张贴图,而是把背后的形成机制变成一个可编辑模型。它工作在线性光里,让颗粒随曝光变化;同时引入色彩通道之间的 correlation,因为真实胶片的 R、G、B 层并不是互相独立的。
更有意思的是,它还允许调整不同空间频率的结构、统计分布和极端值,并且可以从真实素材里采样颗粒特征,再合成一个可继续修改的 procedural grain。也就是说,“Match Grain”不是终点:匹配以后,你仍然可以单独降低高光颗粒、加强中间调、改变黄蓝或洋红绿之间的相关关系。
这和很多把 Noise Plate 直接叠在画面上的方法差别很大。FilmLight 强调的是:如果颗粒足够大,画面细节本身也应该被颗粒结构影响,而不是在一张完全清晰的数字图像上再盖一层透明噪声。物理合理性变成默认起点,但创作者仍然可以把细节混回来。
05 Color Correlation:为什么Baselight 需要“第十种饱和度”
Daniele Siragusano 在访谈里开玩笑说,Color Correlation 大概已经是 Baselight 的第十种 Saturation。听起来有点夸张,但它恰恰说明了一件专业调色里非常重要的事:饱和度从来不是一个唯一的数学问题。
传统方法可能先转到 HSV,再放大 Saturation;也可能进入 Lab 一类感知空间增加 chroma。Color Correlation 则直接留在 RGB 域里,看三个通道之间的统计相关性:相关性降低,RGB 彼此拉开,颜色更饱和;相关性升高,三个通道靠拢,颜色更中性。
它还允许定义目标 gamut 或 creative primaries,让已经接近边界的颜色被压向合理范围,而不是所有颜色一股脑往外推到 clipping、glowing 或异常的高饱和区。这不是“更大的 Sat 旋钮”,而是另一套颜色运动规律。
06 这四件事,其实是同一种产品哲学
把 Chromogen ML、Groups View、新 Grain 和 Color Correlation 放在一起看,会发现 Baselight 8 最重要的变化根本不是功能数量,而是它们共享同一种思路:
Reference / LUT / Timeline → 机器理解结构 → Editable Structure → Human Decision
Chromogen ML 拆 Look 的结构;Groups View 拆项目的结构;Grain 拆纹理形成的结构;Color Correlation 拆“饱和度”背后的通道关系。AI 和算法没有把创作者从工具里赶出去,反而把过去最难看见的东西变得更可见。
这可能比“一键自动调色”更接近专业软件真正会长期采用的 AI 形态。因为专业创作最怕的不是工具太复杂,而是结果不可解释、不可重复、不可局部修改。一旦 AI 的输出仍然是透明、参数化、可编辑的结构,它就不再和调色师争夺判断权,而是在给调色师增加控制权。
07 这和Reference 搜索其实也有同一个方向
这篇内容和 YouCan 不需要硬连,但它给视觉搜索一个很直接的提醒:过去 Reference Search 是“帮我找一张更像的图”,下一步可能是“告诉我这张图为什么成立”。如果搜索能从相似结果走向视觉结构解释——景深、光比、颜色关系、纹理、镜头距离、空间层次——Reference 就会从终点图变成一套可继续创作的条件。Baselight 正在做的,本质也是把一个 Look 从结果重新变回结构。
最后
Baselight 8 当然还有新的音频 Mastering、Remote、S3、Transcode、Preset 等大量工作流更新。但如果只问我这一版最值得影像创作者记住什么,我会记住一句话:AI 不一定要替我们决定画面。它更有价值的角色,可能是把那些原本隐藏、复杂、重复、难以解释的结构摊开。
好的专业 AI,不是把创作者关在黑箱外面,而是帮他把黑箱打开。
转载自调色师华成。
