
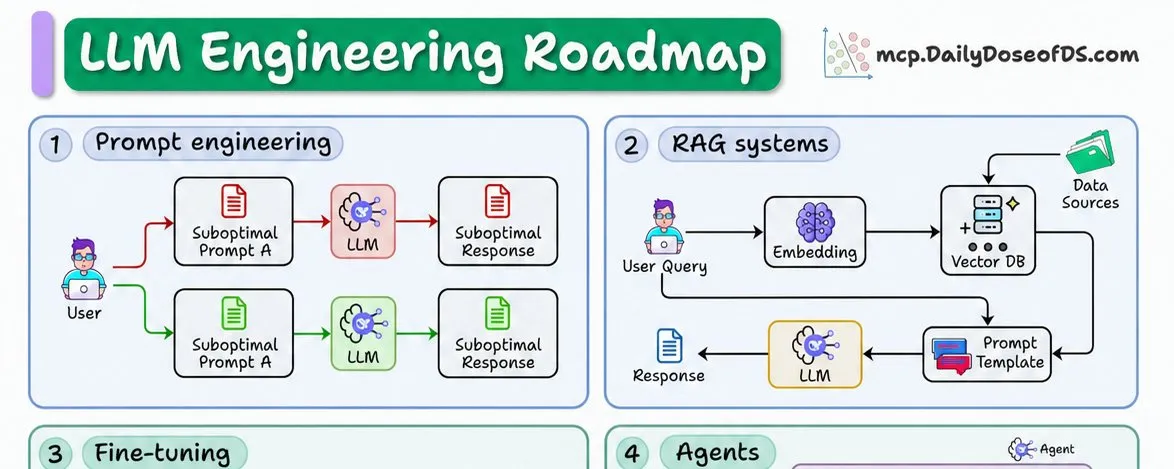
使用 LLM,不只是会写提示词。
真正达到生产级的系统,要求你深入理解 LLM 是如何被构建、部署和优化的。
下面这 8 个支柱,定义了真正的 LLM 开发:
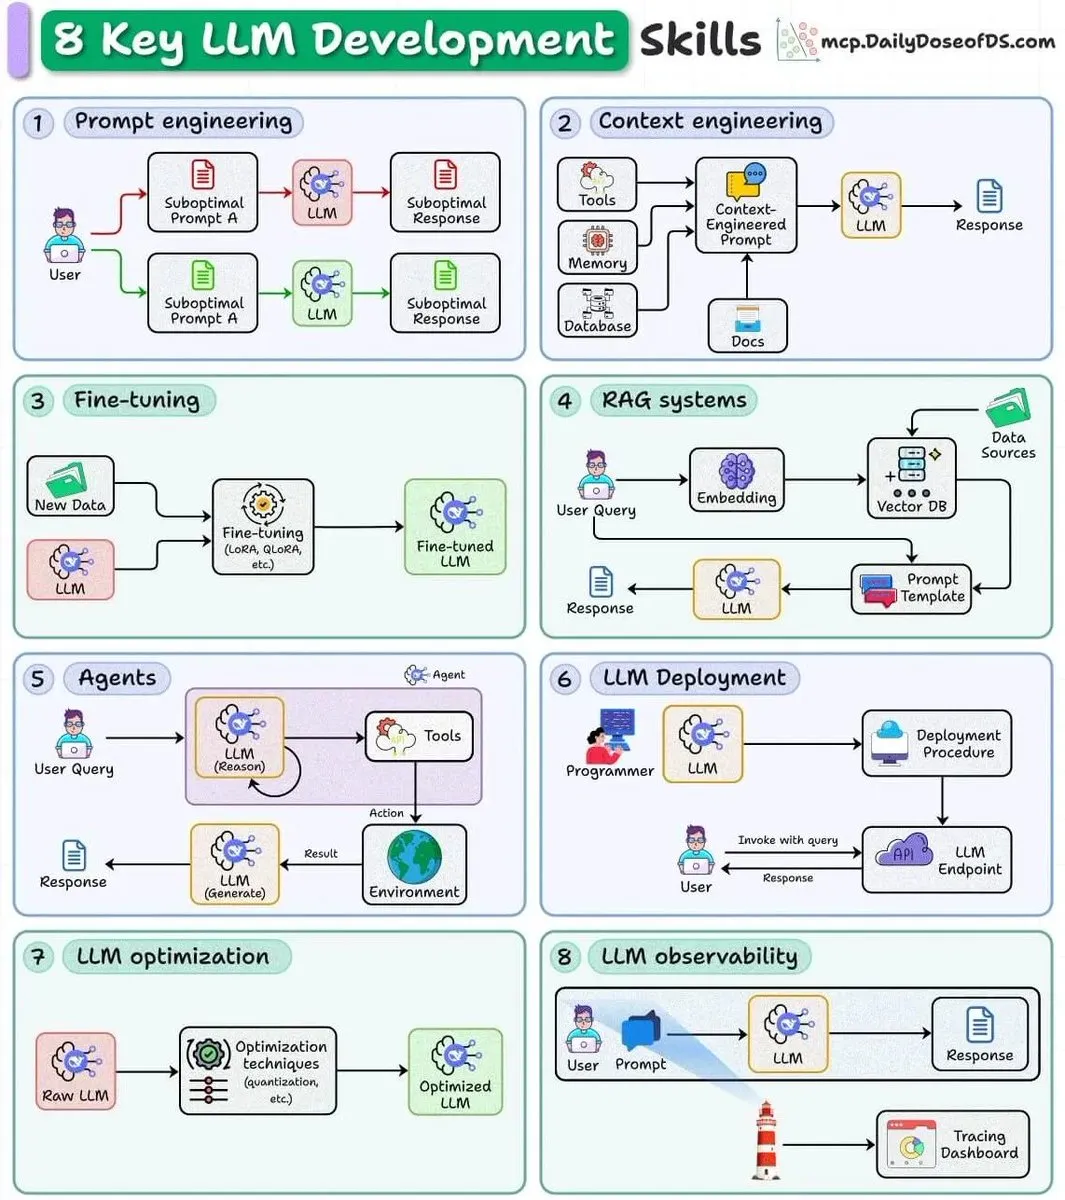
下面逐一来看。
1. 提示工程
每一段 LLM 学习路径,都是从这里开始的,因为提示词是你手里成本最低的杠杆。
在你开始上检索或微调之前,应该先弄清楚,一个结构良好的提示词到底能把效果推进到什么程度。
这意味着你要学会写出能减少歧义的指令,使用少样本示例来固定输出格式,并通过推理链来稳定模型的推理过程。
目标是把提示词当成代码来对待,也就是要能版本化、可测试、可复现,而不是复制粘贴那些今天有效、明天就失效的一次性技巧。
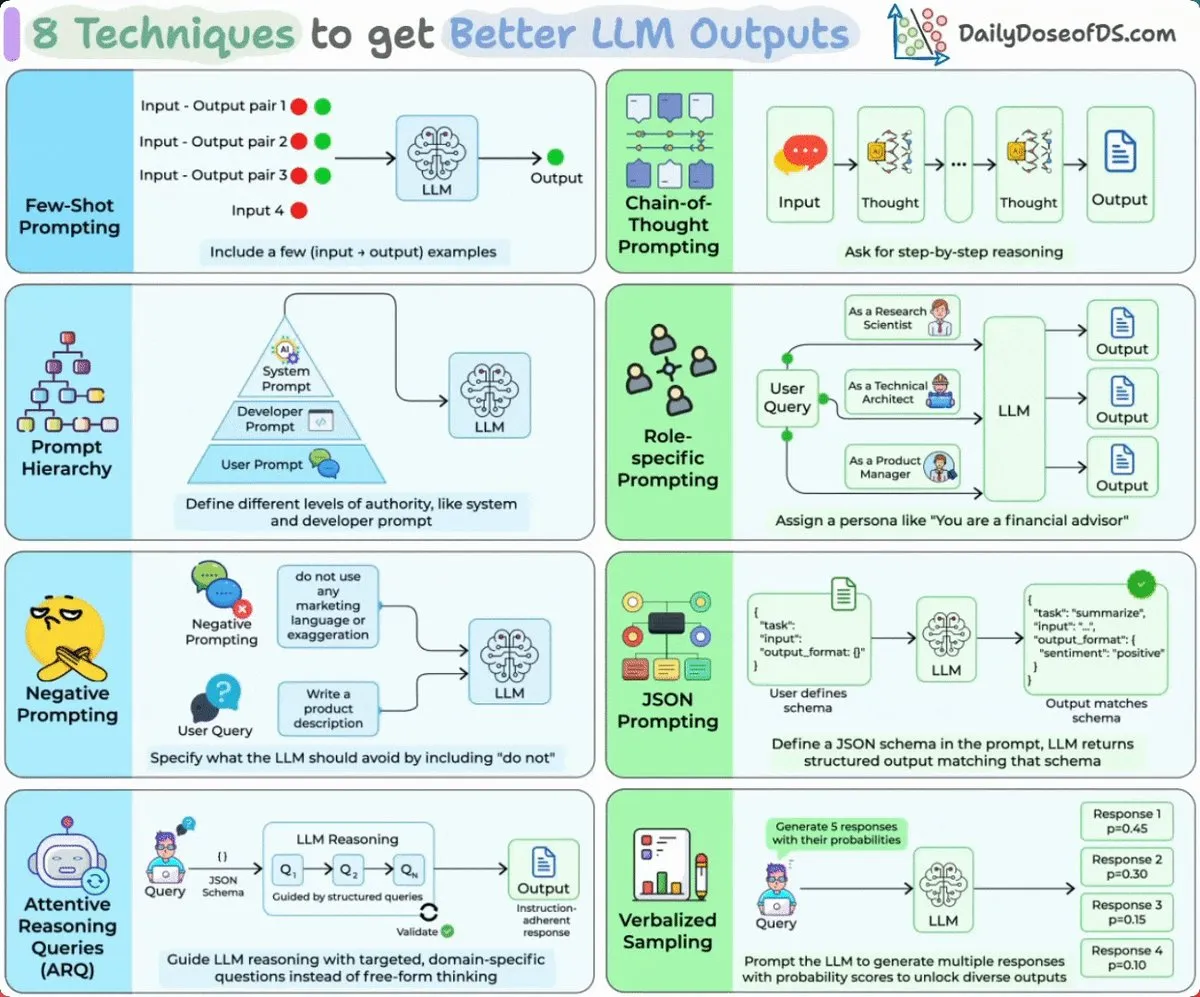
我在下面整理了 8 种可以显著提升 LLM 输出效果的提示技巧:
https://x.com/\_avichawla/status/2047941215648444771
更多免费资源:
- 这份提示工程指南 是一份非常全面的开源指南,几乎覆盖了所有技术路线,并配有论文与笔记本示例:
- Anthropic 的提示工程总览 是官方指南,持续更新,并且附带提示词生成器:
- OpenAI 的提示工程指南 覆盖推理模型、结构化输出以及 Agent 工作流:
- 这个提示工程仓库 提供了 22 个从入门到进阶的实战 Jupyter 笔记本:
2. RAG 系统
一旦答案需要模型训练时从未见过的数据,比如公司文档、客户历史记录,或者知识截止时间之后的新信息,单靠提示词就会碰到天花板。
RAG 的解决思路,是先把文档嵌入到向量索引里,在查询时检索出最相关的片段,再把它们拼接进提示词。
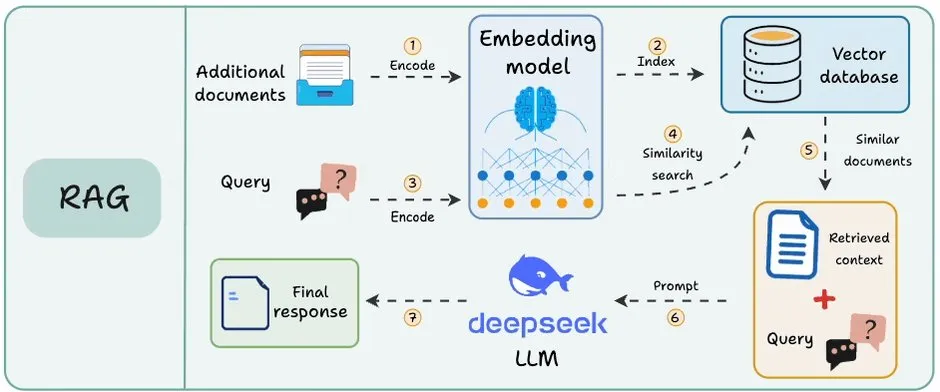
一个可用的 RAG 系统,通常要重点处理的流水线环节包括:分块大小与重叠策略、检索前的查询改写,以及检索后的 cross-encoder 重排。
你应该掌握多种不同的 RAG 架构:
https://x.com/i/web/status/2027270775494082936
免费资源:
- 这个 RAG 技术仓库 提供了从朴素 RAG 到 Agentic RAG 的全套笔记本教程。
- LangChain 的 RAG from scratch 是一套从基础到高级模式的教学视频系列。
- Awesome RAG 是一份整理过的框架、论文与教程资源清单。
- Building RAG Agents with LLMs 是 NVIDIA 提供的免费课程,覆盖文档处理、嵌入以及部署。
3. 上下文工程
检索只是众多输入中的一种。
模型的上下文窗口里,还会同时放着对话历史、工具输出、跨会话记忆、系统提示词和少样本示例,它们都在争抢同一批 token。
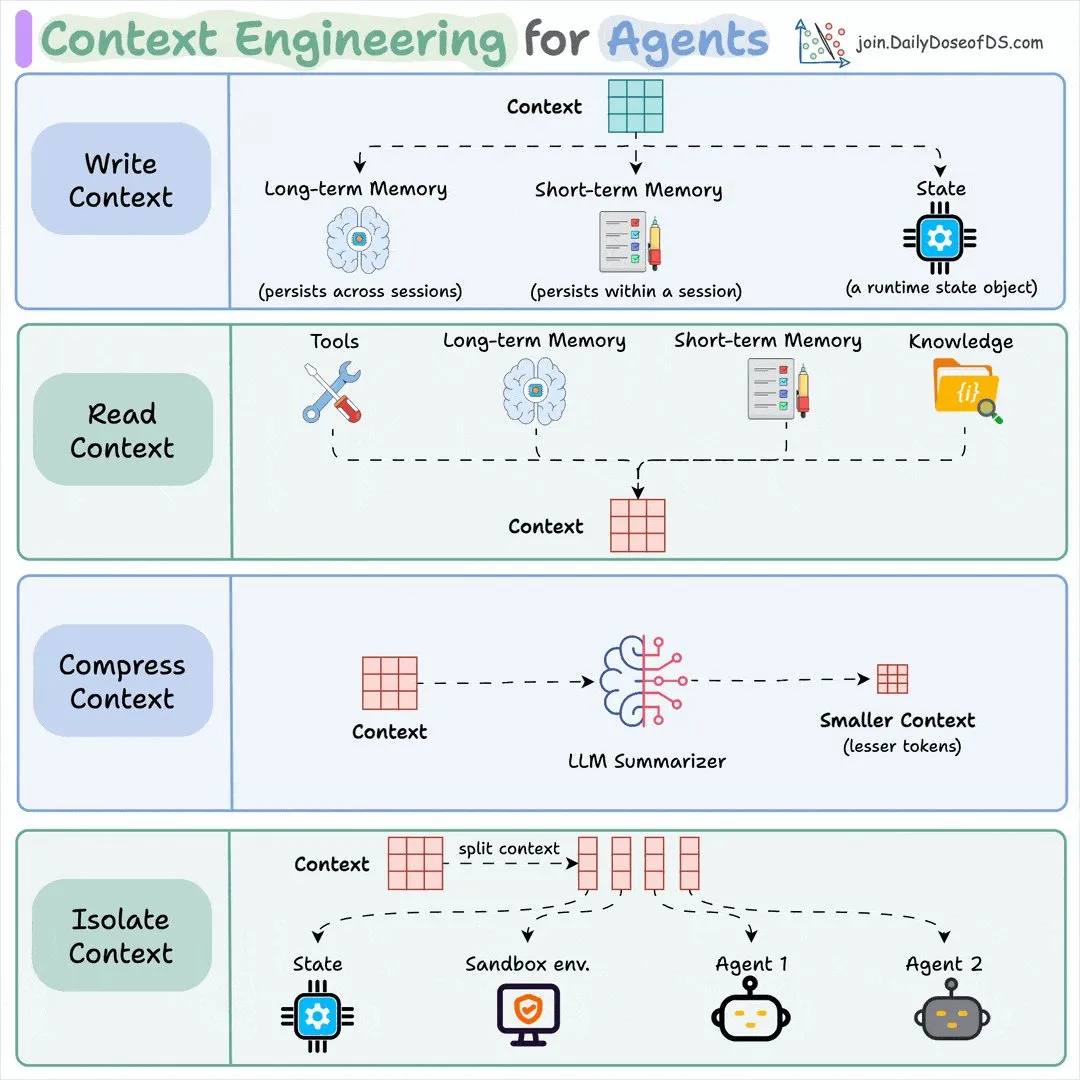
上下文工程,就是决定哪些内容该保留、哪些该压缩、哪些该丢弃的学问,因为每一个 token 都意味着成本,也会稀释模型的注意力。RAG 只是这个更大问题中的一个工具。
这是我最近关于上下文工程的一个演示:
https://x.com/i/web/status/1966026427779961112
免费资源:
- Anthropic 的 Effective context engineering for AI agents 是讨论上下文策略的权威工程指南。
- 这份上下文工程指南 覆盖了系统提示词、检索、记忆和工具定义。
4. 微调
当提示词和上下文优化都开始触顶时,下一个杠杆就是模型权重本身。
LoRA 和 QLoRA 通过训练小型低秩矩阵,而不是整个参数集,让你可以在单张 GPU 上改造基础模型,通常只需要几千条样本,就能补齐特定领域的能力缺口。
这篇内容讲清了 5 种必须掌握的 LLM 微调技术:
https://x.com/i/web/status/2039256052643078144
真正难的是数据,包括去重、指令格式化和质量筛选。训练循环本身反而是更容易的部分。
我联合创始人也写过一篇文章,讲 2026 年应该如何理解 LLM 微调:
https://x.com/i/web/status/2029212227438518406
更多免费资源:
- Sebastian Raschka 的 Build a large language model (from scratch) 附带免费仓库,涵盖预训练、指令微调以及从零开始实现 LoRA。
- Hugging Face LLM course 由社区驱动,系统覆盖 Transformers 与端到端微调。
- Unsloth notebooks 提供免费 Colab 笔记本,用于快速完成 LoRA / QLoRA 微调。
5. Agents
Agent 是对 LLM 循环的扩展:模型选择工具、调用工具、读取结果,再决定下一步该做什么,如此往复,直到任务完成。
真正的工程难点在于编排层。你要处理跨轮状态管理、工具返回异常时的重试逻辑、防止无限循环的步数限制,以及模型选错工具时的优雅失败。
我在这里介绍了几种构建 Agent 的常见模式:
https://x.com/i/web/status/1984145843113619714
此外,这里还有一篇由我联合创始人整理的 Agent 构建速成内容:
https://x.com/i/web/status/1944011860086235540
一些免费资源:
- Hugging Face agents course 是一门完整免费课程,覆盖 smolagents、LangGraph、LlamaIndex 和 Agentic RAG。
- Anthropic 的 Building effective agents 是一份简洁的 Agent 设计模式指南。
- Awesome AI agents 收录了 1,500+ 个相关资源和工具。
- Agents towards production 提供了覆盖生产级 Agent 全生命周期的教程。
6. LLM 部署
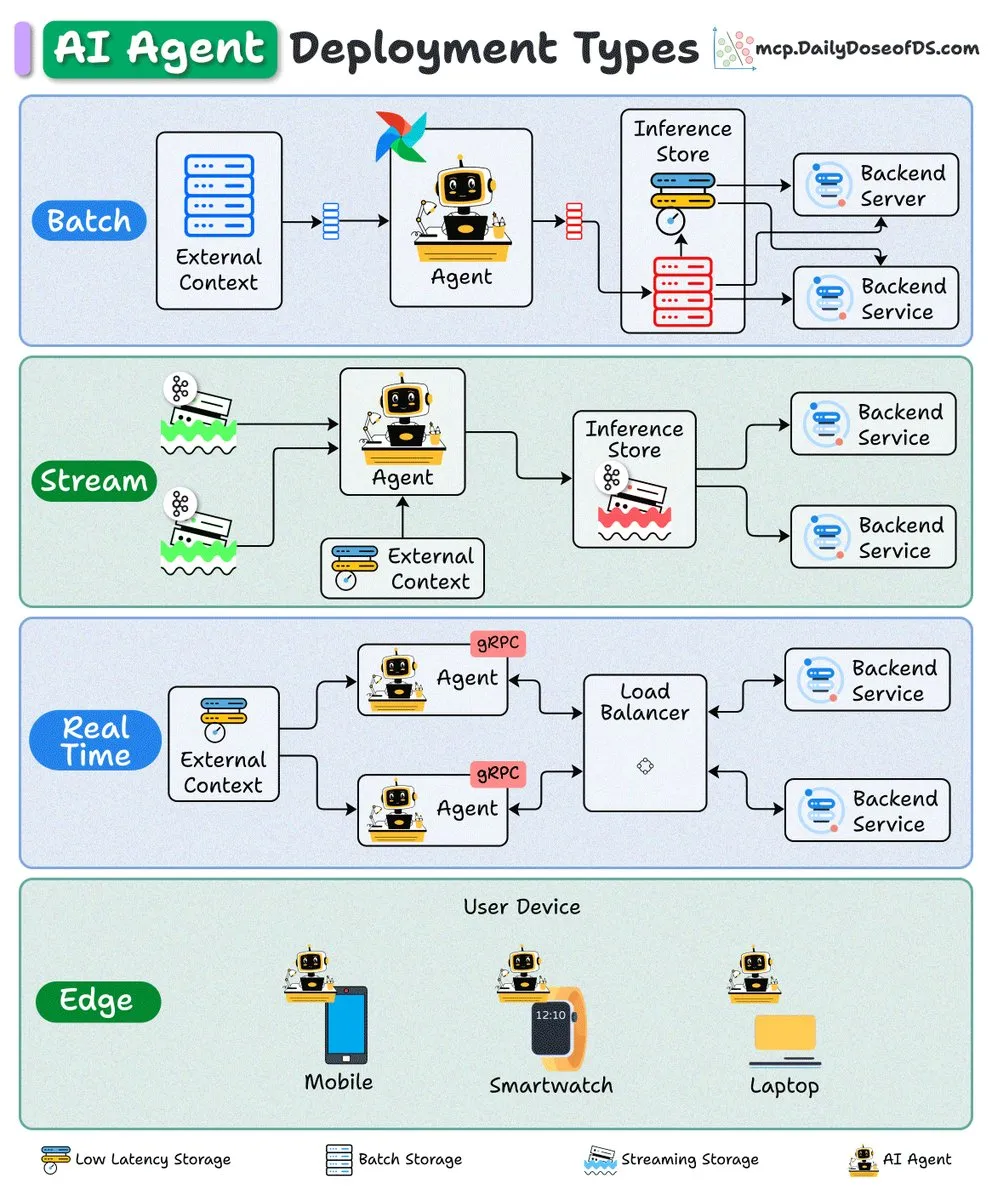
部署的核心,是在流量上来时处理并发请求、在负载下扩展系统,并把延迟稳定控制在可接受范围内。
问题在于,很多团队还在试图把 DevOps 的思路直接套到 LLM 应用上。
但 DevOps、MLOps 和 LLMOps 解决的是本质不同的问题。
建议先读这部分,建立对 LLM 部署核心挑战的基本认知:
https://x.com/i/web/status/2003353201228263497
当你在认知上把 LLMOps 和 DevOps 真正区分开之后,推理引擎就会成为第一个明确的技术决策点。
vLLM 通过 PagedAttention,把 KV cache 的浪费从 60% 到 80% 压到 4% 以下,这通常意味着在相同硬件上,吞吐量能比 TGI 高出 2 到 4 倍。
在这之上,你还要叠加服务层(LitServe、BentoML)、用于路由与成本控制的 LLM 网关(LiteLLM),以及按请求维度的成本追踪。
这是我关于用 LitServe 做 LLM 部署的一个演示:
https://x.com/i/web/status/1920727940297544169
这里还有另一个内容,讲的是如何直接从 Slack 构建并部署一个 Coding Agent,它可以抓取文档、编写可用于生产的代码、解决 issue,并发起 PR:
https://x.com/i/web/status/1953357517700182399
一些资源:
- vLLM 是高吞吐推理引擎,也是开源模型服务化的事实标准之一。
- Lightning AI 的 LitServe 是构建在 FastAPI 之上的灵活服务框架,专为 AI 工作负载中的 batching 和 streaming 设计。
- LiteLLM 用统一接口整合了 100+ 个 LLM API,并负责路由和成本控制。
7. LLM 优化
当你收到第一张推理账单时,这项能力就会立刻变得关键。
量化是最强的杠杆之一,它能把权重从 FP16 压到 4-bit(例如 llama.cpp 里的 Q4_K_M),通常只带来不到 1% 的 perplexity 损失,却能把内存占用压缩到原来的约四分之一,这也是为什么 70B 模型可以塞进单张 24GB GPU。
蒸馏则是用大模型的输出训练一个更小的学生模型。剪枝则会移除低于阈值的权重。每一种取舍,都必须在你的真实工作负载上做基准测试,而不是只看通用评测。
我在下面整理了 72 种这样的优化技术:
https://x.com/i/web/status/2045224379718791273
免费资源:
- llama.cpp 支持 1.5-bit 到 8-bit 量化,也是让本地推理真正普及的代表项目。
- Unsloth 提供 2 倍更快的微调和推理,并附带免费 Colab 笔记本。
- Hugging Face Optimum 是用于量化、ONNX 导出和硬件感知优化的工具包。
- bitsandbytes 是 Transformers 里 8-bit 和 4-bit 量化背后的核心库。
8. 安全、评测与 LLM 可观测性
如果你无法判断系统到底有没有真正跑起来,那么前面的所有工作都会白费。评测和可观测性回答的是两类不同的问题:
- 评测 关注的是:“输出质量够不够好?” 它通常在部署前运行,基于黄金数据集,并在每次提示词或模型改动后作为回归检查。
- 可观测性 关注的是:“系统现在到底发生了什么?” 它用于追踪线上请求、监控 token 消耗和延迟,并暴露生产环境中的失败点。
这里可以系统了解可观测性的各个层次:
https://x.com/i/web/status/2051571401614925975
这篇实战指南介绍了如何借助 Comet Opik,把评测与可观测性集成进 LLM 应用 →
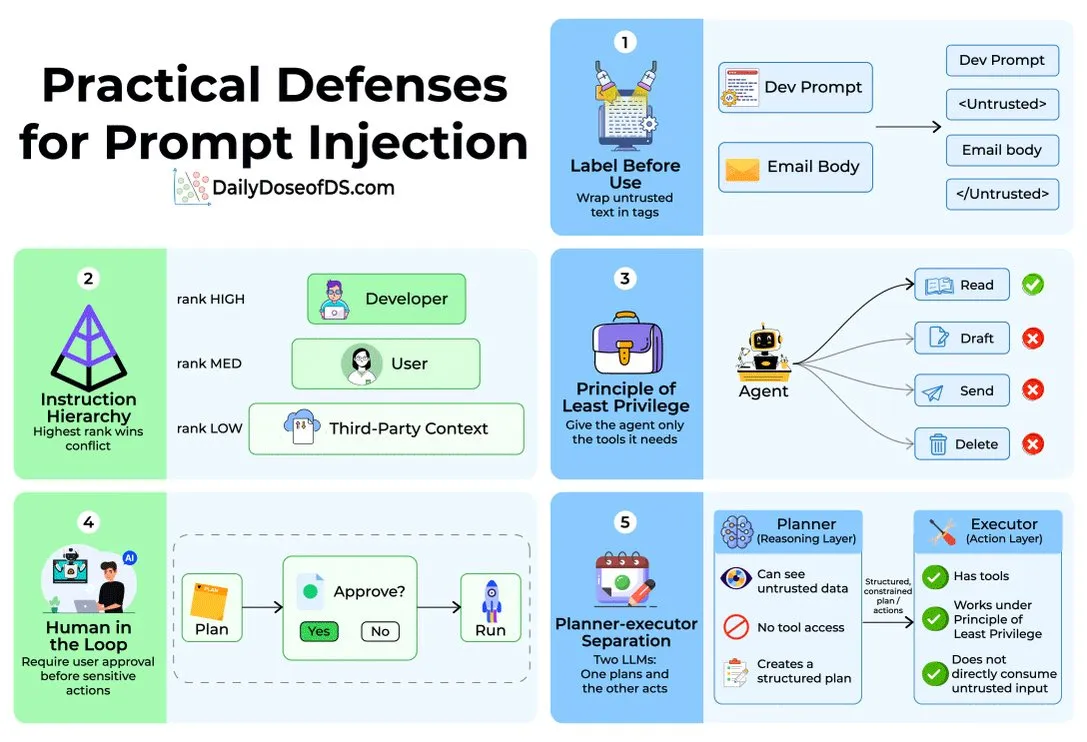
说到安全性,下面这份内容整理了每个 LLM 应用都应该具备的 5 个实用 Prompt Injection 防御手段:
上面这 8 项技能,默认都建立在模型已经训练完成的前提上。如果你还想再往下钻一层,理解训练本身到底是如何发生的,我在这里拆解了其中的 4 个阶段:
https://x.com/i/web/status/1947184607277019582
另外,如果你只想保留一个最权威的总参考,那么 Chip Huyen 的 AI Engineering: Building Applications with Foundation Models 是我认为讲清楚如何把基础模型真正产品化的最佳书籍之一。
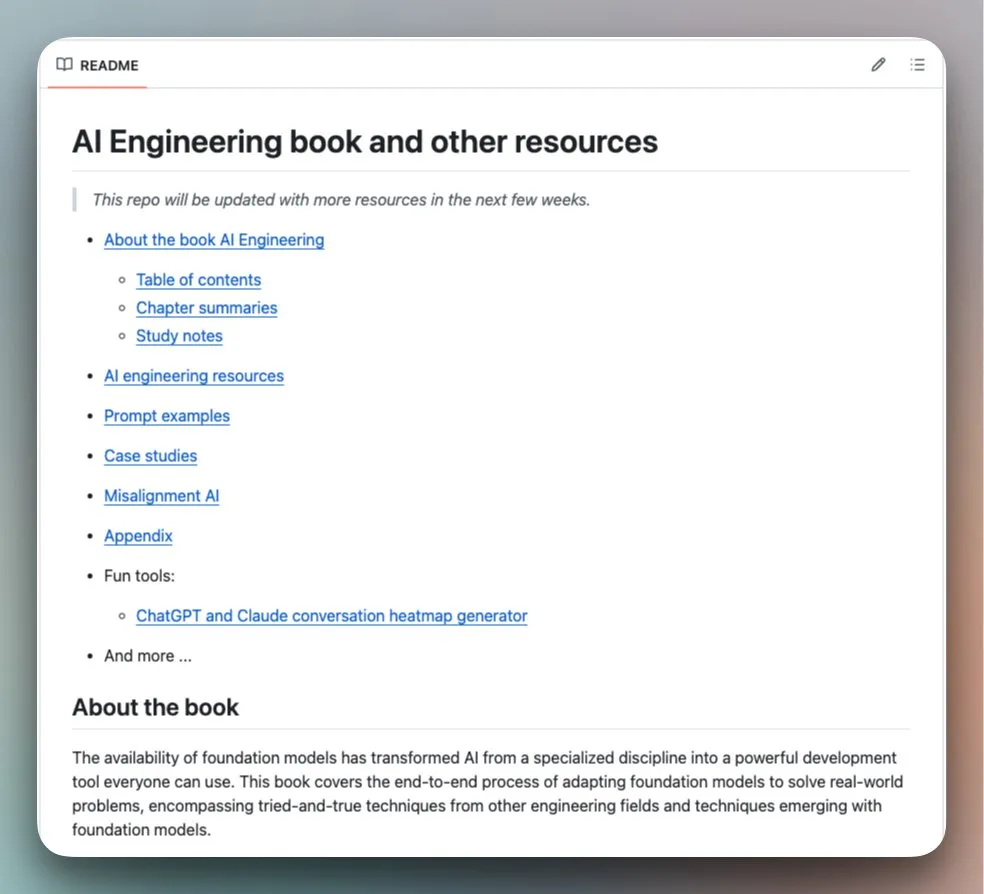
配套仓库中的笔记和资源也都是免费的。
👉 轮到你了:你还会往这份清单里补充哪些 LLM 开发技能?
以上就是全部内容!
如果你喜欢这篇教程:
欢迎关注我 → @\_avichawla
我每天都会分享关于 DS、ML、LLM 和 RAG 的教程与洞察。
📎 原文信息
原帖链接:https://x.com/\_avichawla/status/2053049489963811135
