
曾在 Apple 做了 12 年 UI/UX 的 设计师 Anshu Chimala,经常在 X 上发 AI 设计的 demo,发完第一版,还会持续迭代、研究去除 AI 生成的痕迹。他的 Build in public 这个探索曲线分享出来,里面有很多可以值得学习的细节。
他过去在 Apple 的工作经历,长期带一个研发团队做探索性的未来 AI 产品的研究和原型,他开玩笑地说,跟 UIKit、SwiftUI、Xcode 缠斗把命都磨短了几年,但就是这份精进的、钻研的经历,成为他探索 AI iOS 端设计的一条基准,模型出的界面达没达到 Apple 那个水准、转场算不算流畅,他一眼能看出来,也知道该往哪个方向调试。
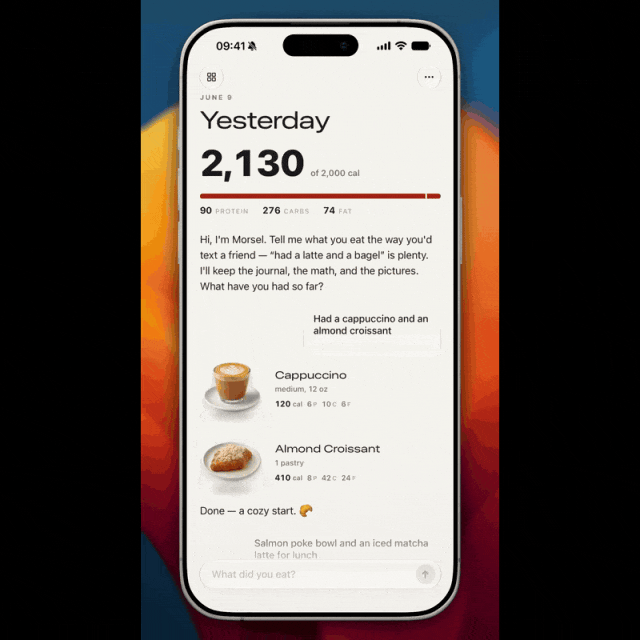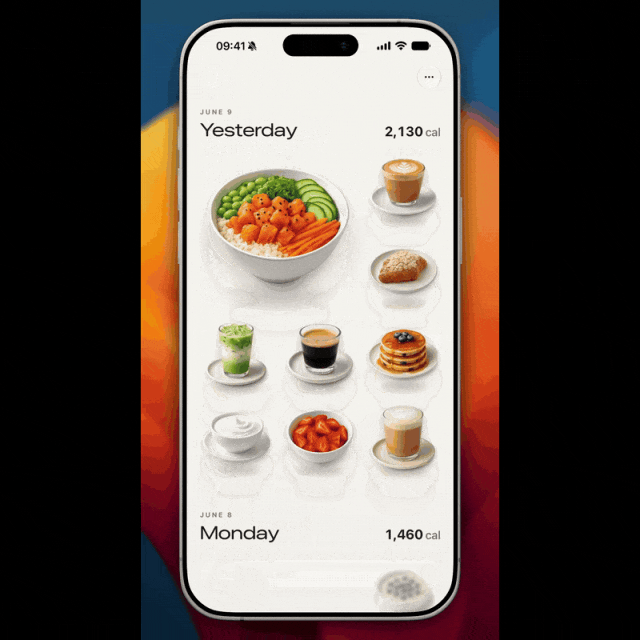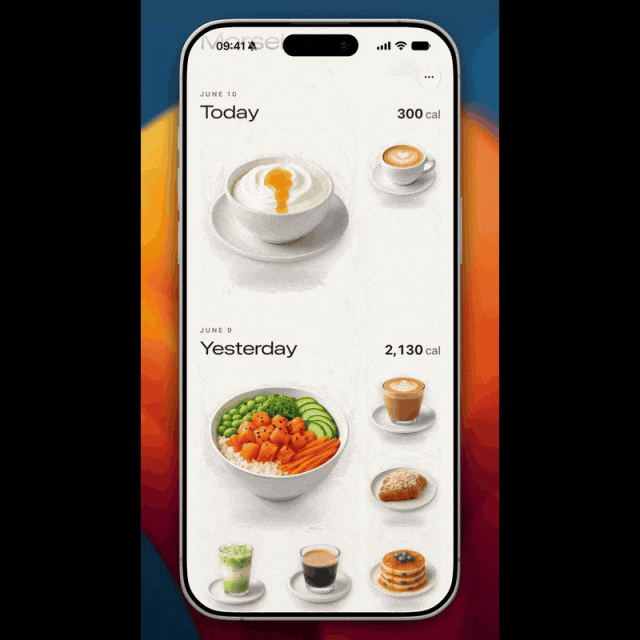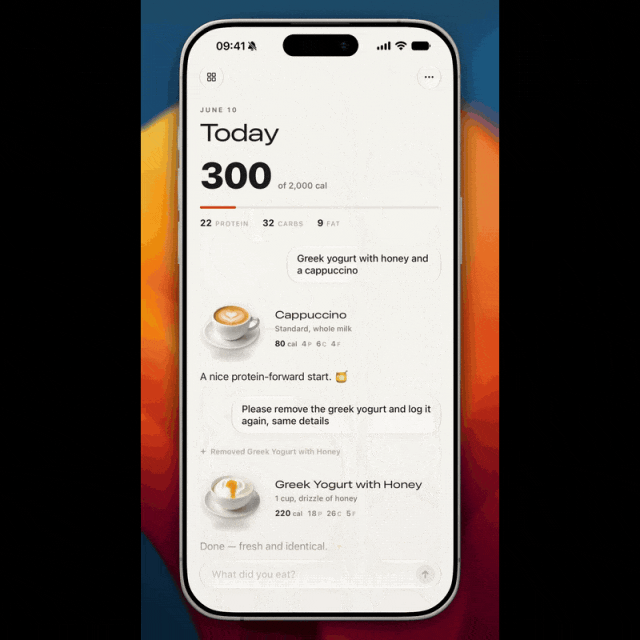
他在 X 上传播最广的一条帖子是 6 月 11 日发的,Claude Fable 5 发布当天的实测。做的是一个卡路里追踪 app,他本身健身和称重记录成瘾,什么都要称重录入,但市面上的追踪 app 全是丑的 React/Flutter slop,记一条要点好多下,他想要一个把所有吃的直接丢给 agent 的 iOS 应用。
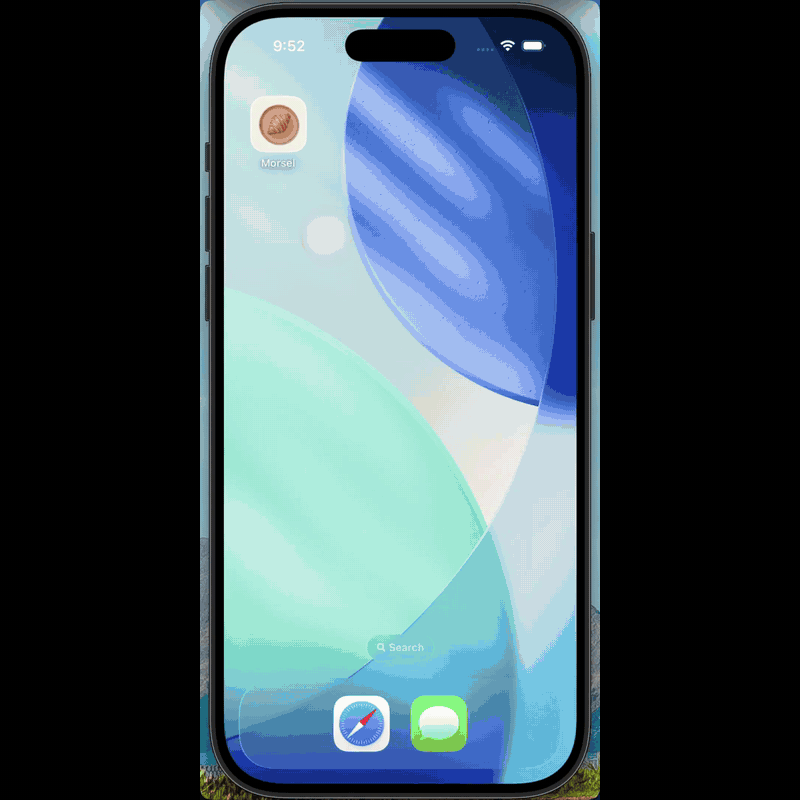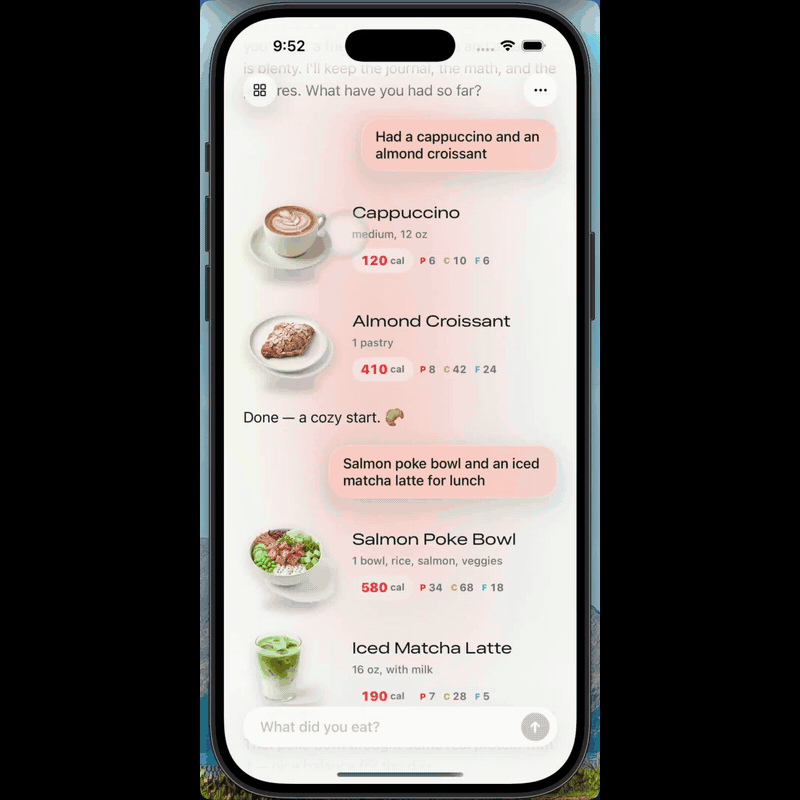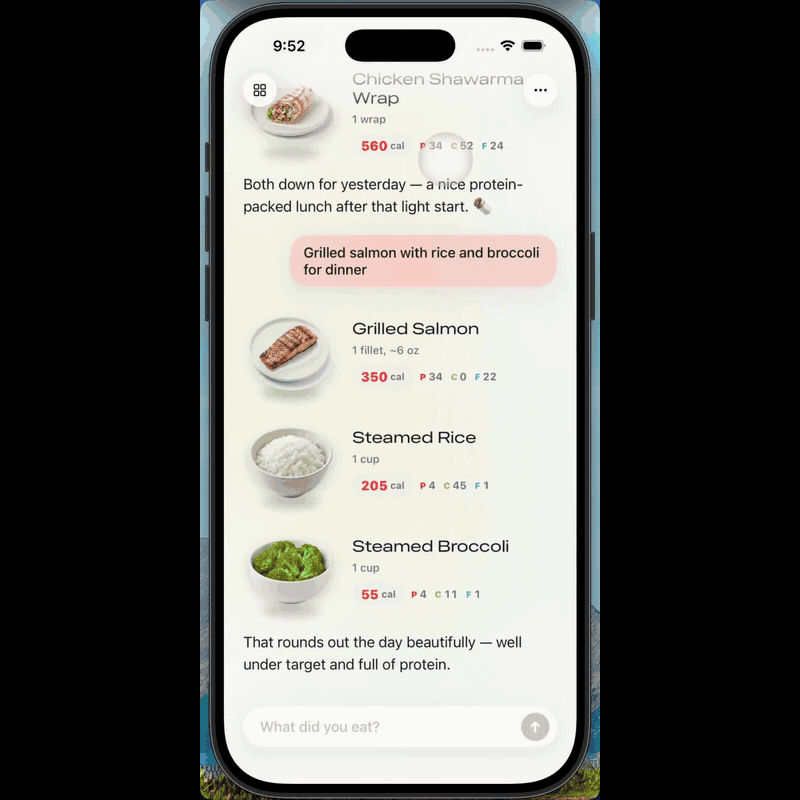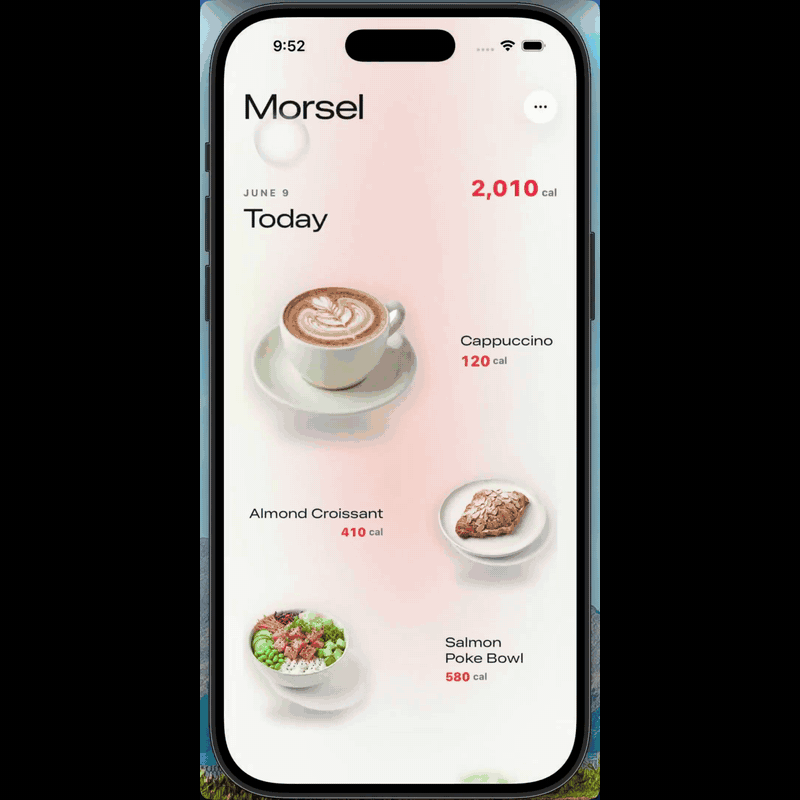
第一版 iOS App,一个 prompt 就生成出来了,而且不停留在 mock 层面,整个 app 从头到尾都用 AI 真做出来了。Nano Banana 做图片生成,配了自定义的 Metal shader 特效,agent 部分 Fable 搭建,包括人格设定、持久记忆、工具调用和 token 流式输出,连 Anthropic 的 prompt caching headers(提示词缓存请求头,配好之后重复的上下文按缓存价计费,能省不少 token 费用)都自己配好了,他说从没见过哪个模型把这一步做对。营养数据接的是 USDA 数据库,USDA 是美国农业部,它的公开食品数据库收录了海量食品的营养成分,是查营养数据的权威来源。
他贴了完整的 prompt 原文:
做一个 iOS 卡路里追踪 app。设计要超级干净,极简,design-forward,审美要到位。每个细节都要抠到极致,每个交互都要让人用起来觉得特别舒服,可以写自定义的 Metal shader,自定义 UI 组件,让每一处都流畅、独特、有惊喜感。
我的构想是做成一个统一的对话式体验。可以按天翻页,每一天就是一个和 agent 的对话线程。agent 要配好查营养数据库和我的历史记录的工具,能更新食物追踪。整体感觉要私人、友好。
食物条目要好看,能理解食物的内容并生成风格统一的精美图片,像影棚拍出来的质感。可以用 Gemini 或 OpenAI 这类小而快的生图模型,自己去查。我想能从对话线程缩放出来,用这些图片组成一条可滚动的时间线,每顿饭对应一张图,整体感觉像高端杂志画册。每个转场都要流畅,手势要有弹性,Apple 液态玻璃那种质感。用 shader 特效让转场看起来特别,有记忆点,让图片生成过程好看,甚至让聊天和 token 流式输出的体验也独特有趣。把交互流程想清楚,该展示的信息到位,屏幕不能乱,不能太技术化。
大部分事情按你自己的判断来,别来问我,除非真卡死了。按你的理解去发挥,给我看你的能力上限。端到端做完,能在模拟器里验证所有交互、转场和功能就去验证。需要什么资源和文档随时去网上找,别因为 iOS 默认方案好写就什么都用默认,往深了挖,每个细节都花心思。玩得开心。
先 git init,边做边 commit,写文档保持条理,别丢了上下文。代码要干净、模块化、好维护。
后来复盘这个 prompt 的写法:想清楚了自己要什么,只写真正在乎的部分,其余刻意留白让模型发挥。他明确要求对细节、转场和 "delight" 极致苛刻,要求模型自己在模拟器里验证所有交互。他还在 prompt 里给模型安排了一个工作习惯,边做边写文档、随手 commit。因为长任务跑久了,模型的对话上下文会被压缩,压缩之后前面的细节就记不全了,有文档在,模型回头翻一眼就能接上思路。 文档不仅要记做了什么改动,更要记下当初的意图,想把这个功能做成什么样,光记结果,之后再看就不知道为什么这么做了。
第一版的工具和设置也很简单,终端里跑 Claude Code,没有任何 skill 和插件,模型用 Claude Fable 5 开 xhigh effort。他用的是 \$200 的 20x 套餐,这个项目消耗了大约 5% 的周额度。从一个完全空的文件夹开始,Mac 上装了 Xcode 和 iOS SDK,但 Claude 实际没打开过 Xcode,全程用 xcodebuild、xcrun 这些命令行工具驱动编译和模拟器。
但第一版出来后,明显不像人设计的,浓浓的 AI 味,满屏是最常见的、那种没有个性的、通用款渐变底色,布局也乱,转场还带着跳帧。有人在评论里说这是 AI slop。
看到设计大佬用 Fable 生成的第一版设计,是不是感觉和我们平时用 AI 生成差不多,大家用 AI 做设计,是同一个起点。他把第一版设计分享出来后,也收到了很多反馈:像 AI slop,渐变太通用、布局别扭、转场有毛刺;另一大批人是追着他要 prompt 和工作流的细节。
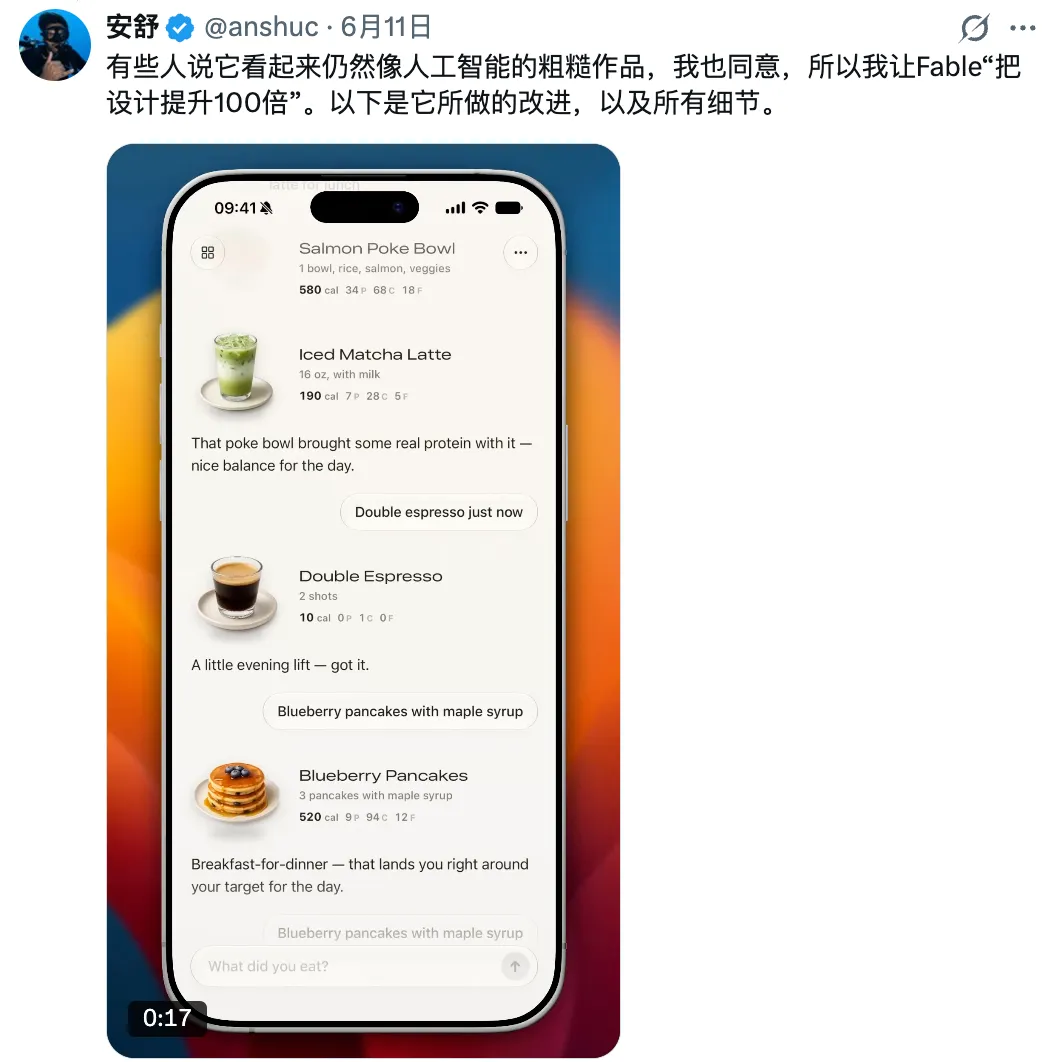
面对这些反馈,他直接把这些不满意的问题原封不动转述给 Claude,发了第二个 prompt,主攻去除 AI 味:
X 上有人抱怨这看着像 AI slop,嫌渐变太通用、有视觉毛刺、布局别扭。所以你要玩命证明他们错了。把设计 100x,每个像素完美,每个转场逐帧无瑕。
想办法仔细审计每一帧每个像素,做到顶级 1% 人类设计师水准,够格拿 Apple Design Award。
一切手段都可以上。想从头写自己的组件就写。为了这个写一个游戏引擎都行。写世上最狠的 Metal shader 也行。做到 Alan Dye 会亲自用的程度。不许出错。
中途他还发了两条 steering 插话指令:"换一个能正确处理透明度的模型。网格视图的交替布局有点俗,简化,更以图片为中心",以及 "卡片和网格之间瓷砖要流畅过渡,做漂亮的自定义视图和转场,别用无聊的 iOS 默认 view controller 转场"。
模型拿到这些指令之后,Agent 自己装了 idb 操作 iOS 模拟器模拟鼠标事件,用 ffmpeg 录屏抽帧逐帧检查动画和转场,发现卡顿和跳帧就自己写 Python 脚本做像素级的差异分析来修复,一直修到转场流畅、看不出是 AI 做的为止。这个过程一共 4 到 5 轮迭代,大约 1 到 1.5M token,跑了约 4 个小时,才跑出来,其中他实际参与不到 5 分钟。
两次实测的有效经验
给 Claude 搭一个像素级的美学自查循环
第二遍生成效果好了很多,因为模型不用再操心架构,全部注意力都放在美学上。"pixel-perfect,每个转场逐帧无瑕" 是最重要的一条指令,这条逼着模型去录屏、抽帧,一直修到流畅。让模型自我检查生成的设计,这个思路非常重要,贯穿了两个 prompt:第一个 prompt 里是 "在模拟器里验证所有交互",这是杠杆最大的一条;第二个 prompt 把验证标准升级到帧和像素级,模型就做出了录屏、抽帧、逐帧修的动作。 检查标准更细,模型就会把自己修的更细。
每次他在 X 上发 demo,评论区总会被问同一类问题,"为什么模型给你做出来的这么惊艳,我一上手就只有千篇一律的 slop,你是不是用了别的模型。" 他的回答一直一样:模型都一样,大多数人只用到了 AI 创造力的 1%。
被问得多了,他索性发了一篇客座长文《How to turn your AI into a world-class designer》,把方法论都分享了出来。框架上他参考了经典的 Double Diamond 双钻设计流程,按 AI agent 的工作方式把它改造成 Discover、Define、Deliver 三个阶段,共包含了 8 个技巧,整篇内容非常深刻。
next-token 预测
训练出了最保守的设计
LLM 的工作方式是 next-token 预测,每一步都依赖前面的序列,从上百万个训练样本和人类反馈评分里预测概率最高的下一个 token。这个训练方式教出来的模型挑的是所有人都满意的安全选项。具体到设计上,每遇到一个设计决策,用什么配色、元素怎么排、动效怎么做,模型给出的都是所有人偏好的最大公约数,是终极版的 design by committee (直译就委员会设计),大概意思是每个人的意见都照顾到,那么,生成出来的方案就没有个性了。
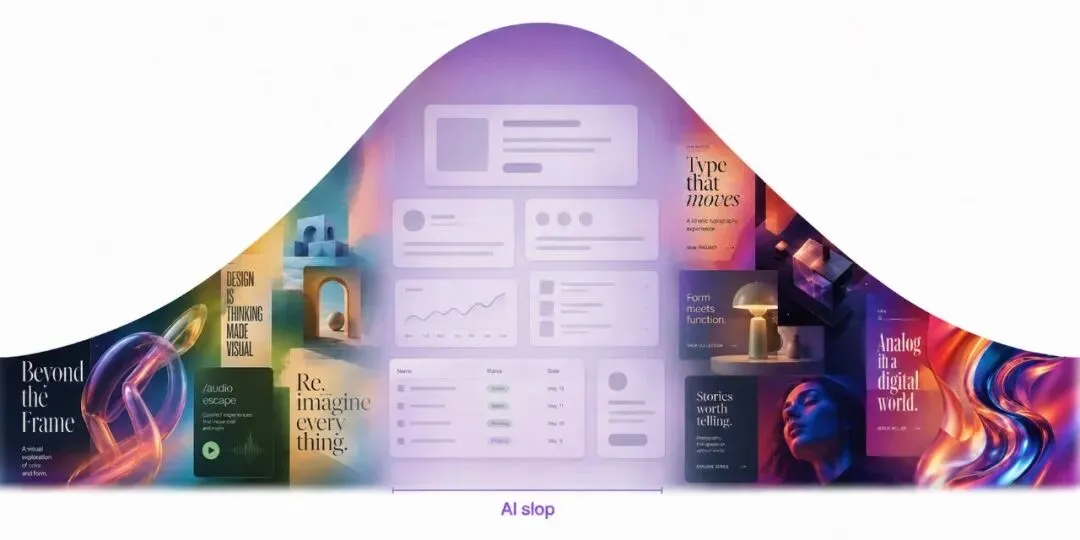
好设计恰恰相反,从感受出发,追求唤起用户的情绪反应,敢打破惯例,用出人意料的选择制造记忆点。LLM 每一步都在做概率最高的预测,好设计要的恰好是概率不那么高的那些选择。不过如果能让模型跳出最安全的预测,就能触及一大片多数人从来没碰过的创意空间。
Anshu 说这个体会来自他在 Apple 带领人类设计师的经历。团队早期也会反复回到自己熟悉的界面模式里,后来靠更严格的流程和新方法才学会往可能性的边缘去探索,把细节打磨到 Apple 的品质线。离开 Apple 之后,他一直在把同样的思路搬到 AI agent 上。这几年 AI agent 已经强到几个小时就能做完他团队过去要花几周的工作,而且只要引导的方法对,能做出跟市面上完全不重样的设计。下面的技巧,是这套引导方法的具体拆解。
用一串随机字符打破千篇一律
•Discover 阶段,先把探索面铺宽。给模型一个普通 prompt,比如 "给我做一个效率类 app 的落地页", Claude 出来的四个实例几乎一模一样,紫色渐变,文字在左,图在右,同一套结构。
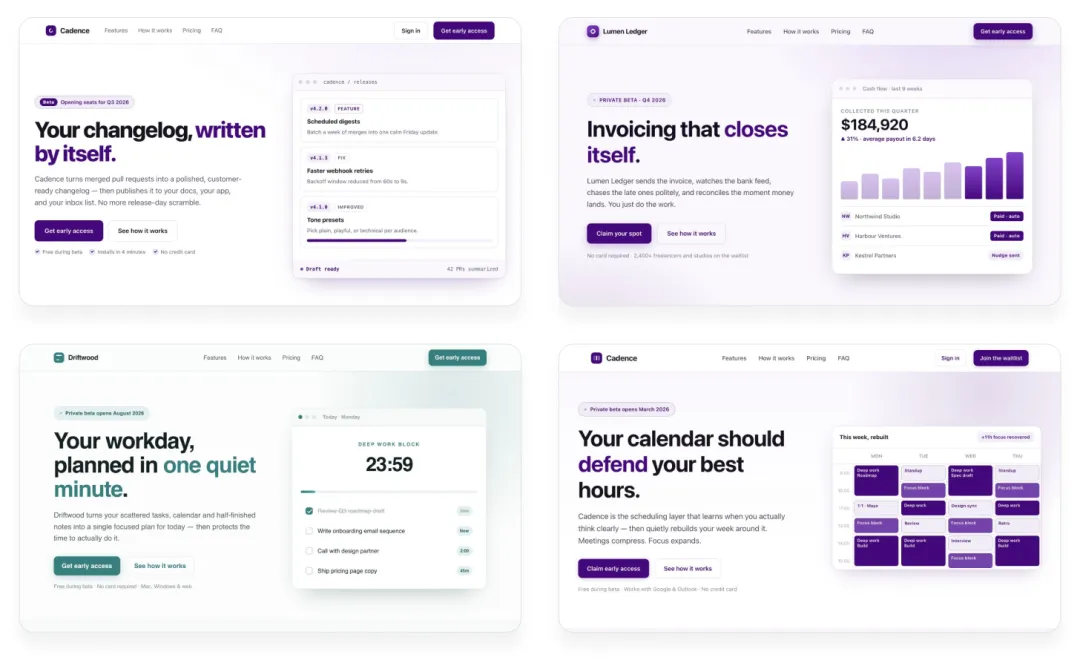
加一句 "Make every design decision completely at random"(每个设计决策都完全随机地做)也没用,配色变了但结构和比喻还是同一个套路,连陶艺意象都在反复出现。模型预测出来的 "随机" token 其实并不随机。Anshu 用 Sakana AI 发表的 String Seed of Thought (思想的种子字符串)技术,具体做法就是在 prompt 里多写四行流程:
给我做一个效率类 app 的落地页。按这个流程来:
先用 shell 脚本生成一长串随机的字母数字。
根据这串字符来定创意方向(配色、布局、排版等)。别只看表面,从里面找子规律、特殊数字,任何能给你灵感的点。
用你自己的判断把这个方向落地,做好看。
不要把这串字符显示在设计里,它只是你的灵感来源。
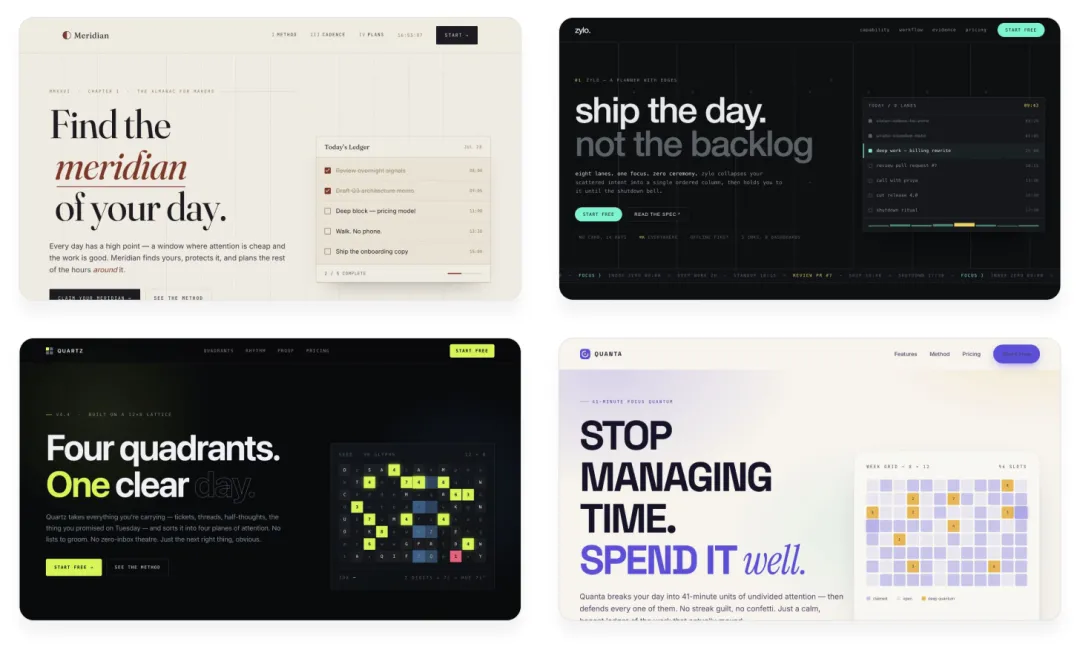
随机字符不用你自己想,模型自己跑脚本生成,每次运行出来的都不一样。这串字符本身没有任何含义,它的作用是给模型的设计决策换一个真随机的起点。不过这一招只解决 "每次生成都一个样" 的问题,配色、字体确实各不相同了,典型的 AI 味无法根除,这些结果仍然是典型的 AI 味结构样式:文字在左、CTA 按钮在下、顶部一条导航、图形在右,真正去 AI 味要靠后面几个技巧接着做。
让 prompt 更大胆更有野心
不写 "给我一个落地页",给模型一个明确的创意方向,让它每一步预测都有确定的目标可以靠拢,而不用从概率分布里去猜最安全的那个方向。Anshu 给了三个大胆 prompt 的例子:
给我做一个效率类 app 的落地页,大胆的像素风主题加惊艳的画面。每个区块都要像电子游戏的一帧画面,但整体仍然是一个能用的落地页。
给我做一个效率类 app 的落地页,放进一个等距视角的活的 3D 城市里,不同功能用不同的街区或建筑来表示。
给我做一个效率类 app 的落地页,极端不对称的布局,刺眼的配色和排版,让人不舒服的留白。打破所有规则但还得好看。
想出好点子本身是最难的部分。如果光拿 AI 生成的点子再喂回 AI,别人也能做一样的操作,很难做出独特的设计。用一套和 AI 一起找创意的三步流程:先让 AI 把方向铺宽,再按自己的口味收窄,最后让 AI 写出执行用的 prompt。
第一步,让 AI 列一堆粗略的创意方向:
我想给产品找一个大胆独特的设计语言,尽量多列想法,每个只给简短的描述,要广不要深。
第二步,从里面挑一个喜欢的方向,根据自己的审美偏好反复细化。比如他选了工业控制面板方向,给的反馈是这样的:
我想象的是有触感的东西。按钮按下去有咔哒感,声音好听。
一开始我脑子里是卡通拟物风,但我觉得俗,别走这个方向。
要有一套成体系的组件和小细节,把这个感觉落地但不要过头。
灰渐变会无聊,要更多质感。能不能保留控制面板的感觉同时加点颜色?
根据我的口味把这个方向打磨设计。
第三步,迭代到满意之后,让 AI 写出执行用的 prompt:
帮我写一个简洁的 prompt,让 AI agent 用它搭一个初版页面。
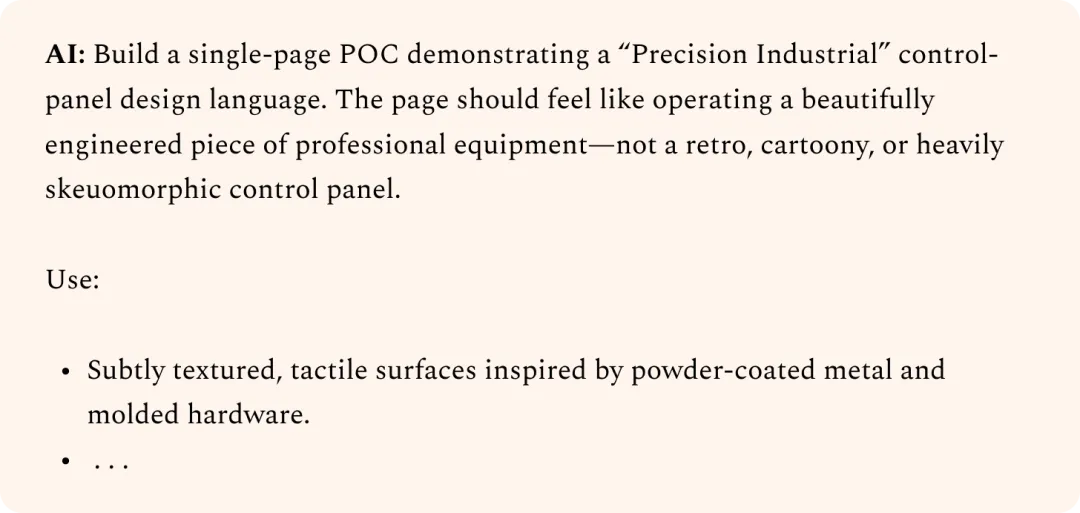
如果只是把 AI 生成的点子原样再喂回 AI,谁都能做同一套操作。但当你主动用自己的审美去引导方向,最终做出来的东西只有你才做得出来。不要怕尝试听起来不靠谱的点子,反而觉得 "这个不可能行" 的时候说明方向对了,试了不行就扔掉,但把 prompt 存下来,等新模型出来再跑一遍,这样能知道自己有没有跟上最新模型的能力边界。
用子 agent 建立正反馈循环
•从这里进入 Define 阶段,目标是让初稿有自己的个性和辨识度。让同一个 agent 看着自己写的代码说 "改好一点" 不太有用,它在审自己的代码和之前的决策过程,没办法跳出来看全局。解法是拆成两个角色:一个便宜、快的模型干活画设计,一个贵的强模型当设计评委。 评委只看截图,不看代码,不看实现细节,不看之前的迭代记录,每次在全新的上下文里只对着截图给反馈。
完整的设计评委 prompt:
我要你改进这个设计。用一个 Fable 5 子 agent 当设计评委来决定改什么。
每轮迭代按这个流程:
截一张当前设计的图。
在全新的上下文里只把截图发给评委,不给代码、实现细节和之前的迭代记录。
让它评估这个设计追求的审美方向,想象顶级设计工作室会怎么执行这个方向,列出最大的差距。
最后给一个 10 分制评分,衡量离工作室级质量线多远。
评委 prompt 里要写:整体结构构图和细节都要看;警惕过度、明显 AI 生成的模式并扣分;反馈要具体不要空泛;要大胆有主见不走安全路线。
评委独立打到 9 分以上工作才算完成。这条标准不要写进评委 prompt,保持客观。每轮用同一个评委 prompt。
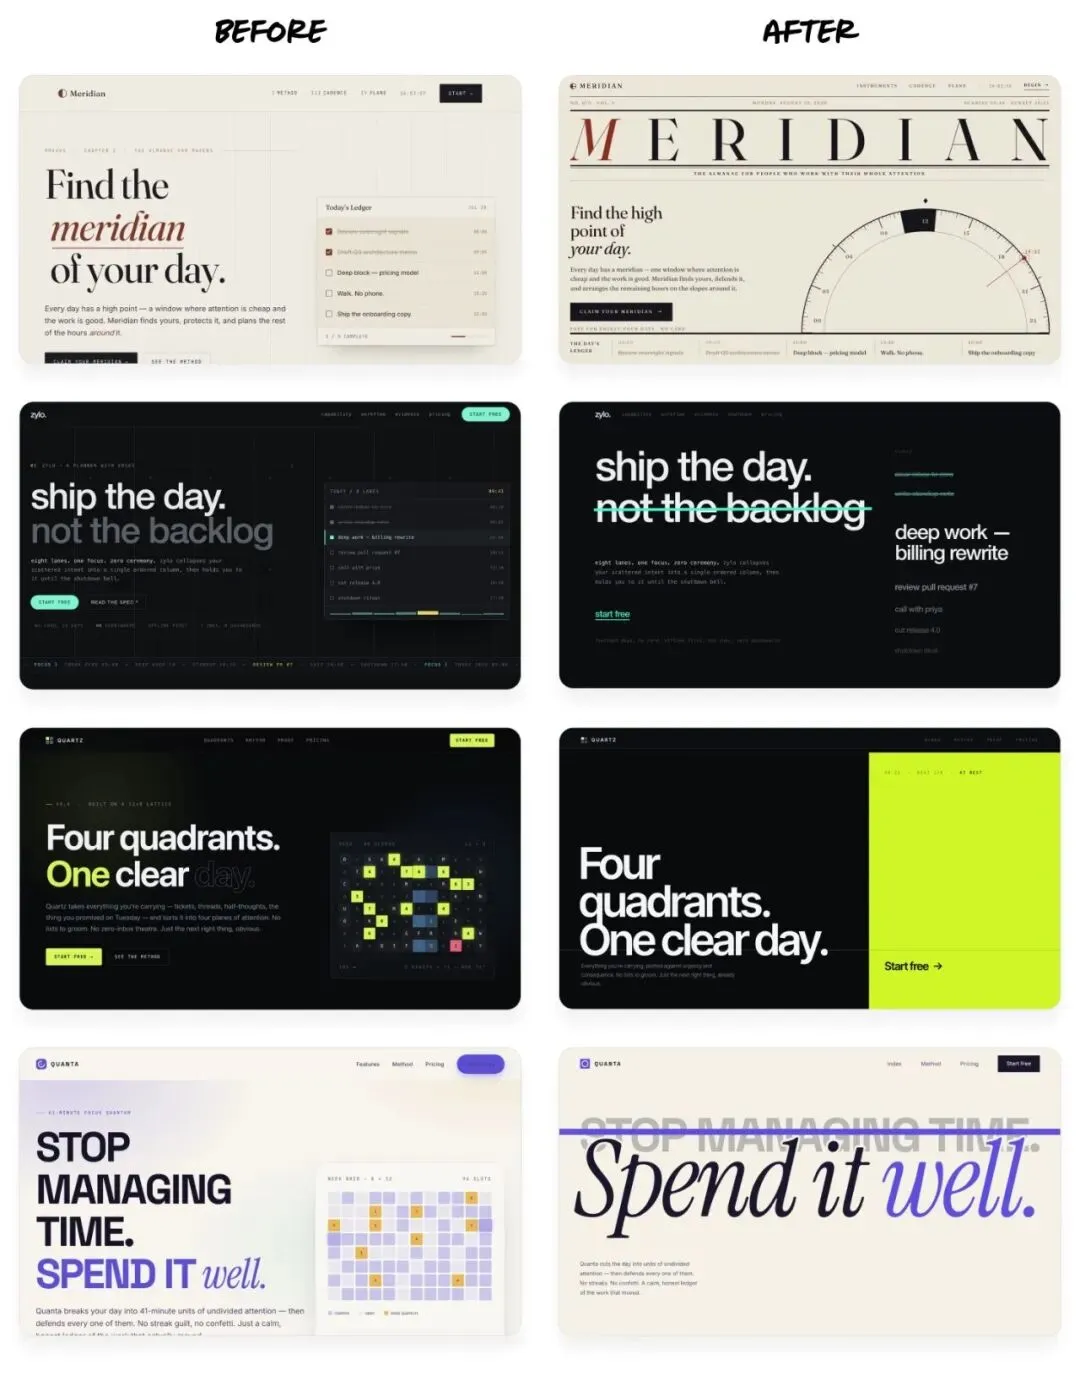
成本上,Fable 占总输出 token 不到 10%,因为它只需要看图说话给几条反馈。如果让 Fable 自己从头重新设计整个页面,成本至少翻倍,时间也更长。
还有几条实操建议:评委的标准要尽量清晰客观,"看着是否好看" 太主观,会导致每次结果差异很大;好一点的写法是给一个一致的评判框架和质量标杆;最好的做法是放几张真实的优秀设计截图让评委对着排名打分,这种指令具体且客观。可以提供参考图作为质量基线,但要说清楚是 moodboard 不是抄袭目标。
循环的退出条件要设得小心点,类似前面 prompt 里 "评委打到 9 分才算完成" 那条,标准定得太高评委永远不满意,agent 就会没完没了地改下去、白白烧 token,建议先只跑一两轮,看设计是不是在往好的方向收敛,再决定加不加轮数。模型分配上,评委用大模型,参数多通常审美判断和创意分布更广,执行用小模型,但小模型也不能太小,得能把设计方向执行到位。
用图像模型 生成更丰富的设计
AI 做设计的时候很少主动用图片,默认用代码画渐变、形状和基础图案,这些一看就是 AI 生成的。解法是直接告诉 agent 去用生图模型。
可以这么写 prompt:
这个设计有点素。用图像生成加点个性。考虑把 shader 或 3D 效果和图片结合,做更有趣的视觉。
生图用 OpenAI API key(只在本地用,别存进代码或产品里):sk-a1b2c3d4…
在浏览器里逐帧确认效果没问题。


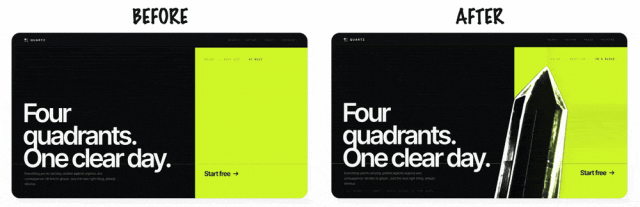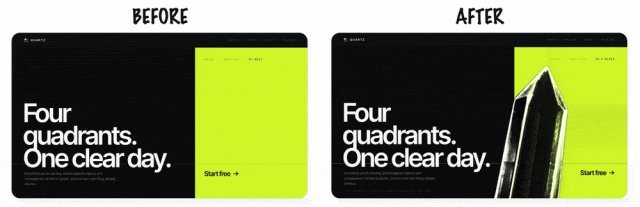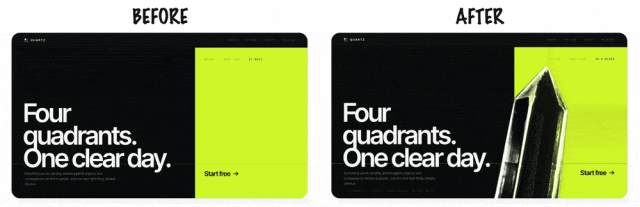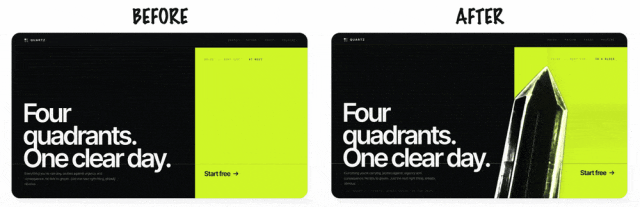
图片和特效能迅速给设计注入个性,让它不那么一眼 AI,因为这已经超出了表面功夫的层次。
用视频生成做更高级的动效
视频生成模型现在已经非常强了,但大多数人只拿它们做 UGC 广告或者玩梗。其实视频模型在日常设计里也能出奇效。这里介绍使用到的两种用法。
•做惊艳的动态图形。 生成一段循环片段,配纯色背景,然后用色键(类似绿幕)或视频 matting 模型去掉背景,叠到 UI 上当动效。这样能做出玻璃折射、焦散光、复杂物理运动这种代码很难实现的效果。
他拿之前的设计跑的 prompt:
能不能把页面上的图片换成一段更有意思的循环视频?让水晶碎裂开、缓慢旋转。要有很棒的玻璃质感,折射页面背景、投下光影。
为了折射效果可信,先在页面背景色上渲染视频(把折射烘焙进去),再用视频抠像模型去掉背景。
用这把 fal.ai 的 API key:sk-a1b2c3d4…
自己去找合适的新款视频生成和背景去除模型。

效果比纯代码丰富得多:玻璃折射、焦散反射、复杂的物理运动,都是写代码很难做到的。
•做流畅的状态转场。 很多视频模型能在两张关键帧图片之间生成过渡视频,把生成的片段绑定到用户的滚动或滑动手势上,就能做出交互式转场。
他用一个 prompt 做了一个行李箱的滚动交互 demo:
做一个行李箱的 demo 页,用视频模型在几个屏幕之间做可交互的转场。每屏行李箱一个状态,竖直方向的运动要适合滚动:
一开始行李箱悬浮在高空。
然后落地弹开。
最后里面的物品从上方整齐落进去。
先用你的生图 skill 生成初始帧,再生成从这一帧动到下一状态的视频片段。用上一段的末帧接着生成下一段保证无缝,用户滚动时逐段播放。
用这把 fal.ai key:sk-a1b2c3d4…
选物理和一致性强的视频模型,比如 Seedance 2.5。
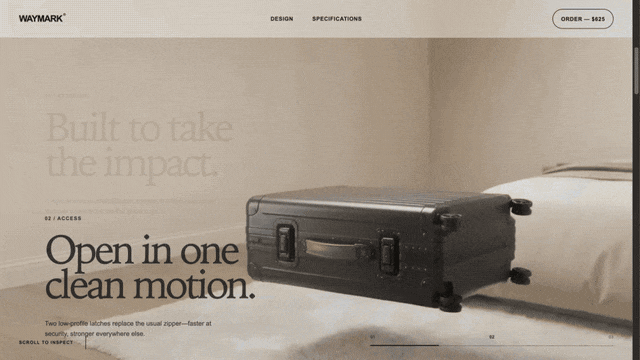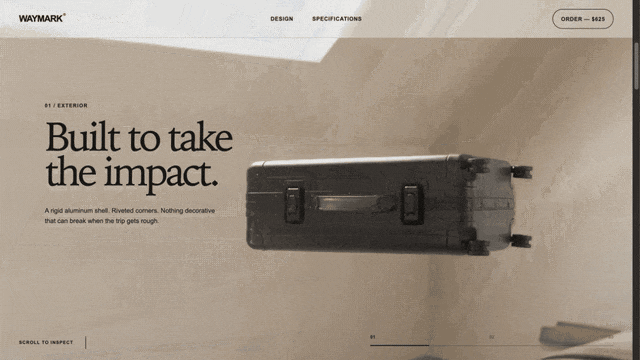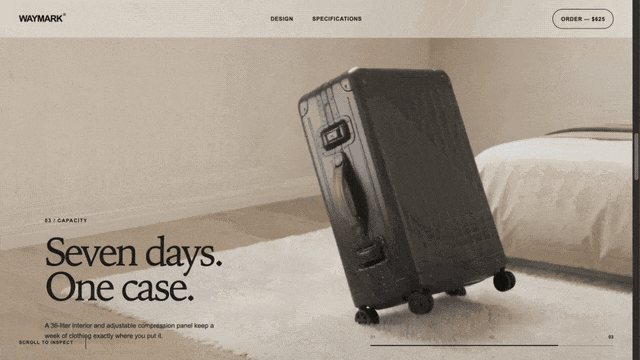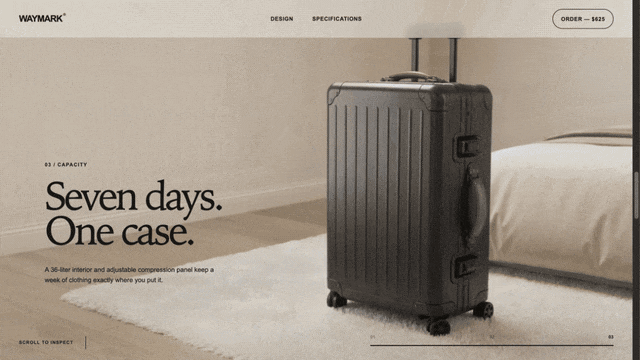
转场跟着用户的滚动走,交互感很强,让人忍不住继续往下翻。
删掉不增加价值的元素
•来到 Deliver 阶段,把独特的设计打磨成能交付的成品。 AI 做设计只会做加法,几乎不会主动做减法,页面上什么都要解释一遍,堆一堆没有实际用途的视觉元素,这是 AI 生成设计最明显的问题。克制的设计反而显得高级和有品味。
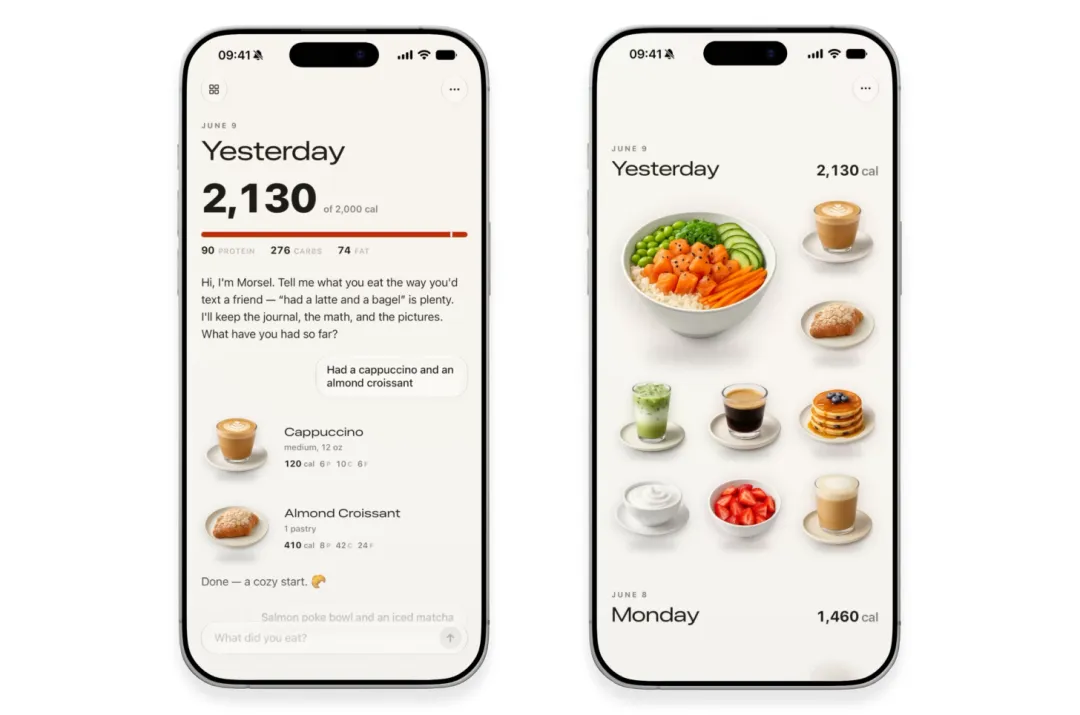
用他的卡路里追踪 app 举例。初版他在 prompt 里已经明确要求 "clean, minimalist design",结果不算差,但有很多不加分的成分:背景和进度条上有粉色发光效果,文字上随机带着颜色和高亮,食物列表用了大量标签和留白但图片已经传达了这些信息,自定义的按钮和输入框反而没有 iOS 原生组件好看。
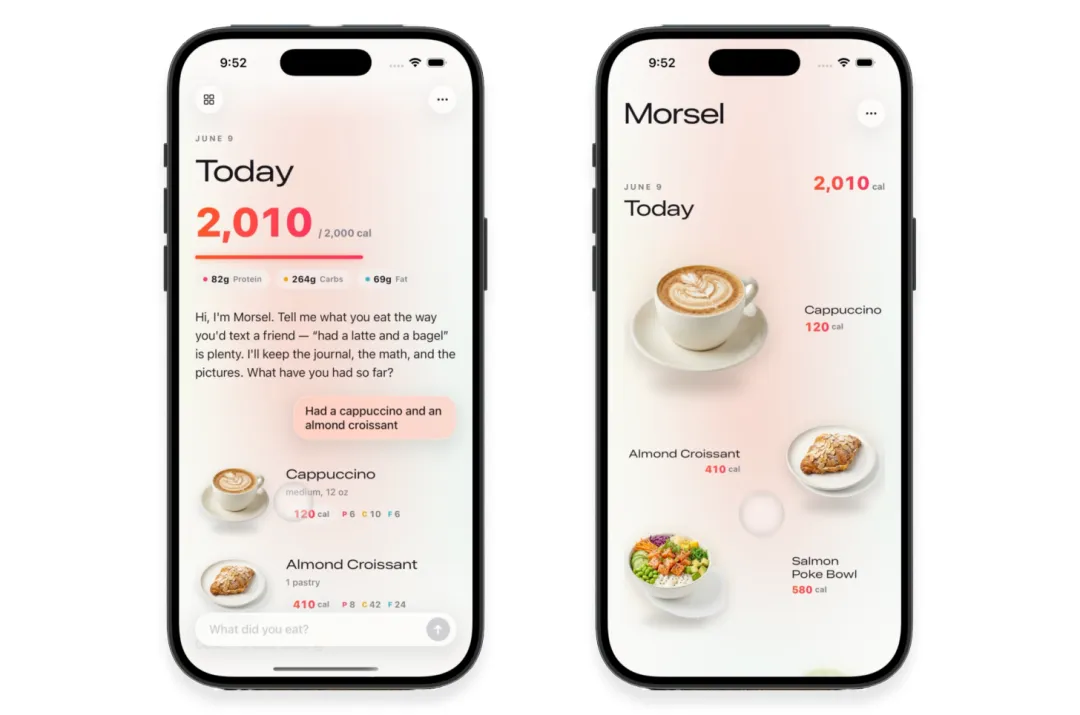
他给 Claude 的指令是三条:
把布局简化成以图片为中心的网格。
去掉渐变、发光和不必要的容器。
瞄准真正的极简,要有 Apple 原生的质感。
改完之后,设计就有了自己的态度,让视觉元素更突出,文字更小更紧凑,多余的颜色和渐变没了。经常是放的越少,用户越能把注意力集中在重要的内容上。
今天的 AI 模型不会自己做这些选择,做减法等于删代码、推翻之前的决策,模型的训练里不鼓励冒这种险,需要人来看一遍设计,问自己屏幕上什么是真正需要在那里的。
其他还有 2 个技巧是 "去掉 AI 痕迹"、"文案亲手重写",也是最难的部分,残留的 AI 痕迹,得设计师本人一处处挑出来改掉;文案最讲语感,也一句句亲手重写。
设计师,还是很有必要的。
本文素材与配图来自 Anshu Chimala 的 X 帖子(2026-06-11)与 Lenny's Newsletter 客座长文《How to turn your AI into a world-class designer》(2026-09-01),封面取自该文的创造力分布示意图。
