
原帖链接
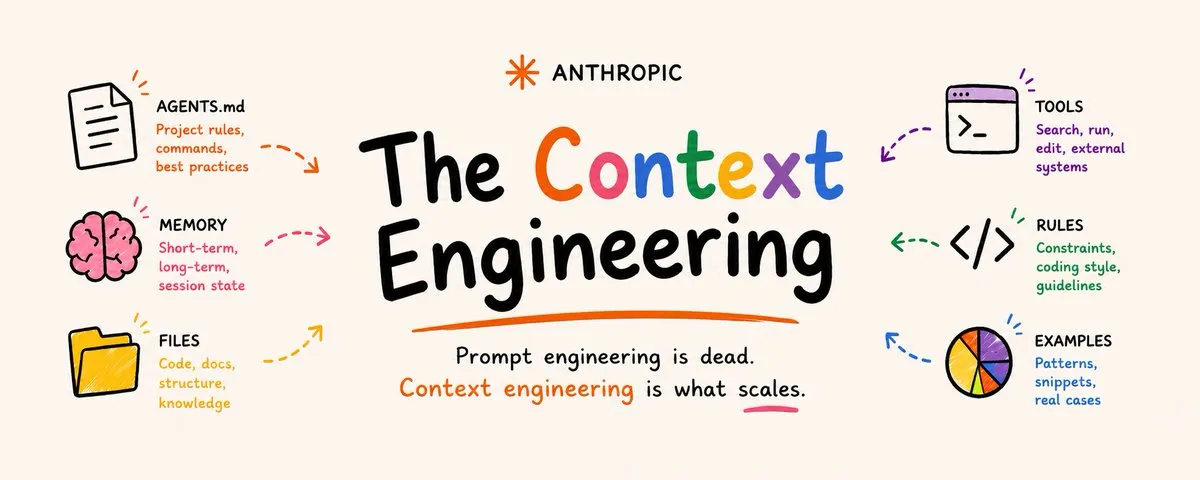
Anthropic 的工程师如今每天合入的代码量,是一年前的 8 倍。模型没有变,硬件没有变,团队规模也没有变。改变的是 Claude 在开始工作前能够看到的内容。
大多数开发者把时间花在写出更好的提示词上;Anthropic 的工程师则把时间花在构建更好的上下文上。这一转变,正是 8 倍差距的全部来源。
Anthropic 自己的研究也直言不讳:AI 智能体的质量,与其说取决于模型,不如说取决于你提供的上下文。Claude 只能看到上下文窗口中的内容,窗口之外的一切对它而言都不存在。这意味着,严肃的 AI 工程师真正要做的并不是编写巧妙的提示词,而是在 Claude 采取任何行动之前,确保它拥有恰好需要的信息。
这套方法如今有了名字:上下文工程。它正在取代提示词工程,就像两年前提示词工程取代手工脚本那样。
收藏本文并关注我。我是 Noisy,一名有 4 年经验的开发者。我构建 AI 系统和自动化流水线,并探索将技术转化为真实收入的方法。
为什么你的 AI 智能体会给出糟糕答案
AI 智能体失败时,大多数人会责怪模型:改错了文件、做了错误假设、犯下任何开发者都能发现的明显错误。
模型几乎从来不是问题所在。问题在于上下文缺失。
大多数人交给 Claude 的内容 | 一条提示词
Claude 实际需要的内容 | 知识、记忆、文件、规则、示例、工具、状态、先前操作提示词只是一句话;上下文则是 Claude 运行于其中的整个信息环境。一个智能体能否正常工作,差异几乎总在于这个环境中有什么,而不是运行的是哪一个模型。
Anthropic 的表述是:LLM 只能看到上下文窗口中的内容。上下文是 AI 的操作系统。把它构建错了,无论模型能力多强,一切都无法正常运作。
上下文究竟是什么
大多数人认为,上下文就是在问题前粘贴的一段文字。这只是其中一层。经过恰当工程化的上下文由七个相互配合的部分组成。
记忆       | 智能体从过去会话中知道的内容
指令       | 规则、约束和编码风格
示例       | 优质输出实际应是什么样子
文件       | 相关代码、文档和架构信息
先前操作   | 智能体已经尝试过什么
工具结果   | 搜索和函数返回了什么
状态 | 任务当前所处的阶段Claude 每采取一次行动,上下文都会增长:工具结果返回、新文件被读取、状态得到更新。Claude 看到新上下文后决定下一步行动。这个循环才是智能体真正的运行机制,不是提示词,也不是模型,而是每一步都在演进的上下文。
用户请求
↓
由七个部分构建上下文
↓
Claude 决定行动
↓
工具执行
↓
结果加入上下文
↓
Claude 看到新上下文
↓
下一步行动
↓
重复直至完成糟糕的智能体会在第二步打断这个循环:上下文不完整,于是 Claude 开始假设;假设错误,输出也就错误。大多数开发者会通过重写提示词来修复它,而真正的修复方法是正确构建上下文。
三层上下文栈
Anthropic 建议将上下文理解为三个层次。每一层承担不同职责,并在智能体工作的不同阶段加载。
全局上下文 | 始终存在,适用于每次会话
项目上下文 | 在项目启动时加载
任务上下文 | 为特定任务加载全局上下文是永久层:身份、核心规则、编码风格,以及智能体绝不能做的事。它不会随会话变化,也无需反复解释。
全局上下文包含:
- 智能体身份与角色
- 编码标准与风格规则
- 安全约束
- 绝不能触碰或修改的内容
- 处理不确定性的方式项目上下文是知识层,包含 Claude 理解特定代码库所需的一切:架构、所采用的模式、曾做出的决策及其原因,以及此前出过的问题。
项目上下文包含:
- README 和架构概览
- 带有项目专属规则的 AGENTS.md
- 文件夹结构与命名约定
- 测试要求与模式
- 关键依赖项及其选型原因任务上下文是执行层,包含当前正在处理的具体文件、当前工单、直接目标,以及仅适用于这项任务的约束。
任务上下文包含:
- 当前文件与相关文件
- 本次会话的具体目标
- 近期变更及其结果
- 当前测试结果
- 该任务专有的约束大多数开发者只向 Claude 提供任务上下文。智能体每次会话开始时都没有全局或项目上下文,只能猜测它不了解的部分;错误正是从这些猜测中产生的。
AGENTS.md:改变一切的文件
https://docs.claude.com/en/docs/claude-code/memory
这是任何严肃 Claude Code 配置中最重要的单个文件。研究人员已将 AGENTS.md 视为 AI 编码智能体上下文的新标准;它之所以已出现在数千个生产仓库中,正是因为它有效。
AGENTS.md 是项目上下文长期驻留的地方。Claude 会在每次会话开始时自动读取它,此后就不必再被重复告知这些信息。
# AGENTS.md

## 架构
使用 Next.js 前端和 Express 后端的单体仓库。
所有 API 路由都位于 /api。绝不要直接修改 /legacy。

## 编码规则
绝不使用 axios,一律使用 fetch。
每个组件均使用 TypeScript、Tailwind 和 Server Actions。
除页面外,不使用默认导出。

## 测试
单元测试使用 Vitest,端到端测试使用 Playwright。
每次提交前运行 npm test。
绝不禁用失败的测试:修复它,或上报处理。

## Git
绝不直接提交到 main。
始终创建带有清晰描述的 PR。
每个 PR 都关联一张 Linear 工单。

## 禁止触碰
src/payments/:任何变更都需要人工批准。
src/auth/tokens/:需要进行安全审查。
.env 文件:绝不读取或修改。这个文件中的每一条规则,都是 Claude 以后不会再犯的一次错误。项目运行得越久,AGENTS.md 就越具体、越有价值:它积累了智能体犯过的每个错误,以及团队建立的每条约定。
驱动智能体的上下文栈
优秀的 AI 工程师不会以写一条提示词开始任务。他们会构建上下文栈,即在 Claude 采取任何行动前加载的一组结构化信息。
第 1 步 | 加载全局上下文:身份、规则、风格
第 2 步 | 加载项目上下文:AGENTS.md、架构、文档
第 3 步 | 检索与任务相关的历史记忆
第 4 步 | 加载本任务相关文件
第 5 步 | 加载当前状态:测试结果、近期变更
第 6 步 | 用清晰的成功标准定义任务目标
第 7 步 | Claude 带着完整信息采取行动将经过良好上下文工程的智能体与默认情况对比:
糟糕的智能体:
问题 → Claude → 答案
Claude 会猜测一切自己不了解的内容

良好的智能体:
问题
↓ 检索文档
↓ 检索记忆
↓ 读取 AGENTS.md
↓ 读取相关文件
↓ 检查当前状态
↓ Claude
↓ 基于完整信息构建答案第二个智能体并不更聪明,它只是掌握了更多信息。模型相同,上下文不同。
记忆:跨会话留存的上下文
Anthropic 明确区分了为上下文供给信息的不同记忆类型。大多数智能体只有一种,即当前会话,因此每次会话都要从零开始。
长期记忆 | 在所有过去会话中学到的一切
短期记忆 | 当前对话中此前发生的事
工作记忆 | 此刻位于上下文窗口中的内容长期记忆让智能体的价值能随时间复利增长。每次会话都会为它增加内容,每次错误都会被记录,每个成功模式都会被存储。一个在某代码库中运行了六个月的智能体,了解的项目细节是任何提示词都无法复刻的。
实际落地方式是一份记忆文件:它是会话之外的 Markdown 文档,智能体会在每次会话开始时读取,并在结束时更新。
# 项目记忆

## 架构决策
- 选择 Supabase 而非 Firebase:实时性不那么关键,但需要 SQL 查询。
- 从 REST 迁移至 tRPC:实现全栈类型安全,2026 年 6 月。

## 已验证有效的方法
- 在重构前提高测试覆盖率,可以避免回归。
- 将大型 PR 拆为带功能开关的发布,可缩短评审时间。

## 曾经无效的方法
- 自动生成迁移:模式漂移导致生产事故。
- 并行智能体写入同一文件:始终使用 worktree。

## 反复出现的模式
- 认证问题几乎总能追溯到中间件顺序。
- 性能问题通常始于数据库查询层。每次会话都会读取这份文件,每次会话也都会更新它。智能体不会遗忘。
MCP:来自各处的上下文
上下文并不只来自仓库中的文件。一个生产级智能体需要来自团队所使用的每个系统的上下文:问题跟踪器、错误监控、文档、数据库和沟通工具。
Model Context Protocol(MCP)让 Claude 能从外部系统拉取上下文,而无需为每个系统都编写定制集成。
文件系统       | 本地文件、配置和代码库
GitHub         | 问题、PR、提交历史和 CI 结果
Linear / Jira  | 工单、优先级和项目状态
Slack          | 已做出的决策与讨论上下文
Postgres       | 实时数据、模式和查询结果
Google Drive   | 文档、需求说明和会议记录
Sentry | 线上错误、发生频率和受影响用户配置了 MCP 的智能体看到的不只是代码。它还能看到说明为什么需要该功能的工单、决定架构的 Slack 讨论、展示用户如何触发缺陷的 Sentry 错误,以及修复时必须遵守的数据库模式。
这才是完整上下文:Claude 做出正确决策所需的一切信息,不需要猜测。
上下文工程工作流
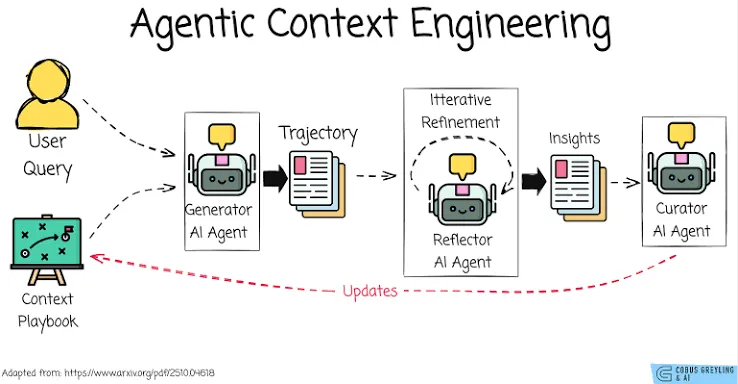
一项经过恰当上下文工程处理的任务,从开始到结束会是这个样子。
不要只给:
实现导出功能。而是给 Claude:
目标
导出功能正在阻碍免费用户转化为付费用户。
参见信号:/signals/export-too-hidden.md

相关文件
src/features/export/:当前实现
src/components/ui/Button.md:需要遵循的按钮模式
tests/features/export.test.ts:现有测试覆盖

架构约束
阅读 AGENTS.md 的“导出规则”章节。
绝不直接修改计费集成。

成功标准
所有现有测试均通过。
新增测试覆盖三种导出格式。
创建 PR,并关联 Linear 工单 EXP-47。
不修改 src/payments/。任务相同,上下文却完全不同。输出不是渐进式变好,而是发生了质的变化,因为 Claude 基于完整信息做决策,而不是进行看似聪明的猜测。
这个周末可以完成的实际配置
第 1 天:构建三层上下文栈。写一份包含身份和核心规则的全局上下文文件;创建包含项目架构、编码约定和禁止触碰清单的 AGENTS.md;设置一份会在会话开始时加载、会话结束时更新的记忆文件。
第 2 天:通过 MCP 连接外部上下文。安装 GitHub 连接器,让 Claude 能看到问题跟踪器和 PR 历史;安装文件系统连接器,使其高效导航代码库;若团队用 Slack 或 Linear 做决策,也将它们接入。
第 3 天:测试差异。分别用旧的“仅提示词”方式和完整上下文栈运行同一项任务。产出差距正是 8 倍生产力的来源。
已经发生的转变
提示词工程关注的是找到正确的措辞;上下文工程关注的是构建正确的信息环境。
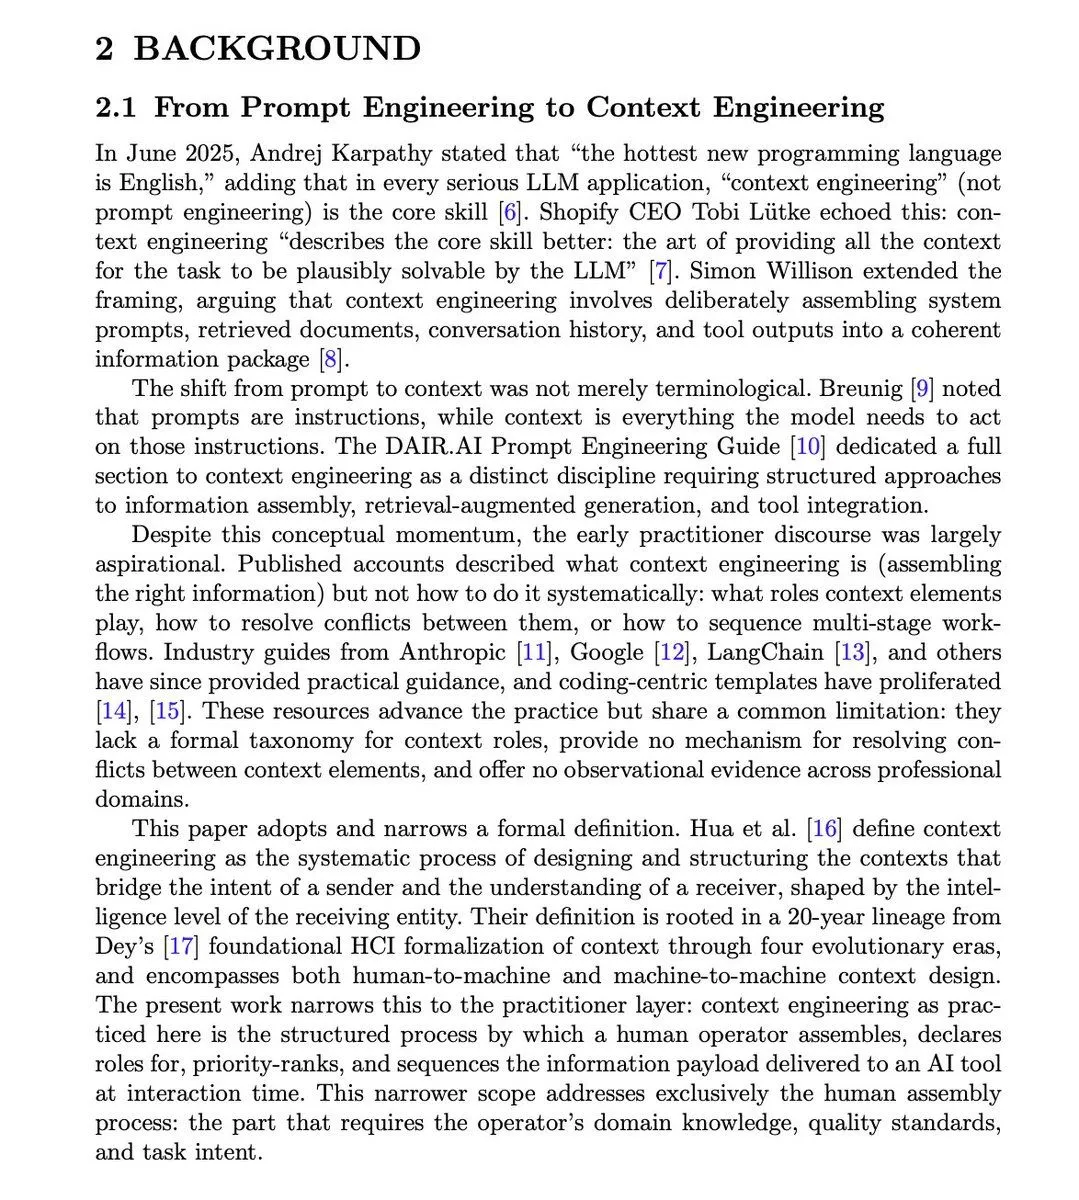
Anthropic 最优秀的 AI 工程师不会花时间打磨巧妙的提示词,而是确保 Claude 在采取任何行动前,拥有恰好需要的知识、记忆、文件、规则和状态。提示词只占工作量的最后 1%,上下文才是其余 99%。
拥有完美提示词却上下文匮乏的智能体,会犯下看似聪明的错误;提示词普通但上下文完整的智能体,会做出正确决策。模型相同,信息环境不同。
上下文是 AI 的操作系统。正确构建它,8 倍的产出差距就不再只是 Anthropic 发生的事,也会发生在你的代码库中。
大多数开发者会继续反复改写提示词,并疑惑结果为何没有改善;少数人会用一个周末构建完善的上下文栈,此后再也回不去了。
你塑造自己的人生,所以请选择正确的道路。
