
本篇目标:搞懂知识库与 RAG 的原理(为什么 AI 能"记住"你所有的资料),完成 ima 知识库与 WorkBuddy 的连接授权,学会批量导入资料(本地文件/公众号文章/网页/聊天记录),掌握检索提问技巧,搭起"读取 → 处理 → 存回"的完整闭环,并了解共享知识库与团队协作。
一句话定义:知识库 = AI 的外挂硬盘 + 参考资料架——AI 回答不再凭感觉,而是从你的资料里找答案。
1 为什么需要知识库:AI 不认识你的资料
1.1 一个扎心的事实
你问 WorkBuddy:"我们公司 Q2 的销售复盘重点是什么?"它答不上来——哪怕复盘报告就躺在你桌面。AI 模型的知识来自训练数据,它不认识你电脑里的文件、你公司的规范、你积累的笔记。
知识库解决的就是这个问题:把你的资料集中"喂"进一个 AI 能检索的地方,之后每次提问,AI 先去翻你的资料,再结合资料回答——答案来自你的文档,不是凭空编造。
用一句话说:知识库的核心价值不是存储,是复用——资料放进来的目的,是以后能被问出来、被引用、被再加工。多数人知识库搭失败的原因恰恰不是工具不够高级,而是资料进入后缺乏后续处理:只收藏、不整理、不复用,最终沦为"垃圾堆搬进新房子"。
1.2 背后的原理:RAG(三分钟看懂,不用懂技术)
RAG(Retrieval-Augmented Generation,检索增强生成)是这一切背后的核心技术。用大白话讲就是:让 AI 在回答问题之前,先去翻阅你指定的参考资料,再结合资料作答。
它分三步工作:
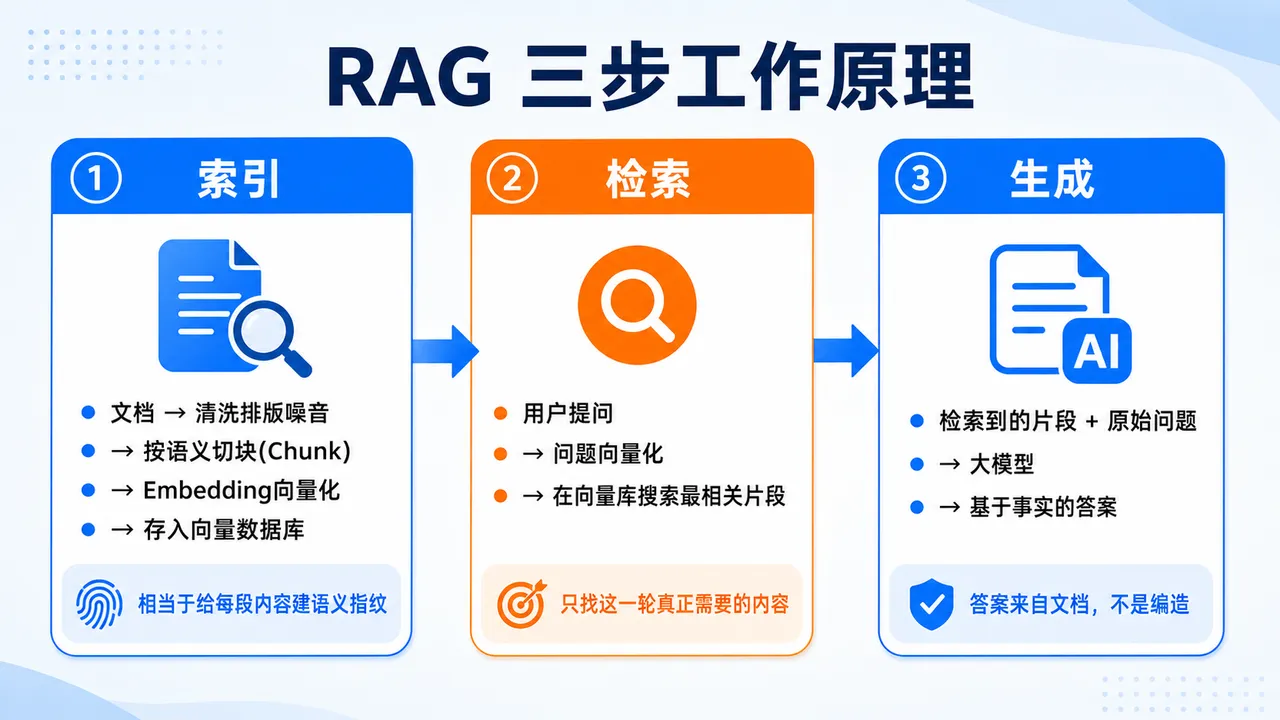
- 索引:你把资料"放好"——文档被清洗掉排版噪音,按语义切成若干 Chunk(知识块),再通过 Embedding 模型把每块内容转成高维向量,连同原文、路径存入向量数据库。相当于给每段内容建了一张"语义指纹";
- 检索:你提问时,问题也被转成向量,系统在向量库里搜索语义最相关的知识片段;
- 生成:把检索到的片段与原始问题一起送给大模型,生成基于事实的答案。
一个例子:ima 里存了几十篇产品资料,你问"我们产品相对竞品 A 在文档协作方面有哪些优势"——系统不会把几十篇文章全塞给模型,而是先检索出最相关的几个片段,只把这些交给模型分析。
RAG 的优势:低成本、高灵活性、数据实时更新(新增资料即时可查)、无需重新训练模型。对普通用户来说不用记住 Chunk、Embedding 这些术语——只需记住:RAG 做的事,就是从大量资料中找到"这一轮真正需要给模型看的内容"。
它也有局限:不会主动帮你"理解"和重组知识;跨文档的隐含逻辑、前后矛盾的信息,朴素 RAG 往往无能为力;向量召回在专业领域可能不准。所以知识库整理(4 节)和人工判断(5 节)仍然必要。
1.3 两大方案:本地文件夹 vs ima 云端知识库
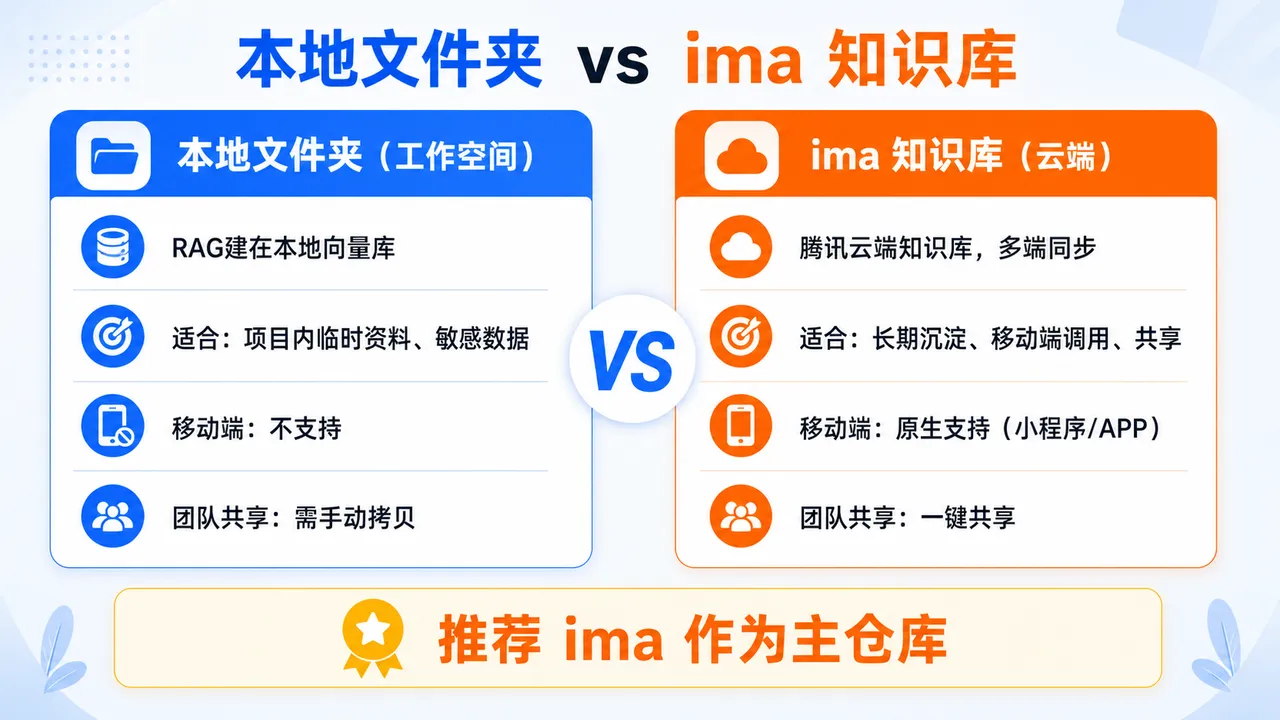
WorkBuddy 有两类"外挂硬盘",各有分工:
| 维度 | 本地文件夹(工作空间) | ima 知识库(云端) |
|---|---|---|
| 本质 | RAG 直接建在本地向量库 | 腾讯云端知识库,多端同步 |
| 适合 | 项目内临时资料、敏感数据 | 长期沉淀、移动端调用、共享 |
| 移动端 | 不支持 | 原生支持(小程序/APP) |
| 团队共享 | 需手动拷贝 | 一键共享 |
为什么推荐 ima 作为主仓库:原有 Obsidian 等个人知识库工具存在数据同步配置门槛高、移动端难以随时调用 AI 协作的痛点;ima 支持多端数据同步,设有个人、共享、订阅三类知识库模块,还能订阅公开优质知识库内容。而 WorkBuddy 作为 Agent 平台负责执行——两者搭配是"ima 存储索引资料、WorkBuddy 预处理整理、人工最终判断"的分工流程。
本篇以 ima 云端方案为主线(它覆盖本地方案的全部能力且可多端使用),本地工作空间已在第三篇讲过。
2 从零连接:五分钟打通 WorkBuddy 与 ima
2.1 前置准备
- 安装登录 ima:浏览器打开 ima.qq.com 下载客户端,微信扫码登录;手机端在微信搜索「IMA 知识库」小程序,用同一个微信登录;
- ⚠️ 最重要的一条:ima 和 WorkBuddy 必须用同一个微信账号登录,否则知识库读不到——这是新手最常见的翻车点;
- WorkBuddy 桌面端保持已登录状态。
2.2 连接授权(核心步骤)
- 打开 WorkBuddy 客户端,点击左侧边栏的「更多」进入;
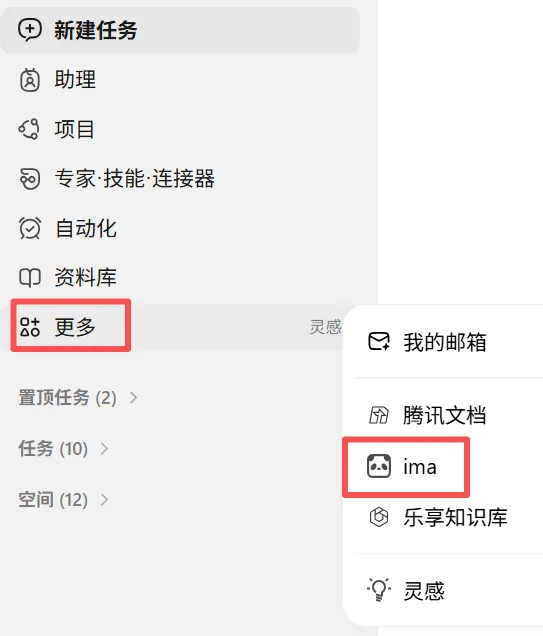
- 选择「ima 知识库」,点击「立即前往授权」;
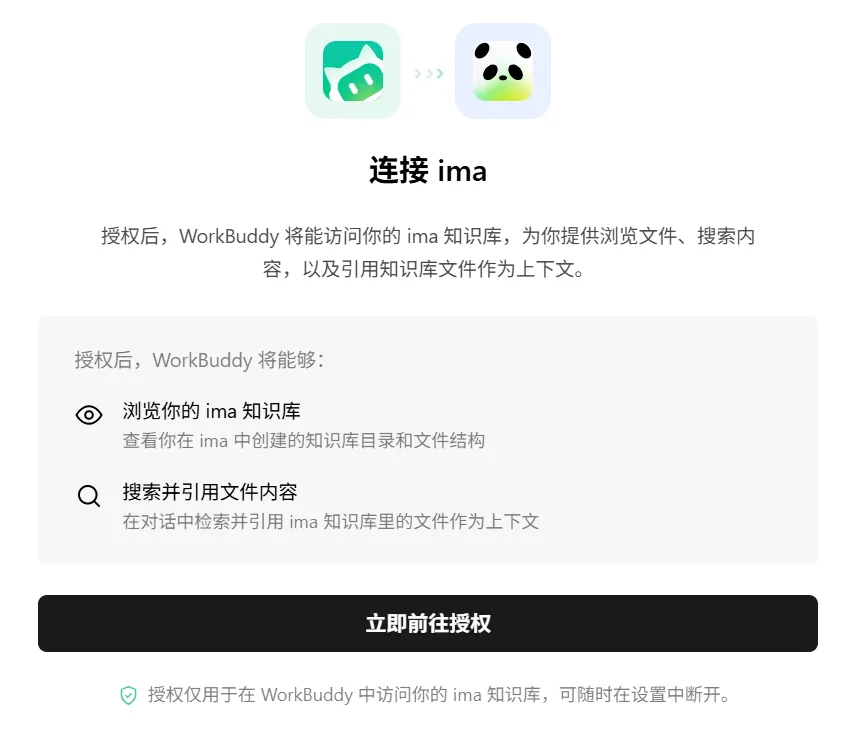
- 弹出微信扫码界面,扫码登录 ima 知识库,点击「确认授权」。
授权完成后,WorkBuddy 就能查看你的知识库列表、浏览和搜索知识库资料、将知识库文件添加到任务、或将文件保存到 ima 知识库。
2.3 验证连接
在 WorkBuddy 对话框输入:
帮我列出 ima 知识库中所有的知识库名称
返回了你的知识库列表,说明连接成功。如果报错或列表为空,第一件事检查两边登录的是不是同一个微信号。
2.4 在任务中引用知识库的三种方式
- @ 引用:对话框中点「@」→ 选「ima 知识库」→ 右侧显示文件列表,可勾选整个知识库,或切到「选择文件」Tab 单独勾选所需文件;
- 资料库添加:「资料库 → ima 知识库」选中对应文件,点击「添加到任务」;
- 上传文件入口:输入框上方点「上传文件」图标 → 打开 ima 知识库 → 勾选。
完整的联动闭环是四步:授权绑定 → 选取资料 → 执行任务 → 一键回传(任务完成后点产物区的「上传到云端」,选择保存到 ima 知识库的对应位置)——读取、处理、存回,闭环完成。
3 建库与导入:先跑通再扩张
3.1 第一版只建三个库(别贪多)
连接打通后,大多数人会犯一个错误:一上来就建十几个知识库——资料库、项目库、领域库、卡片库、输出库、归档库、灵感库……听起来很专业,但分类越多越容易放弃。第一版只建三个:
- 01-资料库:放外部资料。文章、PDF、报告、网页、课程、访谈稿、会议录音转写;
- 02-项目库:放正在推进的事。一个选题、一个客户项目、一个产品想法、一个课程计划;
- 03-输出库:放你自己的成果。文章草稿、选题库、复盘总结、观点卡片、方法论沉淀。
为什么是三个?第一阶段最重要的不是分类精细,而是养成"资料进来后不乱放、先进入一个能被 AI 读取处理的地方"的习惯——这一步跑通,你就已经超过了大多数人的"收藏夹知识库"。
在 ima 创建知识库:打开 ima 客户端 → 左侧「知识库」→ 点「+」新建 → 输入名称。命名要具体且稳定:用「01-资料库」这种数字前缀+简短名称的格式;库本身要具体("2026-Q2 竞品分析库"而非"我的资料","八年级物理教学库"而非"我的教学资源"——后者三个月后你自己都懒得翻)。文件命名用「日期-主题-状态」格式(如 2026-07-06-知识库教程-草稿),命名目的不是好看,是为了以后能找回来。另外每个知识库控制在 100-200 个文件以内检索更快,并定期清理过时内容。
3.2 第一批资料:20 条以内
第二批容易犯的错:第一天就想把所有资料倒进去——微信收藏几百条、浏览器书签几百个、几十个 PDF 全导进去。这不是搭知识库,是把垃圾堆搬进新房子。第一批资料只放 20 条以内,目的是验证三件事:
- ima 能不能把这些资料存好?
- WorkBuddy 能不能把这些资料读出来、整理好?
- 你看完 AI 生成的结果后,是否愿意继续用?
三个问题跑通了,再扩张不迟。
3.3 资料进库的多条渠道
ima 的入库渠道比想象的多,先传 3 份最常用的资料试水:
- 本地文件:ima 客户端进入对应知识库,直接上传(Word/PDF/Markdown/Excel 等,上传后等向量化处理完成,通常几秒到几分钟);
- 公众号文章:复制文章链接 → ima 客户端或小程序进入知识库 → 粘贴链接保存;
- 微信聊天文件:知识库「上传 → 微信文件」→ 选联系人 → 选文件入库;微信里收到好资料也可以长按"用其他应用打开 → ima"秒传;
