
一、前言
最近,Anthropic 发布了 Claude Opus 4.8,同时带来了一个很多人还没有意识到其意义的新能力——Claude Code Dynamic Workflows(动态工作流)。
如果说过去两年 AI 编程领域最重要的两个关键词是 MCP 和 Skills,那么在我看来,Dynamic Workflows 很可能会成为下一个被行业反复讨论、最终演变成标准范式的能力。
因为它改变的已经不是模型本身,而是软件开发任务的组织方式。
过去,我们习惯于把 AI 当作一个聪明的助手:
你提问,它回答;
你规划,它执行;
你发现问题,它继续修复。
无论模型变得多强,本质上仍然是在一个有限上下文窗口里的单线程协作。
但 Dynamic Workflows 不一样。
它第一次让 Claude 不再只是一个对话对象,而开始像一个真正的工程团队。
Claude 会先理解目标,然后自己编写一段用于调度的 JavaScript 编排脚本,在后台启动数十、数百甚至上千个 Subagent 并行工作。它们从不同角度分析问题、互相审查彼此的结论、不断迭代修正,最终只把经过验证的结果呈现给用户。
更重要的是,这一切都发生在主对话上下文之外。
计划被写进代码,而不是塞进上下文窗口;
思考过程被存入运行时,而不是堆积在聊天记录里。
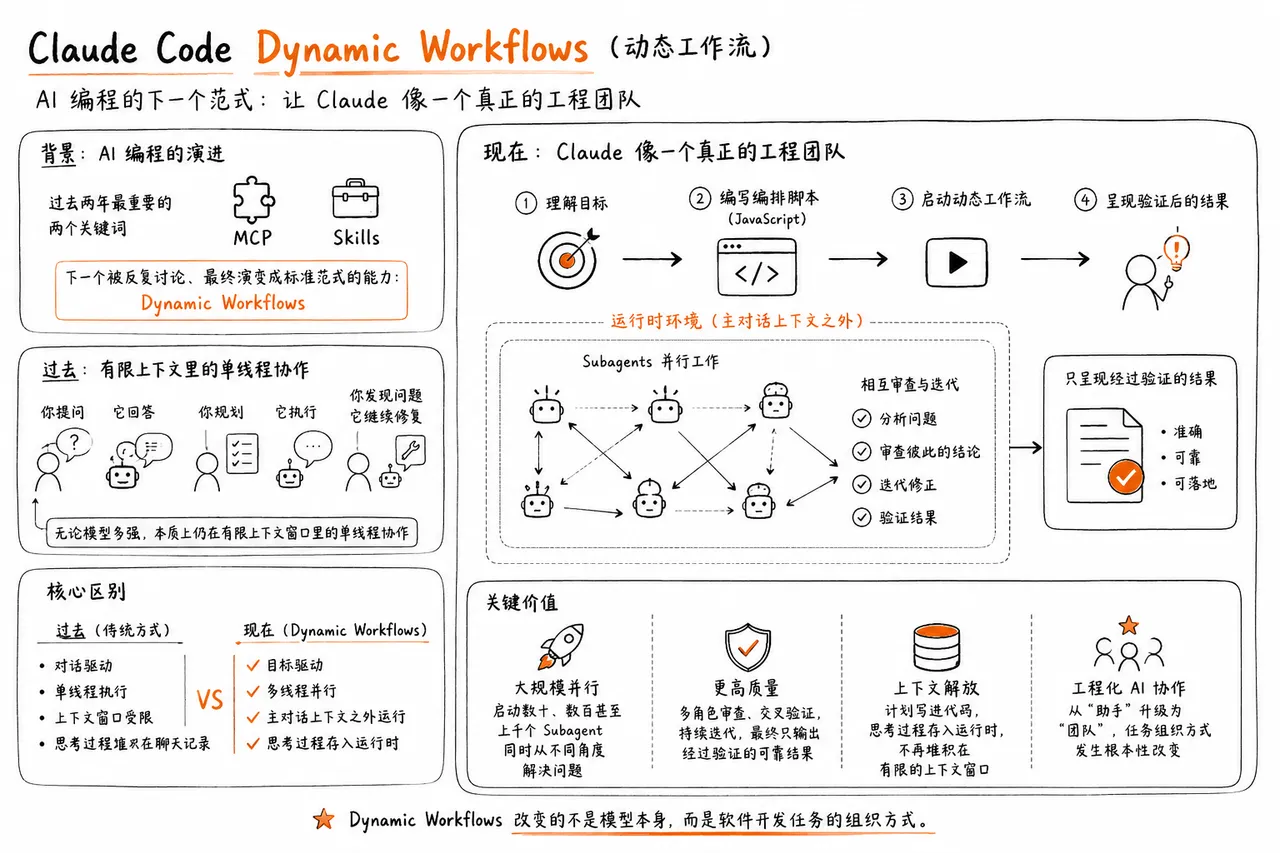
这意味着 AI 编程长期存在的几个核心瓶颈——上下文污染、逻辑漂移、复杂任务失控——第一次看到了系统性的解决方案。
官方展示的案例甚至有些令人震撼。
Bun 作者 Jarred Sumner 使用 Dynamic Workflows 完成了 Bun 从 Zig 到 Rust 的迁移:
- 生成约 75 万行 Rust 代码;
- 既有测试套件通过率达到 99.8%;
- 从首次提交到代码合并仅用了 11 天。
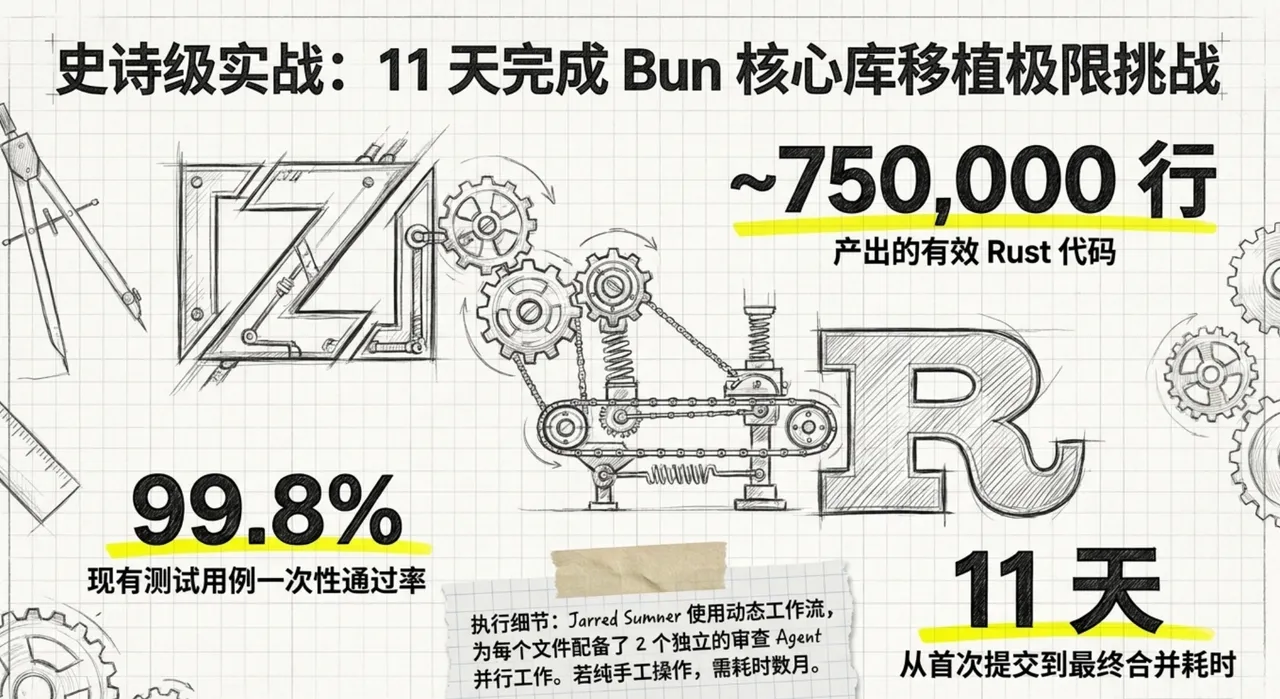
这并不是简单地“写代码更快了”。
而是第一次让人看到:原本需要一个团队持续数周甚至数月推进的大型工程任务,开始能够由一个由 AI 驱动的并行智能体集群自主完成。
如果说 MCP 解决的是「让 AI 接入世界」的问题;
Skills 解决的是「让 AI 复用经验」的问题;
那么 Dynamic Workflows 解决的,则是「让 AI 学会组织大规模工作」的问题。
我认为,这可能是 AI 软件工程发展过程中一个极其重要的转折点。
它标志着开发模式正在从“单一对话式 Agent”,迈向“大规模并行智能体协作网络”。
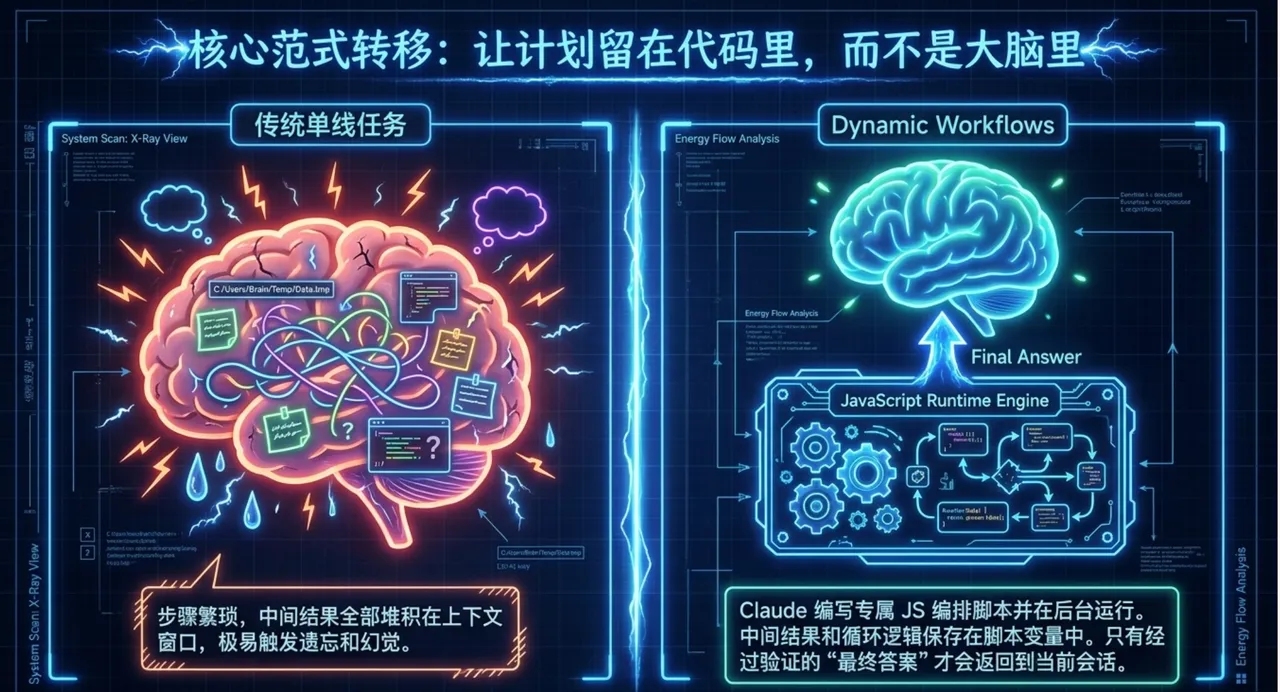
未来很多今天仍然依赖人工协调、人工拆解、人工跟踪的大型工程任务,都有可能因此被重新定义。
Dynamic Workflows(动态工作流)是解决“上下文污染”和“复杂任务规划”的杀手锏。
Dynamic Workflows 的本质,是让计划留在代码里,而不是留在上下文里;让组织能力成为 AI 的基础设施,而不是开发者的负担。
本文将结合官方资料、技术细节以及个人理解,分享下 Claude Dynamic Workflows 的只是、设计以及它可能给整个 AI 编程生态带来的深远影响。
二、快速体验
接下来,我们先快速的使用一下,首先更新下我们的ClaudeCode版本为最新的版本。这里我用的是MiniMax模型,使用switchcc进行配置,目前看问题也不大:
npm install -g @anthropic-ai/claude-code
然后我们进入到ClaudeCode的命令行界面:
claude
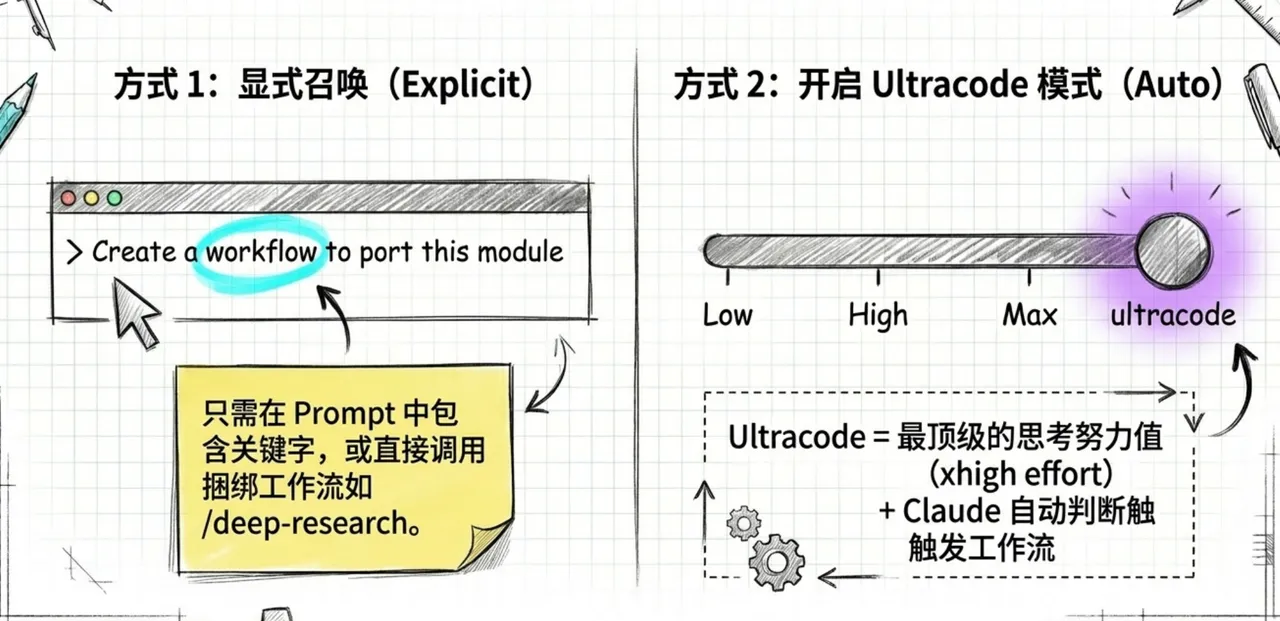
然后输入我们的一个问题,根据官方的说法,使用时prompt 里包含 "workflow" 这个词。
两种方式如下:
接下来,我们发起个实验试试,这是一个基于 Claude Code Workflow 的自动化小说生成工作流。可以一键生成:
- 3章小说的 Markdown 文档
- 对应的精美 HTML 网页(支持在线阅读)
- 小说目录首页
例如:
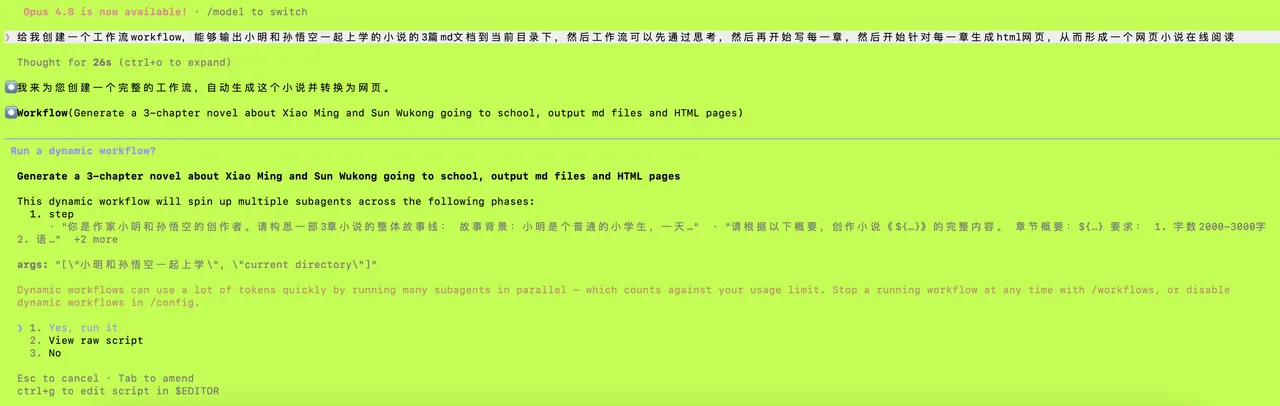
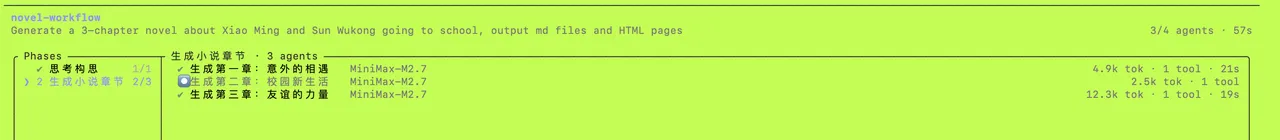
然后我们通过执行/workflows命令查看到执行的进度,可以看到分成了多个步骤,然后一共使用了4个agent的方式开始实现我们的需求:
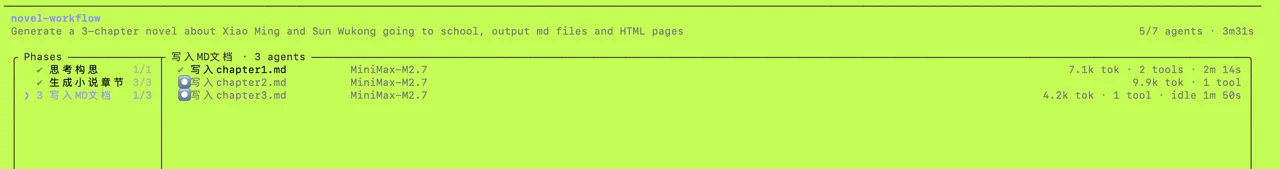
执行到第3步的时候,又给我们生成了3个Agent,开始写MD文档,此时已经出现了7个Agent。
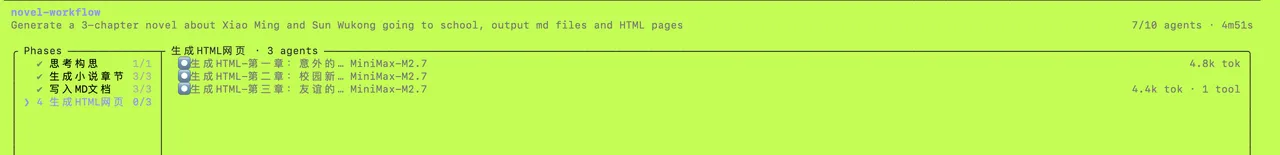
然后执行到第4步的时候,又给我们生成了3个Agent,开始给我们生成HTML网页,此时已出现10个Agent:
执行到第5步的时候,继续生成了3个Agent,开始进行写文件,此时用了13个Agent:
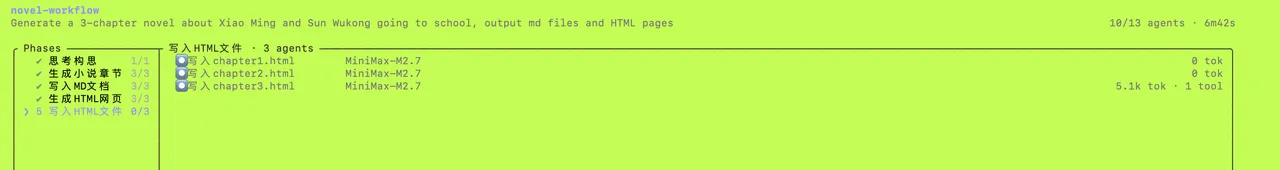
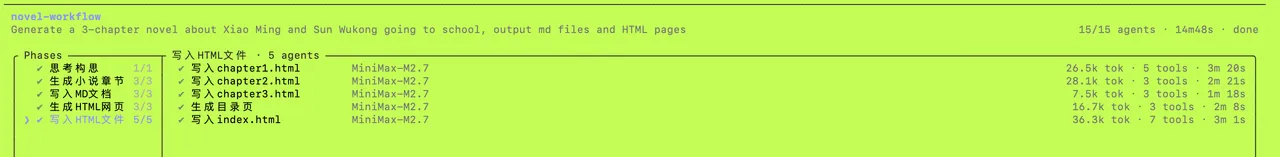
然后继续执行,最终通过使用了15个Agent的方式,实现了这个3章的小说的生成.
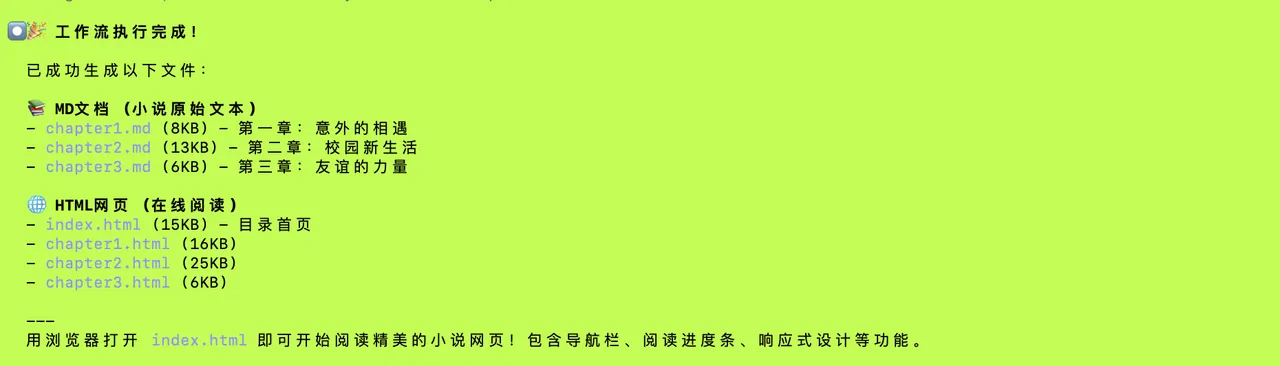
执行结束,提示日志:
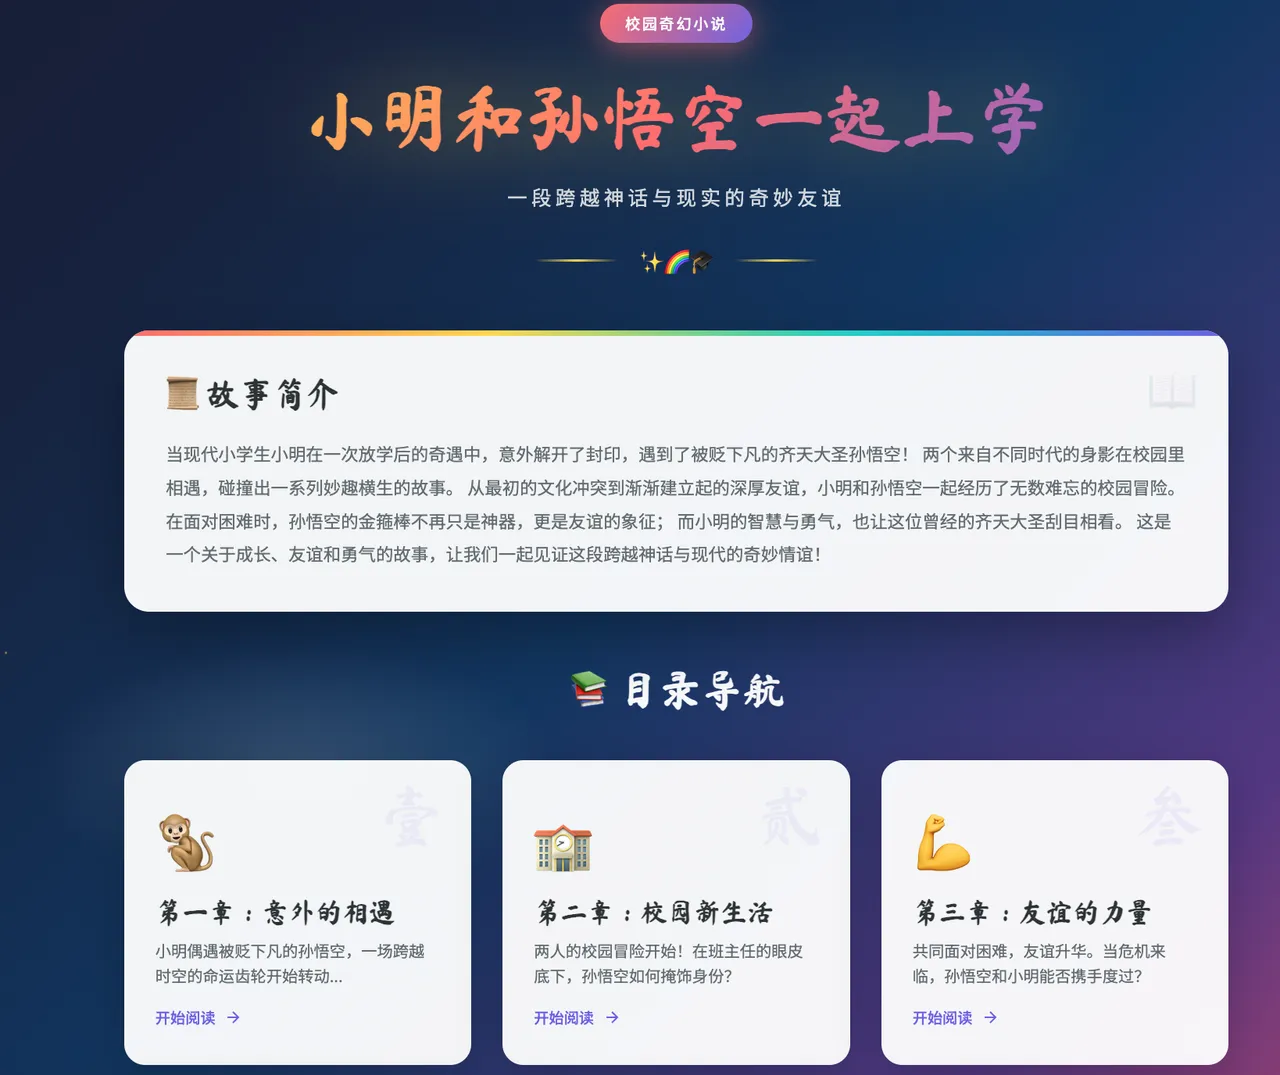
接下来看下效果,还不错:
接下来,我们实现快捷键来执行保存,方便日后使用,使用字母s:
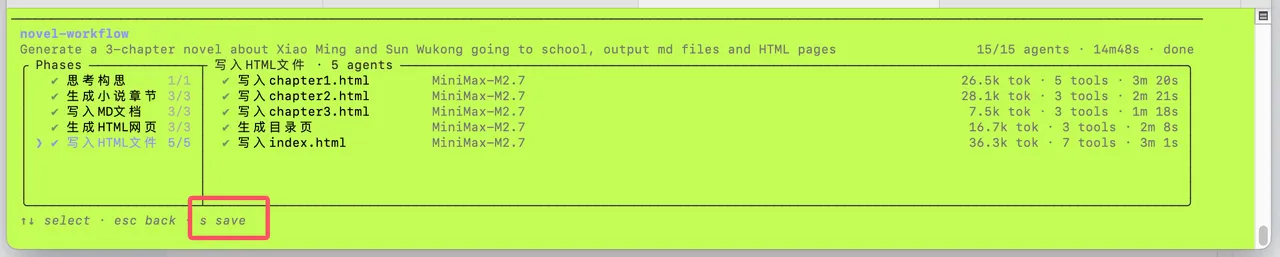
弹出的保存工作流交互,我们输入自己的名称后,会在当前目录下保存工作流:
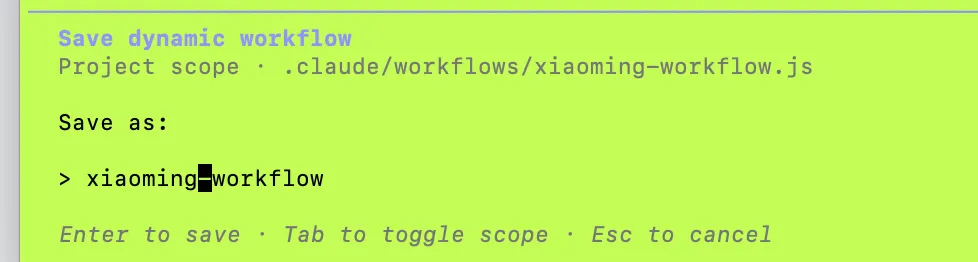
保存成功后,会提示我们输入斜杠命令的方式实现工作流的复用,我这里的提示如下:
Invoke as /xiaoming-workflow or Workflow({name: "xiaoming-workflow"}) in future sessions.
这是工作流最实用的特性之一。当 Claude 生成的脚本跑通之后,你可以把它保存为一条命令,以后在同样的项目里直接复用。
通过 /workflows 进入运行列表,选中你要保存的工作流,按 s 键。有两个保存位置可选:
• .claude/workflows/ — 保存在项目目录,团队成员都能用(建议提交到 Git)
• \~/.claude/workflows/ — 保存在家目录,个人全局可用
保存后,在 Claude Code 中输入 / 就能看到它出现在自动补全列表中
在这个进度视图中,相关的操作命令如下:
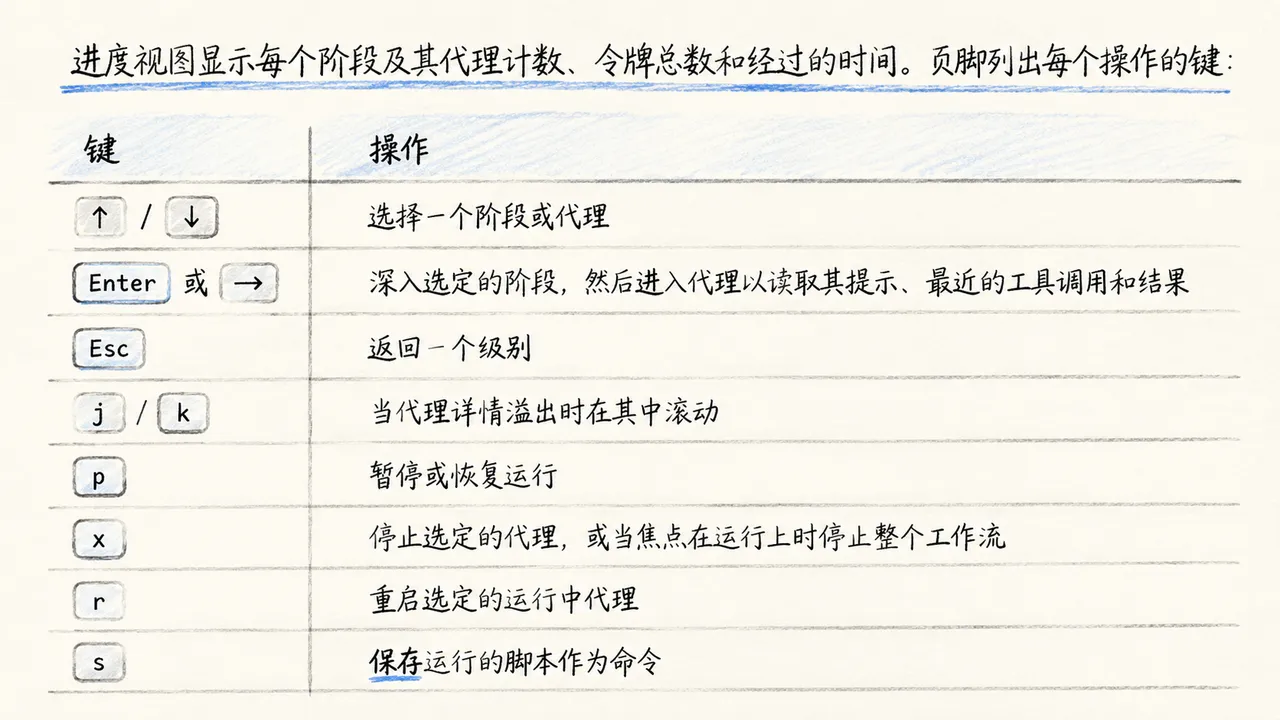
保存完成后,会在当前目录下生成脚本文件,目录结构如下:
.claude
    workflows
xxxxxx-workflow.js代码内容截图如下:
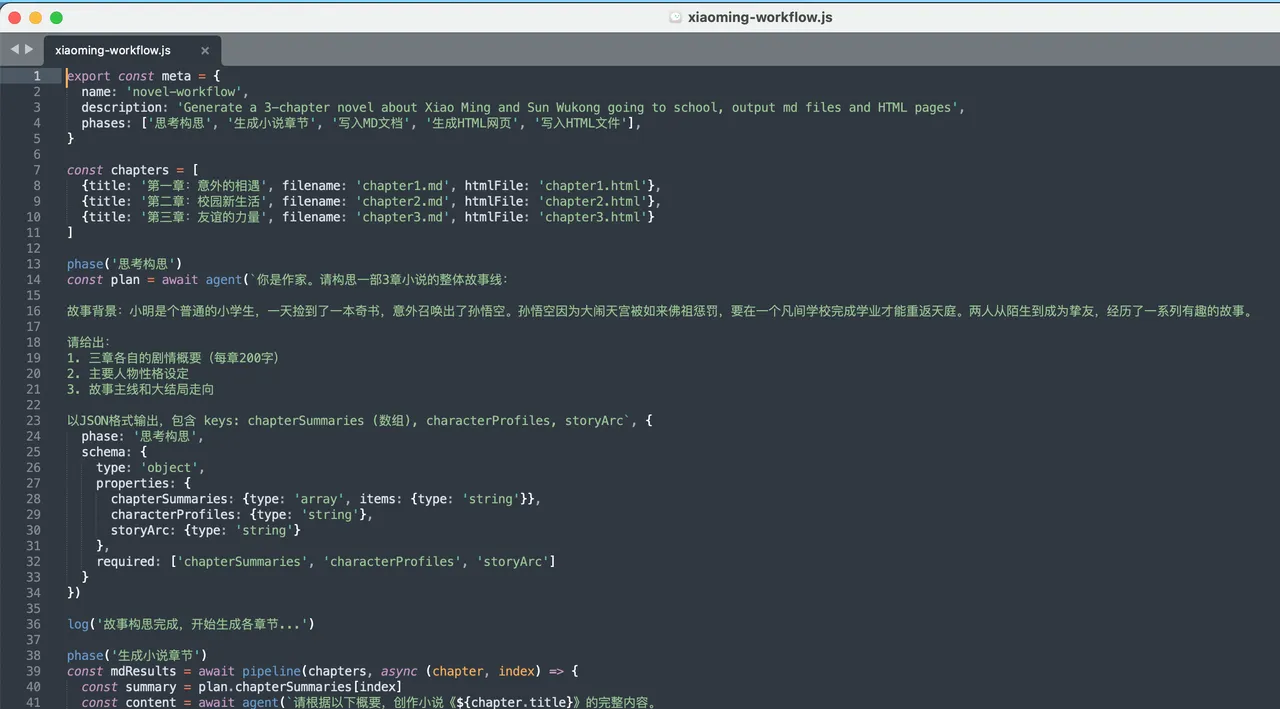
关于这个脚本的内容和逻辑,工作流程
Phase 1: 思考构思
调用 AI Agent 生成故事大纲
输出:每章概要、人物性格、故事主线
使用 schema 约束确保返回结构化 JSON
Phase 2: 生成小说章节
使用 pipeline() 并行生成3章内容
每章基于上一阶段的概要创作
输出:2000-3000字的 Markdown 格式小说
Phase 3: 写入MD文档
使用 pipeline() 并行写入3个 .md 文件
每个文件调用一个 Agent 完成任务
Phase 4: 生成HTML网页
使用 pipeline() 并行生成3个章节网页
AI Agent 负责设计精美的阅读界面
Phase 5: 写入HTML文件
写入章节 HTML 文件
生成并写入 index.html 目录页
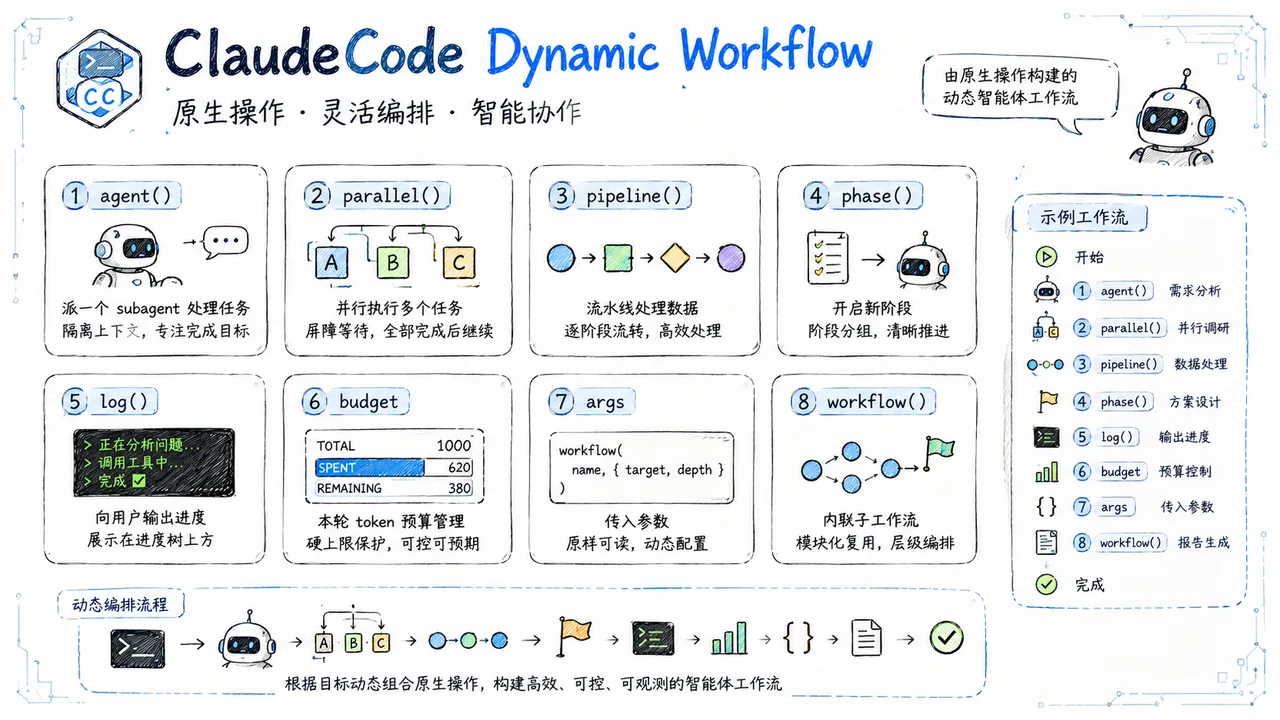
这个脚本中主要的几个关键内容如下:
- 导出 meta 对象
export const meta = {
  name: 'workflow名称',
  description: '描述',
  phases: ['阶段1', '阶段2', ...]  // 进度显示的阶段
}- phase() 分阶段
phase('阶段名称') // 在进度树中创建一个新的阶段分组- agent() 调用 AI
结构化输出:给 agent() 传一个 JSON Schema,subagent 会被强制调用结构化输出工具,agent() 直接返回校验过的对象——无需自己解析,模型不匹配会自动重试。
const result = await agent('提示词', {
  phase: '所属阶段',
  label: '显示标签',
  schema: { /* JSON Schema约束输出格式 */ }
})- pipeline() 并行处理
const results = await pipeline(items, async (item, index) => {
  // 对每个item执行操作
  return result
})- log() 输出日志
log('消息') // 显示在进度树中- args 全局变量
args // 获取 Workflow 调用时传入的参数在这个脚本中,代表了Agent设计模式中的流水线设计模式的使用。
常见的使用的几个原生操作如下:
完整代码如下,可以保存后,自己放到.claude/workflows下,存储为xiaoming-workflow.js文件,文件内容:
export const meta = {
  name: 'novel-workflow',
  description: 'Generate a 3-chapter novel about Xiao Ming and Sun Wukong going to school, output md files and HTML pages',
  phases: ['思考构思', '生成小说章节', '写入MD文档', '生成HTML网页', '写入HTML文件'],
}

const chapters = [
  {title: '第一章:意外的相遇', filename: 'chapter1.md', htmlFile: 'chapter1.html'},
  {title: '第二章:校园新生活', filename: 'chapter2.md', htmlFile: 'chapter2.html'},
  {title: '第三章:友谊的力量', filename: 'chapter3.md', htmlFile: 'chapter3.html'}
]

phase('思考构思')
const plan = await agent(`你是作家。请构思一部3章小说的整体故事线:

故事背景:小明是个普通的小学生,一天捡到了一本奇书,意外召唤出了孙悟空。孙悟空因为大闹天宫被如来佛祖惩罚,要在一个凡间学校完成学业才能重返天庭。两人从陌生到成为挚友,经历了一系列有趣的故事。

请给出:
1. 三章各自的剧情概要(每章200字)
2. 主要人物性格设定
3. 故事主线和大结局走向

以JSON格式输出,包含 keys: chapterSummaries (数组), characterProfiles, storyArc`, {
  phase: '思考构思',
  schema: {
    type: 'object',
    properties: {
      chapterSummaries: {type: 'array', items: {type: 'string'}},
      characterProfiles: {type: 'string'},
      storyArc: {type: 'string'}
    },
    required: ['chapterSummaries', 'characterProfiles', 'storyArc']
  }
})

log('故事构思完成,开始生成各章节...')

phase('生成小说章节')
const mdResults = await pipeline(chapters, async (chapter, index) => {
  const summary = plan.chapterSummaries[index]
  const content = await agent(`请根据以下概要,创作小说《${chapter.title}》的完整内容。

章节概要:${summary}

要求:
1. 字数2000-3000字
2. 语言生动有趣,适合青少年阅读
3. 包含具体对话、动作、心理描写
4. 以 Markdown 格式输出
5. 使用中文写作
6. 标题使用 # 格式

直接输出小说内容,不要有额外说明。`, {
    phase: '生成小说章节',
    label: `生成${chapter.title}`,
    schema: {type: 'object', properties: {content: {type: 'string'}}, required: ['content']}
  })
  return {chapter, content: content.content, index}
})

phase('写入MD文档')
await pipeline(mdResults.filter(Boolean), async (result) => {
  await agent(`请将以下小说内容写入文件 ${result.chapter.filename}。

文件路径:${args[1]}/${result.chapter.filename}

小说内容:
# ${result.chapter.title}

---

${result.content}`, {
    phase: '写入MD文档',
    label: `写入${result.chapter.filename}`,
    schema: {type: 'object', properties: {success: {type: 'boolean'}}, required: ['success']}
  })
  log(`✓ 已生成: ${result.chapter.filename}`)
})

phase('生成HTML网页')
const htmlResults = await pipeline(mdResults.filter(Boolean), async (result) => {
  const htmlContent = await agent(`请将以下小说内容转换为精美的HTML网页。

小说标题:${result.chapter.title}
小说内容:
${result.content}

要求:
1. HTML5标准结构,包含 <!DOCTYPE html>
2. 使用 <style> 标签内嵌CSS,设计要精美:
   - 适合阅读的字体大小(16-18px)和行高(1.8)
   - 舒适的阅读宽度(max-width: 800px, margin: auto)
   - 标题使用大号字体,居中显示
   - 章节标题有装饰效果(如底部边框或渐变背景)
   - 段落之间有合适间距
   - 添加淡蓝色或米色背景色
   - 添加返回目录链接
3. 添加中文导航栏:包含"上一章"、"目录"、"下一章"链接(注意:第一章没有上一章,最后一章没有下一章)
4. 响应式设计,在手机端也能良好阅读
5. 添加阅读进度条效果
6. 添加简单的页脚:版权信息和"由AI生成"

直接输出完整HTML代码,不要有其他说明。`, {
    phase: '生成HTML网页',
    label: `生成HTML-${result.chapter.title}`,
    schema: {type: 'object', properties: {html: {type: 'string'}}, required: ['html']}
  })
  return {chapter: result.chapter, html: htmlContent.html}
})

phase('写入HTML文件')
await pipeline(htmlResults.filter(Boolean), async (result) => {
  await agent(`请将以下HTML内容写入文件 ${result.chapter.htmlFile}。

文件路径:${args[1]}/${result.chapter.htmlFile}

HTML内容:
${result.html}`, {
    phase: '写入HTML文件',
    label: `写入${result.chapter.htmlFile}`,
    schema: {type: 'object', properties: {success: {type: 'boolean'}}, required: ['success']}
  })
  log(`✓ 已生成: ${result.chapter.htmlFile}`)
})

// 生成目录页
const indexHtml = await agent(`请为小说《小明和孙悟空一起上学》创建一个精美的目录首页HTML。

小说信息:
- 书名:小明和孙悟空一起上学
- 类型:校园奇幻小说
- 共3章

三章内容:
1. 第一章:意外的相遇 - 小明偶遇被贬下凡的孙悟空
2. 第二章:校园新生活 - 两人的校园冒险开始
3. 第三章:友谊的力量 - 共同面对困难,友谊升华

要求:
1. HTML5标准结构
2. 精美的CSS样式:
   - 大气的标题设计
   - 章节列表使用卡片式布局
   - 添加可爱的图标或emoji
   - 渐变背景色
   - 悬停效果
3. 每个章节链接到对应的HTML文件
4. 添加小说简介区域
5. 响应式设计
6. 添加页脚

直接输出完整HTML代码。`, {
  phase: '写入HTML文件',
  label: '生成目录页',
  schema: {type: 'object', properties: {html: {type: 'string'}}, required: ['html']}
})

await agent(`请将以下HTML内容写入文件 index.html。

文件路径:${args[1]}/index.html

HTML内容:
${indexHtml.html}`, {
  phase: '写入HTML文件',
  label: '写入index.html',
  schema: {type: 'object', properties: {success: {type: 'boolean'}}, required: ['success']}
})
log('✓ 已生成: index.html (目录页)')

log('\\n🎉 全部完成!生成了以下文件:')
log('  📚 MD文档: chapter1.md, chapter2.md, chapter3.md')
log('  🌐 HTML网页: chapter1.html, chapter2.html, chapter3.html')
log('  📖 目录页: index.html')
log('\\n用浏览器打开 index.html 即可开始阅读!')那么,这个东西既然可以落地为脚本,那么意味着我们可以做更多有意思的事情:
1、做个AI程序来自动生成这个适配ClaudeCode的Workflows脚本程序
2、也可以写个Skills来生成这种稳定的Workflows脚步的逻辑
3、可以建设Workflows的市场、周边各种生态。
.......
Claude Code 也自带了一个开箱即用的 workflow 叫 /deep-research——专门做需要"上网+读代码+交叉验证"的深度调研:
/deep-research xxxxxxx
它会自己拆成几十个 subagent:一批查文档、一批读你仓库实际代码、一批跑对照验证,最后汇总成一份带引用的报告。/deep-research 是看懂 Dynamic Workflows 的最快入口——你不需要懂 JS,直接体验完整流程。
这个workflow的源码截图如下:
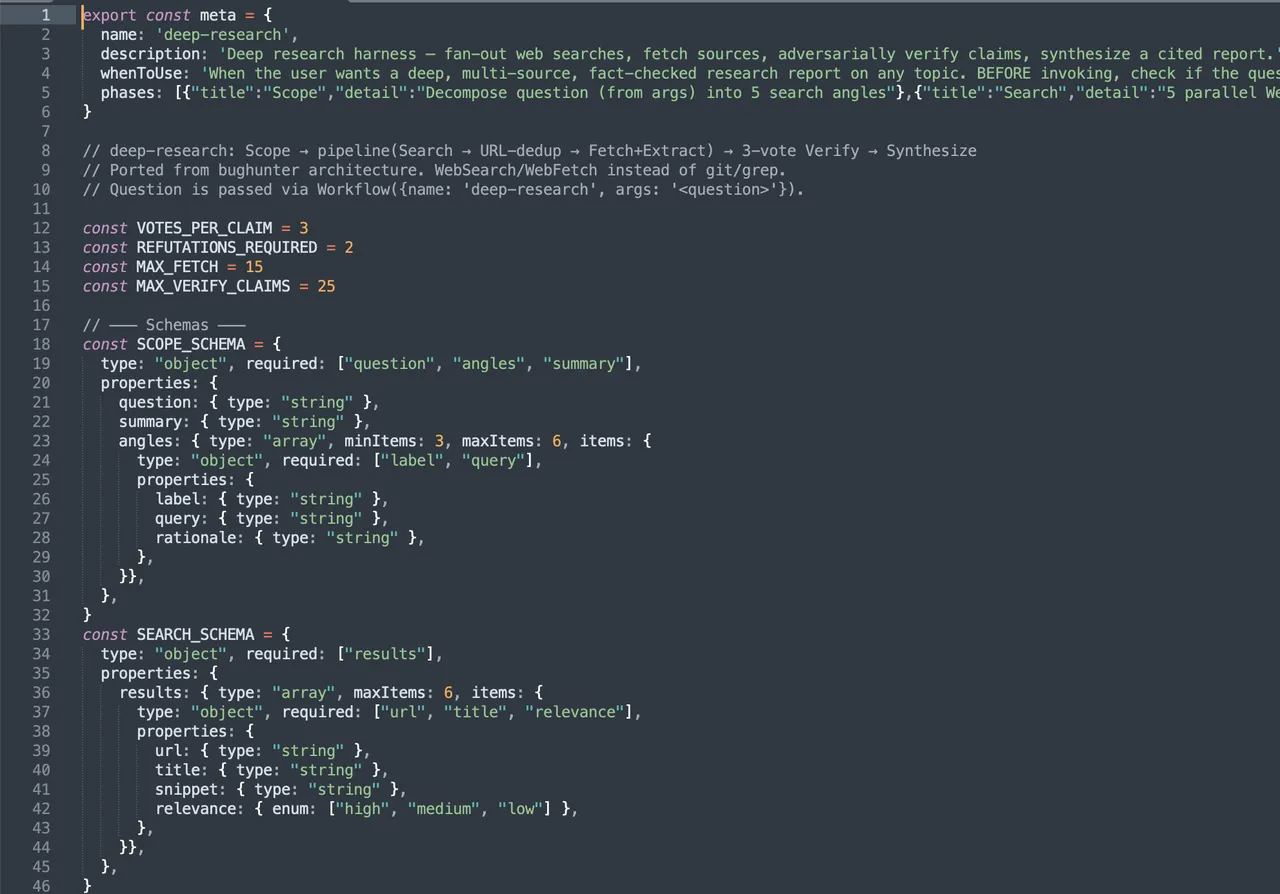
无论是刚才的写文章的Workflow,还是这个内置的深度搜索的Workflow,多数的这个Workflow这个体验上来看启动工作流时都会做类似如下的内容:
- Claude 根据提示动态规划任务
- 将任务拆解为子任务
- 并行分发给子代理
- 子代理从独立角度处理问题
- 对抗代理尝试挑战结果
- 不断迭代直到答案收敛
最终用户得到的是单一、协调一致的结果。特点:
- 支持长时间并行工作(可持续数小时至数天)
- 复杂工程任务以前需要数周才能完成
- 进度在运行中保存,中断后可从上次位置恢复
- 协调在对话外进行,任务规模再大也能保持计划一致
工作流生成许多代理,所以单次运行可以使用比在对话中处理相同任务更多的令牌。
从我们刚才敲下 prompt 的时候,到结果回灌,中间发生了什么呢,可以看下这个图:
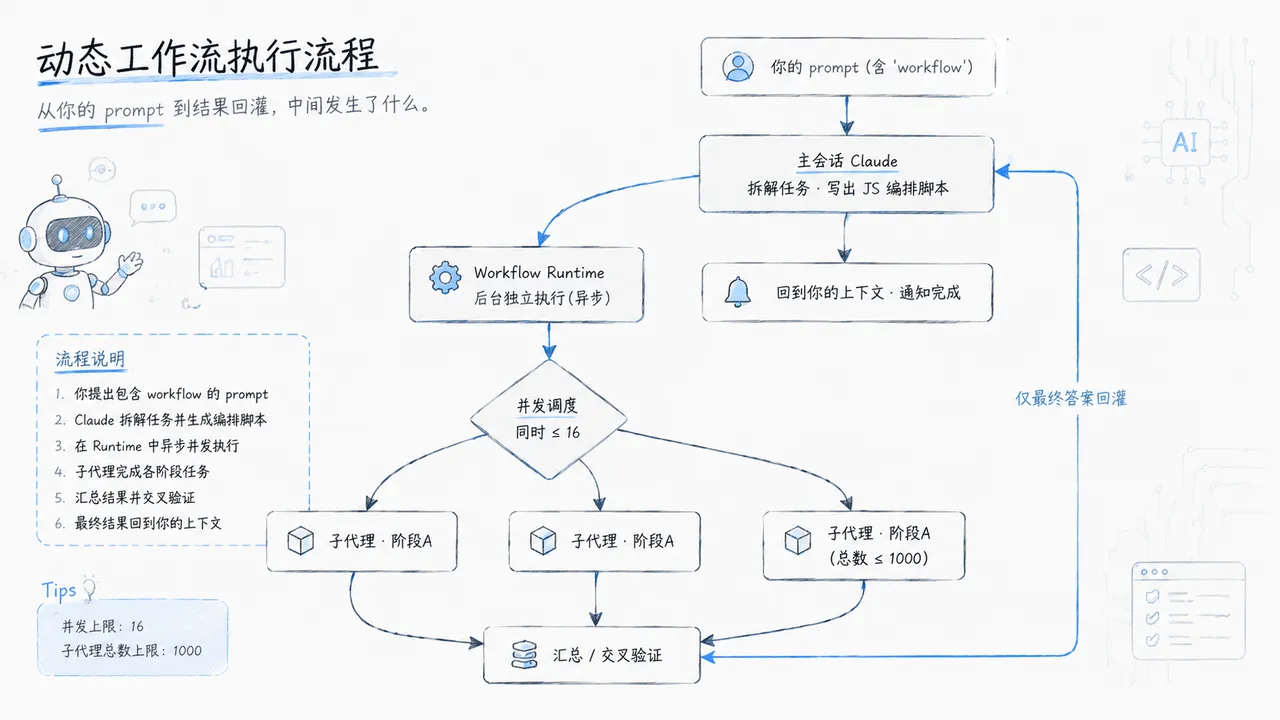
隔离执行:runtime 在与对话隔离的环境里跑脚本,中间结果留在脚本变量里,不进 Claude 上下文。
异步后台:启动后立即返回一个任务 id,workflow 在后台跑,主会话仍可交互;完成时通知你。
并发受控:同时最多 16 个 subagent,多出的排队等空位;整个生命周期总量上限 1000。
上下文干净:中间推理默认不回到主会话(除非脚本用 log() 输出),因此长任务不会撑爆上下文。
可交叉验证:脚本可以让独立 subagent 互相审查彼此结论后再上报,或从多个角度起草方案再择优。
体验完成了,接下来我们在看看这个Dynamic Workflows。
三、继续学习下Dynamic Workflows是什么
首先,我们还是通过DeepResearch类的软件,来深度研究下这个功能,这个东西在AI时代非常重要,也是能够快速学习的一种方式,我这里使用的依然是谷歌的NoteBookLM,截图如下:
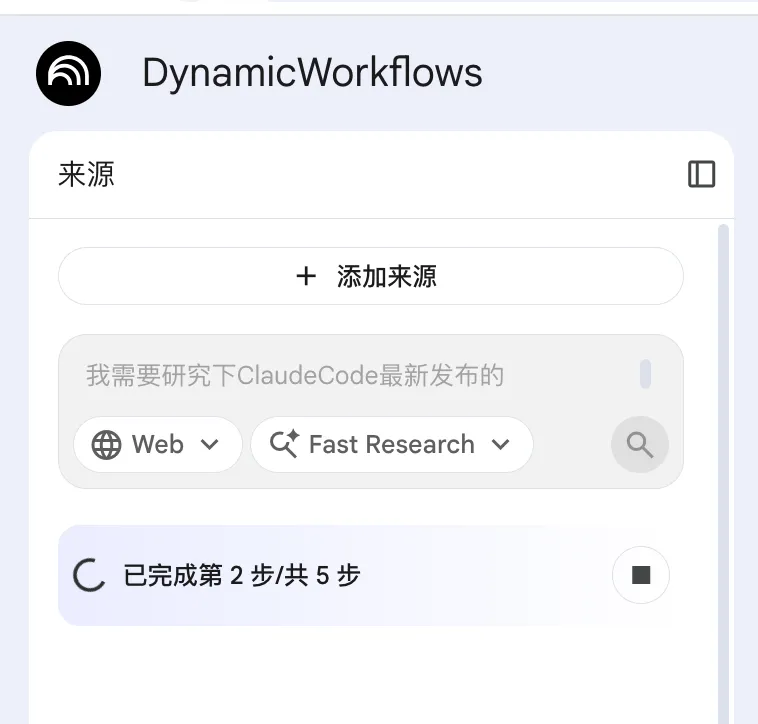
等待一会儿后,我们可以看到我们想要的内容,给我们整理20篇的文章,接下来开始学习:
首先我们来看下这个东西的基本研究结果。
首先,从设计上来看,这个东西体现了【上下文卸载机制Context Offloading Mechanism)】,当用户发起复杂任务时:
主模型首先规划整体目标;
然后将该计划转换成一个临时 JavaScript 脚本;
Claude Code 内部后台运行时(Runtime)负责执行该脚本。
而在我们传统方式下:每一步操作、目录扫描结果、临时文件修改,都会被不断追加到对话历史中,最终导致:
Context Pollution(上下文污染)
Context Drift(上下文漂移)
而 Dynamic Workflows 中:中间变量、循环逻辑、条件分支等全部保存在 JavaScript 运行时内部。
因此:
主上下文窗口只保留最终结果;
子代理(Subagents)独立执行各自任务。
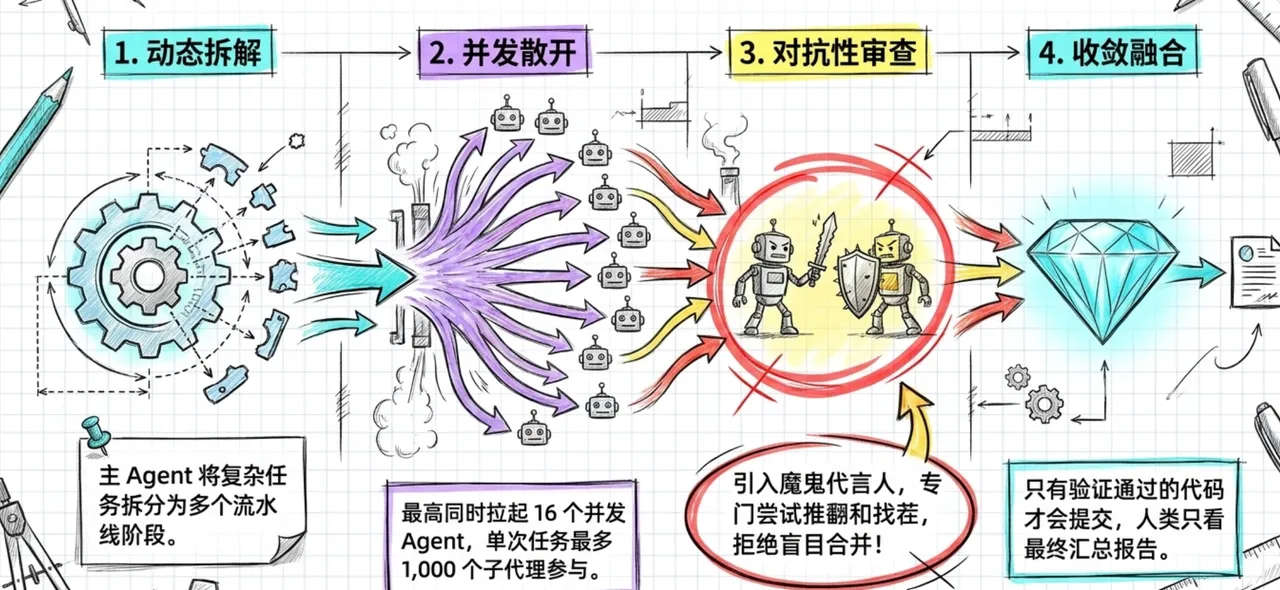
其次,再看它也做到了并行扇出(Fan-Out)的模式,动态生成的 JavaScript 脚本能够同时协调数十到数百个并行运行的子代理。执行流程如下:
(1)、首先动态任务拆解:主脚本将高层目标分解为多个可并行执行的子任务。
(2)、然后并行子代理分发:启动多个隔离运行的子代理:实现代码修改,或从不同角度分析代码路径。
如果我们的任务需要做检查,通过这种玩法也会出现对抗式验证(Adversarial Verification),AI代理可能会生成一些作为“反方审查员(Devil's Advocate)”的Agent,来
反驳发现结果;
寻找安全漏洞;
尝试破坏代码修改方案。
各代理不断迭代,直到逻辑分析结果收敛为统一结论。后台运行时:
汇总验证后的结果;
输出单一统一结论给用户。
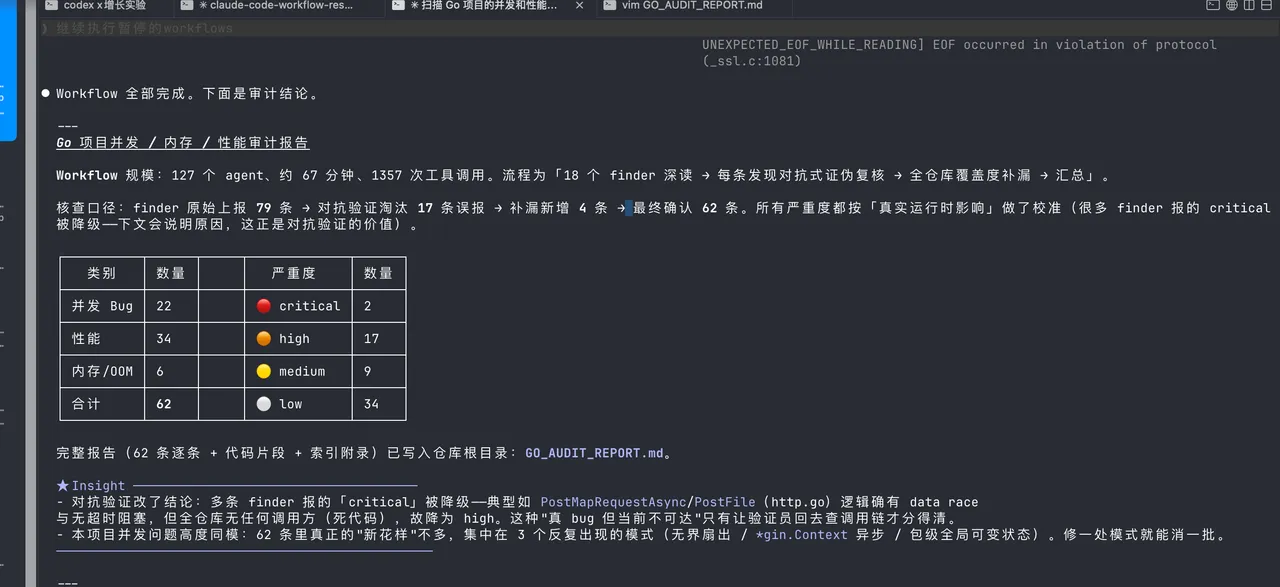
例如,在我的微信群中,有的网友网友来扫描代码,发现的结果也是出现了对抗性的特使,使用了127个Agent来达到目标,通过对抗性验证淘汰了17条的误报,这个东西价值比较大了:
正如Alessio Vallero所说:“动态工作流对于大规模代码库的探索和复查任务特别有价值。它帮助我们发现死代码和清理机会,这是传统静态分析无法覆盖的,让工程师在维护和重构工作上速度更快。”
同样的Ken Takao所说:
“动态工作流填补了单个子代理与完整代理团队之间的空白。从计划到执行流程顺畅,我们可以信任长期运行的任务而不会失去可见性。”
对于这个未知的东西,我们依然从5W2H的思维来看待这件事:
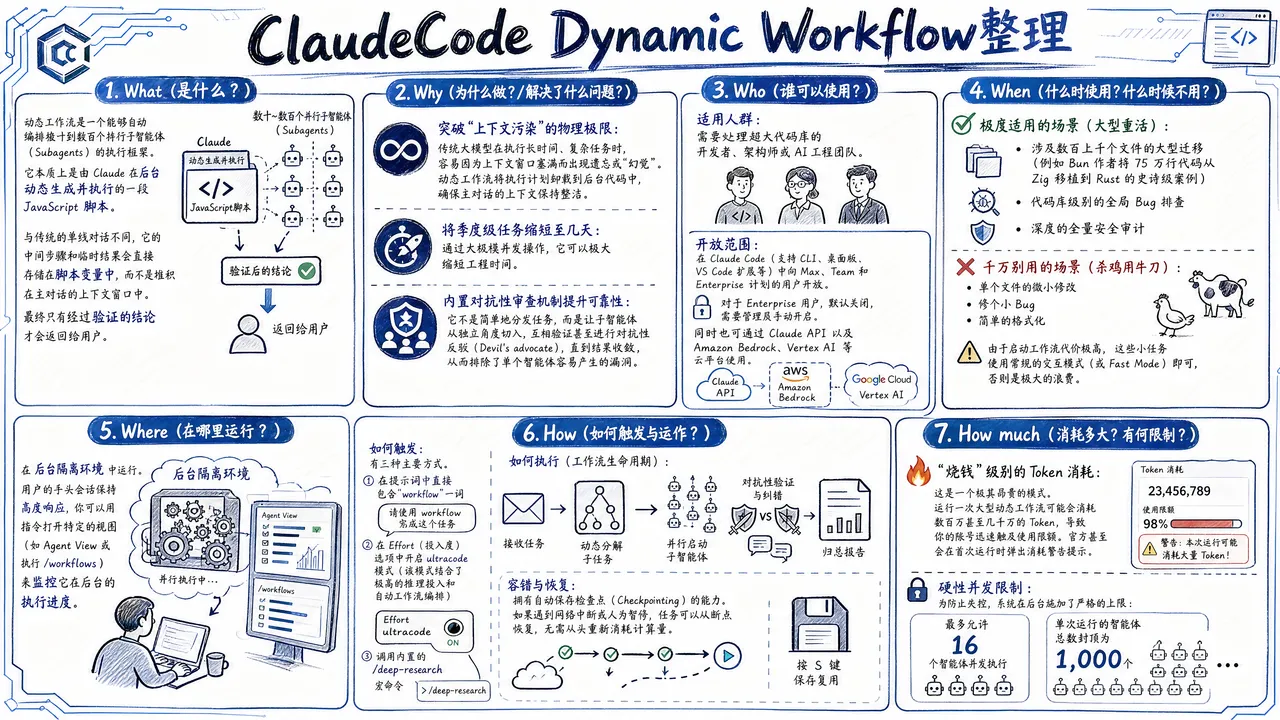
- What(是什么?)
动态工作流是一个能够自动编排数十到数百个并行子智能体(Subagents)的执行框架。 它本质上是由 Claude 在后台动态生成并执行的一段 JavaScript 脚本。与传统的单线对话不同,它的中间步骤和临时结果会直接存储在脚本变量中,而不是堆积在主对话的上下文窗口中。最终只有经过验证的结论才会返回给用户。
- Why(为什么做?/ 解决了什么问题?)
突破“上下文污染”的物理极限: 传统大模型在执行长时间、复杂任务时,容易因为上下文窗口塞满而出现遗忘或“幻觉”。动态工作流将执行计划卸载到后台代码中,确保主对话的上下文保持整洁。
将季度级任务缩短至几天: 通过大规模并发操作,它可以极大缩短工程时间。
内置对抗性审查机制提升可靠性: 它不是简单地分发任务,而是让子智能体从独立角度切入,互相验证甚至进行对抗性反驳(Devil's advocate),直到结果收敛,从而排除了单个智能体容易产生的漏洞。
- Who(谁可以使用?)
适用人群: 需要处理超大代码库的开发者、架构师或 AI 工程团队。
开放范围: 在 Claude Code(支持 CLI、桌面版、VS Code 扩展等)中向 Max、Team 和 Enterprise 计划的用户开放。对于 Enterprise 用户,默认关闭,需要管理员手动开启。同时也可通过 Claude API 以及 Amazon Bedrock、Vertex AI 等云平台使用。
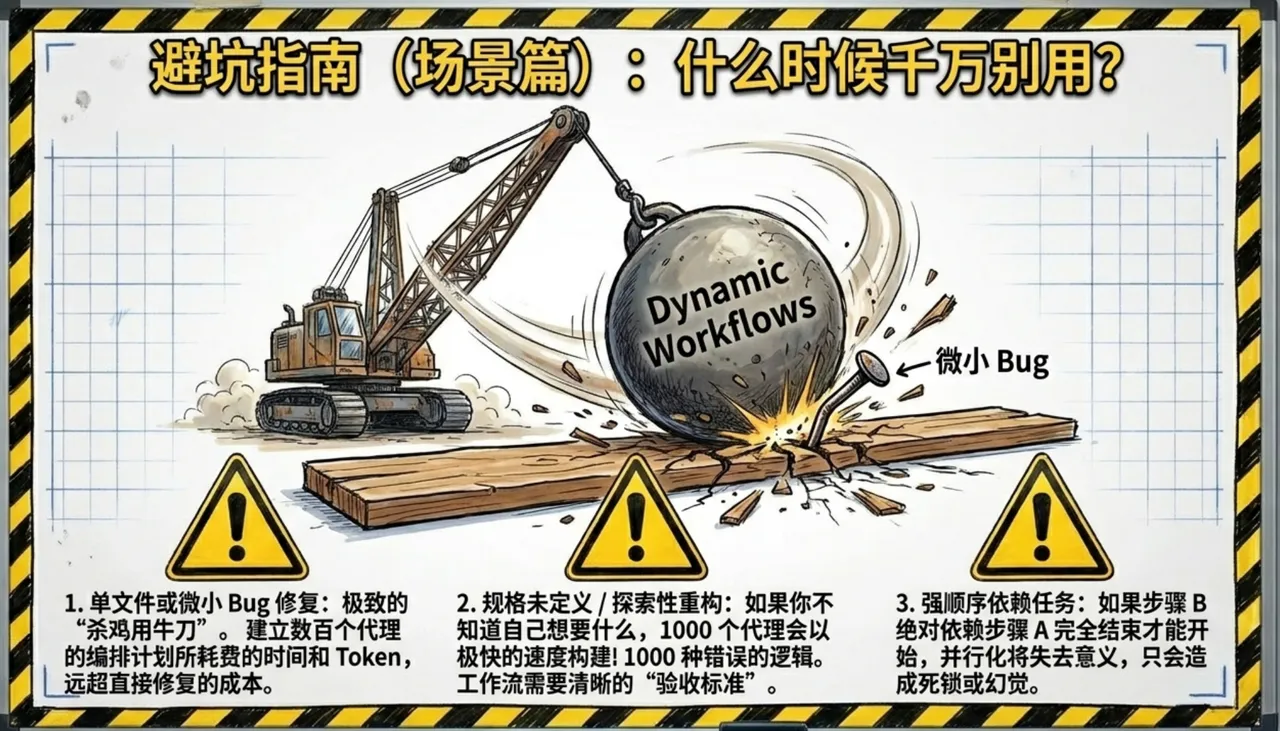
- When(什么时候用?什么时候不用?)
极度适用的场景(大型重活): 涉及数百上千个文件的大型迁移(例如 Bun 作者将 75 万行代码从 Zig 移植到 Rust 的史诗级案例)、代码库级别的全局 Bug 排查、深度的全量安全审计。
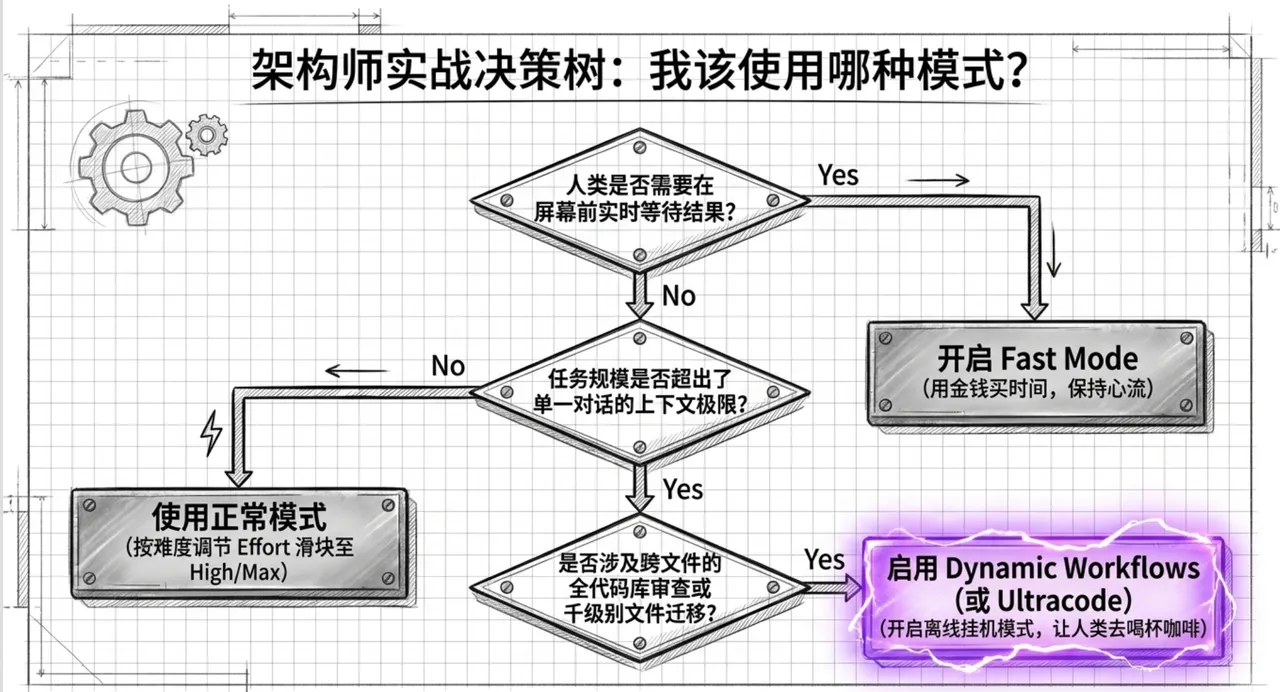
千万别用的场景(杀鸡用牛刀): 对于单个文件的微小修改、修个小 Bug 或简单的格式化。由于启动工作流代价极高,这些小任务使用常规的交互模式(或 Fast Mode)即可,否则是极大的浪费。
- Where(在哪里运行?)
在 后台隔离环境 中运行。用户的手头会话保持高度响应,你可以用指令打开特定的视图(如 Agent View 或执行 /workflows)来监控它在后台的执行进度。
- How(如何触发与运作?)
如何触发: 有三种主要方式。第一,在提示词中直接包含“workflow”一词;第二,在 Effort(投入度)选项中开启 ultracode 模式(该模式结合了极高的推理投入和自动工作流编排);第三,调用内置的 /deep-research 宏命令。
如何执行: 接收任务 -> 动态分解子任务 -> 并行启动子智能体 -> 对抗性验证与纠错 -> 归总报告。
容错与恢复: 拥有自动保存检查点(Checkpointing)的能力。如果遇到网络中断或人为暂停,任务可以从断点恢复,无需从头重新消耗计算量。完成的工作流脚本还可以通过按 s 键保存下来,供未来团队复用。
- How much(消耗多大?有何限制?)
“烧钱”级别的 Token 消耗: 这是一个极其昂贵的模式。运行一次大型动态工作流可能会消耗数百万甚至几千万的 Token,导致你的账号迅速触及使用限额。官方甚至会在首次运行时弹出消耗警告提示。
硬性并发限制: 为防止失控,系统在后台施加了严格的上限:最多允许 16 个智能体并发执行,且单次运行的智能体总数封顶为 1,000 个
四、架构对比
首先来看下SubAgent、AgentTeams、Dynamic Workflows的对比:
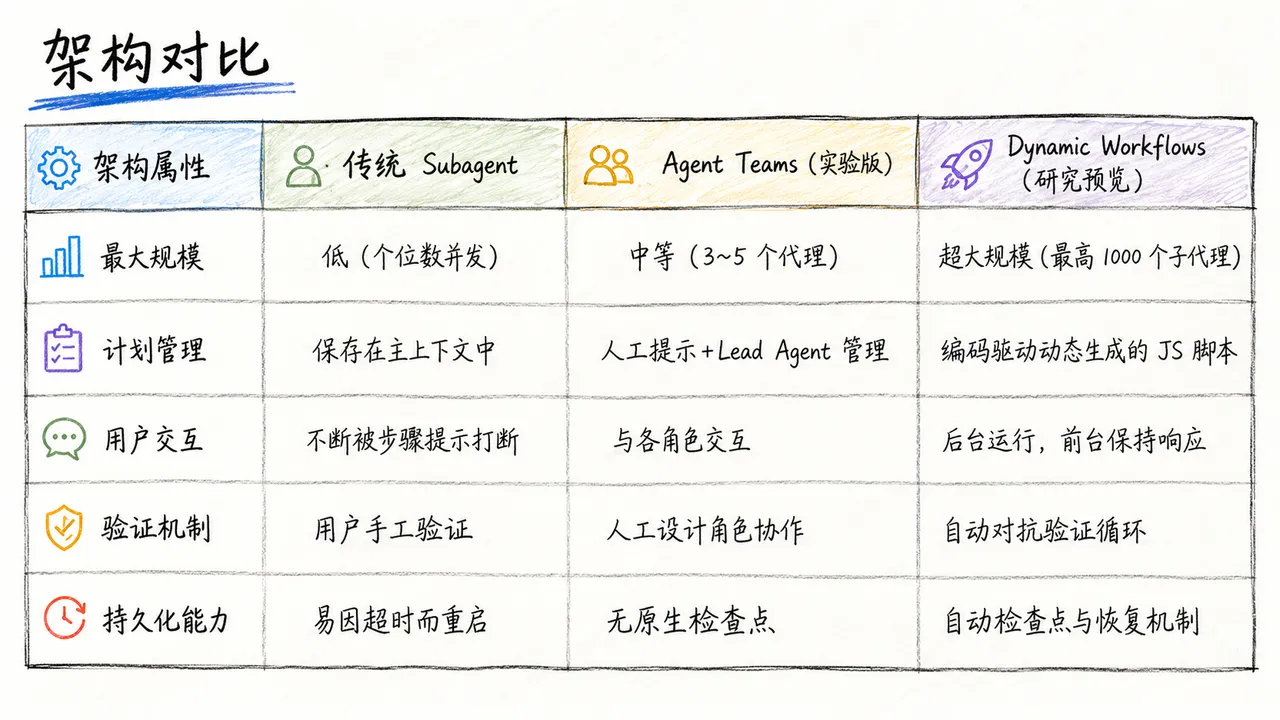
之前很多人应该使用Subagents来解决问题(一个会话内派几个专家并行)和 Agent Teams(多会话直接通信)。它们能解决很多问题,但有一个共同的天花板——调度逻辑活在主 Claude 的 context 里。
实际后果:
你想扫完一个百万行仓库找 bug?派 50 个 subagent,每个查一个目录?主 context 装不下这么多 task 描述 + 结果摘要。
你想做一个跨 200 个文件的大迁移?Agent Teams 的协调消息会把主 context 顶爆。
你想让多个 agent 对同一个发现互相挑刺、迭代到共识?目前没有"对抗式校验"这层基础设施。
简单说:Subagents 是"一个老板带几个工人",Agent Teams 是"几个团队互相打配合",但你想要一个工厂——上百个工位同时干、生产管理跟干活的事分开。
再来看下它和子代理、skills的对比,都可以运行多步骤任务。区别在于谁掌握计划:
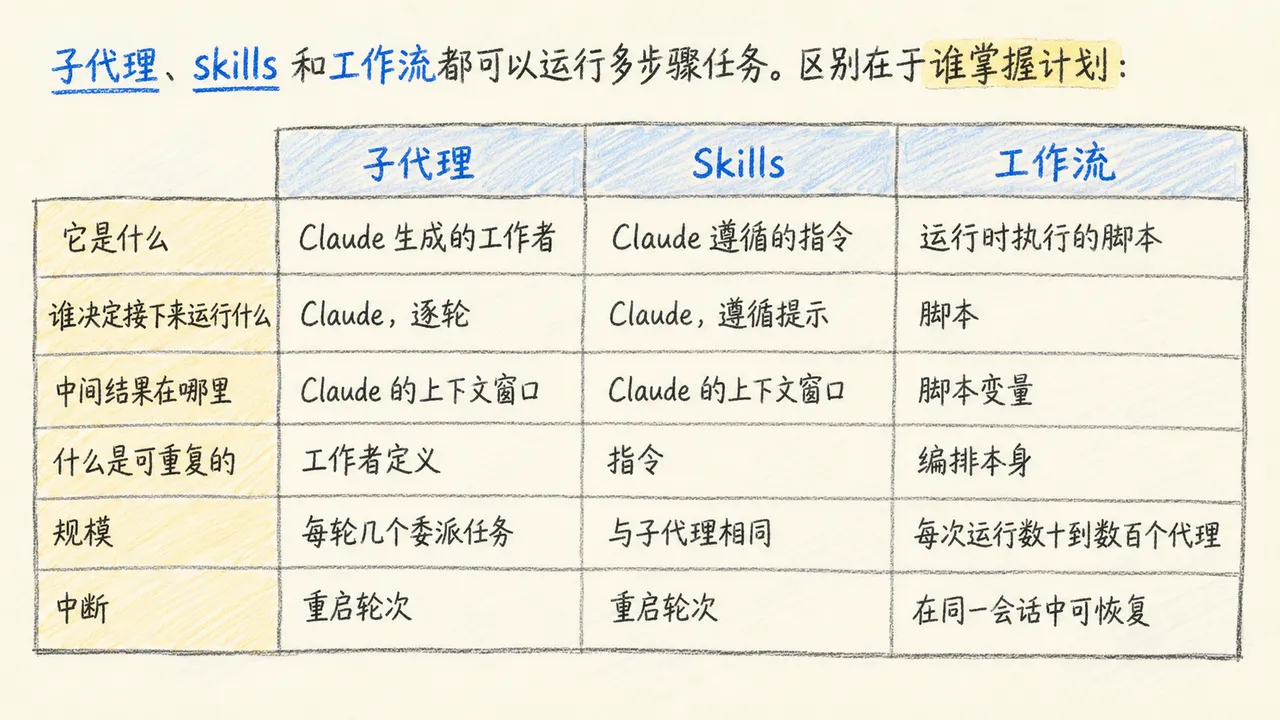
工作流将计划移入代码。使用子代理和 skills,Claude 是编排者:它逐轮决定接下来生成什么,每个结果都进入 Claude 的上下文。工作流脚本持有循环、分支和中间结果本身,所以 Claude 的上下文只持有最终答案。将计划移入代码也让工作流应用可重复的质量模式,而不仅仅是运行更多代理:它可以让独立代理在报告之前对彼此的发现进行对抗性审查,或从多个角度起草计划并相互权衡,所以您获得比单次通过更可信的结果。
Dynamic Workflows 解决的是编排规模。它不让主 Claude 每一轮都亲自协调,而是把调度逻辑交给脚本。脚本可以 parallel,可以 pipeline,可以循环,也可以在每个发现后安排对抗性 review。
从这个角度看,它在 Claude Code 里补了一层“编排运行时”。
我们在通俗的对比下,了解下这几个概念,拆解这四个概念:
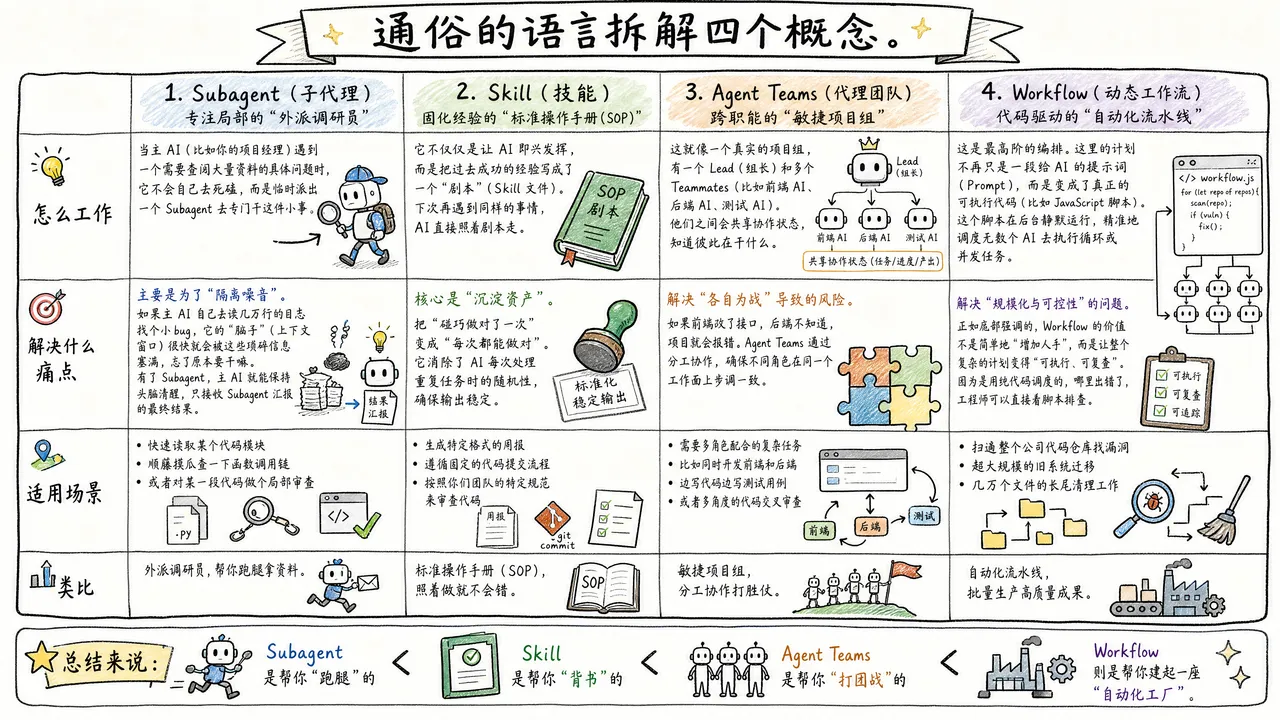
- Subagent(子代理):专注局部的“外派调研员”
怎么工作: 当主 AI(比如你的项目经理)遇到一个需要查阅大量资料的具体问题时,它不会自己去死磕,而是临时派出一个 Subagent 去专门干这件小事。
解决什么痛点: 主要是为了“隔离噪音”。如果主 AI 自己去读几万行的日志找个小 bug,它的“脑子”(上下文窗口)很快就会被这些琐碎信息塞满,忘了原本要干嘛。有了 Subagent,主 AI 就能保持头脑清醒,只接收 Subagent 汇报的最终结果。
适用场景: 快速读取某个代码模块、顺藤摸瓜查一下函数调用链、或者对某一段代码做个局部审查。
- Skill(技能):固化经验的“标准操作手册(SOP)”
怎么工作: 它不仅仅是让 AI 即兴发挥,而是把过去成功的经验写成了一个“剧本”(Skill 文件)。下次再遇到同样的事情,AI 直接照着剧本走。
解决什么痛点: 核心是“沉淀资产”。把“碰巧做对了一次”变成“每次都能做对”。它消除了 AI 每次处理重复任务时的随机性,确保输出稳定。
适用场景: 生成特定格式的周报、遵循固定的代码提交流程、或者按照你们团队的特定规范来审查代码。
- Agent Teams(代理团队):跨职能的“敏捷项目组”
怎么工作: 这就像一个真实的项目组,有一个 Lead(组长)和多个 Teammates(比如前端 AI、后端 AI、测试 AI)。他们之间会共享协作状态,知道彼此在干什么。
解决什么痛点: 解决“各自为战”导致的风险。如果前端改了接口,后端不知道,项目就会报错。Agent Teams 通过分工协作,确保不同角色在同一个工作面上步调一致。
适用场景: 需要多角色配合的复杂任务,比如同时开发前端和后端、边写代码边写测试用例、或者多角度的代码交叉审查。
- Workflow(动态工作流):代码驱动的“自动化流水线”
怎么工作: 这是最高阶的编排。这里的计划不再只是一段给 AI 的提示词(Prompt),而是变成了真正的可执行代码(比如 JavaScript 脚本)。这个脚本在后台静默运行,精准地调度无数个 AI 去执行循环或并发任务。
解决什么痛点: 解决“规模化与可控性”的问题。正如图片底部强调的,Workflow 的价值不是简单地“增加人手”,而是让整个复杂的计划变得“可执行、可复查”。因为是用纯代码调度的,哪里出错了,工程师可以直接看脚本排查。
适用场景: 扫遍整个公司代码仓库找漏洞、超大规模的旧系统迁移、几万个文件的长尾清理工作。
总结来说:
Subagent 是帮你“跑腿”的,Skill 是帮你“背书”的,Agent Teams 是帮你“打团战”的,而 Workflow 则是帮你建起一座“自动化工厂”。
五、生态发展
首先我觉得这个东西的发布,将会对那种图形化编排的软件FastGPT、Dify造成一定的冲击,同时让ClaudeCode中的一些场景执行的更稳定,同时也会让非技术人员,能够编写更强大,更厉害的应用场景。原来开发人员使用SDK开发的自定义Agent的场景也有一定的冲击。
在发布后的不久,Github上相继出现了一些新的生态项目,值得阅读的我推荐几个:
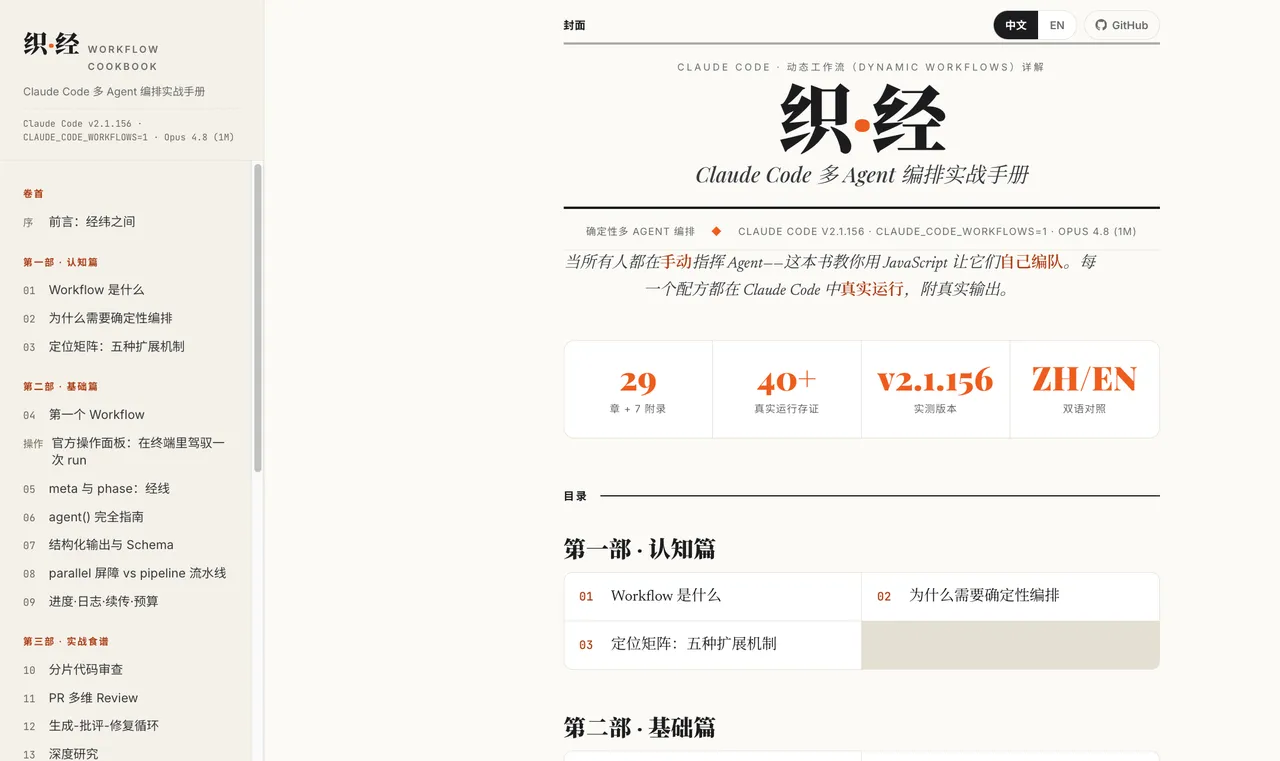
第1个:Claude Code 多 Agent 编排实战手册
仓库地址:https://github.com/AGI-is-going-to-arrive/workflow-cookbook
在线预览:https://agi-is-going-to-arrive.github.io/workflow-cookbook/
本书从零到一带你走完整条路。你先理解工作流在几种扩展机制里的位置,再掌握 agent()/parallel()/pipeline()/schema 全部 API,然后实战 7 个真实运行的配方。接着你解锁对抗验证、循环到干、预算、续传这些进阶模式,横评四大社区系统并提取精华,构建属于你自己的 Workflow 库,最后掌握从意图到上线的创作、校验与调试全流程。
这是一本实战 Cookbook,不是 API 文档。它讲得深入浅出,配方都以真实运行为骨:已实跑的附 Run ID 与用量,仅作示意的脚本明确标注。
第2个:可视化 Claude Code 动态工作流 (Dynamic Workflows) 的轻量级辅助工具
项目地址:https://github.com/democra-ai/claude-workflow-viz
项目介绍:当 Claude 用脚本在后台同时调度几十上百个 subagent 时,所有的执行细节(哪些代理在并行、卡在哪个环节、分别消耗了多少 Token)通常只会静默保存在本地的 JSON 日志里。这个工具的作用就是把这些隐藏的底层数据“提出来”,变成直观的可视化图表。
第3个:一套便携、抗造、能换引擎的轻量级施工脚手架
项目地址:https://github.com/akakabrian/agent-workflows
项目介绍:它是一个无依赖、跨平台、纯 Python 的动态 Agent 工作流运行时环境。它的核心理念是:“用一个简单的 Python 脚本,搞定复杂的多模型协作、并发和容错,而且不绑定任何具体的模型厂商”。
第4个:交互式单页报告:Claude Code 动态工作流(Dynamic Workflows)使用调研
项目地址:https://github.com/cclank/cc-dynamic-workflows
在线预览地址:https://cc-dynamic-workflows.pages.dev/
项目介绍:一份交互式单页 HTML 报告,讲清 Claude Code Dynamic Workflows(2026-05-28 随 Claude Opus 4.8 发布的研究预览功能)怎么用:定义、执行模型、触发与上手、监控成本、限制、脚本 API、编排模式、真实案例。
我觉得接下来还会出现DynamicWorkflow市场、企业DynamicWorkflow的应用、DynamicWorkflows的相关Skills,非常期待了。
六、避坑指南
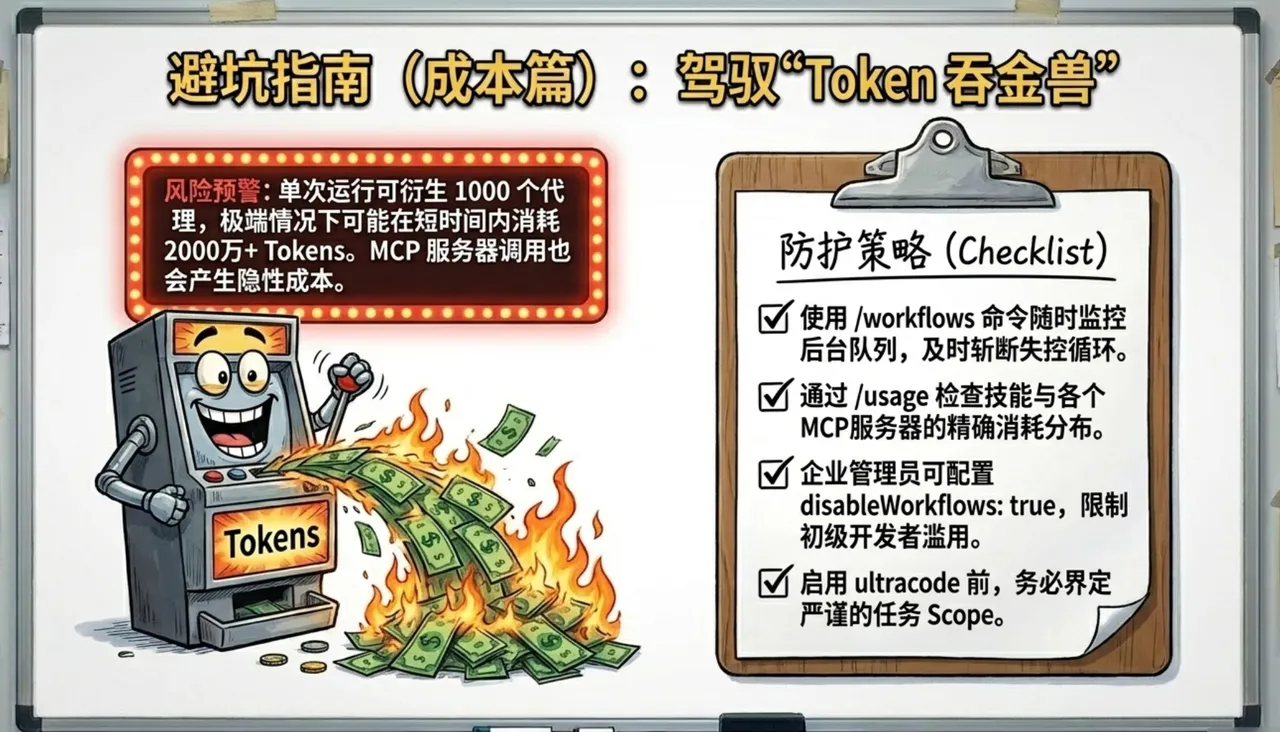
一次 workflow 会 spawn 大量 agent,单次运行可能比在对话里做同一任务消耗明显更多 token;运行像普通会话一样计入你方案的用量与速率限制。在这个过程中,可以随时从 /workflows 停止,不会丢失已完成的工作。
控成本:盯住模型
workflow 里每个 agent 默认用你会话的模型,除非脚本把某阶段路由到别的模型。
大运行前先 /model 确认(尤其你平时会切到小模型做日常活时)。
描述任务时,可让 Claude 把不需要最强模型的阶段换成小模型。
关掉 workflow的几种方式如下:
不想用时三选一:/config 里关掉 Dynamic workflows;或 \~/.claude/settings.json 设 "disableWorkflows": true;或环境变量 CLAUDE_CODE_DISABLE_WORKFLOWS=1。组织级可用 managed settings。关闭后:bundled 命令不可用、workflow 词不再触发、ultracode 从 /effort 菜单移除。
几个注意的地方:
场景:
成本:
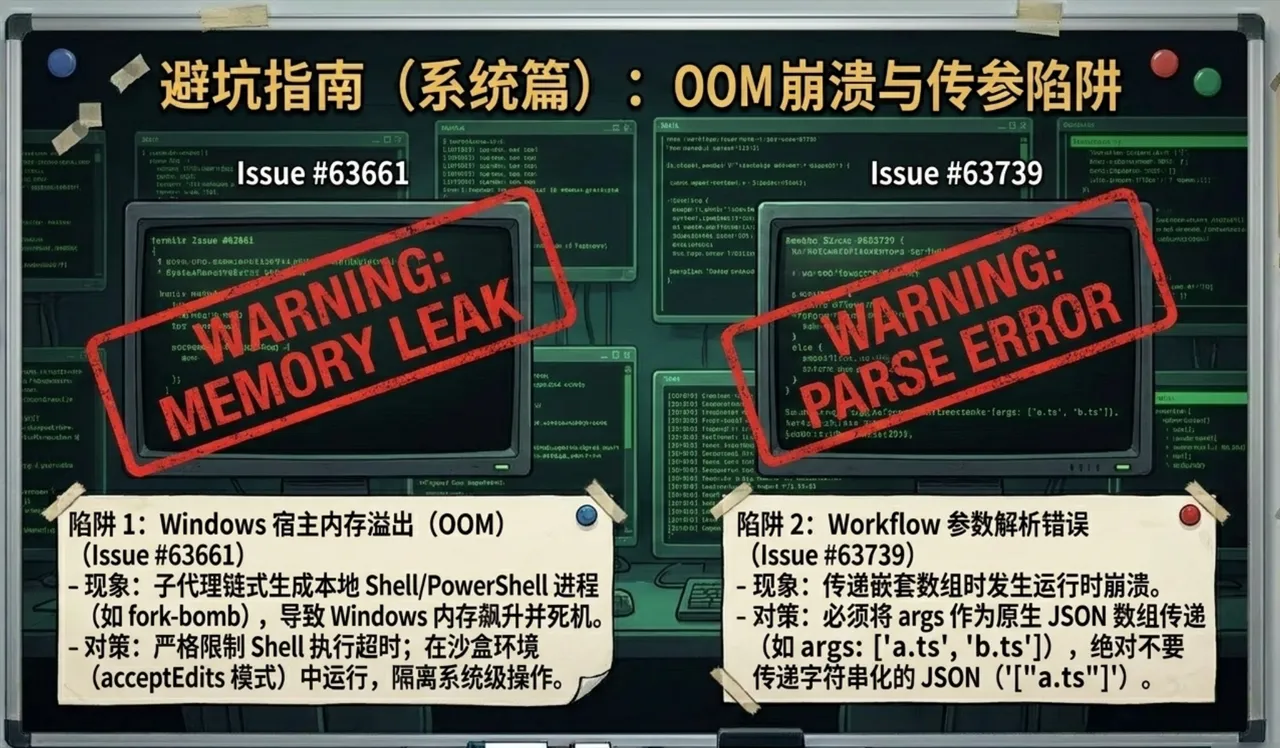
系统:
这个东西在使用的时候,我们还是需要根据自己的情况进行选择:
七、总结
如果说过去两年的 AI 编程革命,主要是在不断提升模型的能力边界,那么 Dynamic Workflows 的出现,则是在重新定义 AI 完成工作的方式。
它本质上并不是一个“更强的代码助手”,而是一种全新的软件工程执行范式:
从「单 Agent 对话式编程」演进到「可持久化、可恢复、可验证的大规模并行 Agent 集群编排系统」。
它背后的几个关键创新包括:
- 上下文卸载(Context Offloading)
- JavaScript 动态执行计划
- 数百至上千个 Agent 的并行协作
- 自动化对抗验证机制(Adversarial Verification)
- 检查点恢复与长任务持续运行能力
而这一切创新的背后,其实都指向同一个核心思想:
把“计划”从对话搬进代码。
在传统模式下,Claude 需要在自己的上下文窗口里完成全部工作:
规划、推理、循环、分支判断、中间状态管理……
所有信息都会不断堆积在有限的上下文中。随着任务规模扩大,Token 持续增长,上下文逐渐被污染,模型也更容易出现逻辑漂移、遗忘甚至幻觉。
Dynamic Workflows 则选择了一条完全不同的道路。
它把循环、条件判断、任务拆解、并行调度以及中间状态管理全部迁移到动态生成的 JavaScript 编排脚本中,由独立 Runtime 持续执行;而主对话上下文只负责接收经过验证的最终结果。
从某种意义上说,这已经不是在扩展 Context Window,而是在绕开 Context Window。
这也是为什么 Claude 能够从过去一次只能驱动一个 Agent,演进到同时协调数百甚至上千个 Subagent,并持续运行数小时甚至数天而不失控。
如果说:
- MCP 解决的是「AI 如何连接世界」;
- Skills 解决的是「AI 如何沉淀经验」;
那么 Dynamic Workflows 解决的,则是:
「AI 如何组织大规模工作」。
这或许才是它真正重要的地方。
因为软件工程从来都不是写出一段代码那么简单,真正困难的是规划、拆解、协作、验证、追踪以及持续迭代。
而 Dynamic Workflows 第一次让我们看到,AI 开始具备承担这些工程组织工作的能力。
对于大型代码迁移、安全审计、仓库级重构以及长周期研发任务来说,它展现出的已经不再是一个编程助手的能力,而更接近于一个能够自主协作的“软件工程团队”。
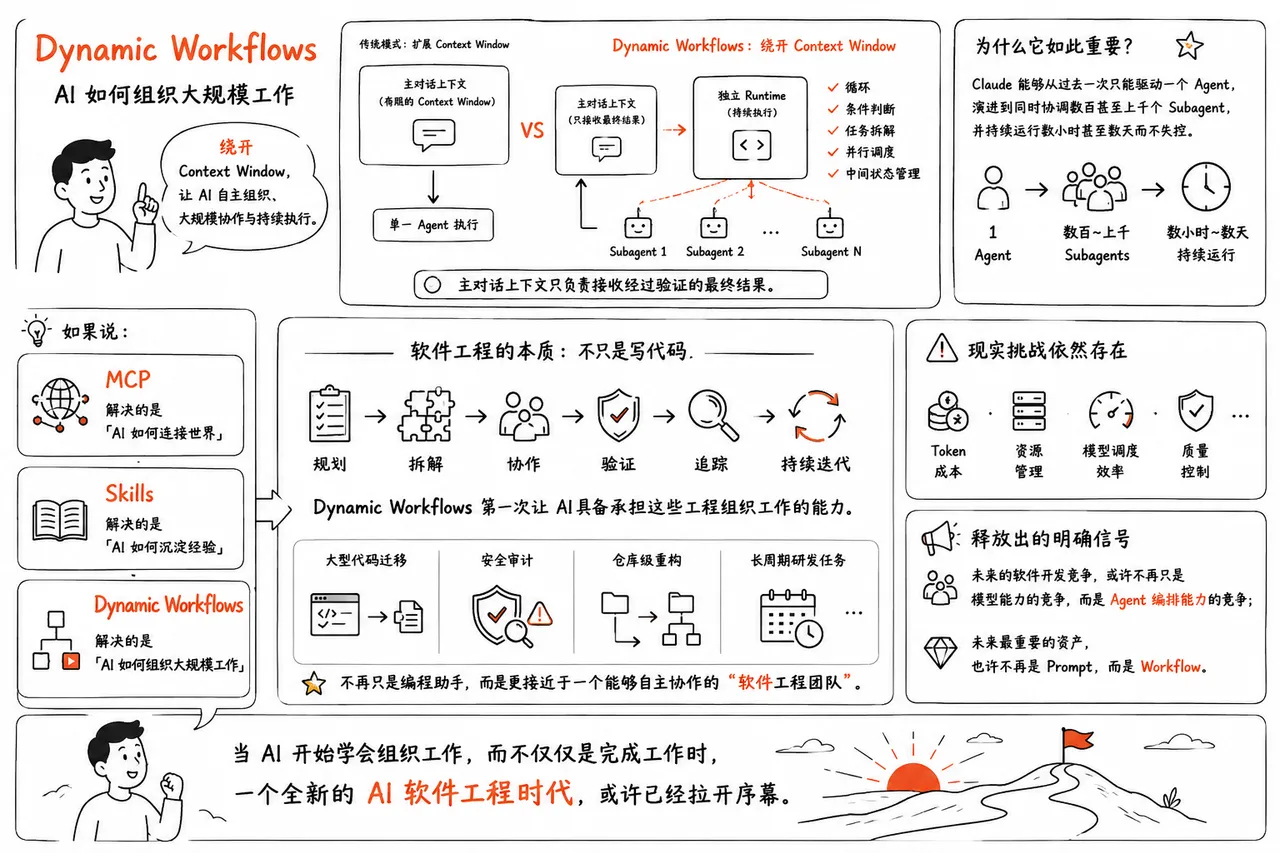
当然,这项技术仍然面临 Token 成本、资源管理、模型调度效率以及质量控制等现实挑战。
但即便如此,它依然释放出了一个非常明确的信号:
未来的软件开发竞争,或许不再只是模型能力的竞争,而是 Agent 编排能力的竞争;未来最重要的资产,也许不再是 Prompt,而是 Workflow。
